GPT-6.1 Terra vs. Claude & Gemini: Designtest
8 Sprachmodelle von OpenAI, Anthropic und Google, dieselben 12 Design-Briefings, je 3 Durchläufe. Alle 287 Designs habe ich blind bewertet.
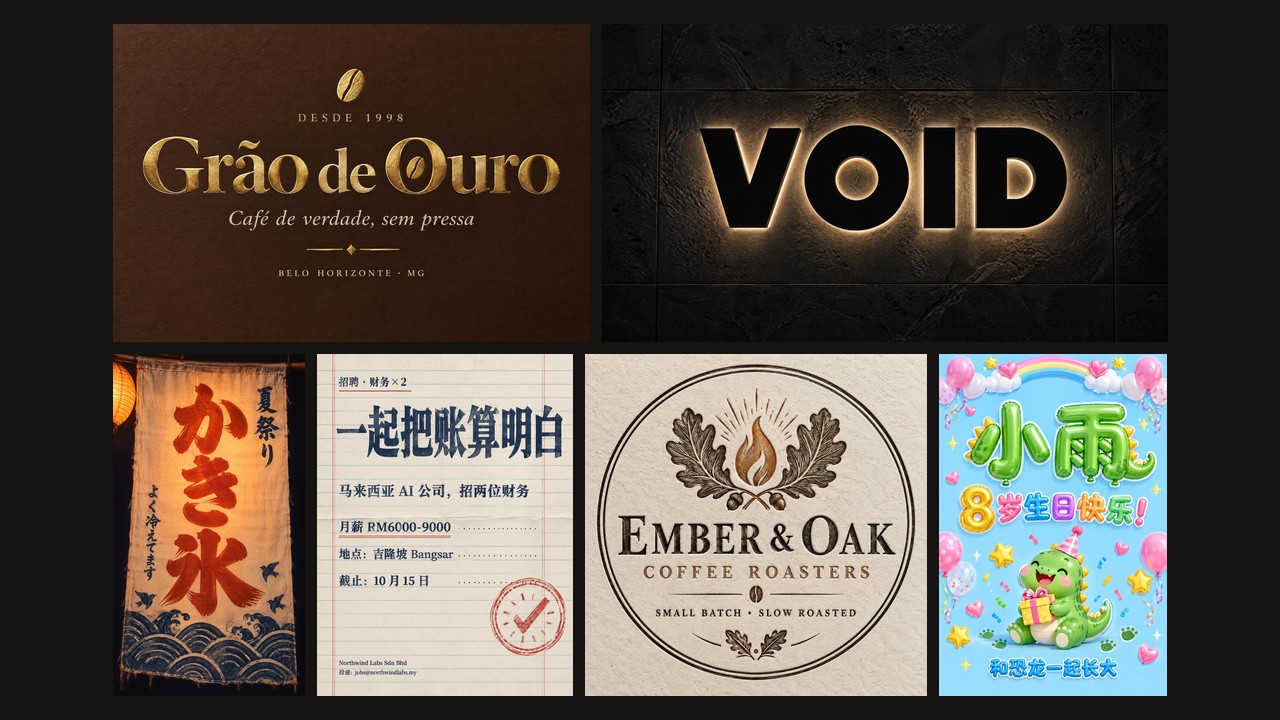
Wenn man FontVibe um ein Design bittet, übernimmt ein Sprachmodell die Arbeit des Designers, bevor überhaupt ein Bild gezeichnet wird. Es liest das Briefing, schlägt drei Designrichtungen vor und schreibt dann die Anweisungen, die das Bildmodell rendert. GPT-6.1 Terra ist am 26. Oktober 2026 erschienen, also habe ich getestet, ob es diese Arbeit besser macht als GPT-5.6 Terra, das Modell, das FontVibe derzeit nutzt, und es mit sechs weiteren Sprachmodellen von OpenAI, Anthropic und Google verglichen.
Jedes Modell bekam dieselben 12 Briefings, jedes dreimal. Das Bildmodell war für jedes Design dasselbe: GPT Image 2.5 Sunburst in 2K und Qualität Medium, das Modell, das in meinem Test von Qwen Image 3.0 und meinem Test von Grok Imagine 2.0 auf Platz zwei kam. Von Design zu Design änderte sich nur, welches Sprachmodell den Designer spielte. 287 Designs wurden blind bewertet, mit verborgenen Modellnamen.
Die Ergebnisse
| # | Modell | Fertige Designs | Gesamt (95%-KI) | Lesbarkeit | Schrift und Ausführung | Information und Layout | Wirkung | Erfundene Zeilen pro Design | Kosten pro Design | Entwurfszeit (Median) |
|---|---|---|---|---|---|---|---|---|---|---|
| – | Claude Opus 5.5 | 18 / 36 | 7.97 (7.40–8.46) | 8.7 | 8.0 | 7.4 | 7.8 | 0.22 | $0.41 | 65 s |
| 1 | GPT-6 Luna | 36 / 36 | 7.69 (7.50–7.88) | 9.1 | 7.2 | 7.5 | 7.2 | 0.36 | $0.005 | 44 s |
| 2 | GPT-5.6 Terra | 35 / 36 | 7.58 (7.14–7.97) | 8.7 | 7.5 | 7.0 | 7.5 | 0.46 | $0.09 | 29 s |
| 3 | Gemini 4 Argon | 36 / 36 | 7.56 (7.21–7.89) | 8.6 | 7.9 | 6.2 | 7.7 | 1.56 | $0.11 | 40 s |
| 4 | Claude Sonnet 5.5 | 36 / 36 | 7.43 (7.14–7.75) | 8.7 | 7.9 | 5.6 | 7.8 | 1.11 | $0.18 | 27 s |
| 5 | GPT-6.1 Sol | 36 / 36 | 7.35 (7.03–7.71) | 9.4 | 6.6 | 7.5 | 6.4 | 0.28 | $0.09 | 62 s |
| 6 | Gemini 3.8 Flash | 36 / 36 | 7.33 (6.94–7.69) | 8.8 | 7.7 | 5.4 | 7.7 | 2.36 | $0.04 | 32 s |
| 7 | GPT-6.1 Terra | 36 / 36 | 7.08 (6.59–7.56) | 9.1 | 6.5 | 7.0 | 6.1 | 0.17 | $0.04 | 37 s |
Die Noten gehen bis 10 und sind der Durchschnitt über alle fertigen Designs. Claude Opus 5.5 hat keinen Rang: Es hat nur bei 8 der 12 Briefings Designs fertiggestellt, überwiegend bei den leichteren, deshalb ist sein Durchschnitt nicht mit dem der anderen vergleichbar (wie es bei denselben Briefings abschneidet). Die 95%-Konfidenzintervalle stammen aus einem Resampling der Briefings, weil die drei Durchläufe eines Briefings dasselbe Briefing und denselben Bewertungsdurchgang teilen. Zwei Modelle gelten nur dann als verschieden, wenn das Intervall ihrer Differenz im Vergleich Briefing für Briefing die Null nicht einschließt; alle 28 Vergleiche stehen im Anhang. Die Kosten pro Design sind die Sprachmodell-Kosten eines Designs im Median (Entwurf plus Bildanweisungen) zu den öffentlichen Preisen der Anbieter am 30. Oktober 2026; das Bild selbst kostet bei jedem Modell gleich viel und ist nicht enthalten. Jede Note pro Aufgabe steht im Anhang.
Vier Ergebnisse fallen auf.
Welches Sprachmodell den Designer spielt, macht einen Unterschied, aber rein nach Qualität ließen sich die meisten Modelle nicht unterscheiden. Mit demselben Bildmodell und denselben Einstellungen reichten die Durchschnittsnoten von 7.08 bis 7.97. Von den 28 Modellpaaren unterscheiden sich im Vergleich Briefing für Briefing 5 klar: GPT-6.1 Terra erreichte niedrigere Noten als GPT-5.6 Terra, GPT-6 Luna und Claude Opus 5.5, und GPT-6.1 Sol niedrigere als GPT-6 Luna und Claude Opus 5.5. Die anderen 23 Paare liegen in diesem Test gleichauf.
Nimmt man Qualität, Kosten, Geschwindigkeit und Zuverlässigkeit zusammen, öffnen sich die Abstände. Modelle derselben Qualitätsgruppe unterschieden sich bei den Kosten pro Design um mehr als das 30-Fache (GPT-6 Luna $0.005, Claude Sonnet 5.5 $0.18). Die Zeit für den Entwurf und das Schreiben der Bildanweisungen unterschied sich etwa um das Doppelte (etwa 41 Sekunden bei GPT-5.6 Terra und Claude Sonnet 5.5, etwa 87 bei GPT-6.1 Sol). Und die Modelle scheiterten aus unterschiedlichen Gründen (Details). Alles zusammengenommen verlieren mehrere Modelle in mindestens einem Punkt, ohne in einem anderen zu gewinnen: GPT-6.1 Sol kostete so viel wie GPT-5.6 Terra und ließ sich bei der Qualität nicht davon unterscheiden, brauchte aber doppelt so lange; Gemini 3.8 Flash kostete achtmal so viel wie GPT-6 Luna, ließ sich bei der Qualität nicht davon unterscheiden und hatte 8 Fehler des Anbieters; GPT-6.1 Terra kostete mehr als GPT-6 Luna und erreichte klar niedrigere Noten.
Kein Modell gewinnt überall; jedes passt zu anderer Arbeit. Claude Opus 5.5 hatte den höchsten Durchschnitt, 7.97, allerdings aus nur 18 Designs bei 8 Briefings. Im Hauptdurchlauf wurden seine Entwürfe, weit länger als die jedes anderen Modells, 17-mal vom Limit von 6600 Tokens abgeschnitten, das FontVibe für den eigenen Produktivbetrieb festgelegt hat, und ein weiterer Durchlauf scheiterte, weil seine Bildanweisungen fehlerhaft zurückkamen. Mit verdoppeltem Limit wiederholt, wurde es jedes Mal fertig; über alle 36 Designs erreichte es klar höhere Noten als GPT-5.6 Terra, Claude Sonnet 5.5, Gemini 3.8 Flash und beide GPT-6.1-Modelle und ließ sich nicht von GPT-6 Luna oder Gemini 4 Argon unterscheiden (Details). Es ist auch das langsamste und das teuerste Modell: im Median $0.41 pro Design oder $0.72 pro fertigem Design, wenn man die gescheiterten Durchläufe mitzählt. Es passt zu komplexer Designarbeit ohne Eile, bei der sein Vorsprung den Preis wert ist. GPT-6 Luna lag in der obersten Qualitätsgruppe, schloss jeden Durchlauf ab und kostete am wenigsten, was es zum besten Preis-Leistungs-Verhältnis macht und zu großen Mengen passt. GPT-5.6 Terra war schnell und ausgewogen, was zum Echtzeiteinsatz passt, bei dem jemand auf das Ergebnis wartet.
Erfundener Text ist ein messbarer Mangel, und er schwankte zwischen den Modellen um das 14-Fache. GPT-6.1 Terra fügte pro Design im Schnitt 0.17 Zeilen hinzu, die im Briefing nie vorkamen; Gemini 3.8 Flash fügte 2.36 hinzu: Gründungsjahre, Slogans, Leistungslisten und erfundene Zahlen. Erfundener Text war der häufigste Grund, warum ein Design bei der Information Punkte verlor, deshalb braucht die Pipeline, egal welches Modell man nutzt, eine Textprüfung.
GPT-6.1 Terra war der Ausgangspunkt dieses Tests, deshalb ein Wort dazu. In derselben Pipeline und mit denselben Prompts war es zurückhaltender als GPT-5.6 Terra. Briefing für Briefing verglichen, erreichte es 0.50 Punkte weniger (95%-KI −0.81 bis −0.21) und schnitt bei 9 der 12 Briefings schlechter ab. Es verlor bei Schrift und Ausführung (−0.93) und bei der Wirkung (−1.38, bei allen 12 Briefings niedriger); seine Lesbarkeit war etwas höher (+0.47), innerhalb der Fehlermarge. Seine Designs enthielten am wenigsten erfundenen Text und waren die schlichtesten; 17 seiner 36 Designs trafen die Stimmung, die das Briefing verlangte, nur teilweise. Das beschreibt, wie es ein Briefing liest, eine Richtung wählt und Bildanweisungen schreibt, nicht, wie es bei anderen Aufgaben abschneidet.
Kosten, Geschwindigkeit und Zuverlässigkeit
Die Designqualität ist nur ein Teil der Modellwahl. Dieselben Durchläufe haben auch gemessen, was jedes Design kostet, wie lange es dauert und wie oft es scheitert.
| Modell | Entwurfszeit (Median / langsamste 10%) | Zeit für Bildanweisungen (Median / langsamste 10%) | Kosten pro Design (Median) | Ausgaben pro 1000 fertige Designs | Im ersten Versuch fertig | Eigene Fehler des Modells | Fehler des Anbieters | Interne Wiederholungen |
|---|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 37 s / 45 s | 13 s / 17 s | $0.041 | $41 | 36 / 36 | 0 | 0 | 0 |
| GPT-5.6 Terra | 29 s / 38 s | 12 s / 14 s | $0.090 | $93 | 33 / 36 | 1 | 0 | 0 |
| GPT-6.1 Sol | 62 s / 79 s | 25 s / 30 s | $0.090 | $91 | 34 / 36 | 0 | 0 | 0 |
| GPT-6 Luna | 44 s / 58 s | 16 s / 23 s | $0.005 | $5 | 36 / 36 | 0 | 0 | 1 |
| Claude Opus 5.5 | 65 s / 75 s | 25 s / 35 s | $0.41 | $721 | 18 / 36 | 18 | 0 | 19 |
| Claude Sonnet 5.5 | 27 s / 32 s | 14 s / 16 s | $0.18 | $162 | 36 / 36 | 0 | 0 | 0 |
| Gemini 4 Argon | 40 s / 73 s | 22 s / 33 s | $0.11 | $102 | 36 / 36 | 0 | 0 | 3 |
| Gemini 3.8 Flash | 32 s / 49 s | 13 s / 35 s | $0.043 | $49 | 29 / 36 | 0 | 8 | 4 |
Die Zeiten sind die eigene Zeit des Sprachmodells für jeden Schritt, über die fertigen Durchläufe. Das Rendern des Bildes dauerte zusätzlich im Median 20 Sekunden, für jedes Modell gleich. Die Kosten beruhen auf den öffentlichen Preisen der Anbieter am 30. Oktober 2026, umfassen beide Sprachmodell-Schritte und lassen das Bild weg, das gleich viel kostet, egal welches Modell es entworfen hat. "Ausgaben pro 1000 fertige Designs" zählt alles, was ausgegeben wurde, einschließlich gescheiterter Durchläufe und Wiederholungen, geteilt durch die fertigen Designs. "Im ersten Versuch fertig" zählt Durchläufe, die ohne Wiederholung ein Bild geliefert haben; die zwei Durchläufe von GPT-5.6 Terra und die zwei von GPT-6.1 Sol, die der Empfang von FontVibe für eine Rückfrage angehalten hat, zählen als nicht im ersten Versuch fertig, obwohl das Modell nichts dafür konnte. Interne Wiederholungen sind die Fälle, in denen die Pipeline von FontVibe innerhalb einer Anfrage nach einem gescheiterten Versuch dasselbe Modell erneut aufgerufen hat.
Kosten. GPT-6 Luna war mit Abstand am günstigsten: etwa $5 pro 1000 fertige Designs, gegenüber $93 für GPT-5.6 Terra und $721 für Claude Opus 5.5, dessen gescheiterte Durchläufe fast so viel kosteten wie die fertigen. GPT-6.1 Terra kostete weniger als halb so viel wie GPT-5.6 Terra. Claude Opus 5.5 war am teuersten, unter anderem weil es die längsten Entwürfe schrieb: Sein Entwurf im Median erreichte das Limit von 6600 Tokens.
Geschwindigkeit. Claude Sonnet 5.5 lieferte die Entwürfe am schnellsten, im Median in 27 Sekunden, und GPT-5.6 Terra lag mit 29 Sekunden knapp dahinter. GPT-6.1 Sol und Claude Opus 5.5 brauchten über eine Minute. Der Median von Gemini 4 Argon lag bei 40 Sekunden, aber seine langsamsten 10% brauchten 73 Sekunden oder mehr, die größte Streuung aller Modelle.
Zuverlässigkeit. GPT-6.1 Terra, GPT-6 Luna, Claude Sonnet 5.5 und Gemini 4 Argon haben alle 36 Durchläufe im ersten Versuch abgeschlossen. Die eigene Ausgabe von Gemini 3.8 Flash ist nie gescheitert, aber der Dienst von Google lieferte in 7 seiner Durchläufe insgesamt 8 Fehler (Ratenlimits und Timeouts), und alle diese Durchläufe wurden bei einer Wiederholung fertig. Claude Opus 5.5 scheiterte 18-mal: 17 Entwürfe wurden am Ausgabelimit abgeschnitten, und einmal kamen die Bildanweisungen fehlerhaft zurück. Die meisten seiner 19 internen Wiederholungen waren zweite Versuche nach einem abgeschnittenen Entwurf, die wieder abgeschnitten wurden.
So habe ich getestet
Die Pipeline
Dieser Test misst eine Aufgabe: Designer sein. Im Design-Modus von FontVibe durchläuft eine Anfrage drei Schritte:
- Entwerfen. Ein Sprachmodell liest das Briefing und schlägt drei Designrichtungen vor, jede mit einem Titel, dem genauen zu druckenden Text, Farben, einem Layout und einer Wahl des Schriftstils.
- Die Bildanweisungen schreiben. Für die erste Richtung schreibt ein Sprachmodell die vollständigen Anweisungen für das Bildmodell.
- Rendern. Ein Bildmodell zeichnet es.
Das getestete Modell übernahm die Schritte 1 und 2. Schritt 3 war immer GPT Image 2.5 Sunburst in 2K und Qualität Medium. Jede Anfrage lief durch die Produktiv-Pipeline von FontVibe, mit denselben System-Prompts, demselben Ausgabeformat und derselben Einstellung für den Reasoning-Aufwand (medium) für jedes Modell. Kein Modell bekam einen eigenen Prompt oder eigene Einstellungen. Gerendert wurde immer die erste Richtung; ich habe keine Richtungen ausgewählt.
Die acht Modelle
| Anbieter | Modell | Warum es dabei ist |
|---|---|---|
| OpenAI | GPT-6.1 Terra | Neu seit dem 26. Oktober 2026; das Modell, um das es geht |
| OpenAI | GPT-5.6 Terra | Das, was FontVibe derzeit für Schritt 1 nutzt |
| OpenAI | GPT-6.1 Sol | Das Flaggschiff von OpenAI |
| OpenAI | GPT-6 Luna | Das günstige Modell von OpenAI; das, was FontVibe derzeit für Schritt 2 nutzt |
| Anthropic | Claude Opus 5.5 | Das Flaggschiff von Anthropic |
| Anthropic | Claude Sonnet 5.5 | Das Modell von Anthropic in der mittleren Preisklasse |
| Gemini 4 Argon | Das Flaggschiff von Google | |
| Gemini 3.8 Flash | Das günstige Modell von Google |
Die 12 Briefings, in vier Ebenen
Ein Designer kann auf vier verschiedene Arten danebenliegen, deshalb kommen die Briefings in vier Ebenen zu je drei, eine Ebene für jede Art.
| Ebene | Was sie testet | Warum das wichtig ist |
|---|---|---|
| 1. Alltägliche Anfragen | Kurze Briefings mit einem einzigen Zweck | Die meisten echten Anfragen sehen so aus, also kommt diese Ebene dem täglichen Gebrauch am nächsten |
| 2. Die Information richtig umsetzen | Text, der exakt erscheinen muss, teils in einer festgelegten Rangfolge | Das Sprachmodell ist der einzige Schritt, der den Text an das Bildmodell übergibt; Text, den es weglässt oder verändert, lässt sich später nicht wiederherstellen |
| 3. Gestalterisches Urteil | Widersprüchliche Anforderungen, ein unbekanntes Fachgebiet, zwei Zielgruppen zugleich | Genau dafür bezahlt ein Auftraggeber einen Designer, und hier unterscheiden sich die Modelle am ehesten |
| 4. Sprache und Kultur | Briefings auf Japanisch, Deutsch und mexikanischem Spanisch mit kulturellem Kontext | Ein falsches kulturelles Signal kostet mehr als ein Tippfehler |
Die Briefings decken sechs Sprachen ab (Englisch, Chinesisch, Spanisch, Portugiesisch, Deutsch und Japanisch), die sechs Sprachen der Oberfläche von FontVibe, und jedes verlangt Text auf dem Design. Acht der 12 Briefings wurden erstmals im September 2026 in einem internen Test von drei OpenAI-Modellen verwendet. Die Firma auf dem Stellenplakat und alle Namen und Adressen in den Briefings sind erfunden. Das vollständige Briefing jeder Aufgabe steht unten im jeweiligen Abschnitt.
Durchläufe und Fehlschläge
Jedes Modell bearbeitete jedes Briefing dreimal: 36 Designs pro Modell, 288 insgesamt. Wenn ein Design scheiterte, entschied die Ursache, wie es weiterging:
- Die eigene Ausgabe des Modells scheiterte (beim Token-Limit des Produktivbetriebs abgeschnitten, oder ein leerer oder fehlerhafter Entwurf): als Fehlschlag gezählt und nicht wiederholt. 19 Designs scheiterten auf diese Weise: 18 von Claude Opus 5.5 (17 am Limit abgeschnittene Entwürfe, 1 Satz fehlerhafter Bildanweisungen) und 1 leerer Entwurf von GPT-5.6 Terra.
- Der Dienst des Anbieters scheiterte (Ratenlimits, Serverfehler, Timeouts): wiederholt. Das kam 8-mal vor, alle Fälle bei Gemini 3.8 Flash.
- Der eigene Empfang von FontVibe stellte zuerst eine Rückfrage. Bevor eine Anfrage beim Designer ankommt, prüft ein separates, festes Modell, ob etwas fehlt. Beim Nachtclub-Briefing fragte es manchmal "fast unsichtbar oder aus 50 Metern lesbar?", statt das Briefing weiterzugeben. Das hat nicht das getestete Modell zu verantworten, deshalb wurden diese 4 Durchläufe wiederholt, und bewertet wurde das Design der Wiederholung. Jeder Versuch ist im offenen Datensatz aufgeführt.
Alle 287 Designs (269 aus den Hauptdurchläufen und 18 aus den Opus-Wiederholungen unten) wurden am 30. Oktober 2026 auf der Produktivseite von FontVibe mit einem offiziellen Konto erzeugt und sind öffentlich auf FontVibe zu sehen.
Bewertung
Jedes Design wurde nach dem Bewertungsstandard für Benchmarks von FontVibe bewertet, der geschrieben wurde, bevor die Ergebnisse ausgezählt waren. Er baut auf dem Bewertungsschema aus meinem Test von sieben KI-Design-Tools und den beiden Tests der Bildmodelle auf. Der Juror spielt den Auftraggeber, der das Briefing geschrieben hat, und urteilt in dieser Reihenfolge: Ist es das, was ich verlangt habe; kann ich es verwenden, ohne etwas zu korrigieren; ist es das Gefühl, das ich wollte; sind die Details gut gemacht; bringt es mich auf den ersten Blick zum Staunen.
| Was bewertet wird | Gewicht | Was es umfasst |
|---|---|---|
| Lesbarkeit | 20% | Zuerst eine Prüfung auf harte Fehler, die den Haupttext in seiner tatsächlichen Größe unlesbar machen oder falsch lesen lassen. Jeder harte Fehler bedeutet 1 bis 4; ohne harte Fehler gibt es 7 bis 10. |
| Schrift und Ausführung | 35% | Ob Schrift und Materialien den Effekt und die Stimmung erreichen, die das Briefing verlangt, und wie gut sie gemacht sind. |
| Information und Layout | 25% | Ob es das richtige Ergebnis ist und jedes Stück Text so verwendet werden kann, wie es ist: vollständig, so wie der Auftraggeber es geschrieben hat, und nichts, was der Auftraggeber nicht gesagt hat und nicht vertreten könnte. Danach Hierarchie, Reihenfolge und Ausgewogenheit. |
| Wirkung | 20% | Nur der erste Eindruck und die visuelle Professionalität. Textfehler werden einmal bewertet, unter Information und Layout, und hier nicht noch einmal. |
Die Gesamtnote wird berechnet, nicht geschätzt: 0.20 × Lesbarkeit + 0.35 × Schrift + 0.25 × Information und Layout + 0.20 × Wirkung.
Eine Regel hat viele Noten entschieden, deshalb steht sie hier vollständig. Die Frage für jede Textzeile lautete: Müsste der Auftraggeber das ändern, bevor er es verwendet, und hat der Auftraggeber es je gesagt? Was das Briefing ohnehin sagt ("COFFEE ROASTERS" für eine Kaffeerösterei), und übliche Grüße ("Happy birthday") wurden akzeptiert. Fakten, Zahlen, Versprechen und Slogans, die der Auftraggeber nie geliefert hat, kosteten jeweils einen Abzug, weil der Auftraggeber sie entweder löschen oder unbemerkt etwas Unwahres veröffentlichen müsste. Unverändert gedruckte Platzhalter wie {{fecha}} und Änderungen an der Schreibweise des Auftraggebers, etwa wenn aus "7 de la noche" "7:00 p. m." wurde, kosteten ebenfalls Abzüge.
Wer bewertet hat. Die Noten stammen von KI-Juroren, die mit Claude Opus 5.5 laufen, ein Juror pro Gruppe von drei Briefings, und jeder hat sich alle Originalbilder eines Briefings angesehen, bevor er eines davon bewertet hat. Die Bilder hatten zufällige IDs, und die Juroren wussten nicht, welches Modell welches Design gemacht hat. Eines der acht getesteten Modelle, Claude Opus 5.5, ist dasselbe Modell wie die Juroren. Das sollte man beim Lesen seiner Noten im Kopf behalten: Ob die Juroren die Designs von Opus selbst bevorzugen, wurde nicht getestet. Die Blindauswahl durch einen Menschen ist die einzige menschliche Kontrolle in diesem Test.
Aufgabe für Aufgabe
Jedes Raster zeigt für jedes Modell das erste Design, das fertig wurde, also wurde kein Design von Hand ausgewählt. Die Bildunterschrift nennt die Note dieses Designs und den Durchschnitt des Modells über seine drei Durchläufe der Aufgabe.
Ebene 1: Alltägliche Anfragen
Aufgabe 1: Wortmarke einer Kaffeerösterei
A logo-style title for my new coffee roastery called EMBER & OAK
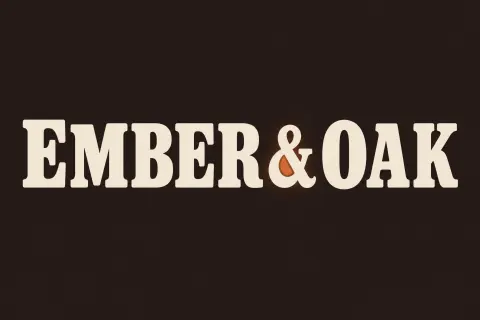
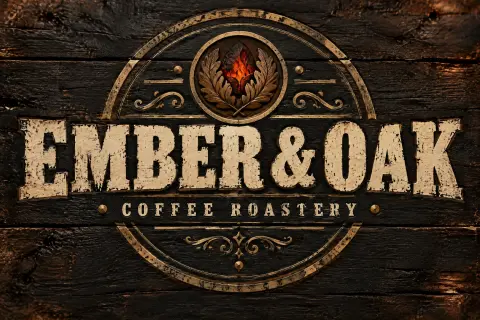
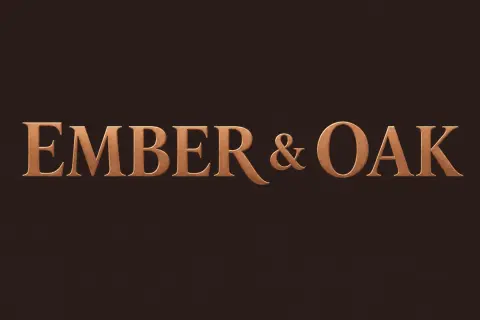
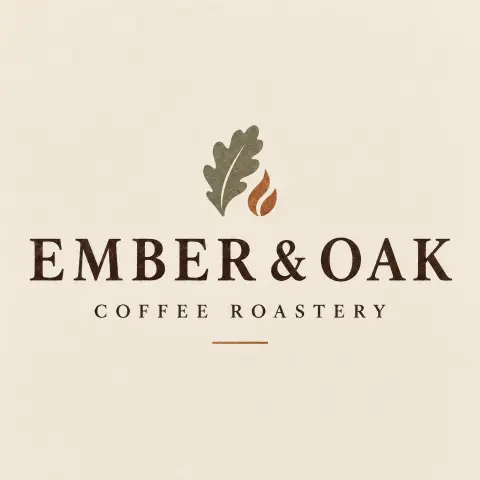
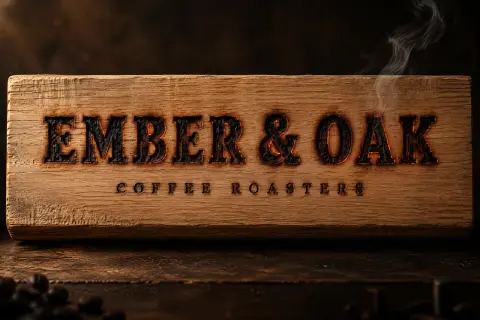
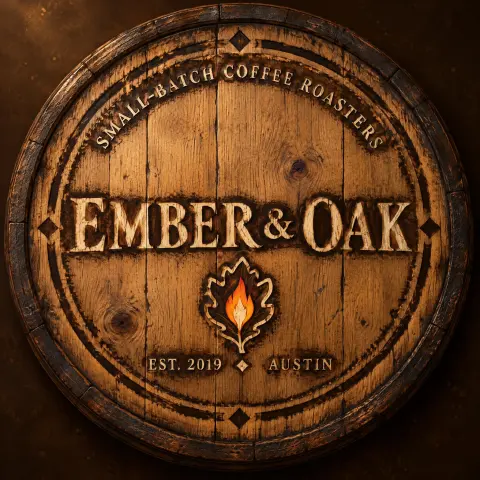
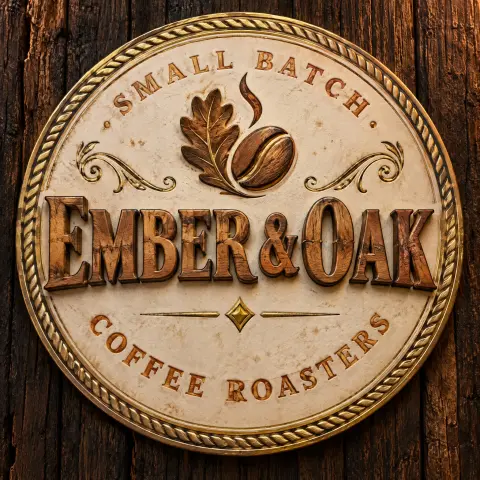
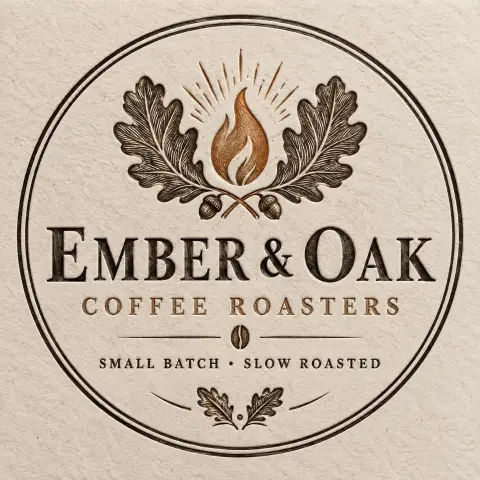
Claude Opus 5.5 erreichte die höchste Note, im Schnitt 8.38: Es hat den Namen in Holz gebrannt, mit versengten Rändern an jedem Buchstaben. GPT-5.6 Terra (8.13) und GPT-6 Luna (8.05) folgten knapp dahinter. GPT-6.1 Terra (6.62) und GPT-6.1 Sol (6.43) setzten den Namen in saubere, aber gewöhnliche Schrift, die der Juror als nur teilweise passend zu "ember and oak" aus dem Briefing bewertete. Das Design von Claude Sonnet 5.5 erfand ein Gründungsjahr und eine Stadt, "EST. 2019" und "AUSTIN", die der Auftraggeber nie genannt hat.
Aufgabe 2: Dinosaurier-Geburtstagsplakat
给我做一张生日海报,寿星叫小雨,今年 8 岁,喜欢恐龙 (Ein Geburtstagsplakat: Das Geburtstagskind heißt Xiaoyu, sie wird 8 und liebt Dinosaurier.)
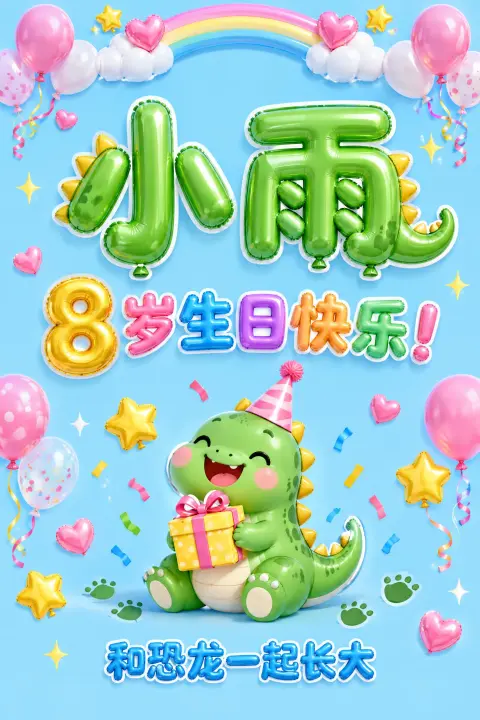
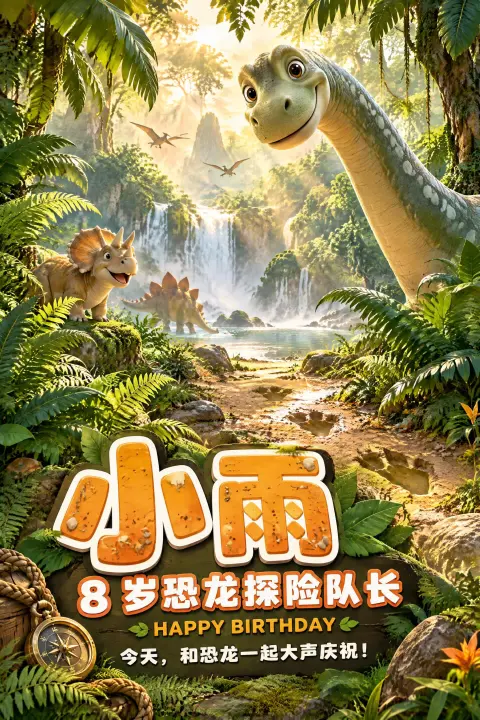
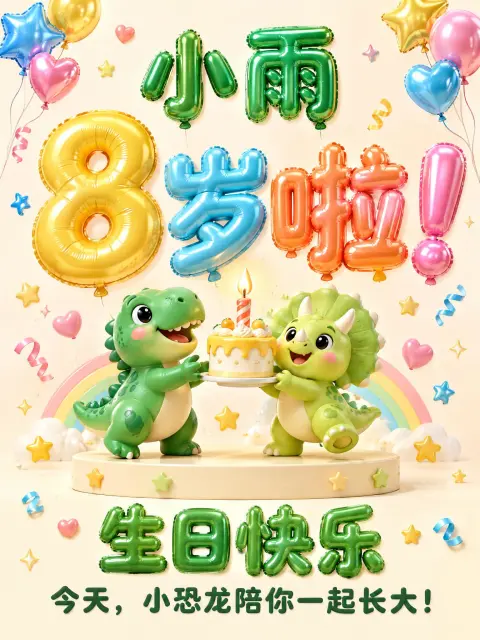
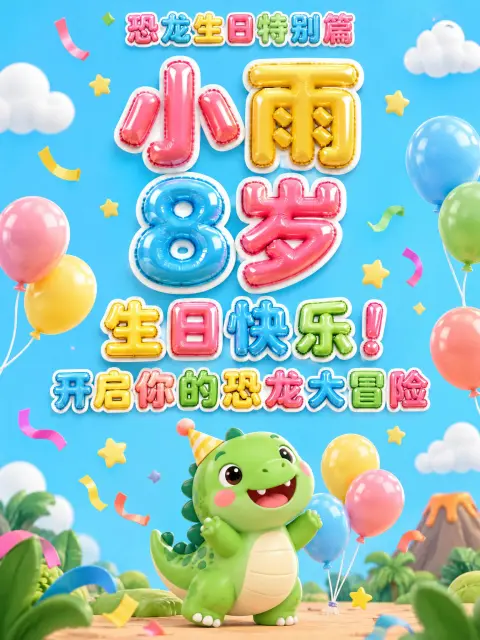
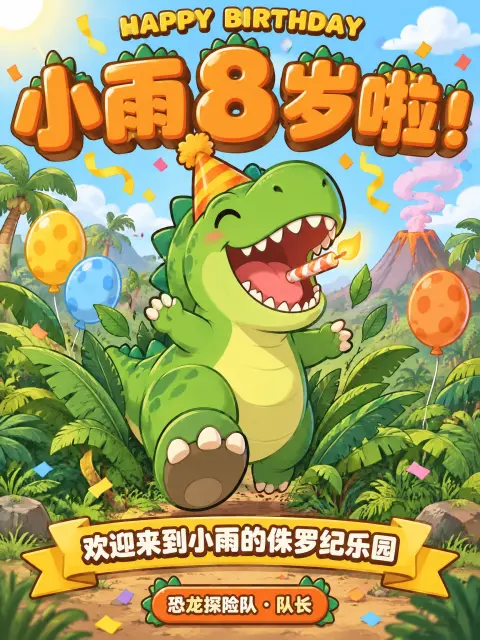
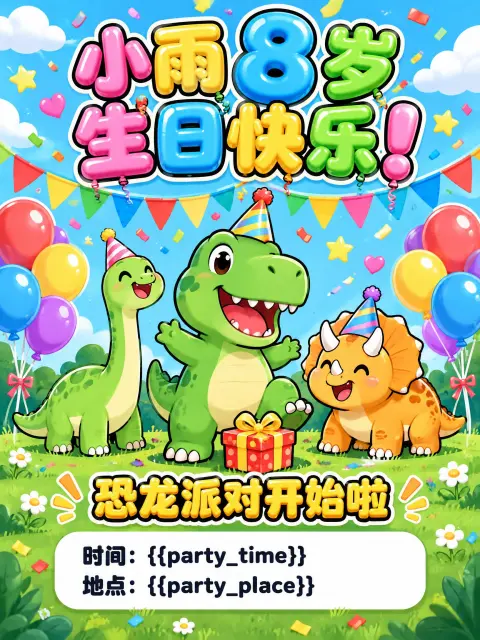
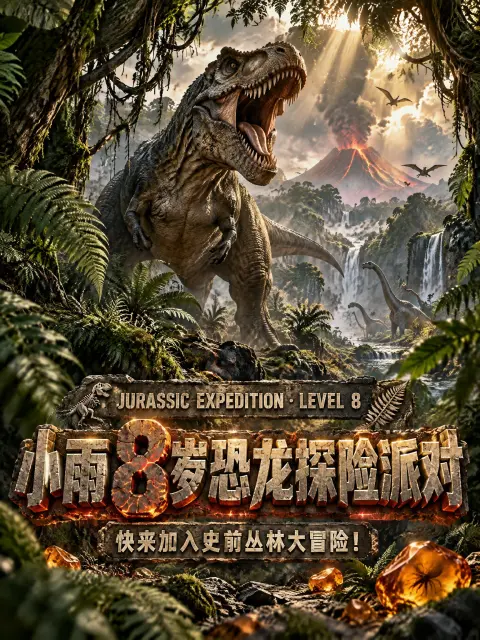
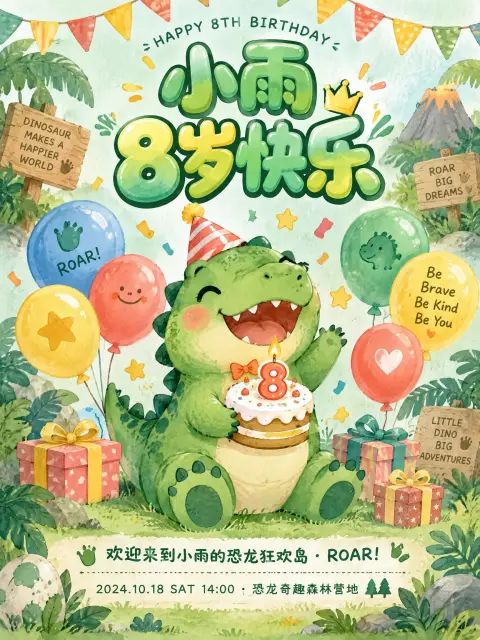
Die OpenAI-Modelle schnitten hier am besten ab. GPT-6.1 Sol erreichte 8.73 und GPT-6.1 Terra 8.43, seine beste Aufgabe, mit einem Dinosaurierschwanz, der aus dem Schriftzeichen 雨 in Xiaoyus Namen wächst. Gemini 4 Argon landete mit 6.48 auf dem letzten Platz: ein fotorealistischer Dschungel und eine Party "Jurassic Expedition · Level 8", die der Auftraggeber nie erwähnt hat und die der Juror als nur teilweise passend zu einem Geburtstag für eine Achtjährige bewertete. Für Ballonschrift wie die von GPT-6.1 Sol gibt es den Bubble-Letter-Generator. Das erste Design von Gemini 3.8 Flash erfand ein Datum, eine Uhrzeit und einen Ort für eine Party, die es nicht gibt, und das Datum war bereits vorbei.
Aufgabe 3: Plakat zur Abschlussfeier
Un cartel para la fiesta de graduación de secundaria, dice PROMOCIÓN 2026 (Ein Plakat für die Abschlussfeier der Oberschule mit der Aufschrift PROMOCIÓN 2026.)
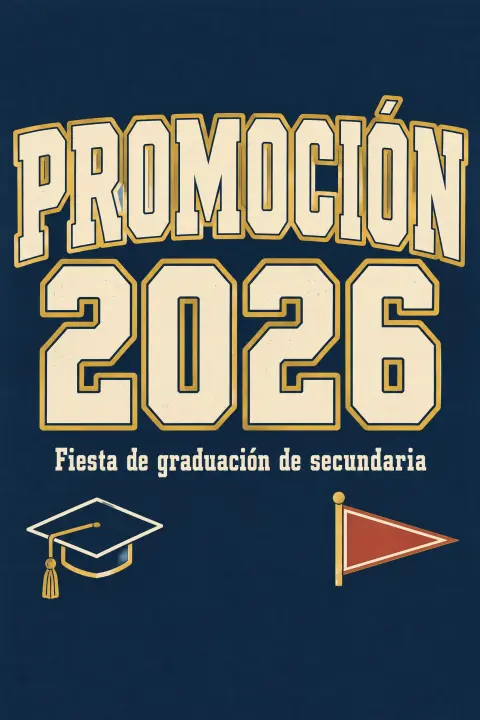
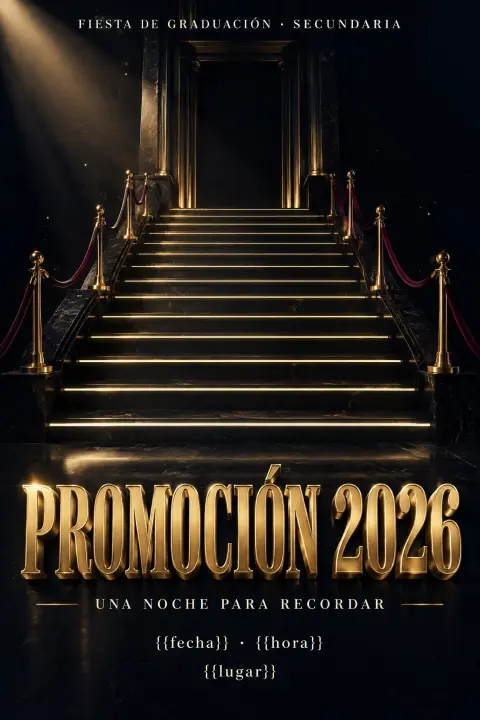
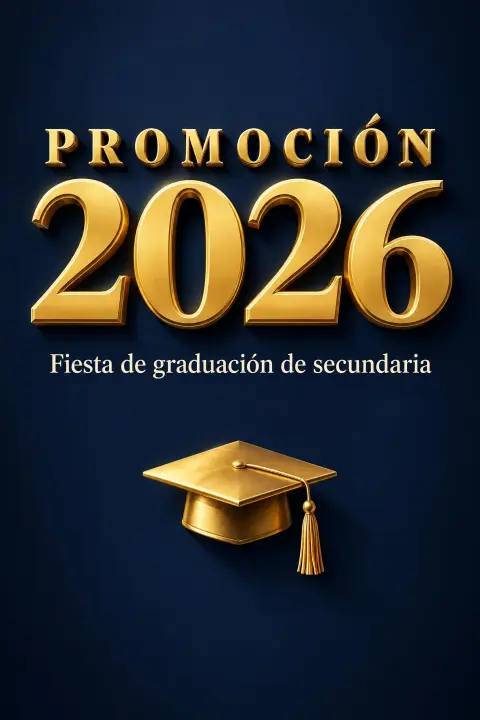
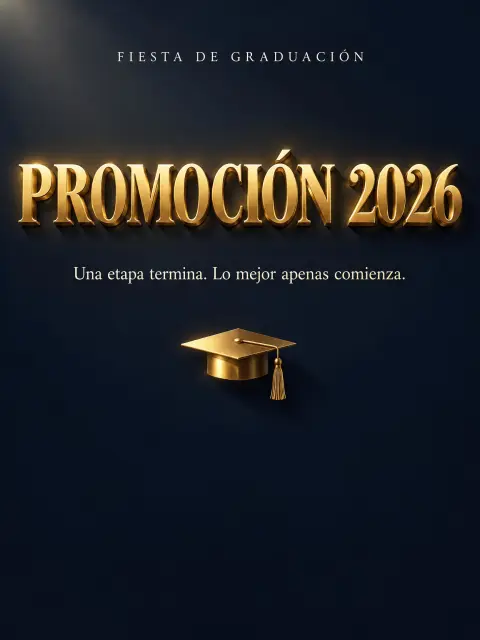
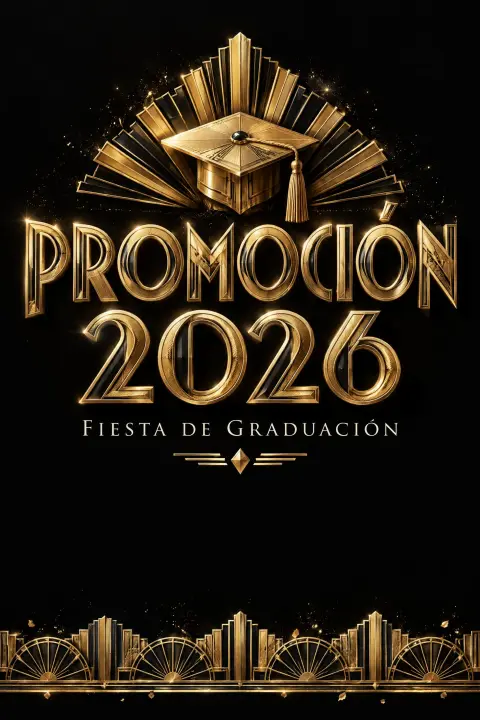
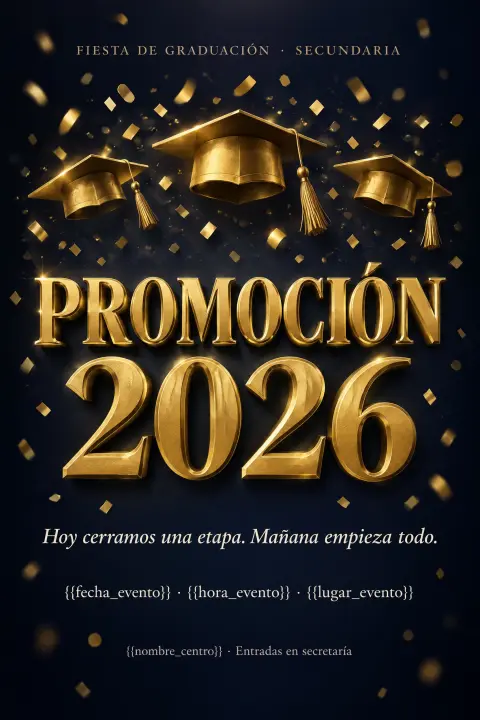
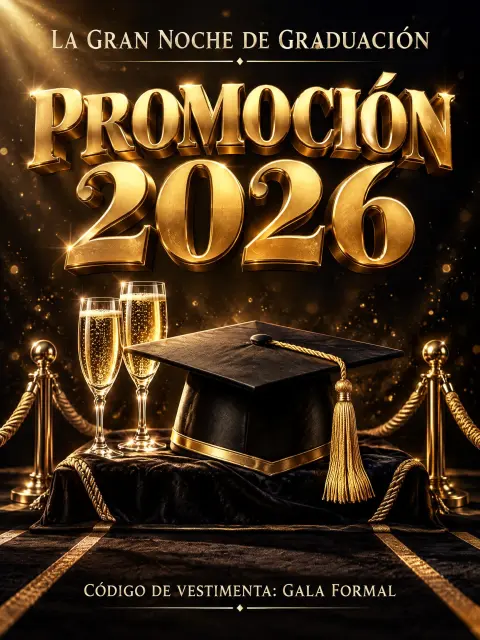
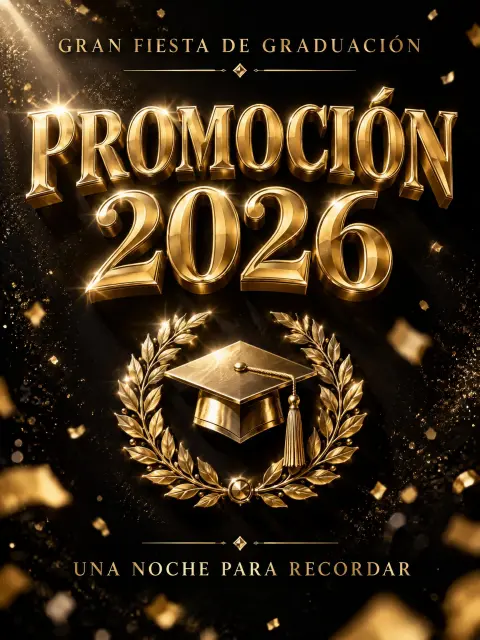
Jedes Modell schrieb PROMOCIÓN mit Akzent. Gemini 4 Argon (8.40) und Gemini 3.8 Flash (8.28) erreichten mit goldener Schrift und Lorbeerkränzen die höchsten Noten, allerdings fügte eines der Designs von Argon eine formelle Kleiderordnung hinzu, und zwei Designs dieser Aufgabe zeigten Champagnergläser auf einer Schulfeier. Dieses Briefing hatte weder Datum noch Ort, und viele Designs ließen unten eine leere Fläche, wo diese Angaben hingehören würden, oder druckten dort Platzhalter wie {{fecha}}.
Ebene 2: Die Information richtig umsetzen
Aufgabe 4: YouTube-Thumbnail
YouTube thumbnail text for a video about losing 30 pounds, title THE SHIFT
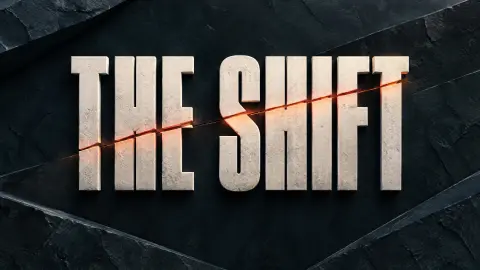
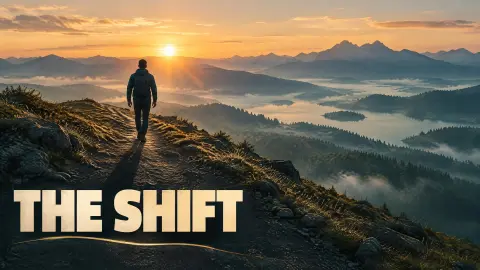
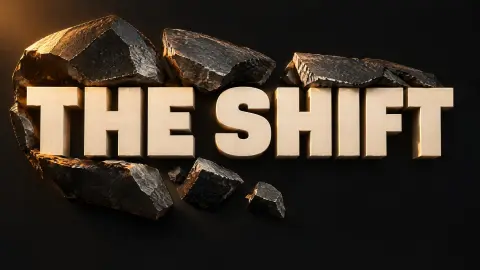
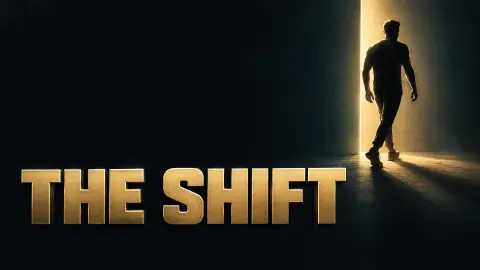
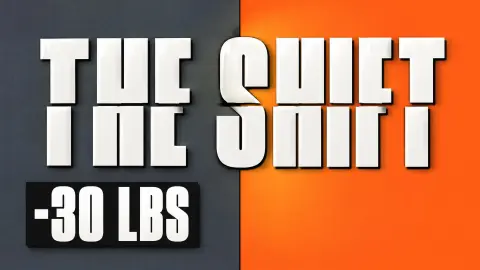
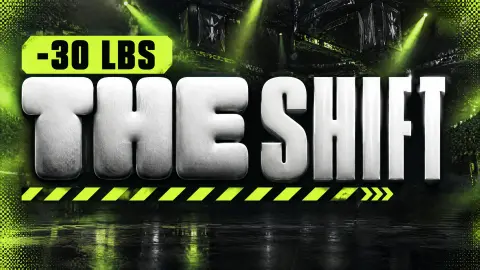
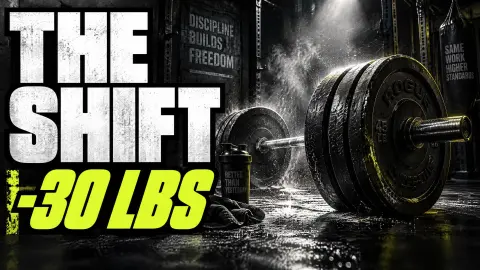
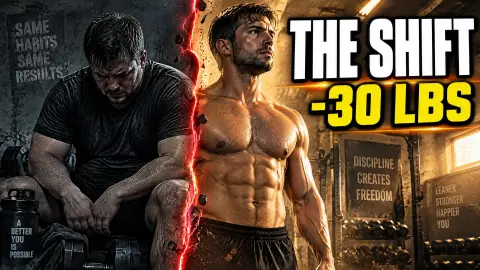
Claude Sonnet 5.5 erreichte die höchste Note, 8.20, mit einem "THE" aus Ton im Kontrast zu einem verspiegelten "SHIFT", um die Veränderung zu zeigen. GPT-6 Luna erreichte 7.97. Claude Opus 5.5 landete mit 6.53 auf dem letzten Platz: Sein erstes Design versetzte die Hälften jedes Buchstabens gegeneinander, was wie ein Druckfehler wirkt. Gemini 4 Argon und Gemini 3.8 Flash füllten den Hintergrund mit Fitnessstudio-Slogans, die der Auftraggeber nie geschrieben hat.
Aufgabe 5: Stellenplakat mit sieben Angaben
招聘海报:标题「一起把账算明白」,副标题「马来西亚 AI 公司,招两位财务」,要写上公司名 Northwind Labs Sdn Bhd、月薪 RM6000-9000、地点吉隆坡 Bangsar、投递邮箱 jobs@northwindlabs.my、截止 10 月 15 日。标题最大,邮箱最小。 (Ein Stellenplakat mit Titel, Untertitel, Firmenname, Gehalt, Ort, E-Mail-Adresse und Bewerbungsschluss. Titel am größten, E-Mail am kleinsten.)
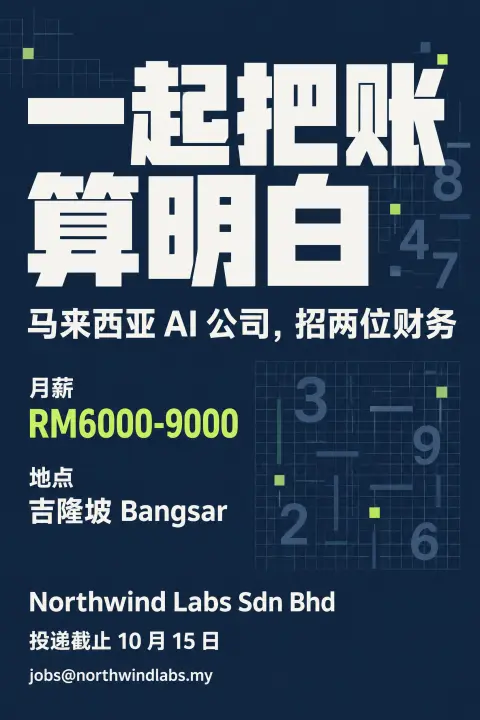
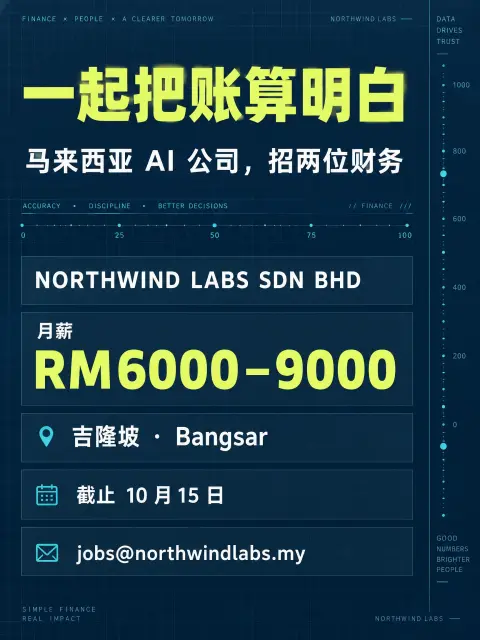
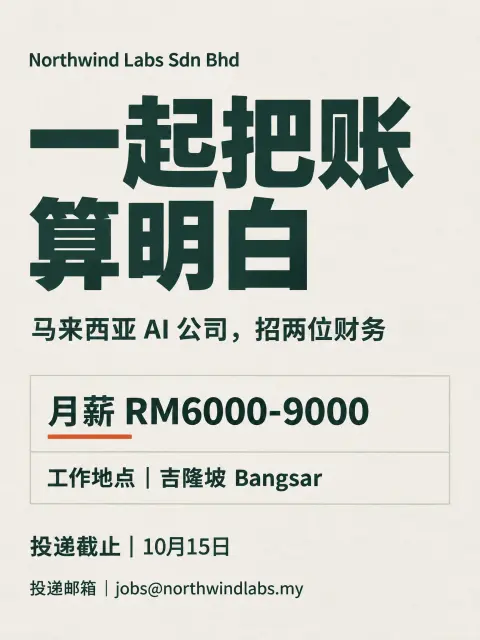
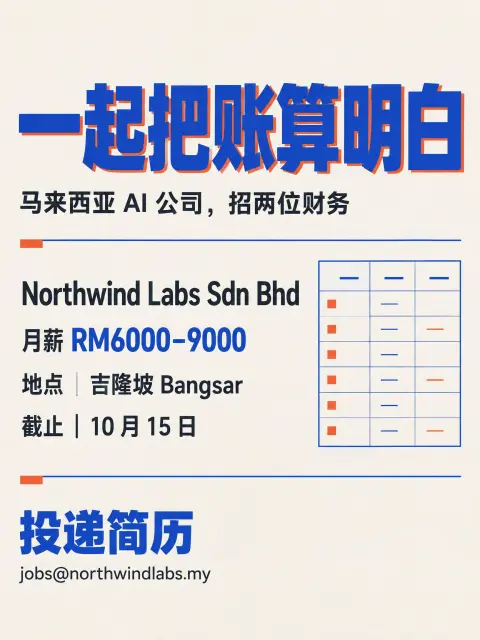
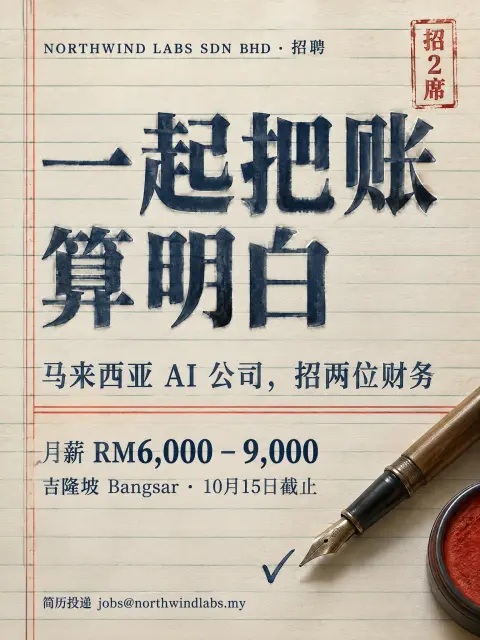
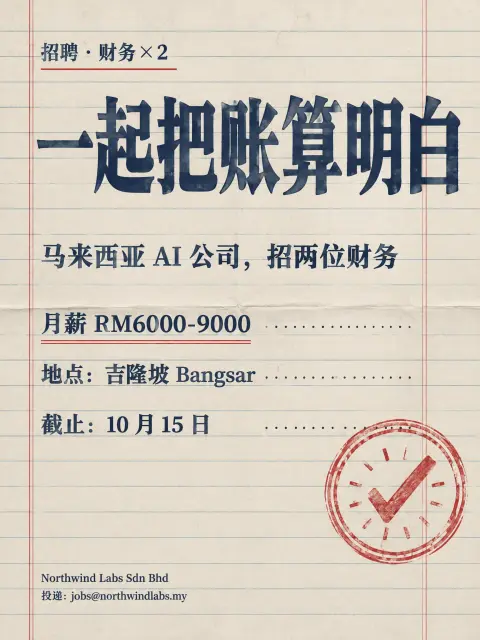
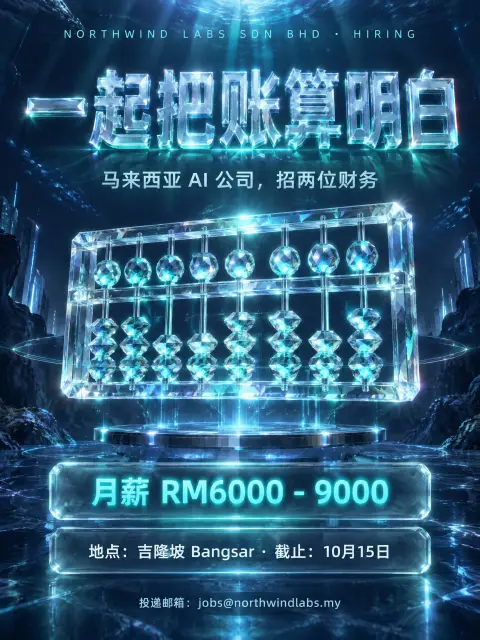
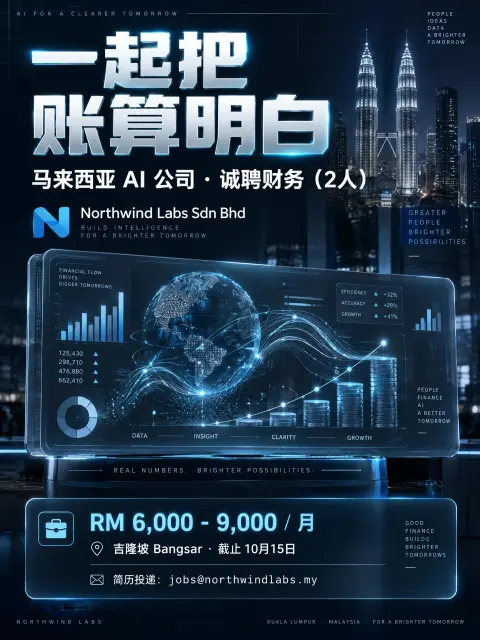
Diese Aufgabe trennte die Modelle am deutlichsten. Claude Sonnet 5.5 erreichte 7.92 mit einem Design auf Kontobuchpapier und einem roten Stempel, das alle sieben Angaben und die Größenordnung einhielt. Gemini 3.8 Flash erreichte die niedrigste Note, 6.12: Sein erstes Design füllte das Plakat mit englischen Slogans, einem Logo und Dashboards mit erfundenen Zahlen und veränderte den Untertitel des Auftraggebers. Claude Opus 5.5 scheiterte in allen drei Durchläufen am Token-Limit des Produktivbetriebs; mit verdoppeltem Limit machte es das beste Design der Aufgabe, 8.95, mit einem ähnlichen Titel in Tinte auf Papier, einem Siegel und einem Füllfederhalter.
Aufgabe 6: Kaffeebecher-Manschette
Uma capa para o copo de café para viagem da minha cafeteria em Belo Horizonte, a Grão de Ouro. Tem que ter o slogan "Café de verdade, sem pressa" e "Desde 1998". (Eine Manschette für die To-go-Becher meines Cafés, mit dem Namen, dem Slogan und "seit 1998".)
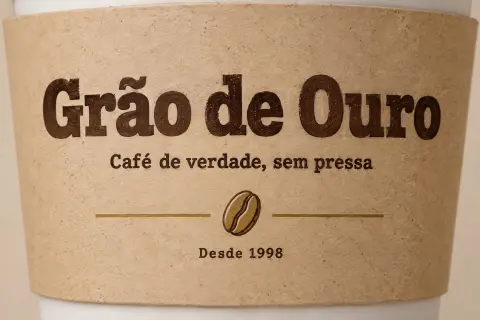
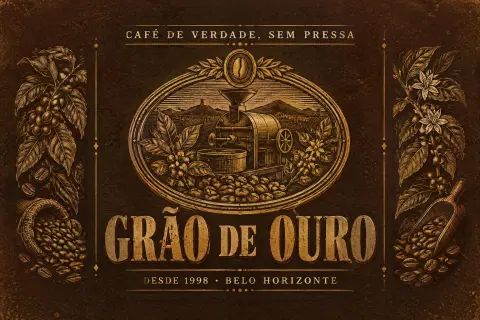
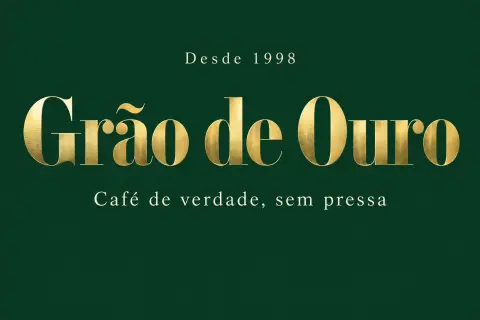
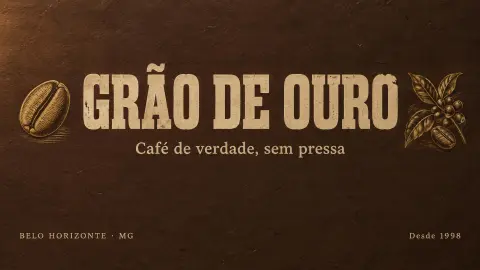
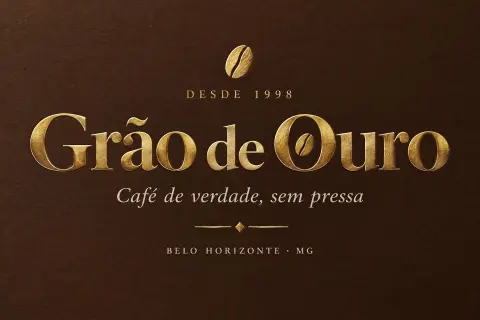
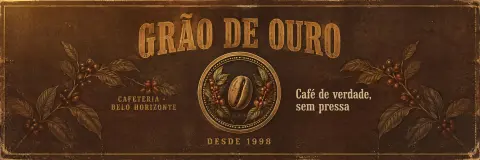
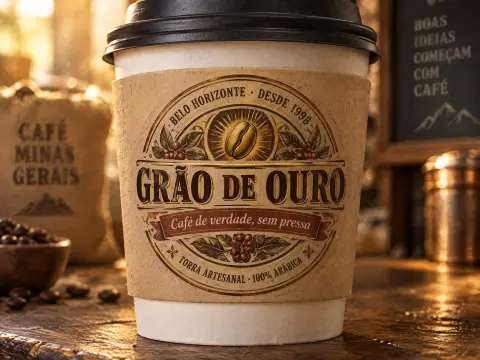
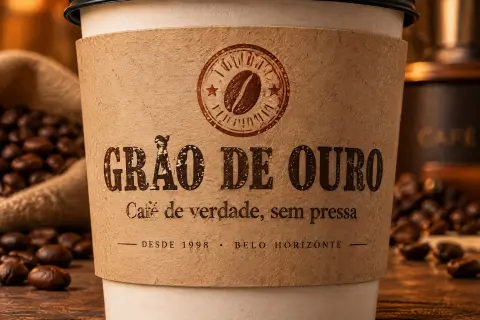
Claude Opus 5.5 erreichte in den zwei fertigen Durchläufen 8.97, mit Serifenschrift in Goldfolie und einem O aus einer Kaffeebohne. GPT-5.6 Terra (8.30) und Claude Sonnet 5.5 (8.38) folgten. Das erste Design von Gemini 3.8 Flash zeichnete die Tilde in GRÃO falsch, sodass der Name eher wie "GRÁO" aussieht. Gemini 4 Argon fügte Behauptungen wie "100% ARÁBICA" hinzu, die das Café nie aufgestellt hat. Für Goldfolien-Schrift allein gibt es den Goldtext-Generator.
Ebene 3: Gestalterisches Urteil
Aufgabe 7: Eine Nachtclub-Wortmarke mit widersprüchlichen Anforderungen
I want an extremely minimal, quiet, almost invisible wordmark for my nightclub — but it also has to scream across a dark street from 50 metres away and feel expensive. The name is VOID.
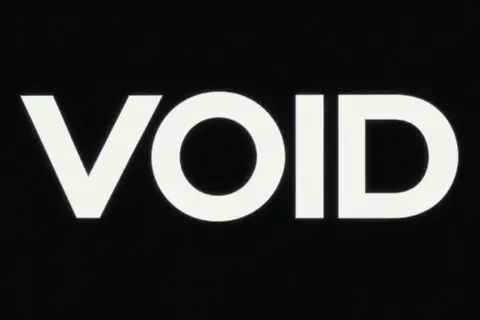
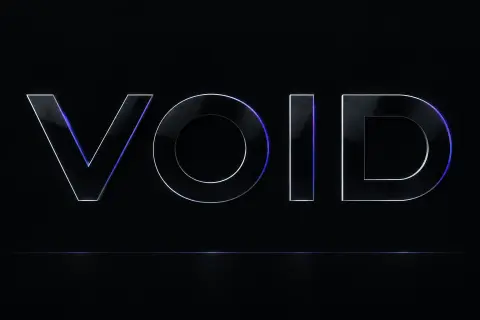
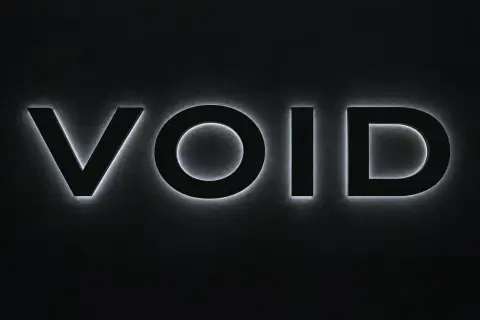
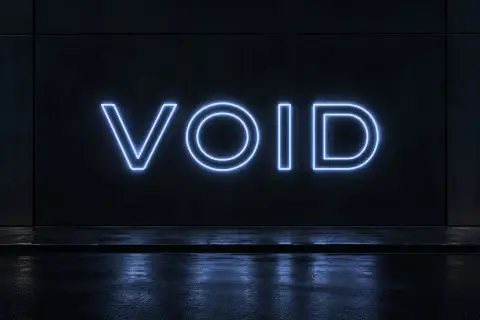
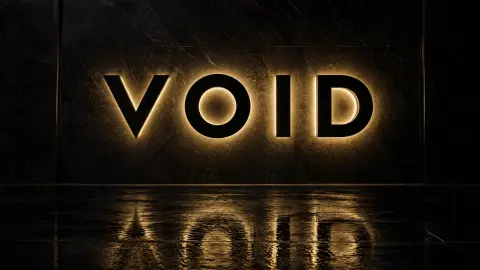
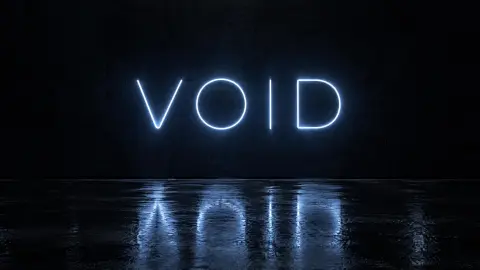
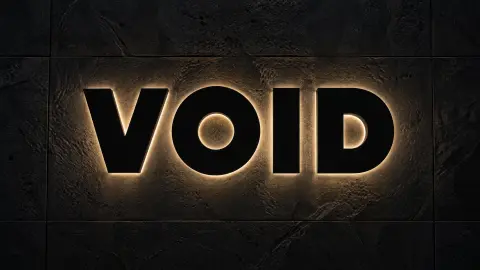
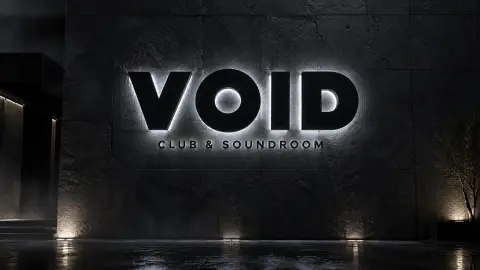
Die stärksten Designs lösten den Widerspruch mit Hinterleuchtung: schwarze Buchstaben auf einer schwarzen Wand, die aus der Nähe verschwinden und nachts leuchten. Gemini 4 Argon (8.13), Gemini 3.8 Flash (8.05) und Claude Opus 5.5 (7.88) setzten das am besten um. GPT-6.1 Terra landete mit 5.48 auf dem letzten Platz: Sein erstes Design ist flache, weiße, fette Schrift auf Schwarz, die zwar schreit, aber weder leise noch teuer wirkt. GPT-5.6 Terra erreichte 5.90. Für beleuchtete Schilder startet der Ladenschild-Maker mit leuchtenden Ladenschildern.
Aufgabe 8: Titelbild einer Fachzeitschrift
Cover art for a peer-reviewed paper on cryo-EM structural determination of amyloid fibrils. Title: CONFORMATIONAL POLYMORPHISM. It has to look like it belongs on the cover of Nature, not like a startup pitch deck.
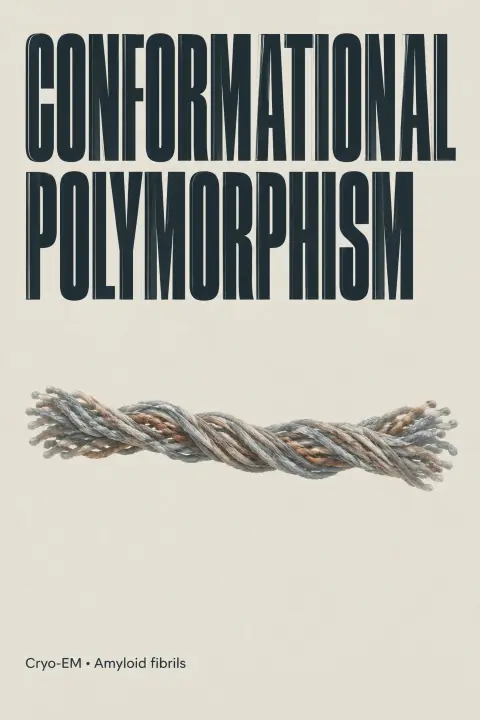
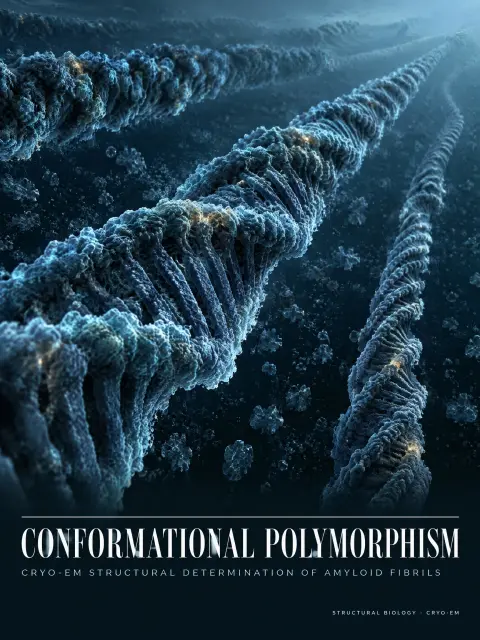
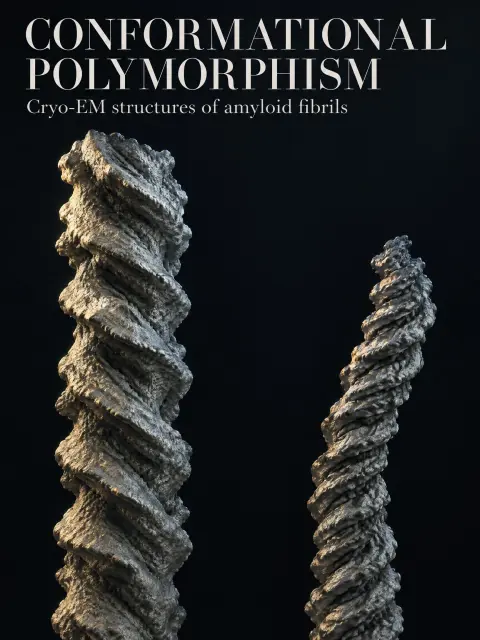
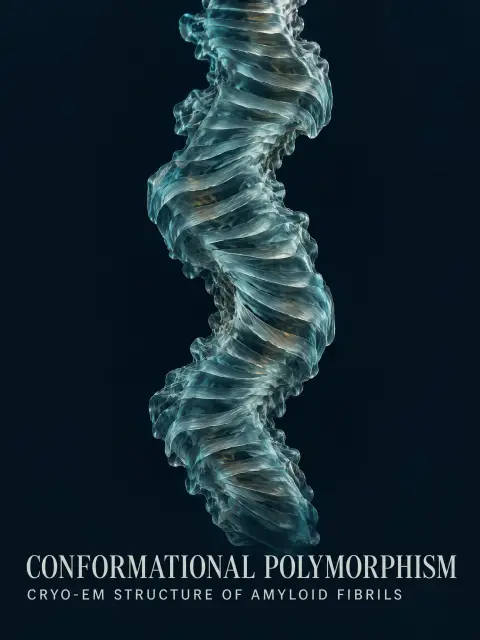
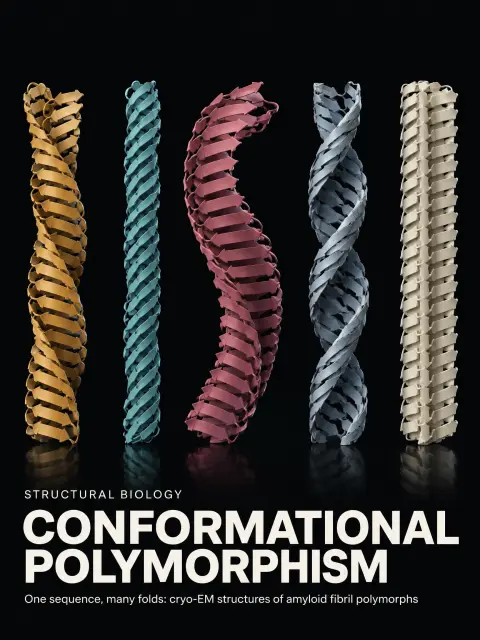
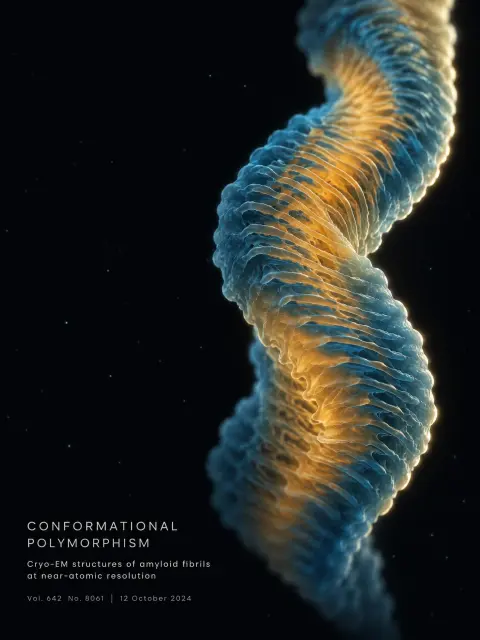
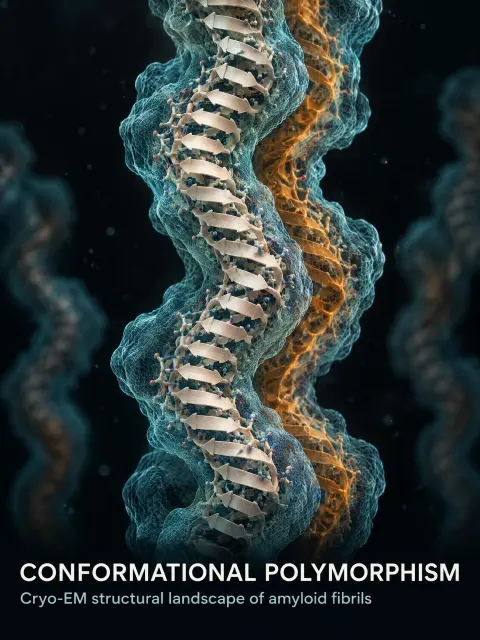
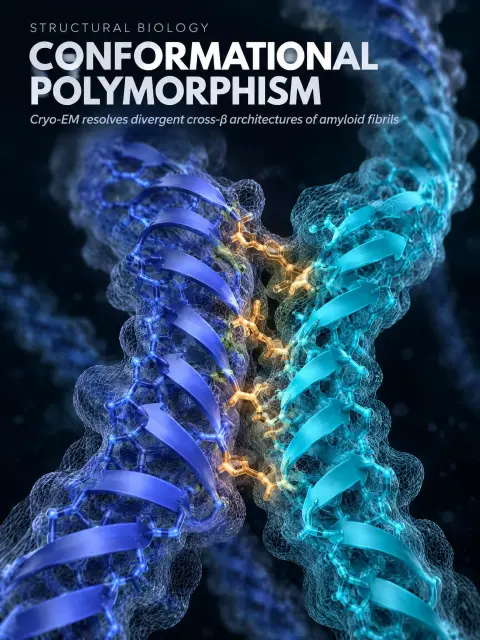
GPT-6.1 Sol (7.65), GPT-5.6 Terra (7.47) und GPT-6 Luna (7.43) erreichten mit zurückhaltenden Serifentiteln und gläsernen Fibrillen die höchsten Noten. Mehrere Designs zeichneten die Fibrillen als leiterartige Doppelhelix, die wie DNA aussieht, ein wissenschaftlicher Fehler auf einem Titelbild über Amyloid. Claude Sonnet 5.5 erfand einen Jahrgang, eine Ausgabe und ein Datum. Claude Opus 5.5 scheiterte in allen drei Durchläufen am Limit des Produktivbetriebs.
Aufgabe 9: Schild eines Tattoostudios für zwei Zielgruppen
A shop sign for my tattoo studio called INKWELL. It should still feel welcoming to my grandmother's generation.
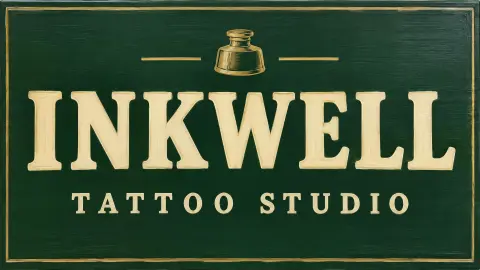
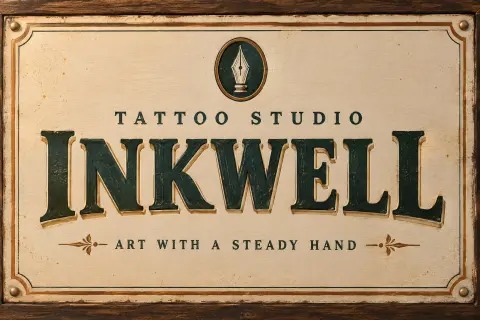
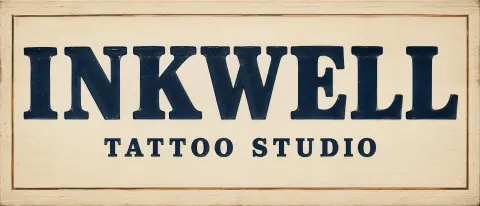
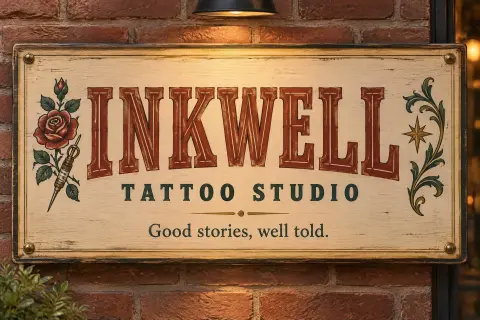
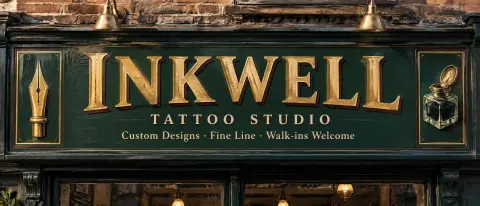
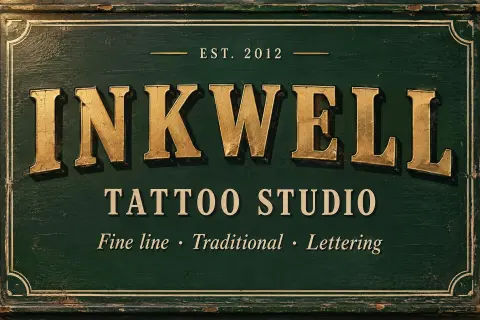
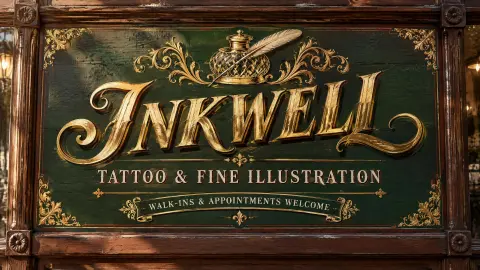
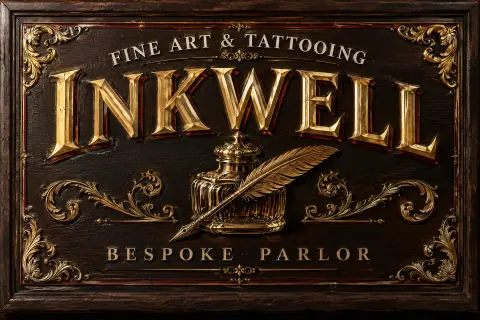
Erfundener Text war in dieser Aufgabe überall: Taglines, Leistungslisten, "Walk-ins welcome" und zwei erfundene Gründungsjahre. Claude Opus 5.5 erreichte die höchste Note, 8.25, und GPT-6 Luna 7.95. Gemini 4 Argon landete mit 6.37 auf dem letzten Platz: Sein erstes Design nutzte ein verziertes großes I, das sich wie ein J liest, sodass der Name wie "JNKWELL" aussieht. Die Designs, die nur den Namen und "Tattoo Studio" druckten, waren korrekt, aber oft schlicht.
Ebene 4: Sprache und Kultur
Aufgabe 10: Japanisches Schild für einen Stand mit geschabtem Eis
夏祭りの屋台の看板を作ってください。「かき氷」と書いて、昭和レトロな駄菓子屋の雰囲気で。提灯の灯りみたいな温かさがほしい。 (Ein Schild für einen Stand auf einem Sommerfest mit der Aufschrift かき氷, in der Stimmung eines Süßwarenladens im Showa-Retro-Stil und mit der Wärme von Laternenlicht.)
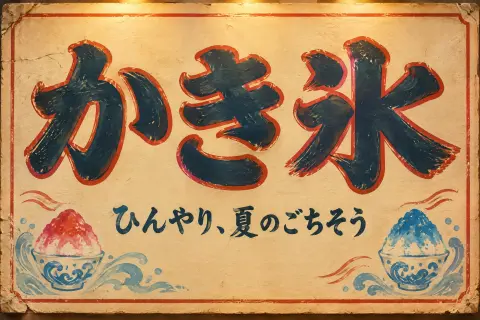
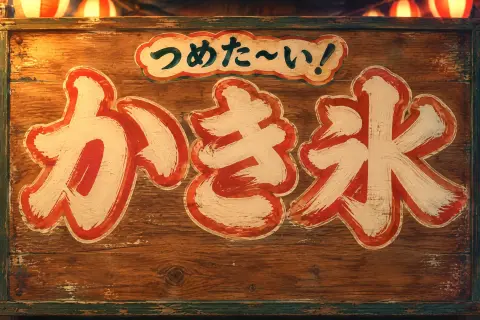
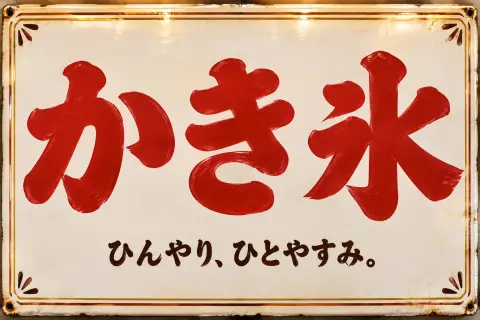
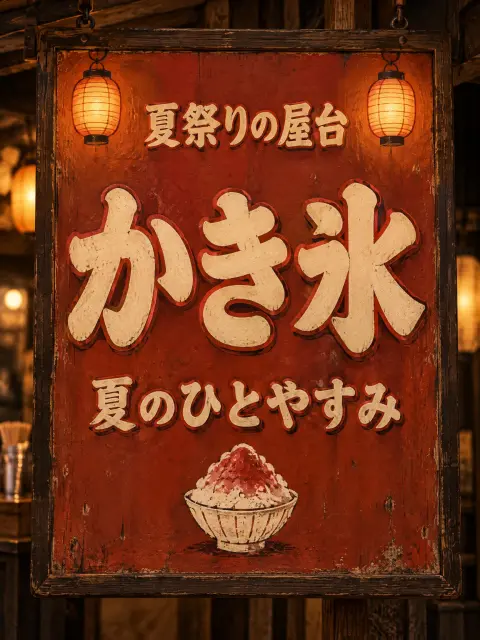
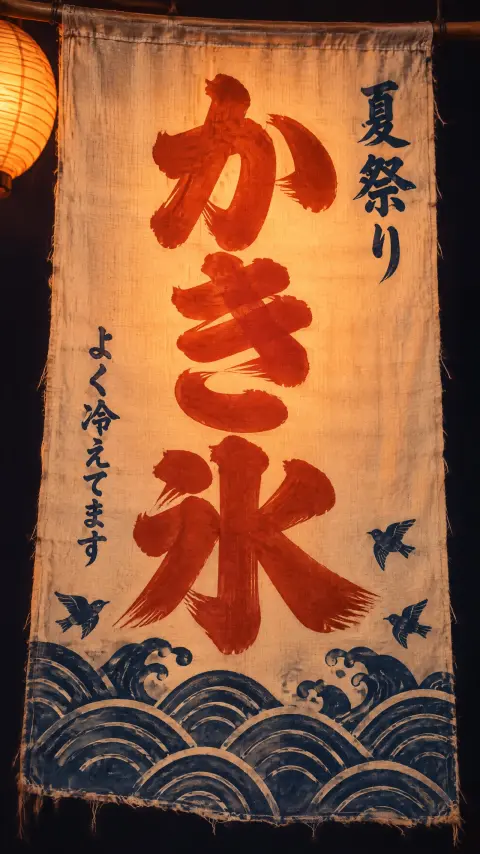
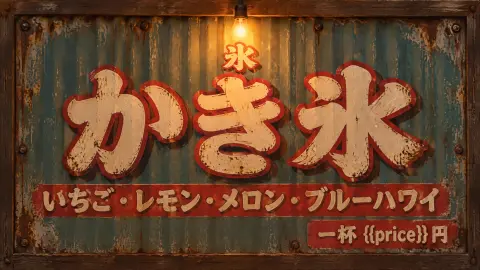
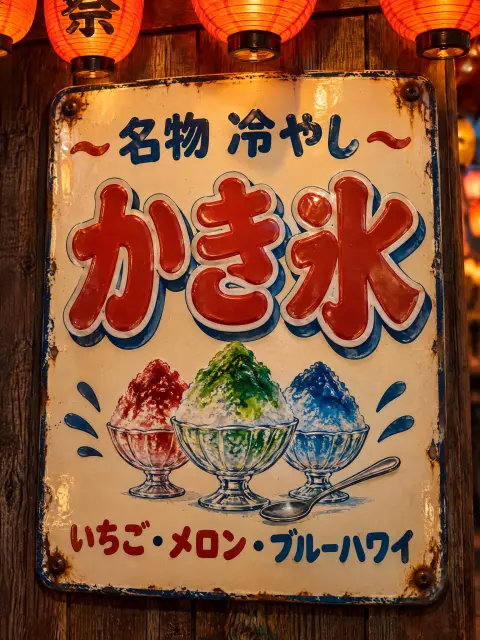
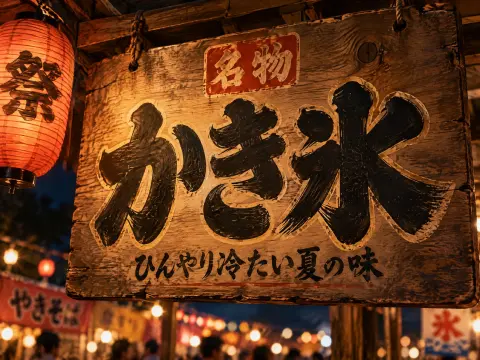
Jedes Modell schrieb かき氷 richtig. Claude Opus 5.5 (8.55), Gemini 4 Argon (8.38) und GPT-5.6 Terra (8.27) erreichten mit gefärbten Stoffbannern und Emailleschildern die höchsten Noten. Die meisten Designs fügten eine kurze Zeile wie "ひんやり" (schön kühl) oder eine Liste von Sirupsorten hinzu, was gegen sie zählte. Zwei Designs druckten {{price}}, und eines erfand einen Preis.
Aufgabe 11: Eröffnungsschild einer deutschen Bäckerei
Ein Schild für die Neueröffnung unserer Bäckerei „Großmanns Backstube" in Leipzig. Öffnungszeiten: Mo–Sa 6:30–18 Uhr, So 7–12 Uhr. Gemütlich, aber nicht kitschig.
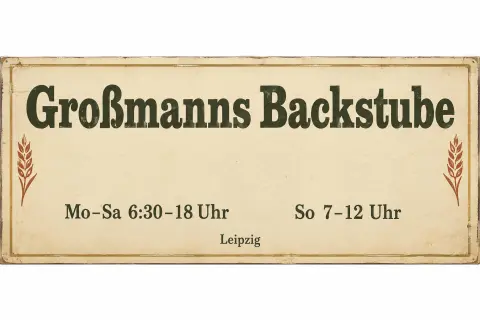
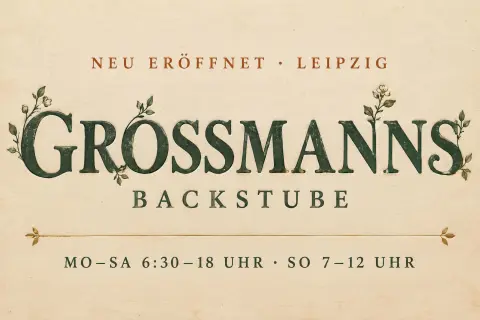
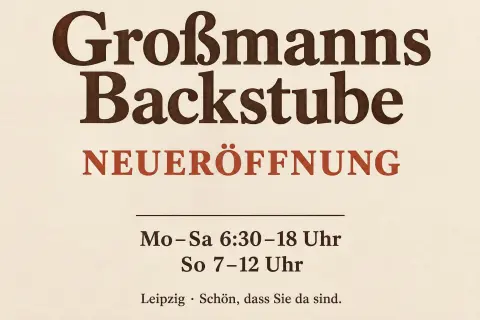
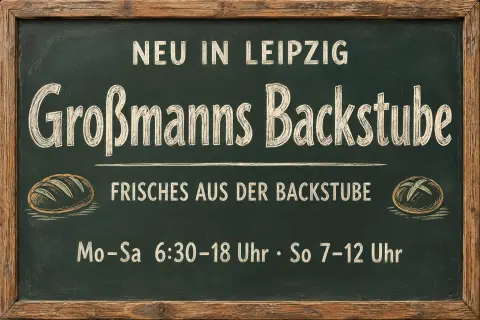
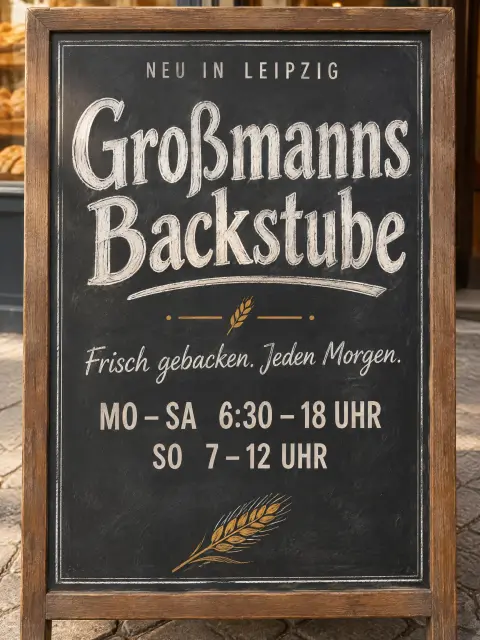
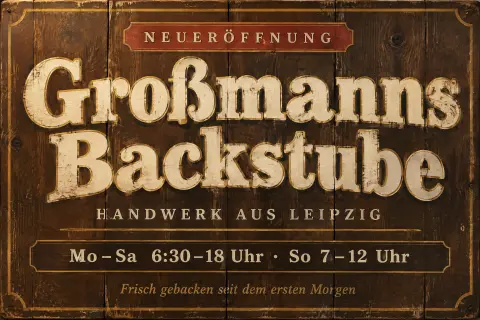
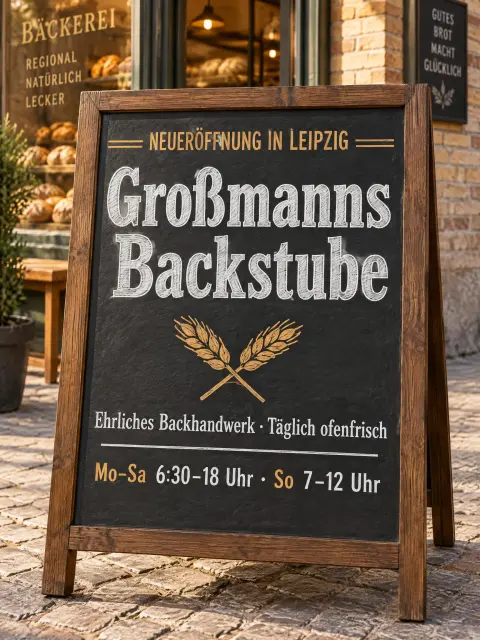
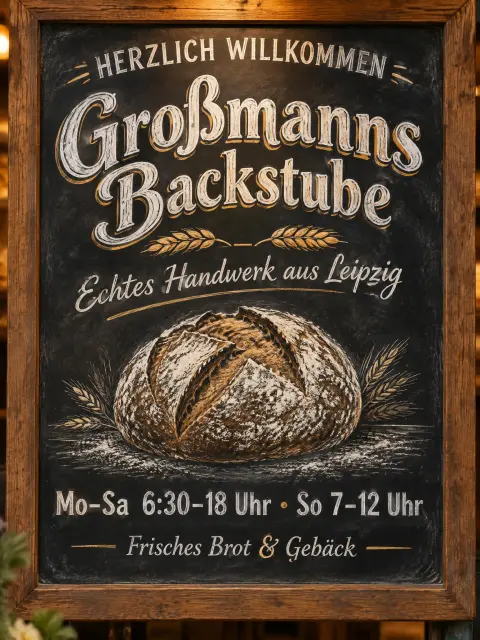
Jedes Modell schrieb Großmanns mit ß. Claude Sonnet 5.5 erreichte die höchste Note, 8.03, mit verwitterter Konturschrift auf Holz. GPT-6.1 Terra (6.32) und GPT-6.1 Sol (6.62) setzten das Schild in flache digitale Schrift ohne Wärme. Alle drei Designs von Claude Sonnet 5.5 fügten Slogans hinzu, die die Bäckerei nie geschrieben hat, etwa "Frisch gebacken seit dem ersten Morgen", und die von Gemini 3.8 Flash ebenso. Claude Opus 5.5 scheiterte in allen drei Durchläufen am Limit des Produktivbetriebs.
Aufgabe 12: Einladung zum Día de Muertos
Invitación para la reunión familiar de Día de Muertos en casa de la abuela Rosa. Domingo 1 de noviembre de 2026, 7 de la noche, Calle Hidalgo 45, Oaxaca. Algo cálido y respetuoso, no de disfraz. (Eine Einladung zum Familientreffen am Tag der Toten im Haus von Oma Rosa, mit Datum, Uhrzeit und Adresse. Warm und respektvoll, keine Kostümparty.)
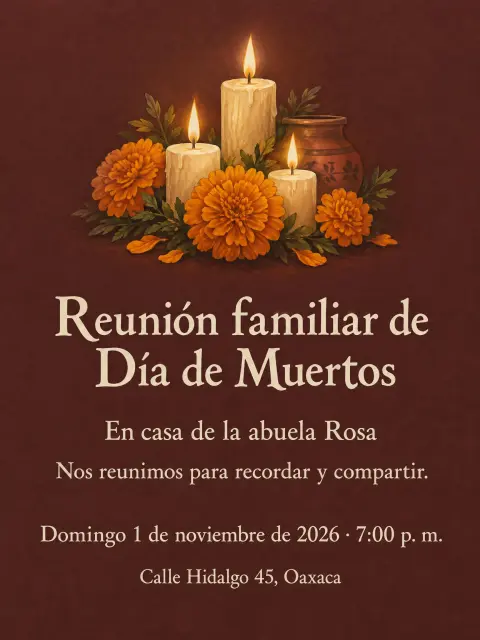
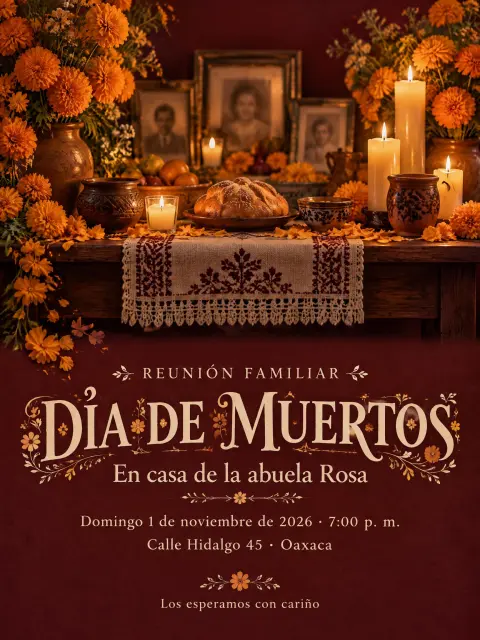
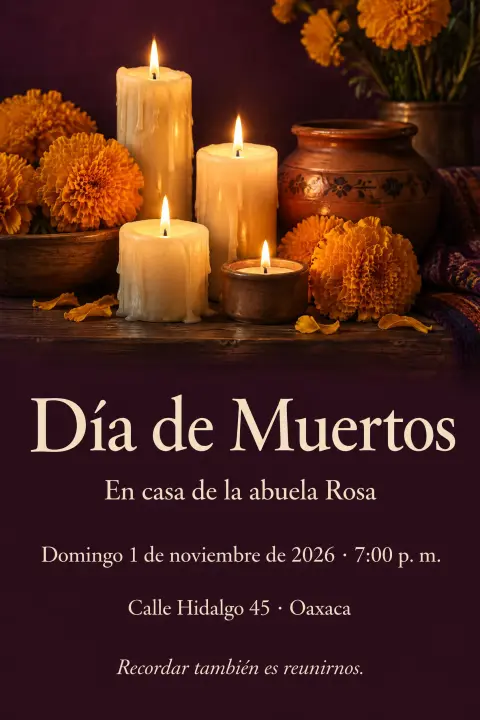
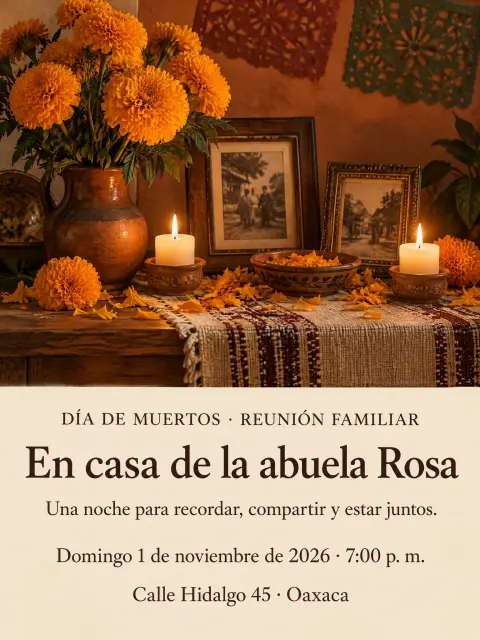
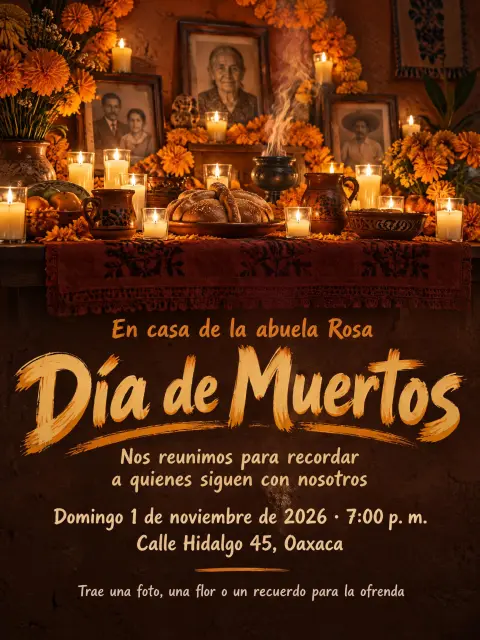
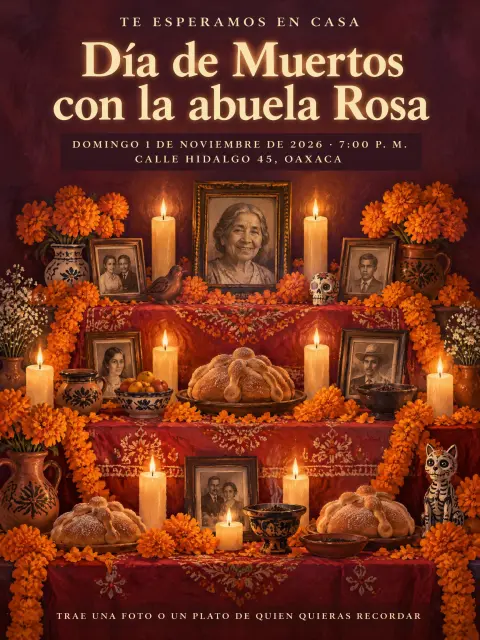
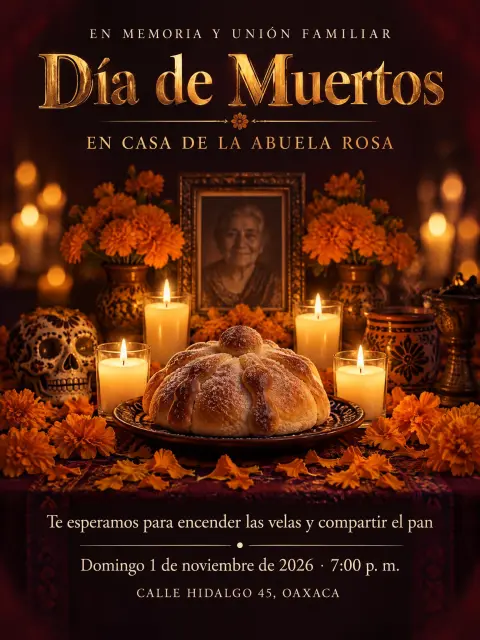
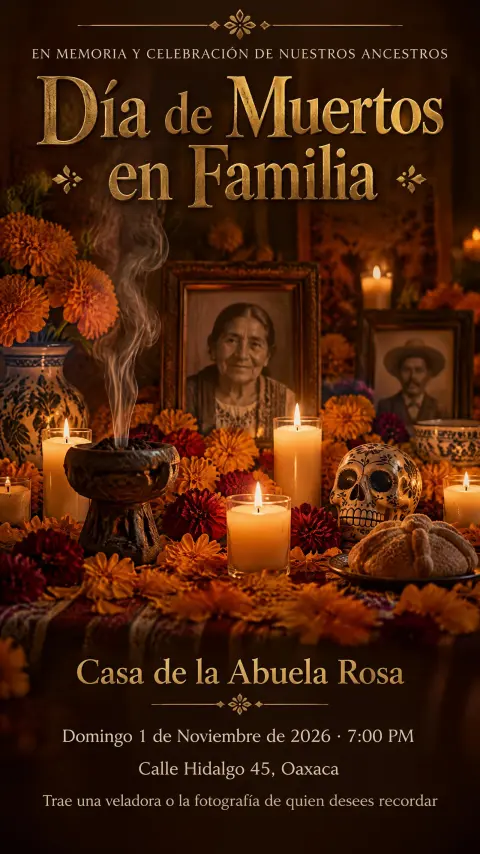
Kein Design machte aus dem Treffen eine Halloween-Kostümparty, und jedes behielt Datum und Adresse bei. Fast alle änderten "7 de la noche" in "7:00 p. m.". GPT-5.6 Terra erreichte die höchste Note, 8.22. Ein subtileres Problem zeigte sich in mehreren Designs: das Porträt einer älteren Frau in der Mitte des Altars, direkt neben "abuela Rosa", was sich liest, als sei Rosa selbst gestorben. Claude Opus 5.5 scheiterte in allen drei Durchläufen am Limit des Produktivbetriebs.
Claude Opus 5.5 mit größerem Budget
FontVibe begrenzt einen Designentwurf auf 6600 Ausgabe-Tokens, das Denken eingeschlossen. Claude Opus 5.5 schrieb längere Entwürfe als jedes andere Modell. Seine Entwürfe erreichten dieses Limit in 19 seiner 36 Durchläufe: 17 wurden abgeschnitten und scheiterten, 2 wurden trotzdem fertig. Ein weiterer Durchlauf scheiterte aus einem anderen Grund: Der Entwurf lag unter dem Limit, aber die Bildanweisungen im zweiten Schritt kamen als fehlerhafte Ausgabe zurück. Bei den anderen Modellen erreichte nur ein Entwurf von GPT-6 Luna das Limit, und er wurde fertig.
Um zu sehen, was Opus macht, wenn es nicht abgeschnitten wird, habe ich nur seine 18 gescheiterten Durchläufe wiederholt, mit beiden Ausgabelimits verdoppelt und sonst unverändert. Alle 18 wurden fertig. 13 davon nutzten mehr als 6600 Tokens für den Entwurf (Median 7286, längster 8890), und der Entwurf dauerte im Median 76 Sekunden. Die 18 Designs erreichten 8.10, und alle 36 Opus-Designs zusammen erreichten 8.04 (95%-KI 7.70–8.30). Briefing für Briefing mit den anderen Modellen über alle 12 Briefings verglichen, erreichten diese 36 Designs klar höhere Noten als GPT-5.6 Terra (+0.46), Claude Sonnet 5.5 (+0.60), GPT-6.1 Sol (+0.68), Gemini 3.8 Flash (+0.71) und GPT-6.1 Terra (+0.96) und ließen sich nicht von GPT-6 Luna (+0.35, 95%-KI −0.06 bis +0.71) oder Gemini 4 Argon (+0.48, −0.05 bis +0.98) unterscheiden.
Diese Wiederholungen sind nicht im Hauptranking, weil kein anderes Modell ein größeres Budget bekam. Das Limit von 6600 Tokens hat FontVibe für den eigenen Produktivbetrieb festgelegt, es ist keine Grenze des Modells. Die Wiederholungen zeigen, dass Opus mit genug Budget jedes Mal fertig wird und seine Qualität hält, um den Preis höherer Kosten und längerer Wartezeit. Sein Durchschnitt in der Haupttabelle beruht auf 18 Designs bei 8 Briefings, und die meisten Briefings, an denen es scheiterte, waren die Briefings der Ebenen 2 bis 4 mit mehr zu planendem Text, also stützt sich dieser Durchschnitt auf die leichteren Briefings; deshalb hat es dort keinen Rang.
Eine Blindauswahl durch jemanden, der nicht der Auftraggeber war
Der Gründer von FontVibe hat sich für jede Aufgabe ein Design pro Modell angesehen, in zufälliger Reihenfolge und mit verborgenen Namen, und das ausgewählt, das er verwenden würde. Seine 12 Auswahlen: Gemini 3.8 Flash 4, Claude Sonnet 5.5 3, GPT-5.6 Terra 2, Gemini 4 Argon 2 und Claude Opus 5.5 1. GPT-6 Luna und keines der beiden GPT-6.1-Modelle hat er je ausgewählt.
Unter den acht Designs, die er pro Aufgabe sah, war seine Auswahl in 2 von 12 Aufgaben das von den Juroren am besten bewertete; das insgesamt bestbewertete Design der Aufgabe war sie nie. Der Unterschied hat eine klare Ursache: 8 seiner 12 Auswahlen enthalten Text, den das Briefing nie geliefert hat. Bei Schrift und Wirkung erreichten seine Auswahlen fast immer 7 bis 9, was zeigt, dass auch die Juroren diese Designs visuell als stark sahen; ihre Punkte verloren die Auswahlen bei der Information.
Er liest die Lücke so: Bei keinem dieser Briefings war er der Auftraggeber, also hat er nach dem ersten Eindruck gewählt. Ein Auftraggeber, der das Design braucht, schaut zuerst auf das Gefühl, dann auf die Details, und behandelt falschen oder erfundenen Text als harten Fehler. Deshalb tragen die Noten nach dem Bewertungsschema das Ranking, und diese Auswahl ist eine Randnotiz. Sie zeigt auch das Risiko für alle, die nach dem ersten Eindruck wählen: Das Design, das zuerst die Aufmerksamkeit fängt, ist oft das, das Text hinzugefügt hat, den man nicht geschrieben hat.
Jedes Modell in Kürze
- Claude Opus 5.5: die beste Schrift und Wirkung und wenige erfundene Zeilen (0.22 pro Design). Die längsten Entwürfe und das längste Nachdenken, deshalb braucht es ein weiteres Ausgabelimit als das von FontVibe im Produktivbetrieb; das langsamste und mit Abstand das teuerste. Passt zu komplexer Arbeit, die keine Eile hat.
- GPT-6 Luna: das beste Preis-Leistungs-Verhältnis: in der obersten Qualitätsgruppe, jeden Durchlauf abgeschlossen, hohe Lesbarkeit, wenige erfundene Zeilen und mit großem Abstand das günstigste. Seine Schrift ist gut, bleibt aber nicht im Gedächtnis.
- GPT-5.6 Terra: schnell und ausgewogen. Stark in Ebene 4 und in den meisten alltäglichen Briefings, am schwächsten in Ebene 3, wo es auf ein schwieriges Briefing oft mit schlichter Schrift antwortete.
- Gemini 4 Argon: einige der reichsten Materialien im Test und 1.56 erfundene Zeilen pro Design.
- Claude Sonnet 5.5: die schnellsten Entwürfe und starke Schrift sowie die meisten unverändert gedruckten Platzhalter (5 Designs).
- GPT-6.1 Sol: die lesbarsten Designs und wenige erfundene Zeilen, aber schlichte Schrift, und langsam in beiden Schritten (zusammen etwa 87 Sekunden).
- Gemini 3.8 Flash: visuell stark, der meiste erfundene Text (2.36 Zeilen pro Design) und das einzige Modell mit Fehlern des Anbieters (8).
- GPT-6.1 Terra: der sauberste Text und die schlichtesten Designs.
Grenzen dieses Tests
- Die Juroren laufen mit Claude Opus 5.5, das auch eines der getesteten Modelle ist. Die Bilder waren anonym, aber die Juroren und ein Teilnehmer teilen sich ein Modell, und ob sie seine Designs bevorzugen, wurde nicht getestet.
- Jedes Briefing wurde einmal bewertet, von einem Juror in einem Durchgang. Es gab keine wiederholte Bewertung und keinen zweiten Juror.
- Die Hauptnote von Claude Opus 5.5 beruht auf 18 Designs bei 8 Briefings, überwiegend den leichteren.
- Ein einziges Bildmodell hat jedes Design gerendert. Ein anderes Bildmodell könnte verändern, wie viel die Anweisungen des Designers ausmachen.
- Jedes Modell bearbeitete jedes Briefing dreimal, und jeder Durchlauf renderte nur die erste seiner drei vorgeschlagenen Richtungen. Bei 12 Briefings sind die meisten Unterschiede zwischen den Modellen zu klein, um sie zu unterscheiden; 28 Paare wurden ohne Korrektur für multiples Testen verglichen.
- Der Bewertungsstandard deckt Designs mit Text ab. Bilder ohne Text wurden nicht getestet.
- Alle Modelle nutzten die Prompts und Limits des Produktivbetriebs von FontVibe. Die Prompts oder Limits einer anderen App könnten andere Modelle begünstigen.
- Die Ergebnisse beschreiben diese Modellversionen am 30. Oktober 2026.
Jedes Design ist öffentlich auf FontVibe zu sehen, und jede Note hat eine schriftliche Begründung. Die Briefings, alle Entwürfe, die Anweisungen an das Bildmodell, Noten und Begründungen stehen im offenen Datensatz AI Design Benchmark (CC BY 4.0), zusammen mit jedem Versuch und einem Skript, das alle Tabellen dieses Artikels nachrechnet. Die Produktiv-Prompts von FontVibe sind nicht veröffentlicht; Forschende, die sie brauchen, können unter hello@fontvibe.ai danach fragen.
Anhang: jede Note
Durchschnittliche Gesamtnote pro Modell und Aufgabe über die fertigen Durchläufe (Anzahl fertiger Durchläufe in Klammern, wenn es weniger als 3 sind).
| Aufgabe | GPT-6.1 Terra | GPT-5.6 Terra | GPT-6.1 Sol | GPT-6 Luna | Claude Opus 5.5 | Claude Sonnet 5.5 | Gemini 4 Argon | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|---|---|
| 1. Wortmarke einer Kaffeerösterei | 6.62 | 8.13 | 6.43 | 8.05 | 8.38 | 7.50 | 7.53 | 7.92 |
| 2. Dinosaurier-Geburtstagsplakat | 8.43 | 8.33 | 8.73 | 8.17 | 8.20 | 7.03 | 6.48 | 7.33 |
| 3. Plakat zur Abschlussfeier | 6.37 | 7.03 | 7.07 | 7.28 | 7.50 (1) | 7.13 | 8.40 | 8.28 |
| 4. YouTube-Thumbnail | 7.18 | 7.12 | 7.27 | 7.97 | 6.53 | 8.20 | 7.88 | 7.75 |
| 5. Stellenplakat | 7.20 | 6.98 | 7.30 | 7.43 | gescheitert | 7.92 | 7.50 | 6.12 |
| 6. Kaffeebecher-Manschette | 7.83 | 8.30 | 7.58 | 7.93 | 8.97 (2) | 8.38 | 7.27 | 7.25 |
| 7. Nachtclub-Wortmarke | 5.48 | 5.90 | 6.67 | 7.25 | 7.88 | 7.28 | 8.13 | 8.05 |
| 8. Titelbild einer Fachzeitschrift | 6.22 | 7.47 | 7.65 | 7.43 | gescheitert | 6.63 | 7.28 | 6.68 |
| 9. Schild eines Tattoostudios | 7.53 | 7.80 (2) | 7.33 | 7.95 | 8.25 (2) | 6.78 | 6.37 | 6.38 |
| 10. Schild für geschabtes Eis | 8.20 | 8.27 | 7.78 | 7.45 | 8.55 (1) | 6.98 | 8.38 | 7.80 |
| 11. Eröffnungsschild einer Bäckerei | 6.32 | 7.43 | 6.62 | 7.25 | gescheitert | 8.03 | 7.78 | 7.02 |
| 12. Einladung zum Día de Muertos | 7.57 | 8.22 | 7.80 | 8.08 | gescheitert | 7.32 | 7.68 | 7.40 |
Alle paarweisen Vergleiche
Jedes Paar wird über die Briefings verglichen, bei denen beide Modelle Designs fertiggestellt haben: die durchschnittliche Differenz ihrer Noten pro Briefing (erstes Modell minus zweites), mit einem 95%-Konfidenzintervall. Schließt das Intervall die Null ein, lassen sich die beiden in diesem Test nicht unterscheiden.
| Modell | Verglichen mit | Briefings | Differenz (95%-KI) | Klar höher |
|---|---|---|---|---|
| Claude Opus 5.5 | GPT-6 Luna | 8 | +0.28 (−0.27 bis +0.73) | gleichauf |
| Claude Opus 5.5 | GPT-5.6 Terra | 8 | +0.42 (0.00 bis +0.96) | gleichauf |
| Claude Opus 5.5 | Gemini 4 Argon | 8 | +0.48 (−0.33 bis +1.29) | gleichauf |
| Claude Opus 5.5 | Claude Sonnet 5.5 | 8 | +0.62 (−0.11 bis +1.18) | gleichauf |
| Claude Opus 5.5 | GPT-6.1 Sol | 8 | +0.68 (+0.10 bis +1.27) | Claude Opus 5.5 |
| Claude Opus 5.5 | Gemini 3.8 Flash | 8 | +0.44 (−0.27 bis +1.15) | gleichauf |
| Claude Opus 5.5 | GPT-6.1 Terra | 8 | +0.83 (+0.20 bis +1.47) | Claude Opus 5.5 |
| GPT-6 Luna | GPT-5.6 Terra | 12 | +0.11 (−0.19 bis +0.43) | gleichauf |
| GPT-6 Luna | Gemini 4 Argon | 12 | +0.13 (−0.35 bis +0.62) | gleichauf |
| GPT-6 Luna | Claude Sonnet 5.5 | 12 | +0.25 (−0.10 bis +0.60) | gleichauf |
| GPT-6 Luna | GPT-6.1 Sol | 12 | +0.33 (+0.03 bis +0.66) | GPT-6 Luna |
| GPT-6 Luna | Gemini 3.8 Flash | 12 | +0.36 (−0.08 bis +0.77) | gleichauf |
| GPT-6 Luna | GPT-6.1 Terra | 12 | +0.61 (+0.21 bis +0.98) | GPT-6 Luna |
| GPT-5.6 Terra | Gemini 4 Argon | 12 | +0.02 (−0.63 bis +0.64) | gleichauf |
| GPT-5.6 Terra | Claude Sonnet 5.5 | 12 | +0.15 (−0.39 bis +0.68) | gleichauf |
| GPT-5.6 Terra | GPT-6.1 Sol | 12 | +0.23 (−0.12 bis +0.63) | gleichauf |
| GPT-5.6 Terra | Gemini 3.8 Flash | 12 | +0.25 (−0.38 bis +0.78) | gleichauf |
| GPT-5.6 Terra | GPT-6.1 Terra | 12 | +0.50 (+0.21 bis +0.81) | GPT-5.6 Terra |
| Gemini 4 Argon | Claude Sonnet 5.5 | 12 | +0.13 (−0.28 bis +0.55) | gleichauf |
| Gemini 4 Argon | GPT-6.1 Sol | 12 | +0.21 (−0.42 bis +0.76) | gleichauf |
| Gemini 4 Argon | Gemini 3.8 Flash | 12 | +0.23 (−0.08 bis +0.53) | gleichauf |
| Gemini 4 Argon | GPT-6.1 Terra | 12 | +0.48 (−0.25 bis +1.16) | gleichauf |
| Claude Sonnet 5.5 | GPT-6.1 Sol | 12 | +0.08 (−0.47 bis +0.60) | gleichauf |
| Claude Sonnet 5.5 | Gemini 3.8 Flash | 12 | +0.10 (−0.35 bis +0.61) | gleichauf |
| Claude Sonnet 5.5 | GPT-6.1 Terra | 12 | +0.35 (−0.24 bis +0.91) | gleichauf |
| GPT-6.1 Sol | Gemini 3.8 Flash | 12 | +0.02 (−0.55 bis +0.57) | gleichauf |
| GPT-6.1 Sol | GPT-6.1 Terra | 12 | +0.27 (−0.02 bis +0.60) | gleichauf |
| Gemini 3.8 Flash | GPT-6.1 Terra | 12 | +0.25 (−0.40 bis +0.96) | gleichauf |
Der Bewertungsstandard
Die Anweisungen an die Juroren, kurz gefasst: Der Juror ist der Auftraggeber, der das Briefing geschrieben hat und dieses Design verwenden wird. Er urteilt in dieser Reihenfolge: ob es das ist, was er verlangt hat; ob jedes Stück Text so verwendet werden kann, wie es ist; ob es das Gefühl hat, das er wollte, ausgesprochen oder vernünftigerweise mitgemeint; wie gut Schrift, Materialien, Texturen, Linien und Farben gemacht sind; und ob es auf den ersten Blick beeindruckt. Jede der vier Noten deckt ihre eigene Frage ab, und ein Problem wird nur einmal abgezogen, unter der Note, zu der es gehört.
Häufige Fragen
Ist GPT-6.1 Terra beim Design besser als GPT-5.6 Terra?
In diesem Test nicht. Briefing für Briefing verglichen, erreichte GPT-6.1 Terra auf einer Skala bis 10 eine um 0.50 Punkte niedrigere Note als GPT-5.6 Terra, mit einem 95%-Konfidenzintervall von −0.81 bis −0.21, und schnitt bei 9 der 12 Briefings schlechter ab. Sein Text war sauberer, aber seine Schrift flacher und seine Wirkung schwächer. Beide Modelle liefen mit denselben Prompts und Einstellungen; das Ergebnis beschreibt, wie es ein Briefing liest, eine Richtung wählt und Bildanweisungen schreibt, nicht, wie es bei anderen Aufgaben abschneidet.
Welches Sprachmodell ist der beste Designer?
Rein nach Designqualität ließen sich die meisten der acht Modelle in diesem Test nicht unterscheiden; nur GPT-6.1 Terra und GPT-6.1 Sol lagen klar zurück. Claude Opus 5.5 hatte den höchsten Durchschnitt, war aber nicht klar besser als GPT-6 Luna oder Gemini 4 Argon, kostete weit mehr und war langsamer. GPT-6 Luna lag in der obersten Qualitätsgruppe, schloss jeden Durchlauf ab und kostete $0.005 pro Design, mit großem Abstand das beste Preis-Leistungs-Verhältnis. Für den Echtzeiteinsatz war GPT-5.6 Terra schnell und ausgewogen.
Erfinden KI-Designer Text?
Ja. Gemini 3.8 Flash fügte pro Design im Schnitt 2.36 Zeilen hinzu, die im Briefing nie vorkamen, etwa Gründungsjahre, Slogans und erfundene Statistiken. GPT-6.1 Terra fügte am wenigsten hinzu, 0.17 Zeilen pro Design. Erfundener Text war der häufigste Grund, warum ein Design bei der Information Punkte verlor.
Was kostet ein KI-Designer pro Design?
Zu den öffentlichen Preisen der Anbieter am 30. Oktober 2026 kostete der Sprachmodell-Anteil eines Designs im Median $0.005 mit GPT-6 Luna, $0.04 mit GPT-6.1 Terra oder Gemini 3.8 Flash, $0.09 mit GPT-5.6 Terra oder GPT-6.1 Sol, $0.11 mit Gemini 4 Argon, $0.18 mit Claude Sonnet 5.5 und $0.41 mit Claude Opus 5.5. Die Bilderzeugung ist nicht enthalten.
Kann ich diese KI-Designer selbst ausprobieren?
Der Design-Modus von FontVibe nutzt dieselbe Pipeline, die hier getestet wurde. Man beschreibt, was man braucht, er schlägt Designrichtungen vor und rendert die ausgewählte.
Bereit, es selbst auszuprobieren?
Setz diese Prompt-Techniken direkt um — kein Konto nötig, um loszulegen.
✦ Jetzt generierenFontVibe in Google als bevorzugte Quelle festlegen
Setz diese Prompt-Techniken direkt um — kein Konto nötig, um loszulegen.
Jetzt gestalten
Kommentare