Qwen Image 3.0 vs GPT Image, Nano Banana, Seedream & Grok
Qwen Image 3.0 Pro und vier konkurrierende Modelle, 10 identische Prompts mit viel Text, bewertet wurde jeweils das erste Bild. Nichts ausgesucht.
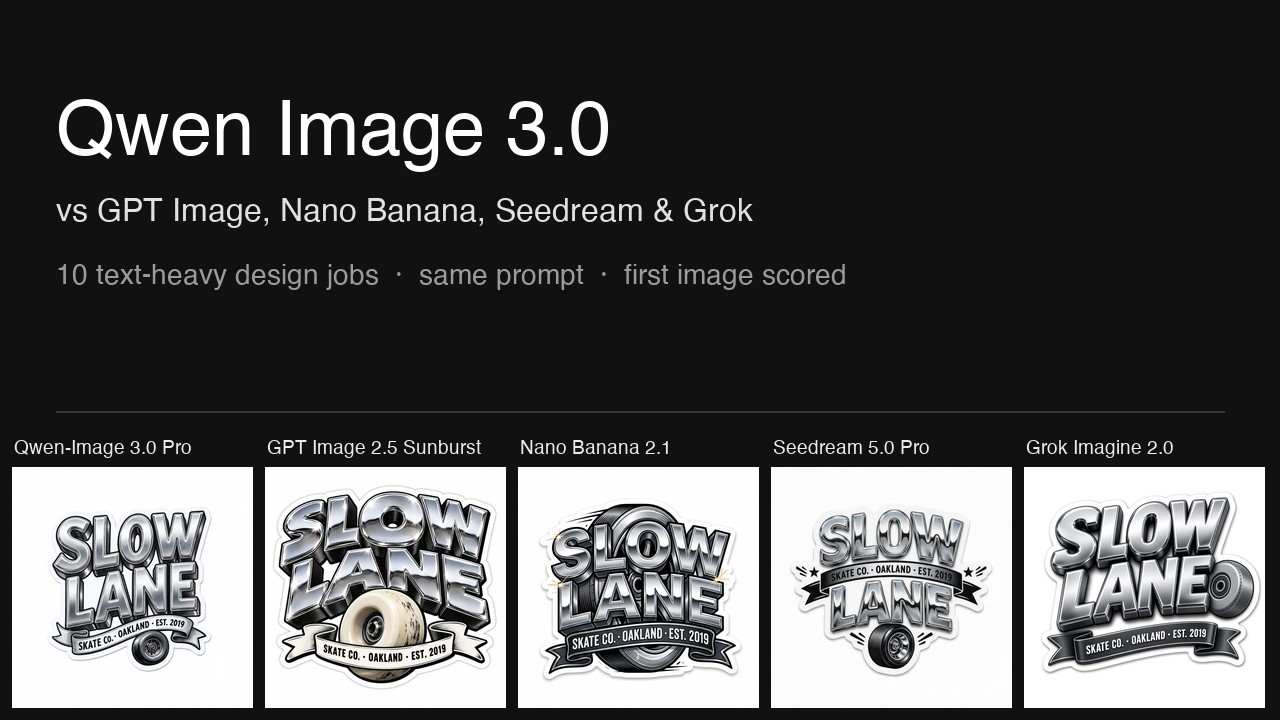
Qwen Image 3.0 Pro ist das Bildmodell von Alibaba. Laut Hersteller rendert es Text bis hinunter zu 10 Pixeln, beherrscht 12 Sprachen nativ und kommt mit dichten Informationslayouts zurecht. Ich habe es gegen vier andere Bildmodelle getestet, mit 10 Design-Aufgaben, in denen überall Text vorkommt: eine Einladung, ein Sticker, ein Plakat, ein Konferenzprogramm, ein zweisprachiges Teeetikett, ein japanisches Plakat in vertikalem Satz, ein Logo, ein Foto, eine Bildbearbeitung und eine Aufgabe mit zwei Referenzbildern. Jedes Modell bekam exakt denselben Prompt, und ich habe jeweils das erste gelieferte Bild bewertet.
Die fünf Konfigurationen, alle in 2K-Auflösung:
- Qwen Image 3.0 Pro (Alibaba). Qwen Image 3.0 Pro hat zwei Auflösungen, 1K und 2K, und keine Qualitätsstufe. Das eingebaute Umschreiben des Prompts war ausgeschaltet, sodass es den Prompt wie die anderen vier unverändert bekam.
- GPT Image 2.5 Sunburst (OpenAI), Qualität High. GPT Image 2.5 hat fünf Qualitätsstufen: Low, Medium, High, Extra High und Max. Getestet habe ich High, die Standardstufe auf FontVibe. Extra High und Max habe ich nicht getestet.
- Nano Banana 2.1 (Google). Nano Banana 2.1 hat keine Qualitätsstufe.
- Seedream 5.0 Pro (ByteDance). Seedream 5.0 Pro hat keine Qualitätsstufe.
- Grok Imagine 2.0 (xAI), Qualität Medium. Medium ist die höchste Stufe von Grok Imagine 2.0. Mein Test von Grok Imagine 2.0 hat die Stufen Low und Medium verglichen, und Medium erreichte die höhere Note.
Die Ergebnisse
| Modell (Stufe) | Lesbarkeit | Schrift und Ausführung | Information und Layout | Wirkung | Gesamt | Mittlere Zeit (Median) | FontVibe-Credits |
|---|---|---|---|---|---|---|---|
| Grok Imagine 2.0 (Medium) | 9.9 | 8.8 | 8.9 | 8.6 | 9.01 | 95 s | 40 |
| GPT Image 2.5 Sunburst (High) | 9.4 | 9.0 | 8.7 | 8.9 | 8.99 | 41 s | 40 |
| Nano Banana 2.1 | 9.7 | 8.8 | 8.3 | 8.3 | 8.76 | 28 s | 25 |
| Seedream 5.0 Pro | 10.0 | 8.7 | 8.0 | 8.5 | 8.75 | 73 s | 40 |
| Qwen Image 3.0 Pro | 10.0 | 8.8 | 7.7 | 7.8 | 8.57 | 23 s | 40 |
Die Noten gehen bis 10 und sind der Durchschnitt über das erste Bild jeder der 10 Aufgaben. Die mittlere Zeit (Median) beruht auf den neuen Bildern der Aufgaben 1 bis 8 und 10, je zwei pro Aufgabe, in 2K: 18 pro Modell, bei Seedream 5.0 Pro 17 wegen der Fehlschläge, die in Aufgabe 10 beschrieben sind. Die Credits sind der Preis für ein 2K-Bild auf FontVibe. Jede einzelne Note steht im Anhang. In einem separaten Blindtest ohne sichtbare Modellnamen lag Qwen Image 3.0 Pro ebenfalls auf dem letzten Platz, und GPT Image 2.5 lag vorne.
Grok Imagine 2.0 Medium erreichte die höchste Note, 9.01 von 10. GPT Image 2.5 Sunburst kam auf 8.99, also 0.02 weniger. Nano Banana 2.1 erreichte 8.76 und Seedream 5.0 Pro 8.75, 0.01 auseinander. Qwen Image 3.0 Pro erreichte die niedrigste Note, 8.57, also 0.18 unter Seedream 5.0 Pro. Alle fünf Durchschnitte liegen innerhalb von 0.44 Punkten. Ändert man eine Note in einer Aufgabe um 1 Punkt, verschiebt sich der Durchschnitt eines Modells um 0.02 bis 0.035, also hängen die Reihenfolge der ersten beiden und die Reihenfolge des dritten und vierten Platzes jeweils an einzelnen Noten.
Qwen Image 3.0 Pro und Seedream 5.0 Pro hatten die höchste Lesbarkeitsnote, 10.0: Die Hauptzeile liest sich in jedem ihrer bewerteten Bilder auf einen Blick. Qwen Image 3.0 Pro hatte die niedrigste Note bei Information und Layout, 7.7, und die niedrigste Note bei der Wirkung, 7.8. In 3 seiner 10 bewerteten Bilder ist eine geforderte Zeile verändert oder falsch geschrieben, in Aufgabe 5 hat es eine Teedose gezeichnet statt des Etiketts, das der Prompt verlangt hat, und sein Konferenzprogramm hat das schlichteste Layout dieser Aufgabe. In keiner Aufgabe erreichte es die höchste Note.
GPT Image 2.5 lief auf High, der dritten seiner fünf Qualitätsstufen. Die anderen vier Modelle liefen auf ihrer höchsten Stufe. Dieser Test zeigt nicht, wie GPT Image 2.5 auf Extra High oder Max abschneiden würde.
Textgenauigkeit
Von den 50 bewerteten Bildern haben 47 jede geforderte Zeile richtig geschrieben. Die drei übrigen stammen alle von Qwen Image 3.0 Pro:
- Aufgabe 1: Aus "Mia's" wurde "MiA'S", mit Großbuchstaben mitten im Namen.
- Aufgabe 4: Aus der URL in der Fußzeile, "formfunction.design", wurde "formfunction.deign".
- Aufgabe 9: Die Bearbeitung sollte "18+" unverändert lassen, und daraus wurde "$Z+".
Kleinere Probleme in den bewerteten Bildern der anderen Modelle:
- GPT Image 2.5, Aufgabe 8: Es hat eine Kreidetafel mit fünf Gerichten hinzugefügt, die der Prompt nicht verlangt hat, und eine Zeile auf dieser Tafel ist verstümmelte, unlesbare Schrift. Der "·" auf der verlangten Menütafel wurde zu einer Wellenlinie.
- Nano Banana 2.1, Aufgabe 8: Der "·" auf der Menütafel sitzt an der falschen Stelle.
- Zeilen, die der Prompt nicht verlangt hat: Seedream 5.0 Pro hat in Aufgabe 4 "ONE-DAY DESIGN CONFERENCE" hinzugefügt; Nano Banana 2.1 hat in Aufgabe 10 "WEEKEND ART EVENT" hinzugefügt; Grok Imagine 2.0 hat in Aufgabe 10 "OPEN STUDIO" wiederholt; Qwen Image 3.0 Pro hat in Aufgabe 10 "NEON OUTLINE" aus einem Referenzbild übernommen.
- GPT Image 2.5 und Nano Banana 2.1 haben in Aufgabe 5 jeweils einen roten Siegelstempel mit Schriftzeichen auf das Teeetikett gesetzt, obwohl der Prompt keinen weiteren Text verlangt hat.
Die drei Versprechen von Qwen Image 3.0 im Test
Versprechen 1: Text bis hinunter zu 10 Pixeln. Teilweise bestätigt. Aufgabe 4 verlangte 10 Zeilen Programmtext. Alle 10 Zeilen im Bild von Qwen Image 3.0 Pro sind scharf und lesbar, und seine Lesbarkeitsnote war 10. Aber der URL in der Fußzeile fehlt ein Buchstabe ("formfunction.deign"), und derselbe Schreibfehler tauchte in 3 der 4 Programmbilder von Qwen auf (beide 1K-Bilder und das erste 2K-Bild). Die anderen vier Modelle haben die URL in allen 8 ihrer Programmbilder richtig geschrieben.
Versprechen 2: 12 Sprachen nativ. Für die beiden getesteten Sprachen bestätigt. In Aufgabe 5 hat Qwen Image 3.0 Pro alle vier chinesischen und englischen Zeilen richtig in vereinfachtem Chinesisch geschrieben, inklusive des 〇 in "二〇二七年春". In Aufgabe 6 hat es alle drei japanischen Zeilen vertikal und richtig gesetzt. Die anderen 10 Sprachen habe ich nicht getestet.
Versprechen 3: dichte Informationslayouts. Durch diesen Test nicht bestätigt. Das Programm von Qwen Image 3.0 Pro in Aufgabe 4 erreichte 7.4, die niedrigste Note dieser Aufgabe: schwarzer Text auf weißer Seite, ohne Gruppierung und mit einer großen leeren Fläche unten. Seine durchschnittliche Note bei Information und Layout, 7.7, war die niedrigste der fünf Modelle.
So habe ich getestet
Die 10 Aufgaben. Die Aufgaben 1 und 3 nutzen dieselben Prompts wie mein Test von Grok Imagine 2.0 und mein früherer Test von sieben KI-Design-Tools. Die anderen acht Prompts sind neu.
- Einladung zum Kindergeburtstag (3:4): glänzende Ballonbuchstaben, drei Zeilen mit Details
- Sticker für einen Skateshop (1:1): wuchtige 3D-Buchstaben aus Chrom, eine Zeile auf einem Band, freigestellt auf Weiß
- Konzertplakat (2:3): Schrift aus geschmolzenem Feuer, vier Zeilen mit Details
- Konferenzprogramm (3:4): 8 Zeitfenster, ein Geviertstrich, ein Schrägstrich und eine URL
- Etikett für eine Teedose (3:4): chinesische Pinselkalligrafie mit einer englischen Zeile
- Japanisches Buchhandlungsplakat (2:3): jede Zeile vertikal gesetzt
- Badge für eine Outdoor-Marke (1:1): ein "FW"-Monogramm und der volle Name in Kapitälchen
- Foto eines Foodtrucks (3:2): gemalte Schrift auf dem Truck und eine Menütafel
- Ein vorhandenes Bild bearbeiten (2:3): ein Datum und einen Preis ändern, alles andere beibehalten
- Zwei Referenzbilder (3:4): Layout aus Bild 1, Schrift aus Bild 2
Der Test umfasst Design-Bilder mit Text. Porträts, Landschaften und andere Bilder ohne Text habe ich nicht getestet. Der vollständige Prompt jeder Aufgabe steht unten im jeweiligen Abschnitt. Die Regeln:
- Jedes Modell bekam exakt denselben Prompt, Wort für Wort, über den DIY-Modus von FontVibe, der den Prompt unverändert an das Modell schickt. Kein Umschreiben des Prompts und keine Stil-Presets.
- Das Seitenverhältnis wurde als Parameter gesetzt, für jedes Modell gleich.
- Jede Konfiguration hat pro Aufgabe zwei Bilder erzeugt. Nur das erste Bild wird bewertet und gezeigt. Das zweite Bild diente nur dazu, die Konsistenz der Rechtschreibung zu prüfen. Wenn das erste Bild fehlschlug, wurde es einmal wiederholt, und bewertet wird das erste Bild, das erfolgreich war.
- Alle Bilder wurden am 21. Oktober 2026 erzeugt und sind öffentlich auf FontVibe zu sehen.
Das Bewertungsschema
Das Schema ist der interne Standard von FontVibe für die Bewertung erzeugter Designs und wurde im Oktober 2026 vor diesem Test geschrieben. Es ist dasselbe Schema wie im Test von Grok Imagine 2.0. Jedes Bild bekommt vier Noten von 1 bis 10, und für jeden Abzug habe ich zuerst den Grund notiert und erst dann die Zahl vergeben.
| Was ich bewertet habe | Gewicht | Worauf ich geachtet habe |
|---|---|---|
| Lesbarkeit | 20% | Zuerst eine Prüfung auf harte Fehler: verstümmelte Buchstaben, abgeschnittener Text, von anderen Elementen verdeckter Text, kaputte Buchstabenformen. Ohne harte Fehler gibt es 7 bis 10, je nachdem, wie leicht sich die Hauptzeile liest. Jeder harte Fehler bedeutet 1 bis 4. |
| Schrift und Ausführung | 35% | Ob das Bild den Schrifteffekt hat, den der Prompt verlangt hat (Ballons, Chrom, Feuer, Pinsel, Neon), und wie gut er gemacht ist. |
| Information und Layout | 25% | Zuerst, ob das Bild das ist, was der Prompt verlangt hat, und ob die Information vollständig und korrekt ist: Jede Zeile aus dem Prompt ist vorhanden, so geschrieben und gesetzt wie vorgegeben, und nichts wurde hinzugefügt, was der Prompt nicht verlangt hat. Jede fehlende, veränderte oder hinzugefügte Zeile oder Satzzeichen kostet mindestens 1 Punkt. Danach, ob die wichtigste Zeile zuerst gelesen wird und die Zeilen in der richtigen Reihenfolge stehen. |
| Wirkung | 20% | Ob das Bild aussieht, als hätte es ein professioneller Designer gemacht. |
Die Gesamtnote wird berechnet, nicht geschätzt: 0.20 × Lesbarkeit + 0.35 × Schrift + 0.25 × Information und Layout + 0.20 × Wirkung.
Vier Punkte dazu, wie ich das Schema angewendet habe. Die Lesbarkeit wird, wie im Schema festgelegt, an der Hauptzeile beurteilt; Nebenzeilen, die zu klein oder zu blass sind, um sie leicht zu lesen, flossen in Information und Layout ein. Ein durchgehender Satz in Großbuchstaben, etwa "WITH SPECIAL GUESTS", zählte nicht als Änderung, zufällig gesetzte Großbuchstaben mitten in einem Wort wie in "MiA'S" dagegen schon. Verstümmelte Schrift auf einem Schild oder einer Tafel, die groß genug ist, dass ein Betrachter sie lesen wollen würde, zählte wie im Test von Grok Imagine 2.0 als harter Fehler; winzige Beschriftungen im Hintergrund, die in der Auflösung des Bildes selbst nicht lesbar sind, zählten nicht. Wenn der Prompt eine Design-Datei verlangte, etwa ein Etikett oder ein gedrucktes Programm, und das Bild sie stattdessen als fotografierten Gegenstand zeigte, verlor Information und Layout 3 Punkte, weil sich das Ergebnis so nicht an eine Druckerei schicken lässt.
Beim Bewerten wusste ich, welches Modell welches Bild gemacht hat. Um Voreingenommenheit zu prüfen, habe ich zusätzlich einen Blindtest mit verborgenen Modellnamen gemacht.
Die Aufgaben 9 und 10 starten mit vorhandenen Bildern. Alle drei stammen aus der öffentlichen Galerie von FontVibe, und keines wurde von einem der fünf getesteten Modelle erstellt. Alle drei stammen von Seedream 5.0, dem Vorgängermodell aus derselben Familie wie Seedream 5.0 Pro.
Aufgabe für Aufgabe
Aufgabe 1: Einladung zum Kindergeburtstag
Birthday party invitation for my daughter, "Mia's 7th Birthday" in glossy balloon letters, "Saturday, Nov 14 · 2 PM", "Sunny Park Pavilion", "RSVP by Nov 7", bright and playful, portrait card
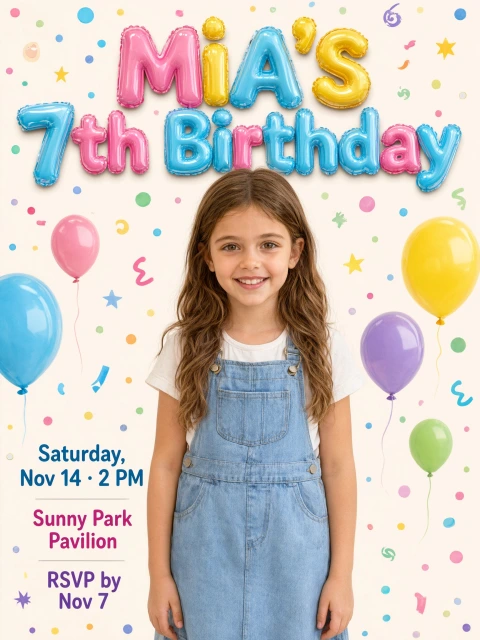
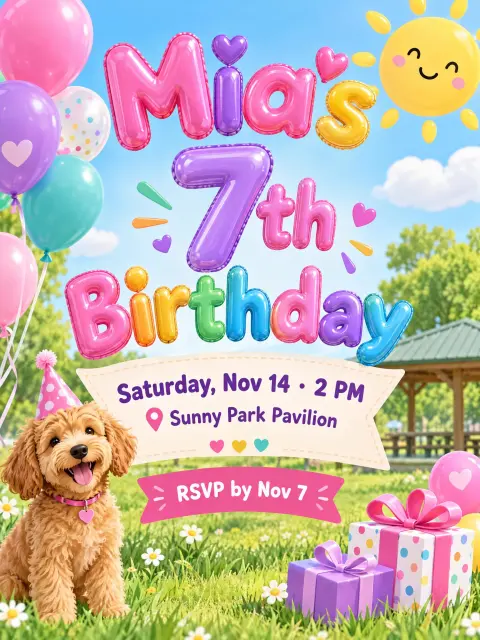
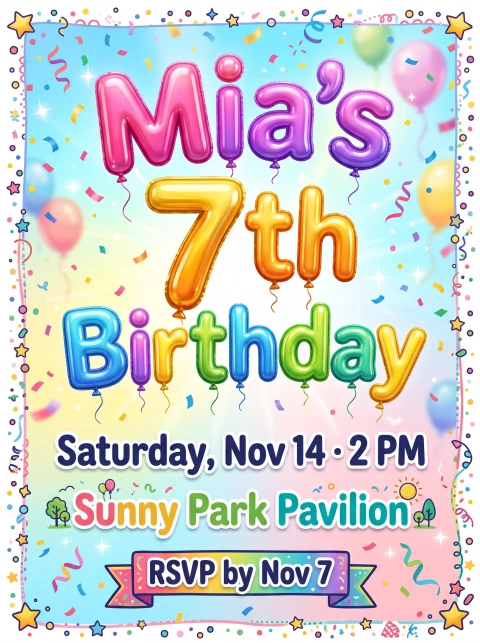
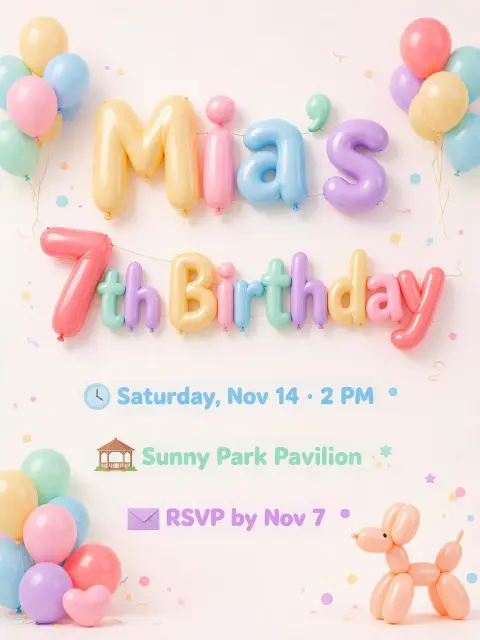
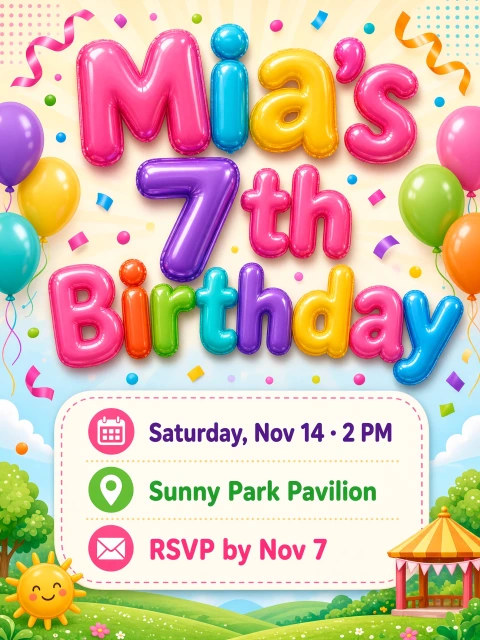
GPT Image 2.5 und Grok Imagine 2.0 teilten sich die höchste Note, 9.2. Beide haben die drei Detailzeilen klar gruppiert, GPT Image 2.5 auf einem Band und Grok in einer Karte mit Icons. Qwen Image 3.0 Pro erreichte die niedrigste Note, 8.3: Es hat den Namen als "MiA'S" geschrieben, und ein Foto eines Mädchens nimmt die Mitte der Karte ein, sodass für die drei Detailzeilen nur eine schmale Spalte links bleibt. Seedream 5.0 Pro hat die drei Detailzeilen in blasser Schrift auf blassen Hintergrund gesetzt, was einen Punkt bei Information und Layout kostete. Ballonbuchstaben als Preset findest du beim Bubble-Letter-Stil.
Aufgabe 2: Sticker für einen Skateshop
Die-cut sticker for my skate shop, "SLOW LANE" in chunky chrome 3D lettering, small "SKATE CO. · OAKLAND · EST. 2019" on a ribbon banner underneath, a skateboard wheel graphic, thick white sticker border, isolated on plain white
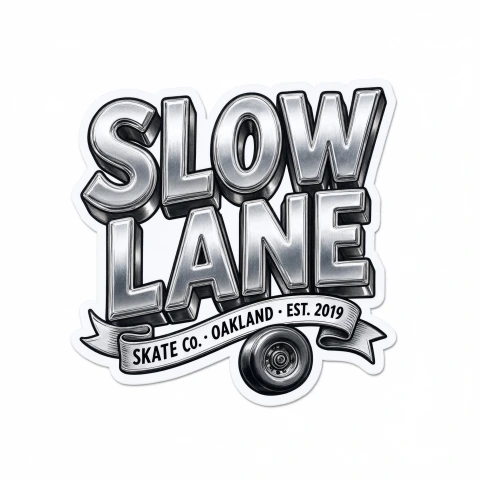
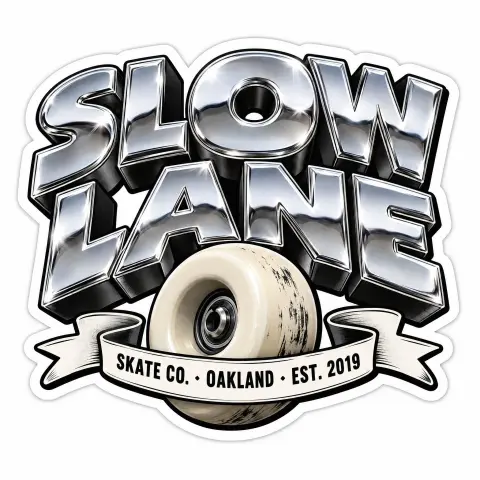
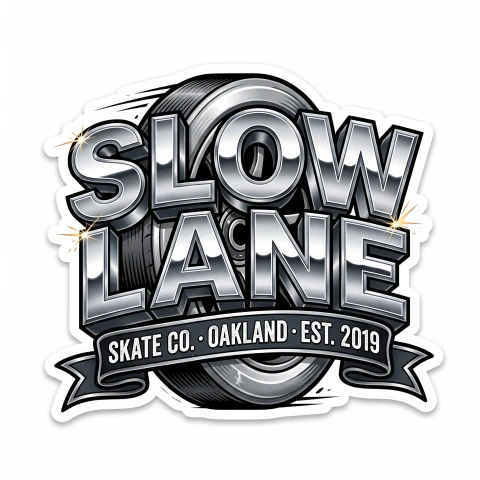
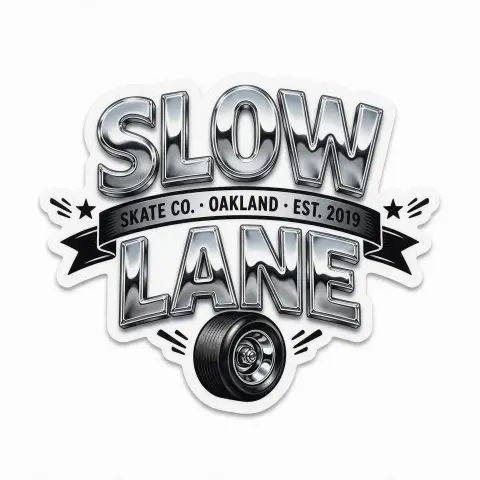
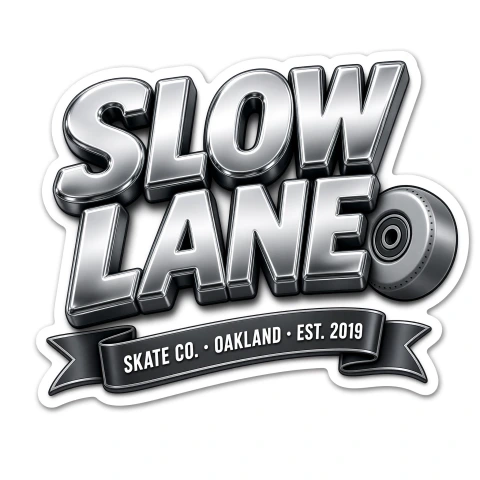
Alle fünf Modelle haben beide Zeilen richtig geschrieben. GPT Image 2.5 und Nano Banana 2.1 teilten sich die höchste Note, 9.2: Die Chrombuchstaben von GPT Image 2.5 haben die meiste Tiefe, und Nano Banana 2.1 hat ein großes Rad hinter die Buchstaben gesetzt. Qwen Image 3.0 Pro und Grok Imagine 2.0 erreichten beide 9.0. Seedream 5.0 Pro erreichte die niedrigste Note, 8.15, weil es das Band zwischen "SLOW" und "LANE" gesetzt hat statt darunter. Chromschrift als Preset findest du beim Metallic-Textstil.
Aufgabe 3: Konzertplakat
A3 gig poster for my band "BURNING ORCHARD", band name in molten fire lettering as the main focus, "with special guests THE LOW TIDES", "SAT 14 NOV · DOORS 8 PM", "THE CELLAR · 22 MILL STREET", "TICKETS £12 ON THE DOOR", gritty rock atmosphere with burning trees
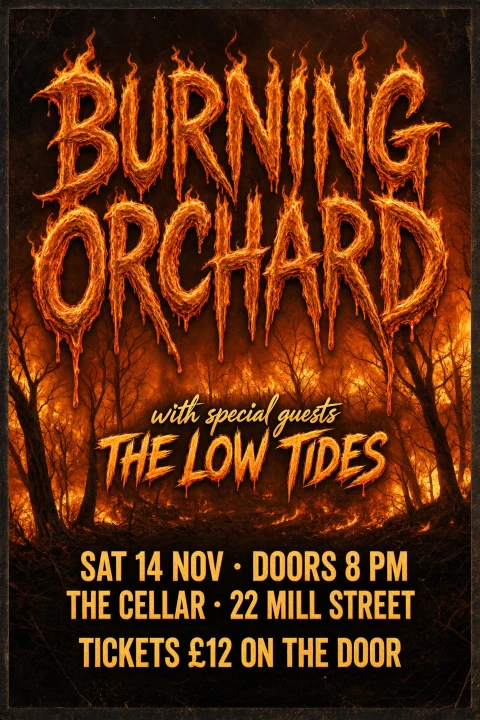
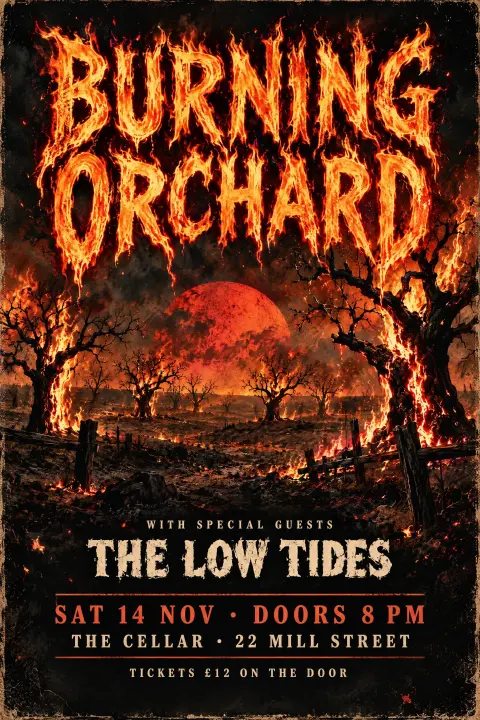
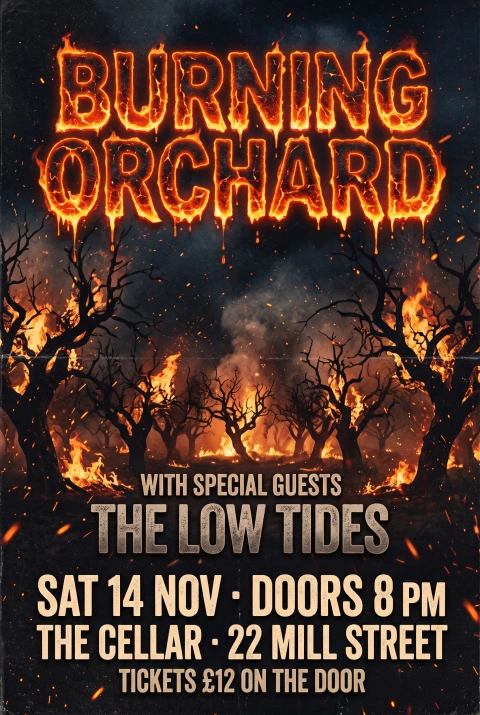
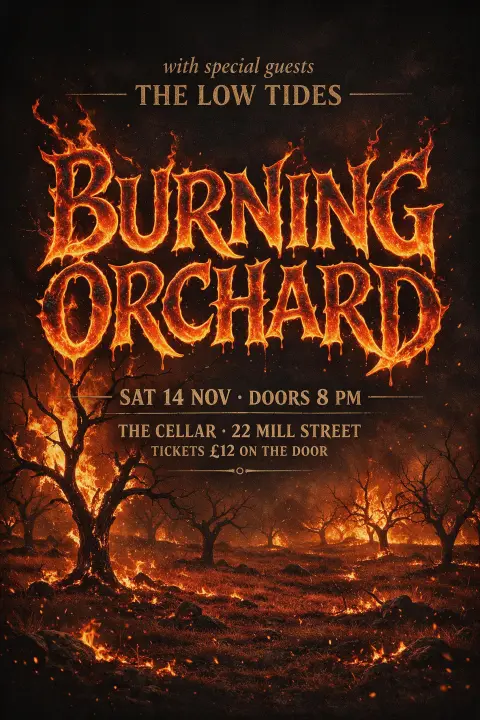
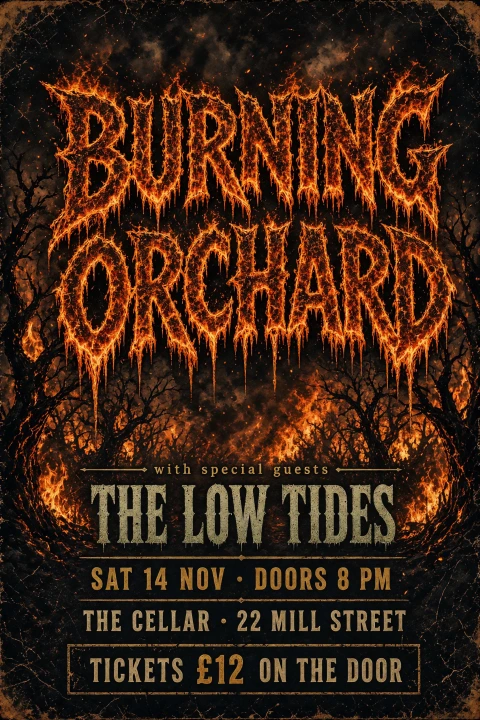
GPT Image 2.5 erreichte die höchste Note, 9.2: Lesbarkeit 10 und 9 bei jeder der anderen drei Noten, mit einem blutroten Mond über dem brennenden Obstgarten. Qwen Image 3.0 Pro, Nano Banana 2.1 und Grok Imagine 2.0 erreichten 9.0; Qwen und Nano Banana 2.1 bekamen 8 bei der Wirkung, und Grok bekam 9 bei der Lesbarkeit. Qwen hat die Vorband in einer handgezeichneten Schreibschrift gesetzt, die sie vom Headliner abhebt. Die Feuertextur von Grok ist die schwerste der fünf, sodass sein Titel einen zweiten Blick braucht. Seedream 5.0 Pro erreichte 8.5, weil es die Vorband über den Headliner gesetzt hat, derselbe Fehler in der Rangfolge wie bei diesem Prompt im Test von Grok Imagine 2.0. Feuerschrift als Preset findest du beim Feuer-Textstil.
Aufgabe 4: Konferenzprogramm
Printed schedule for a one-day design conference, title "FORM & FUNCTION 2027" in bold geometric lettering, then this exact list, one line each: "09:00 Registration & Coffee", "09:30 Opening Keynote — Ada Moreno", "10:15 Type in Motion", "11:00 Panel: Designing for Screens", "12:30 Lunch Break", "13:30 Workshop A / Workshop B", "15:00 Color Systems at Scale", "16:00 Closing Talk — Ken Ito", and a small footer "Hall 3 · Riverside Center · formfunction.design"
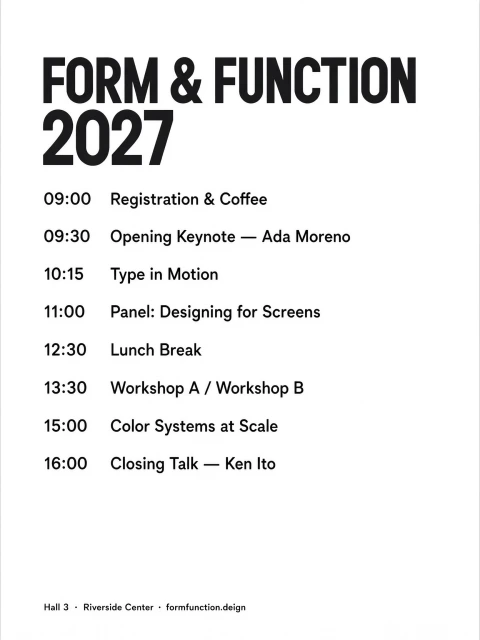
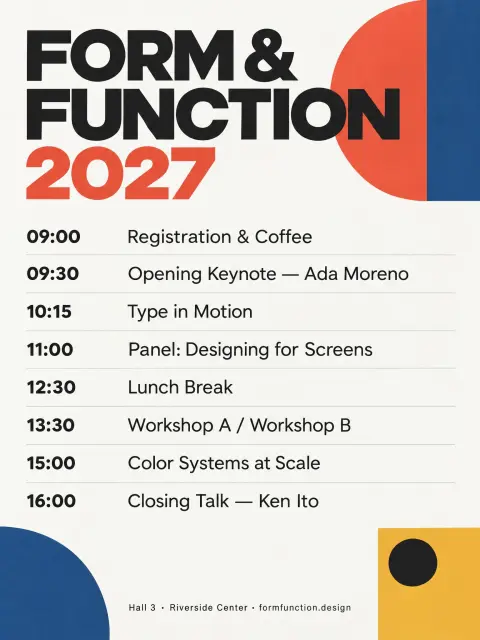
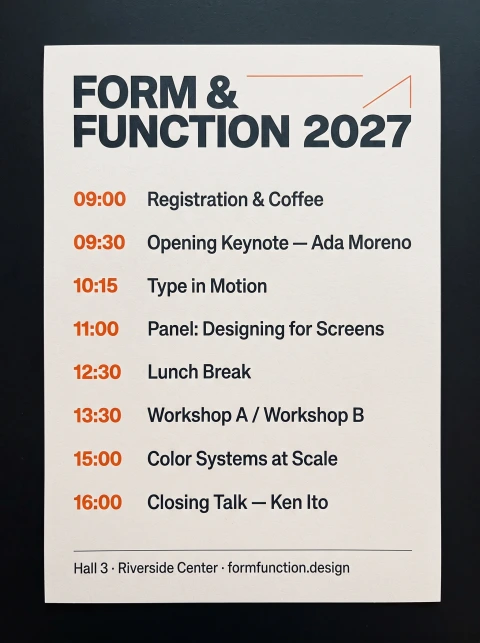
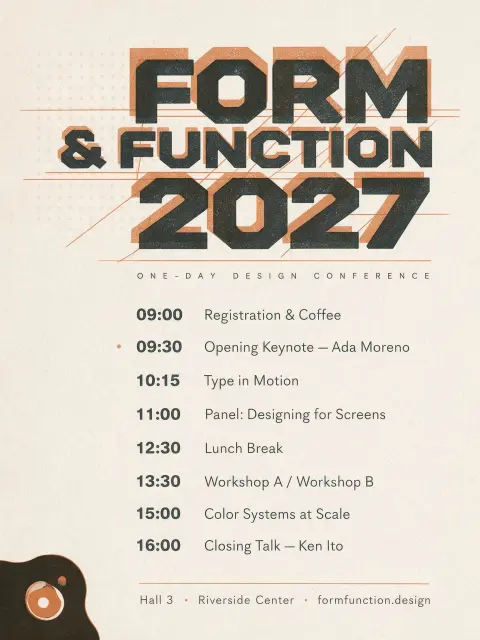
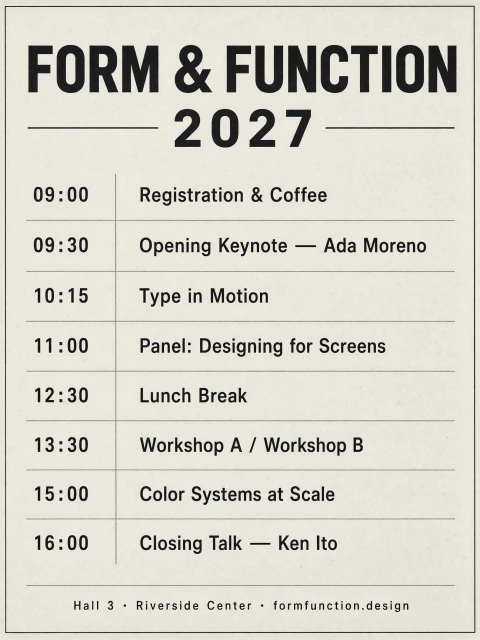
GPT Image 2.5 erreichte die höchste Note, 9.2, mit einem Titel im Bauhaus-Stil, Farbblöcken und einer Linie zwischen allen Zeitfenstern. Alle fünf Modelle haben die 8 Zeitfenster, die Geviertstriche und den Schrägstrich in ihren bewerteten Bildern richtig geschrieben. Nano Banana 2.1 hat den größten, klarsten Text, lieferte aber ein Foto einer gedruckten Karte auf einem dunklen Tisch statt des Programms selbst und erreichte 7.9. Qwen Image 3.0 Pro und Grok Imagine 2.0 haben den Titel in einer schmalen serifenlosen Schrift gesetzt statt in der geometrischen Schrift, die der Prompt verlangt hat; Grok erreichte 8.3. Qwen Image 3.0 Pro hat außerdem die URL in der Fußzeile als "formfunction.deign" geschrieben und erreichte 7.4, die niedrigste Note dieser Aufgabe: Seine Seite ist schwarzer Text auf Weiß, ohne Gruppierung und mit einer großen leeren Fläche unten. Seedream 5.0 Pro hat einen Untertitel hinzugefügt, "ONE-DAY DESIGN CONFERENCE", der nicht im Prompt stand. Im zweiten, nicht bewerteten Bild von GPT Image 2.5 fehlt die Zeile "Panel: Designing for Screens", und nur "11:00" ist übrig.
Aufgabe 5: Etikett für eine Teedose
Front label for a tea tin, brand name "山间茶事" in elegant brush-and-ink calligraphy, English line "MOUNTAIN TEA HOUSE", product line "明前龙井 · 二〇二七年春", net weight "净含量 100 克", misty green mountains, no other text
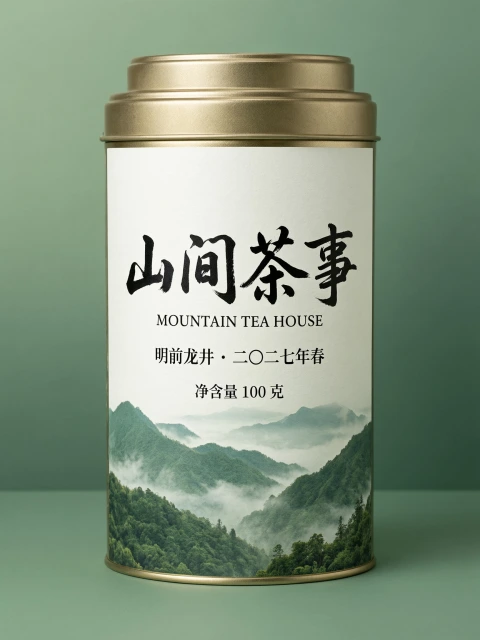
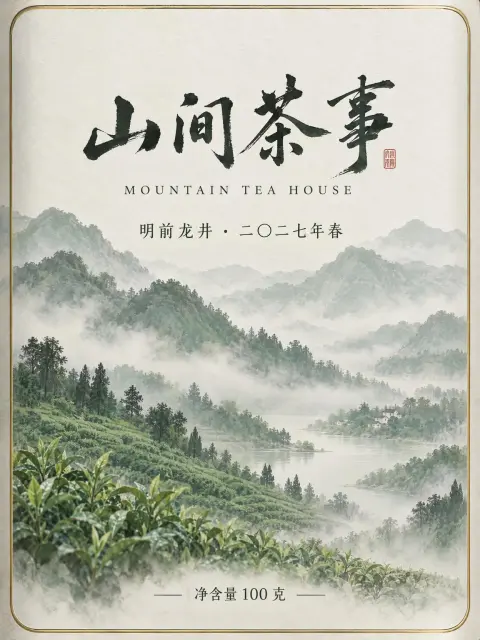
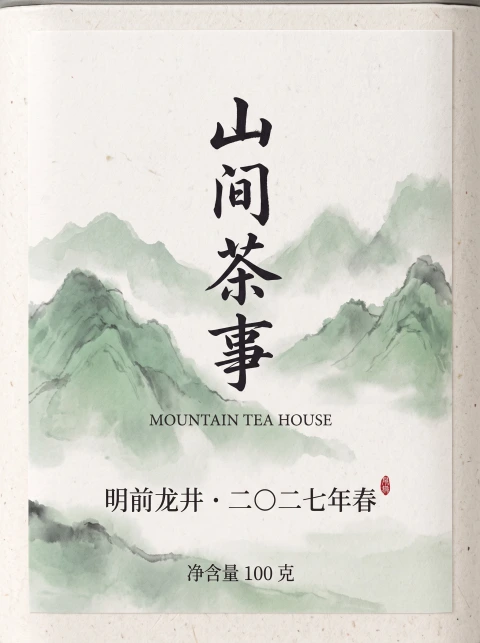
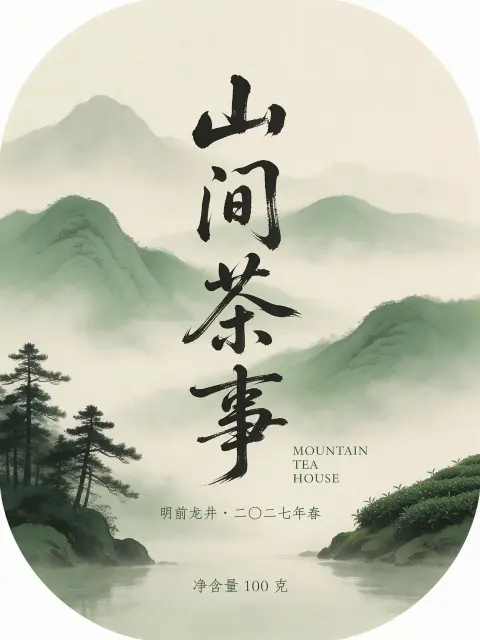
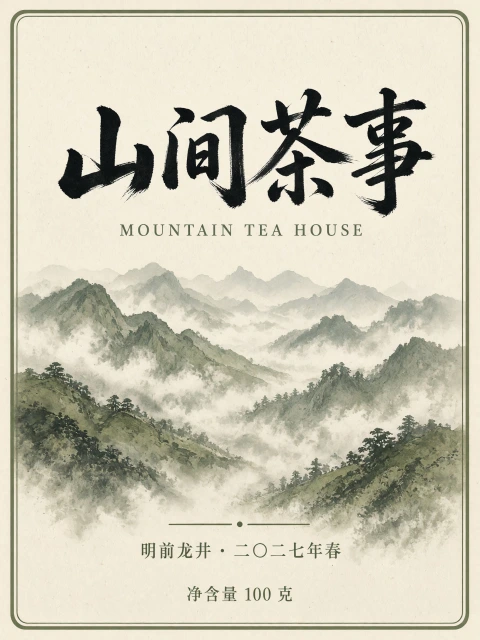
Alle fünf Modelle haben alle vier Zeilen richtig in vereinfachtem Chinesisch geschrieben, inklusive 龙 (nicht das traditionelle 龍) und 〇. Der Prompt verlangte das Etikett, und vier Modelle lieferten ein flaches Etikett. Qwen Image 3.0 Pro hat ein Foto einer ganzen Teedose mit dem Etikett darauf gezeichnet, das sich nicht als Etikett drucken lässt, und erreichte 8.45, die niedrigste Note dieser Aufgabe. Grok Imagine 2.0 erreichte die höchste Note, 9.2: ein flaches Etikett, jede Zeile an ihrem Platz, nichts hinzugefügt. GPT Image 2.5 und Nano Banana 2.1 haben jeweils einen kleinen roten Siegelstempel mit Schriftzeichen hinzugefügt, den das "no other text" im Prompt ausschließt, und beide erreichten 8.95. Pinselkalligrafie als Preset findest du beim chinesischen Pinsel-Tusche-Stil.
Aufgabe 6: Japanisches Buchhandlungsplakat
Poster for a bookstore's autumn reading week, headline "秋の読書週間" set vertically in elegant Mincho lettering, sub-line "十月二十七日〜十一月九日", and "全品ポイント二倍", warm maple leaves, all Japanese text written vertically, no other text
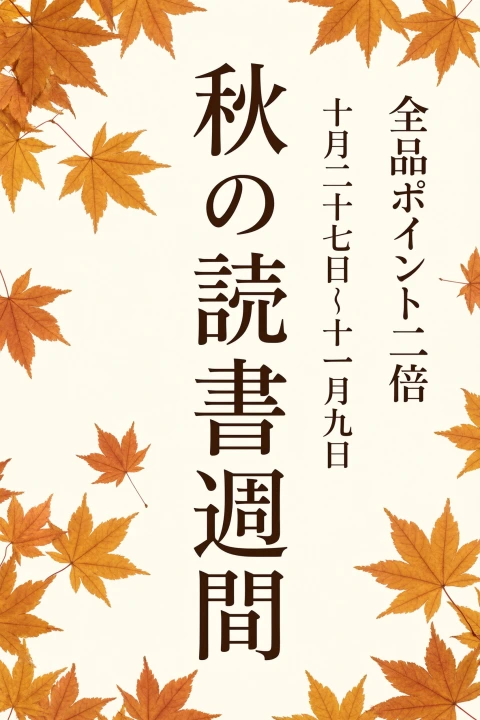
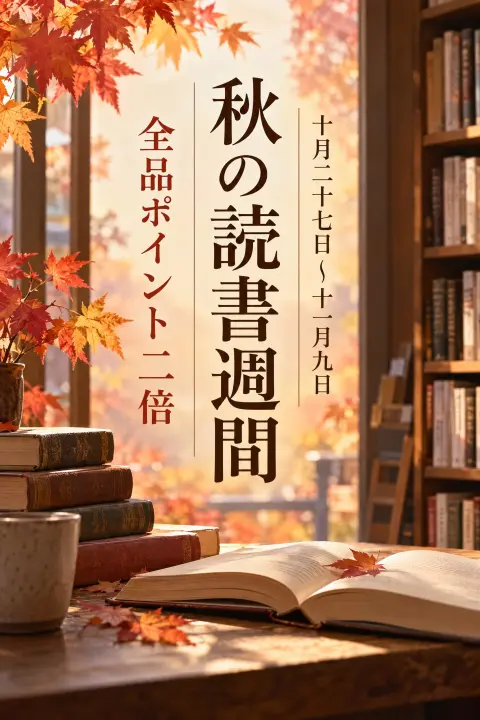
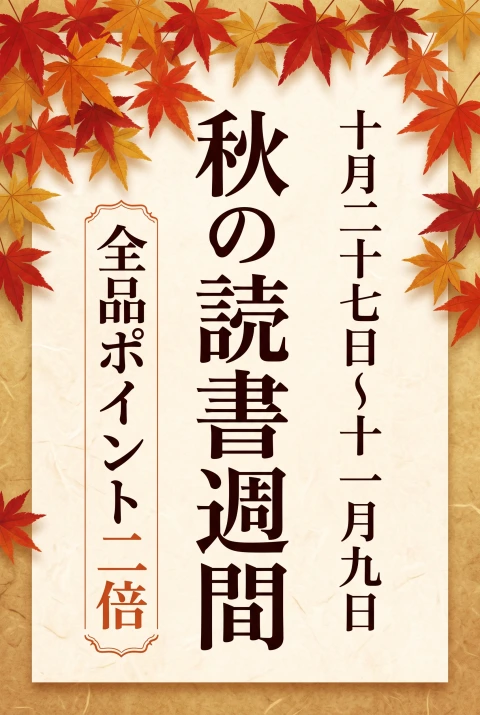
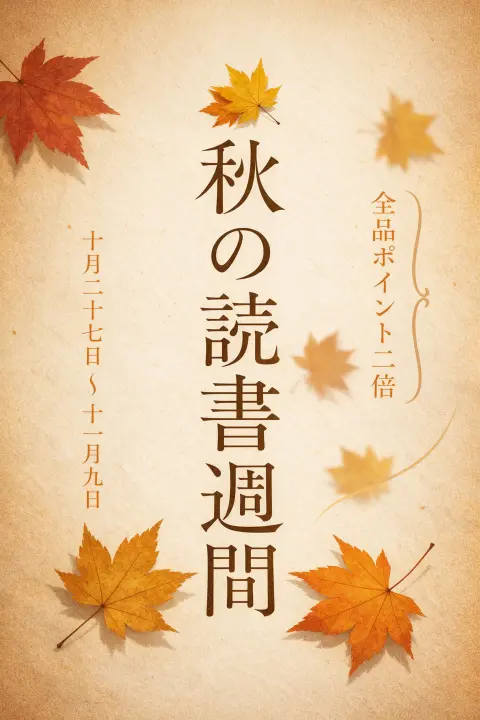

Alle fünf Modelle haben alle drei Zeilen vertikal gesetzt und richtig geschrieben, und alle fünf haben die Mincho-Schrift verwendet, die der Prompt verlangt hat. GPT Image 2.5 erreichte die höchste Note, 9.2, mit einer Buchhandlungsszene und dem Punkteangebot auf einem roten vertikalen Banner. Qwen Image 3.0 Pro, Nano Banana 2.1 und Grok Imagine 2.0 erreichten 9.0. Seedream 5.0 Pro erreichte 8.95: Seine Datumsspalte ist blass und dünn.
Aufgabe 7: Badge für eine Outdoor-Marke
Badge logo for a hiking outfitter called "Fernwood Outfitters", an interlocking "FW" monogram with a fern leaf in the center, the full name in clean small caps around the badge, flat vector look, two colors, on plain white, no other text
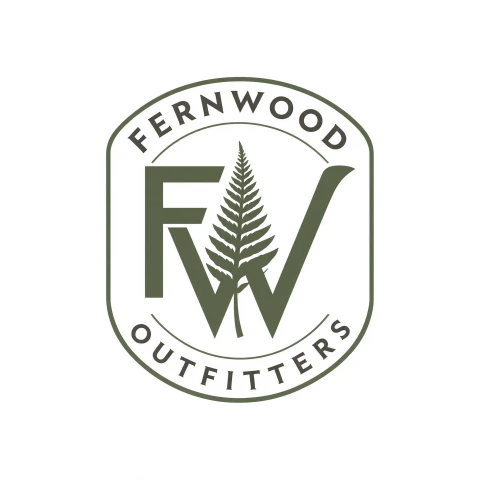
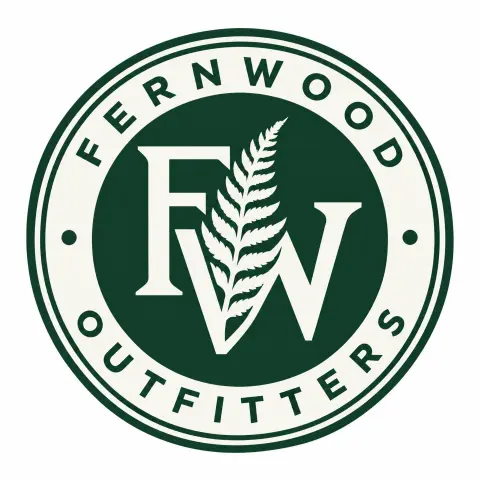
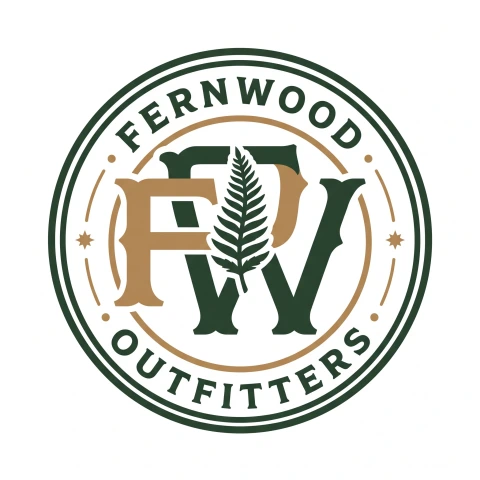
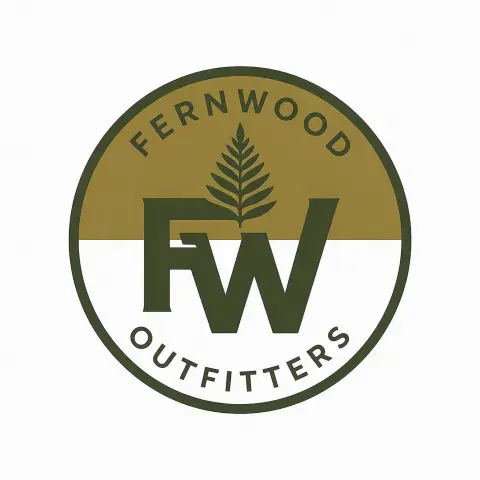
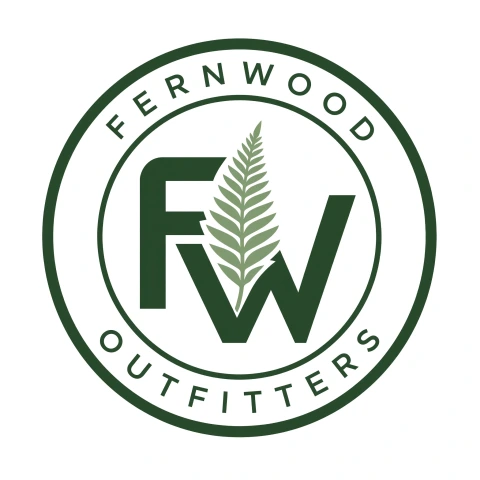
GPT Image 2.5 und Grok Imagine 2.0 teilten sich die höchste Note, 9.2. Qwen Image 3.0 Pro erreichte 9.0 mit einem Farn, der durch das Monogramm wächst. Nano Banana 2.1 erreichte die niedrigste Note, 8.05: Sein Monogramm hat einen zusätzlichen Bogen, durch den es auf den ersten Blick wie "FPW" aussieht. Seedream 5.0 Pro erreichte 8.3: Sein F und W stehen nebeneinander, statt ineinanderzugreifen, und der Farn sitzt über den Buchstaben statt in der Mitte. Im zweiten, nicht bewerteten Bild von Qwen steht der volle Name zweimal um das Badge herum.
Aufgabe 8: Foto eines Foodtrucks
Realistic photo of a vintage food truck parked by the beach at noon, hand-painted lettering on its side reads "SALT & LIME TACOS", a menu board next to it reads "3 TACOS $9 · HORCHATA $4", bright sunlight, shot on a 50mm lens
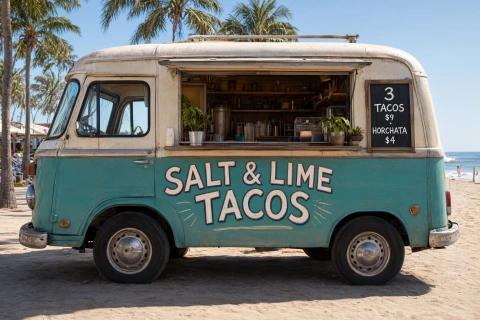
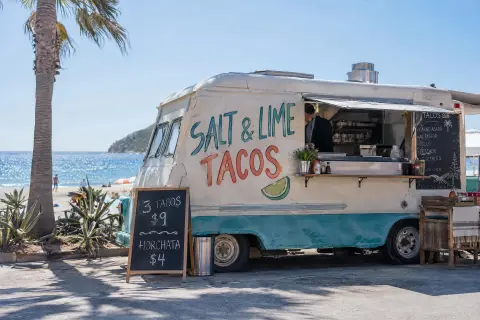
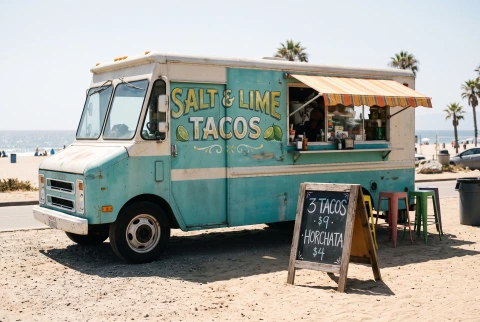
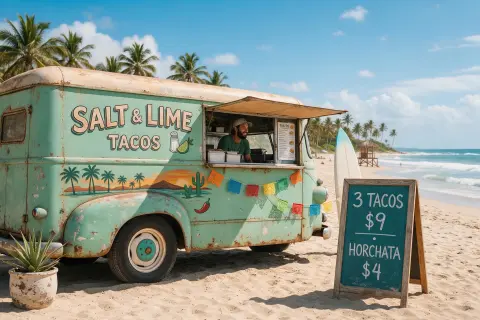
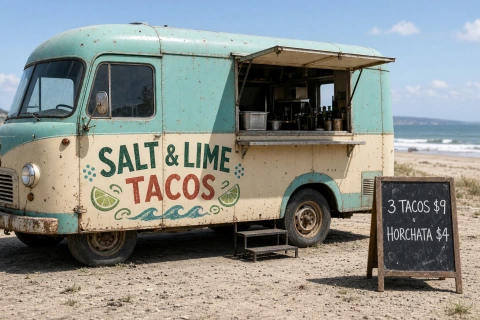
Alle fünf Modelle haben beide geforderten Zeilen richtig geschrieben. Seedream 5.0 Pro und Grok Imagine 2.0 teilten sich die höchste Note, 9.2, mit der Menütafel neben dem Truck, wie der Prompt es verlangt hat. GPT Image 2.5 erreichte die niedrigste Note, 7.5: Neben der Verkaufsklappe hat es eine zweite Kreidetafel mit fünf Gerichten hinzugefügt, und eine Zeile auf dieser Tafel ist verstümmelte Schrift, nach dem Schema ein harter Fehler, deshalb ist seine Lesbarkeitsnote 4. Außerdem hat es den "·" auf der verlangten Menütafel als Wellenlinie gezeichnet. Qwen Image 3.0 Pro hat die Menütafel an den Truck gehängt statt daneben gestellt und erreichte 8.75.
Aufgabe 9: Ein vorhandenes Bild bearbeiten
Change the date to "FRIDAY • NOVEMBER 13 • 2026" and the price to "$20", and keep everything else exactly as it is
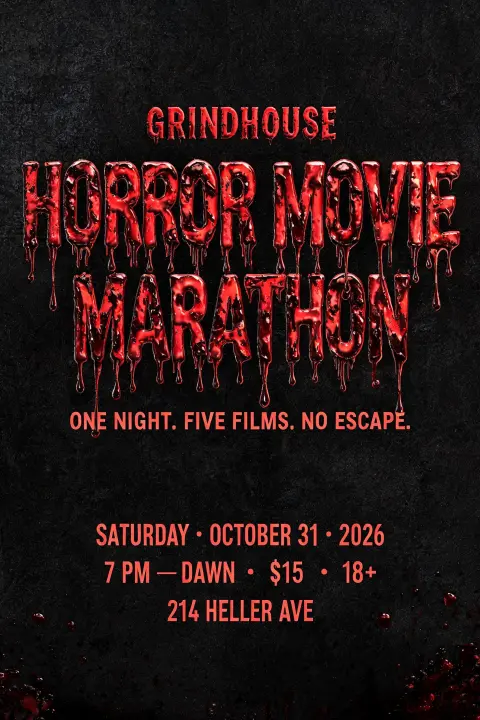
Das Original-Plakat hat sechs Textzeilen. Der Prompt verlangte, zwei davon zu ändern: das Datum und den Preis. Die anderen vier Zeilen und das "18+" sollten gleich bleiben.
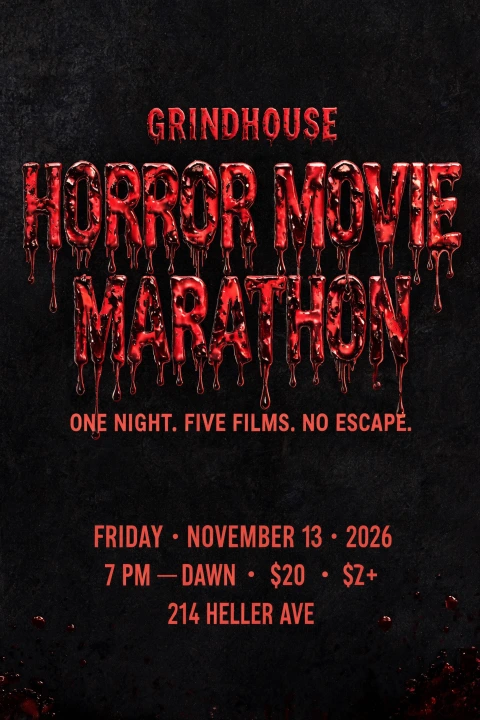
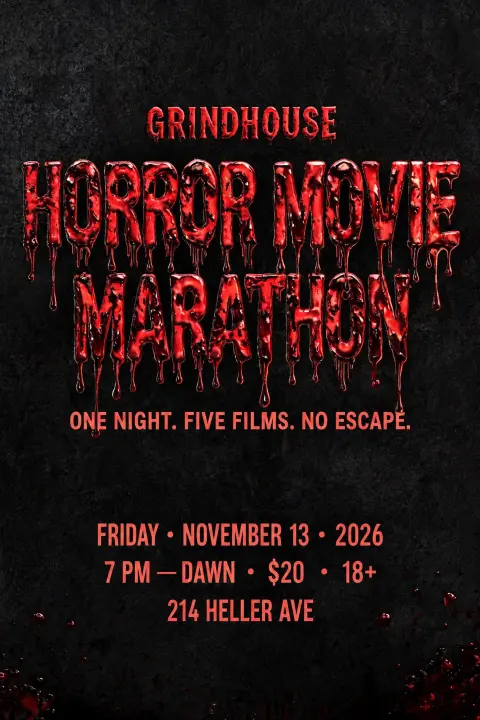
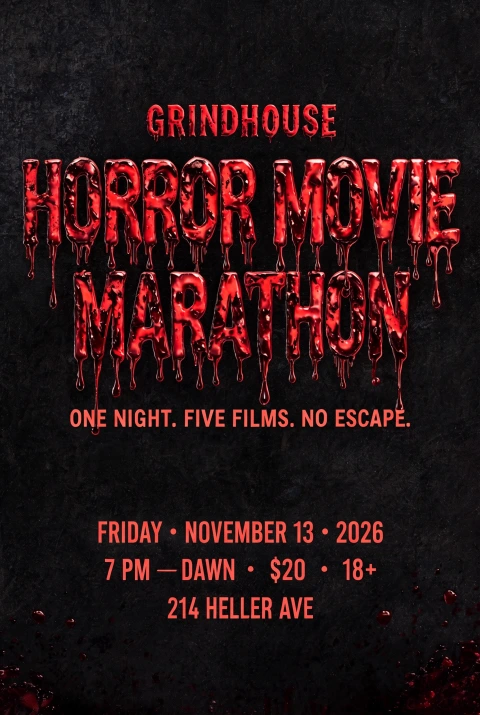
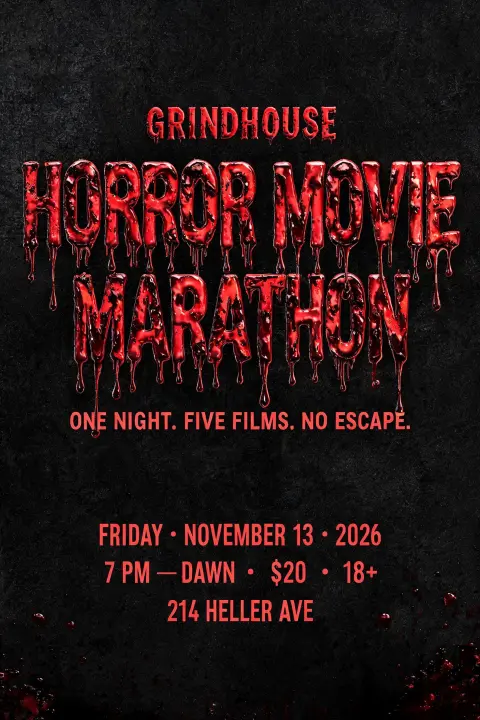
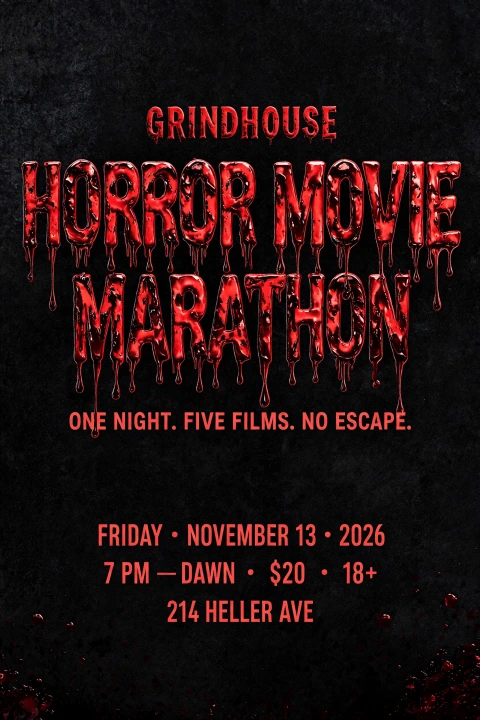
Vier Modelle haben Datum und Preis richtig geändert und alles andere unverändert gelassen, und alle vier erreichten 9.0. Qwen Image 3.0 Pro hat Datum und Preis richtig geändert, aber auch "18+" in "$Z+" verwandelt, und erreichte 8.5. Sein zweites Bild hat "18+" richtig beibehalten.
Das Schema misst nicht, ob der Rest des Bildes gleich geblieben ist, deshalb habe ich das wie im Grok-Test separat gemessen. Jedes Ergebnis und das Original wurden auf 800 × 1200 verkleinert und in Graustufen umgewandelt, und ich habe die mittlere absolute Pixeldifferenz (0 bis 255) außerhalb der beiden Zeilen berechnet, die sich ändern sollten. Niedriger heißt näher am Original.
| Modell | Abweichung vom Original |
|---|---|
| Seedream 5.0 Pro | 2.6 |
| GPT Image 2.5 Sunburst | 5.7 |
| Nano Banana 2.1 | 8.2 |
| Grok Imagine 2.0 Medium | 10.0 |
| Qwen Image 3.0 Pro | 12.2 |
Das Original hat 1664 × 2496 Pixel. Jedes Modell hat diese Größe geliefert, außer Nano Banana 2.1, das 1696 × 2528 lieferte, also stammt ein Teil seiner Abweichung vom Skalieren. Seedream 5.0 Pro lag auch bei der Bearbeitungsaufgabe im Grok-Test am nächsten am Original. Seine mittlere Bearbeitungszeit lag hier bei 118 Sekunden, gegenüber 23 bis 55 Sekunden bei den anderen vier.
Aufgabe 10: Zwei Referenzbilder
Portrait poster that says "OPEN STUDIO" with a small line "Sat & Sun · 11 AM–6 PM". Use the layout of reference image 1 and the lettering style of reference image 2.


Referenzbild 1 ist ein Galerieplakat im Pop-Art-Stil: ein blaues Band oben, ein riesiger zweizeiliger Titel auf rotem Rasterhintergrund und ein Datum unten. Referenzbild 2 ist eine dünne blaue Neon-Wortmarke in Konturschrift auf einem Sternenhintergrund. Das richtige Ergebnis ist das Layout von Referenz 1 mit der Neonschrift von Referenz 2.
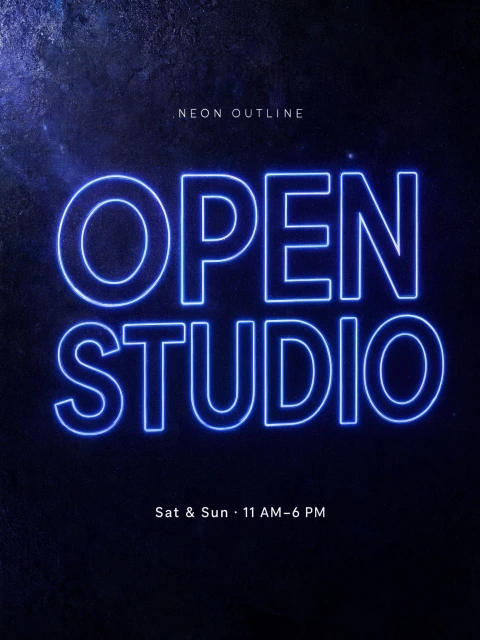
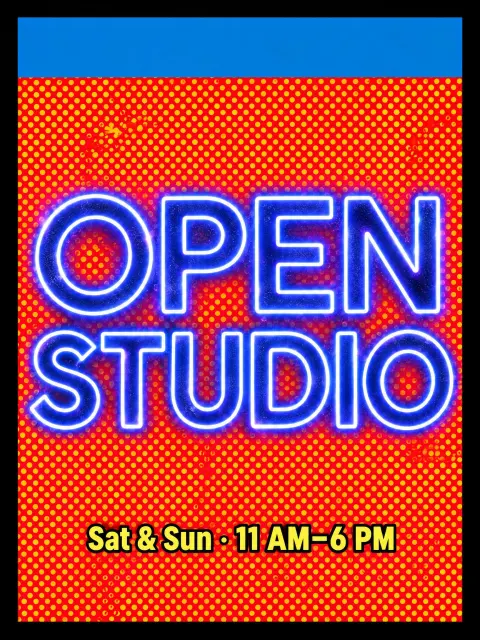
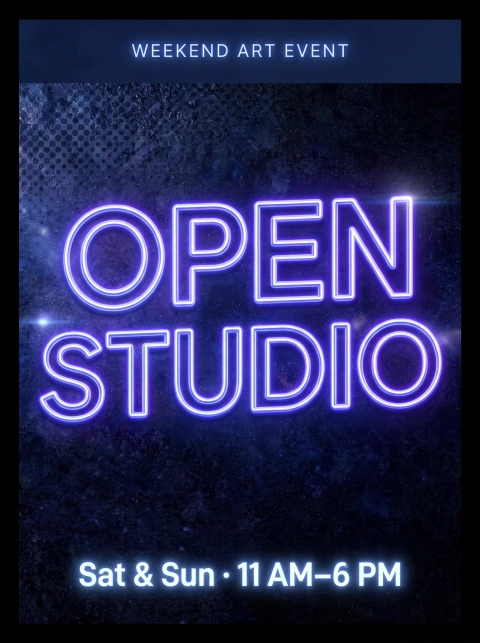
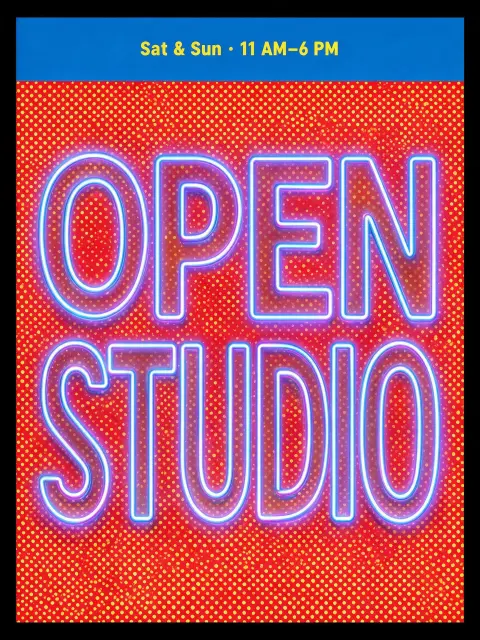
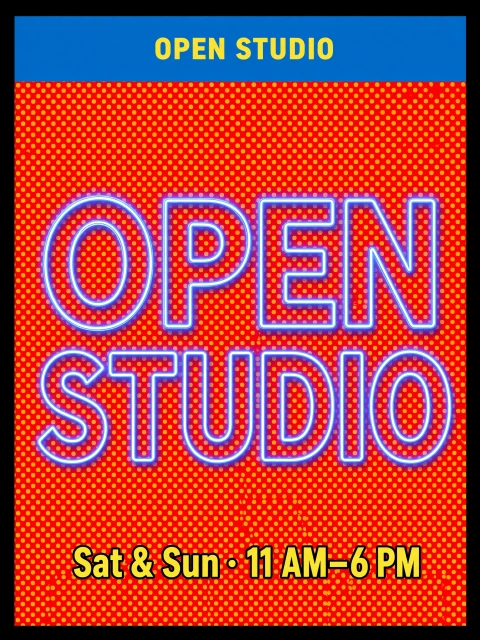
GPT Image 2.5 und Seedream 5.0 Pro haben beide Teile richtig umgesetzt und teilten sich die höchste Note, 9.2. Grok Imagine 2.0 hat ebenfalls beide Teile richtig umgesetzt, aber "OPEN STUDIO" ein zweites Mal ins obere Band geschrieben, und erreichte 8.95. Nano Banana 2.1 hat die Neonschrift und das obere Band übernommen, beides aber auf den Sternenhintergrund von Referenz 2 gesetzt und eine Zeile hinzugefügt, "WEEKEND ART EVENT", die nicht im Prompt stand. Qwen Image 3.0 Pro hat sich sowohl bei der Schrift als auch beim Layout an Referenz 2 gehalten und die Wörter "NEON OUTLINE" daraus übernommen. Sein zweites Bild hat dasselbe getan.
Der erste Versuch von Seedream 5.0 Pro bei dieser Aufgabe schlug fehl. Auf FontVibe wird eine Anfrage an Seedream 5.0 Pro nach 2 Minuten abgebrochen. Seedream 5.0 Pro erreichte dieses Limit bei 3 seiner 4 Versuche in dieser Aufgabe, in 2K mit zwei Referenzbildern, und das eine erfolgreiche Bild brauchte 121 Sekunden. Dieses Bild ist das bewertete. Nano Banana 2.1 schlug ebenfalls einmal fehl, beim zweiten Bild für Aufgabe 7, und war bei der Wiederholung erfolgreich. Fehlgeschlagene Anfragen werden auf FontVibe erstattet.
Qwen Image 3.0: 1K oder 2K?
Auf FontVibe kostet ein Bild mit Qwen Image 3.0 Pro in 1K 22 Credits und in 2K 40 Credits. Ich habe die Aufgaben 4 und 5, die beiden Aufgaben mit dem kleinsten Text, zusätzlich in 1K laufen lassen, mit je zwei Bildern.
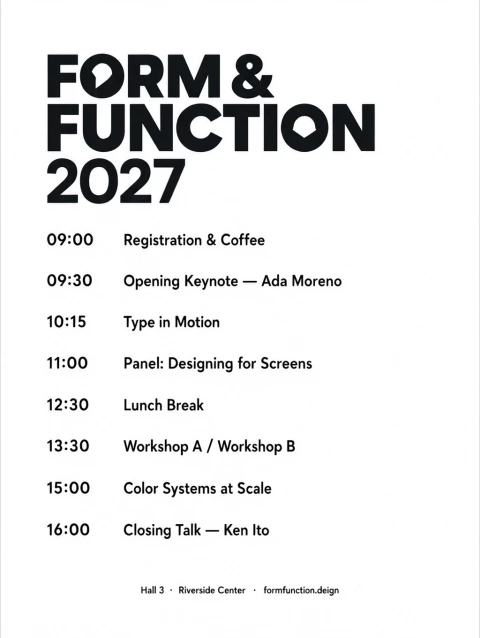
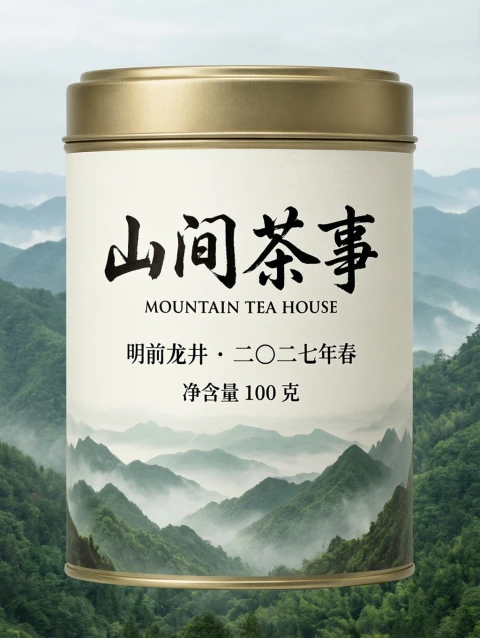
Die 1K-Bilder haben 1024 × 1360 Pixel, die 2K-Bilder 1728 × 2304. In 1K sind alle 10 Programmzeilen und alle vier Zeilen des Teeetiketts weiterhin lesbar, und beide Aufgaben erreichten dieselbe Note wie in 2K: 7.4 und 8.45. Auch in 1K hat Qwen eine Teedose gezeichnet statt eines Etiketts. Beide 1K-Programme haben den Schreibfehler "formfunction.deign", gegenüber einem der beiden 2K-Programme. Die mittlere Zeit lag in 1K bei 14 Sekunden, gegenüber 23 Sekunden in 2K.
Für Entwürfe und Social-Media-Bilder, die auf dem Smartphone angesehen werden, kostet 1K in diesem Test 55% von 2K, und der Text blieb lesbar. Für den Druck hat 2K 2.9-mal so viele Pixel.
Um Qwen Image 3.0 Pro auszuprobieren, wähl es im Modellmenü des FontVibe-Generators. Es nimmt bis zu 3 Bilder pro Anfrage an, das zu bearbeitende Bild und alle Referenzbilder zusammengezählt. Jedes Bild in diesem Beitrag öffnet per Klick seine Seite auf FontVibe, und wenn du mit der Maus darüberfährst, erscheint ein Recreate-Button, der denselben Prompt ausführt.
Zwei Tests im Vergleich
GPT Image 2.5 Sunburst, Grok Imagine 2.0 Medium, Nano Banana 2.1 und Seedream 5.0 Pro waren auch in meinem Test von Grok Imagine 2.0 dabei, der acht andere Prompts verwendet hat.
| Modell | Test von Grok Imagine 2.0 | Dieser Test |
|---|---|---|
| GPT Image 2.5 Sunburst (High) | 8.90 (1.) | 8.99 (2.) |
| Grok Imagine 2.0 Medium | 8.84 (2.) | 9.01 (1.) |
| Nano Banana 2.1 | 8.55 (4. von 5 Konfigurationen) | 8.76 (3.) |
| Seedream 5.0 Pro | 8.20 (5.) | 8.75 (4.) |
GPT Image 2.5 und Grok Imagine 2.0 Medium haben den ersten und zweiten Platz getauscht: Im Grok-Test lagen sie 0.06 auseinander, hier 0.02. Nano Banana 2.1 lag in beiden Tests vor Seedream 5.0 Pro, im Grok-Test um 0.35 und hier um 0.01. Nano Banana 2.1 steht im Grok-Test auf Platz 4, weil dieser Test auch Grok Imagine 2.0 Low enthielt, das 8.59 erreichte.
Die Aufgaben 1 und 3 nutzten in beiden Tests dieselben Prompts und sind daher direkt vergleichbar. In Aufgabe 1 erreichte Qwen Image 3.0 Pro 8.3, weniger als jedes der vier anderen Modelle in beiden Tests. In Aufgabe 3 erreichte es 9.0, so viel wie GPT Image 2.5 und Nano Banana 2.1 in diesem Test.
Jedes Modell in Kürze
Grok Imagine 2.0 Medium, 9.01. Höchste Note bei Information und Layout, 8.9. Höchste oder geteilt höchste Note in 5 der 10 Aufgaben. In keinem bewerteten Bild fehlt Text oder ist falsch geschrieben. Niedrigste Note 8.3, beim Konferenzprogramm, wo sein Titel eine schmale serifenlose Schrift statt geometrischer Schrift ist. Mittlere Zeit 95 Sekunden, die langsamste in diesem Test.
GPT Image 2.5 Sunburst (High), 8.99. Höchste Note bei der Schrift, 9.0, und höchste Note bei der Wirkung, 8.9. Höchste oder geteilt höchste Note in 8 der 10 Aufgaben. Niedrigste Note 7.5, beim Foodtruck-Foto, wo es eine Kreidetafel mit einer verstümmelten Zeile hinzugefügt hat. Getestet auf High; Extra High und Max wurden nicht getestet.
Nano Banana 2.1, 8.76. Kostet auf FontVibe 25 Credits pro 2K-Bild, am wenigsten von den fünf Modellen. Niedrigste Note 7.9, beim Konferenzprogramm, wo es ein Foto einer gedruckten Karte geliefert hat. Hat in Aufgabe 10 die Layout-Referenz nur zur Hälfte umgesetzt.
Seedream 5.0 Pro, 8.75. Höchste Lesbarkeitsnote, 10.0, gemeinsam mit Qwen Image 3.0 Pro. Am nächsten am Original bei der Bearbeitungsaufgabe, mit einer Pixeldifferenz von 2.6. Erreichte bei 3 von 4 Versuchen in der Aufgabe mit zwei Referenzen das 2-Minuten-Limit von FontVibe. Niedrigste Note 8.15, beim Sticker.
Qwen Image 3.0 Pro, 8.57. Höchste Lesbarkeitsnote, 10.0, gemeinsam mit Seedream 5.0 Pro, und die schnellste mittlere Zeit, 23 Sekunden. Niedrigste Note bei Information und Layout, 7.7, und niedrigste Note bei der Wirkung, 7.8. Hat in 3 seiner 10 bewerteten Bilder eine geforderte Zeile verändert oder falsch geschrieben und eine Teedose gezeichnet, wo der Prompt ein Etikett verlangt hat. In keiner Aufgabe die höchste Note.
Ein Blindtest
Weil ich beim Bewerten wusste, welches Modell welches Bild gemacht hat, habe ich zusätzlich einen Blindtest gemacht. Eine private Seite zeigte die fünf Bilder jeder Aufgabe in zufälliger Reihenfolge ohne Modellnamen. Jedes Bild bekam eine Note von 1 bis 5 für die Schrift, eine Note von 1 bis 5 für das Layout und eines von drei Urteilen: sofort nutzbar, braucht eine kleine Korrektur oder unbrauchbar.
| Modell | Blind Schrift (1–5) | Blind Layout (1–5) | Nutzbar / kleine Korrektur / unbrauchbar |
|---|---|---|---|
| GPT Image 2.5 Sunburst | 4.4 | 4.8 | 8 / 2 / 0 |
| Seedream 5.0 Pro | 4.3 | 4.3 | 4 / 4 / 2 |
| Nano Banana 2.1 | 4.3 | 4.2 | 4 / 4 / 2 |
| Grok Imagine 2.0 Medium | 4.0 | 4.2 | 4 / 5 / 1 |
| Qwen Image 3.0 Pro | 3.4 | 3.5 | 1 / 2 / 7 |
Blindtest und Bewertungsschema stimmen beim letzten Platz überein, Qwen Image 3.0 Pro. Der Blindtest setzte GPT Image 2.5 auf den ersten Platz, während es im Bewertungsschema 0.02 hinter Grok Imagine 2.0 Medium liegt, und er ordnete Seedream 5.0 Pro, Nano Banana 2.1 und Grok Imagine 2.0 in umgekehrter Reihenfolge wie das Bewertungsschema. Der Blindtest fiel für Qwen Image 3.0 Pro strenger aus als das Bewertungsschema: Er stufte 7 der 10 Bilder von Qwen als unbrauchbar ein, gegenüber höchstens 2 bei jedem der anderen vier Modelle.
Grenzen dieses Tests
- Pro Modell und Aufgabe wurde ein Bild bewertet, und eine Person hat alle 50 bewertet.
- Grok Imagine 2.0 Medium und GPT Image 2.5 liegen 0.02 auseinander, Nano Banana 2.1 und Seedream 5.0 Pro liegen 0.01 auseinander. Ändert man eine Note in einer Aufgabe um 1 Punkt, verschiebt sich der Durchschnitt eines Modells um 0.02 bis 0.035, also hängen beide Reihenfolgen an einzelnen Noten.
- GPT Image 2.5 wurde auf der dritten seiner fünf Qualitätsstufen getestet. Die anderen vier Modelle wurden auf ihrer höchsten Stufe getestet.
- Qwen Image 3.0 Pro wurde mit ausgeschaltetem Umschreiben des Prompts getestet. Ist es eingeschaltet, schreibt das Modell den Prompt vor dem Erzeugen um, sodass seine Ergebnisse anders ausfallen könnten.
- Die Bilder für Bearbeitung und Referenzen stammen von Seedream 5.0, dem Vorgängermodell aus der Familie von Seedream 5.0 Pro.
- Von den 12 Sprachen, die Qwen Image 3.0 Pro angibt, wurden nur Chinesisch und Japanisch getestet.
- Die Ergebnisse beschreiben diese Modellversionen am 21. Oktober 2026.
Jedes Bild ist öffentlich auf FontVibe, und jede Note hat einen schriftlichen Grund. Wenn du einen Prompt erneut ausführst und ein deutlich anderes Ergebnis bekommst, schreib an hello@fontvibe.ai, und ich nehme es in diesen Beitrag auf.
Anhang: alle Noten
Lesbarkeit / Schrift / Information und Layout / Wirkung, danach die gewichtete Gesamtnote. Jeweils das erste Bild jedes Modells (Aufgabe 10, Seedream 5.0 Pro: das einzige erfolgreiche Bild).
| Aufgabe | Qwen Image 3.0 Pro | GPT Image 2.5 (High) | Nano Banana 2.1 | Seedream 5.0 Pro | Grok Imagine 2.0 Medium |
|---|---|---|---|---|---|
| 1 Einladung | 10/9/7/7 = 8.30 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/9/7/8 = 8.50 | 10/9/9/9 = 9.20 |
| 2 Sticker | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 10/9/9/9 = 9.20 | 10/8/7/8 = 8.15 | 10/9/9/8 = 9.00 |
| 3 Plakat | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/9/7/8 = 8.50 | 9/9/9/9 = 9.00 |
| 4 Programm | 10/7/7/6 = 7.40 | 10/9/9/9 = 9.20 | 10/8/6/8 = 7.90 | 10/9/8/9 = 8.95 | 10/7/9/8 = 8.30 |
| 5 Teeetikett | 10/9/6/9 = 8.45 | 10/9/8/9 = 8.95 | 10/9/8/9 = 8.95 | 10/9/7/9 = 8.70 | 10/9/9/9 = 9.20 |
| 6 Japanisches Plakat | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/9/8/9 = 8.95 | 10/9/9/8 = 9.00 |
| 7 Badge-Logo | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 7/8/9/8 = 8.05 | 10/7/9/8 = 8.30 | 10/9/9/9 = 9.20 |
| 8 Foodtruck | 10/9/8/8 = 8.75 | 4/9/7/9 = 7.50 | 10/9/8/9 = 8.95 | 10/9/9/9 = 9.20 | 10/9/9/9 = 9.20 |
| 9 Bearbeitung | 10/9/7/8 = 8.50 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 |
| 10 Referenzen | 10/9/6/8 = 8.25 | 10/9/9/9 = 9.20 | 10/9/7/8 = 8.50 | 10/9/9/9 = 9.20 | 10/9/8/9 = 8.95 |
Qwen Image 3.0 Pro in 1K (nicht in den Durchschnitten): Aufgabe 4, 10/7/7/6 = 7.40; Aufgabe 5, 10/9/6/9 = 8.45.
Der schriftliche Grund für jede Note ist dokumentiert und auf Anfrage erhältlich.
Häufige Fragen
Ist Qwen Image 3.0 gut bei Design mit Text?
In diesem Test teilte sich Qwen Image 3.0 Pro mit Seedream 5.0 Pro die höchste Lesbarkeitsnote, 10.0, und hatte mit 8.57 von 10 die niedrigste Gesamtnote der fünf Modelle. In 3 seiner 10 bewerteten Bilder ist eine geforderte Zeile verändert oder falsch geschrieben, und seine Layouts erhielten bei Information und Layout die niedrigste Note, 7.7.
Welches KI-Bildmodell hat bei Design mit Text am besten abgeschnitten?
Grok Imagine 2.0 Medium erreichte 9.01 von 10, die höchste Note von fünf Modellen über 10 Aufgaben, und GPT Image 2.5 Sunburst auf Qualität High erreichte 8.99, also 0.02 weniger. Nano Banana 2.1 erreichte 8.76, Seedream 5.0 Pro 8.75 und Qwen Image 3.0 Pro 8.57.
Kann Qwen Image 3.0 Chinesisch und Japanisch schreiben?
In diesem Test ja. Es hat ein zweisprachiges Teeetikett auf Chinesisch und Englisch richtig in vereinfachtem Chinesisch geschrieben und ein dreizeiliges japanisches Plakat vertikal gesetzt, mit jedem Zeichen richtig. Die vier anderen Modelle haben dasselbe geschafft.
Kann Qwen Image 3.0 Bilder bearbeiten?
Ja. In der Bearbeitungsaufgabe hat es ein Datum und einen Preis richtig geändert, aber in seinem ersten Bild auch "18+" in "$Z+" verwandelt, und sein Ergebnis hatte von den fünf Modellen die größte Pixeldifferenz zum Original, 12.2 auf einer Skala von 0 bis 255.
Reicht Qwen Image 3.0 in 1K aus?
In den beiden Aufgaben mit dem kleinsten Text erreichten die 1K-Bilder dieselben Noten wie die 2K-Bilder, 7.4 und 8.45, und jede Zeile blieb lesbar. 1K kostet auf FontVibe 22 Credits und 2K 40.
Wurde GPT Image 2.5 auf seiner höchsten Qualitätsstufe getestet?
Nein. GPT Image 2.5 Sunburst wurde auf High getestet, der dritten seiner fünf Qualitätsstufen und der Standardstufe auf FontVibe. Extra High und Max wurden nicht getestet.
Kann ich alle fünf Modelle an einem Ort ausprobieren?
Alle fünf Modelle stehen im Modellmenü auf FontVibe, und derselbe Prompt lässt sich mit jedem ausführen.
Bereit, es selbst auszuprobieren?
Setz diese Prompt-Techniken direkt um — kein Konto nötig, um loszulegen.
✦ Jetzt generierenFontVibe in Google als bevorzugte Quelle festlegen
Setz diese Prompt-Techniken direkt um — kein Konto nötig, um loszulegen.
Jetzt gestalten
Kommentare