Grok Imagine 2.0 vs GPT Image, Nano Banana & Seedream
Grok Imagine 2.0 und drei andere Modelle, 10 identische Prompts mit viel Text, bewertet wurde jeweils das erste Bild. Nichts ausgesucht.
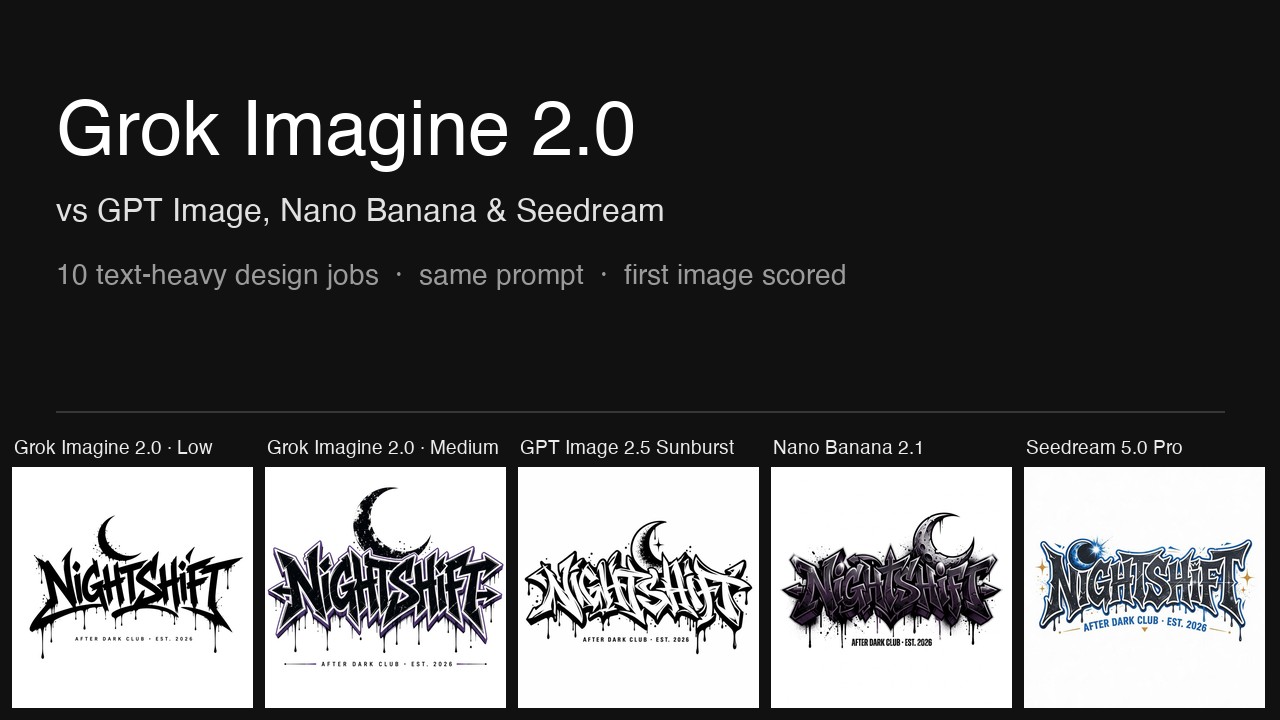
Grok Imagine 2.0 ist das Bildmodell von xAI und erschien im Oktober 2026. Ich habe es gegen drei andere Bildmodelle getestet, mit 10 Design-Aufgaben, in denen überall Text vorkommt: Plakate, eine Speisekarte, ein Logo, eine Einladung, eine Bildbearbeitung und eine Aufgabe mit zwei Referenzbildern. Jedes Modell bekam exakt denselben Prompt, und ich habe jeweils das erste gelieferte Bild bewertet.
Die fünf Konfigurationen, alle in 2K-Auflösung:
- Grok Imagine 2.0, Qualität Low. Grok Imagine 2.0 hat zwei Qualitätsstufen, Low und Medium. Low ist die schnellere.
- Grok Imagine 2.0, Qualität Medium. Medium ist die höchste Stufe von Grok Imagine 2.0.
- GPT Image 2.5 Sunburst (OpenAI), Qualität High. GPT Image 2.5 hat fünf Qualitätsstufen: Low, Medium, High, Extra High und Max. Getestet habe ich High, die Standardstufe auf FontVibe. Extra High und Max habe ich nicht getestet.
- Nano Banana 2.1 (Google). Nano Banana 2.1 hat keine Qualitätsstufe.
- Seedream 5.0 Pro (ByteDance). Seedream 5.0 Pro hat keine Qualitätsstufe.
Die Ergebnisse
| Modell (Stufe) | Lesbarkeit | Schrift und Ausführung | Information und Layout | Wirkung | Gesamt | Mittlere Zeit (Median) | FontVibe-Credits |
|---|---|---|---|---|---|---|---|
| GPT Image 2.5 Sunburst (High) | 9.2 | 8.8 | 8.8 | 8.9 | 8.90 | 36 s | 40 |
| Grok Imagine 2.0 (Medium) | 9.9 | 8.5 | 8.8 | 8.4 | 8.84 | 84 s | 40 |
| Grok Imagine 2.0 (Low) | 9.8 | 8.1 | 8.6 | 8.2 | 8.59 | 23 s | 30 |
| Nano Banana 2.1 | 9.1 | 8.4 | 8.6 | 8.2 | 8.55 | 30 s | 25 |
| Seedream 5.0 Pro | 8.9 | 8.3 | 7.8 | 7.8 | 8.20 | 77 s | 40 |
Die Noten gehen bis 10 und sind der Durchschnitt über das erste Bild jeder der 10 Aufgaben. Die mittlere Zeit (Median) beruht auf 18 neuen Bildern pro Modell (Aufgaben 1 bis 8 und 10, je zwei Bilder) in 2K. Die Credits sind der Preis für ein Bild mit diesen Einstellungen auf FontVibe. Jede einzelne Note steht im Anhang. In einem separaten Blindtest ohne sichtbare Modellnamen lag GPT Image 2.5 ebenfalls vorne und Seedream 5.0 Pro ebenfalls hinten.
GPT Image 2.5 Sunburst erreichte die höchste Note, 8.90 von 10. Grok Imagine 2.0 Medium kam auf 8.84, also 0.06 weniger. Die ersten vier Konfigurationen liegen innerhalb von 0.35 Punkten. Seedream 5.0 Pro erreichte 8.20, 0.35 unter der viertplatzierten Konfiguration.
GPT Image 2.5 lief auf High, der dritten seiner fünf Qualitätsstufen. Grok Imagine 2.0 Medium ist die höchste Stufe von Grok. Der Vergleich stellt also die Standardstufe von GPT Image 2.5 gegen die höchste Stufe von Grok, und dieser Test zeigt nicht, wie GPT Image 2.5 auf Extra High oder Max abschneiden würde.
Textgenauigkeit
Jedes Wort, das die Prompts verlangten, war in allen 50 bewerteten Bildern richtig geschrieben, auch auf dem Plakat in vereinfachtem Chinesisch und auf dem japanischen Plakat. Vier Bilder hatten kleinere Textfehler:
- Nano Banana 2.1, Aufgabe 2: Der Mittelpunkt in "AFTER DARK CLUB · EST. 2026" wurde zu einem Bindestrich.
- Grok Imagine 2.0 Low, Aufgabe 8: Der Mittelpunkt in "OPEN LATE · TAKEAWAY" fehlt.
- Nano Banana 2.1, Aufgabe 8: Eine Kreidetafel, die der Prompt nicht verlangt hat, trägt verstümmelte, unlesbare Schrift.
- Seedream 5.0 Pro, Aufgabe 8: Ein Papierschild und ein Straßenschild, die der Prompt nicht verlangt hat, tragen verstümmelte Schrift.
Drei Bilder enthalten außerdem ganze Textzeilen, die der Prompt nicht verlangt hat: Grok Imagine 2.0 Low in Aufgabe 1 ("Let's celebrate!") und Aufgabe 3 ("LIVE HARD. BURN LOUD. NO APOLOGIES."), und GPT Image 2.5 in Aufgabe 8 (ein Plakat "GOOD NOODLES GOOD MOOD" an der Tür).
So habe ich getestet
Die 10 Aufgaben. Die Aufgaben 1 bis 3 nutzen dieselben Prompts wie mein früherer Test von sieben KI-Design-Tools.
- Einladung zum Kindergeburtstag (3:4): glänzende Ballonbuchstaben, drei Zeilen mit Details
- Brustdruck für ein T-Shirt (1:1): Wildstyle-Graffiti mit Drips, freigestellt auf Weiß
- Konzertplakat (2:3): Schrift aus geschmolzenem Feuer, vier Zeilen mit Details
- Café-Speisekarte auf Kreidetafel (3:4): 9 Positionen mit Preisen, ein É mit Akzent und ein Halbgeviertstrich
- Chinesisches Filmplakat (2:3): ein Titel und zwei Zeilen in vereinfachtem Chinesisch
- Japanisches Ramen-Plakat (3:4): Pinselschrift, Kana und Kanji, Klammern in voller Breite
- Wortmarke für eine Bäckerei (1:1): "Crumb & Co." von Hand geschrieben, einfarbig
- Foto eines Nudelladens (3:2): ein Neonschild und ein gemaltes Fensterschild in der Szene
- Ein vorhandenes Bild bearbeiten (16:9): eine Überschrift ändern, alles andere beibehalten
- Zwei Referenzbilder (1:1): Schrift aus Bild 1, Farben aus Bild 2
Der Test umfasst Design-Bilder mit Text. Porträts, Landschaften und andere Bilder ohne Text habe ich nicht getestet. Der vollständige Prompt jeder Aufgabe steht unten im jeweiligen Abschnitt. Die Regeln:
- Jedes Modell bekam exakt denselben Prompt, Wort für Wort, über den DIY-Modus von FontVibe, der den Prompt unverändert an das Modell schickt. Kein Umschreiben des Prompts und keine Stil-Presets.
- Das Seitenverhältnis wurde als Parameter gesetzt, für jedes Modell gleich.
- Jede Konfiguration hat pro Aufgabe zwei Bilder erzeugt. Nur das erste Bild wird bewertet und gezeigt. Das zweite Bild diente nur dazu, die Konsistenz der Rechtschreibung zu prüfen.
- Alle 100 Bilder wurden am 21. Oktober 2026 erzeugt und sind öffentlich auf FontVibe zu sehen.
Das Bewertungsschema
Das Schema ist der interne Standard von FontVibe für die Bewertung erzeugter Designs und wurde im Oktober 2026 vor diesem Test geschrieben. Ich habe es auch im früheren Test der sieben Tools verwendet. Jedes Bild bekommt vier Noten von 1 bis 10, und für jeden Abzug habe ich zuerst den Grund notiert und erst dann die Zahl vergeben.
| Was ich bewertet habe | Gewicht | Worauf ich geachtet habe |
|---|---|---|
| Lesbarkeit | 20% | Zuerst eine Prüfung auf harte Fehler: verstümmelte Buchstaben, abgeschnittener Text, von anderen Elementen verdeckter Text, kaputte Buchstabenformen. Ohne harte Fehler gibt es 7 bis 10, je nachdem, wie leicht sich die Hauptzeile liest. Jeder harte Fehler bedeutet 1 bis 4. |
| Schrift und Ausführung | 35% | Ob das Bild den Schrifteffekt hat, den der Prompt verlangt hat (Ballons, Graffiti, Feuer, Kreide, Pinsel, Neon), und wie gut er gemacht ist. |
| Information und Layout | 25% | Zuerst, ob die Information vollständig und korrekt ist: Jede Zeile aus dem Prompt ist vorhanden, so geschrieben und gesetzt wie vorgegeben, und nichts wurde hinzugefügt, was der Prompt nicht verlangt hat. Ein Design mit falscher Information verfehlt seine Hauptaufgabe, deshalb kommt dieser Punkt vor allem anderen. Jede fehlende, veränderte oder hinzugefügte Zeile oder Satzzeichen kostet mindestens 1 Punkt. Danach, ob die wichtigste Zeile zuerst gelesen wird und die Zeilen in der richtigen Reihenfolge stehen. |
| Wirkung | 20% | Ob das Bild aussieht, als hätte es ein professioneller Designer gemacht. |
Die Gesamtnote wird berechnet, nicht geschätzt: 0.20 × Lesbarkeit + 0.35 × Schrift + 0.25 × Information und Layout + 0.20 × Wirkung.
Beim Bewerten wusste ich, welches Modell welches Bild gemacht hat. Um Voreingenommenheit zu prüfen, habe ich zusätzlich einen Blindtest mit verborgenen Modellnamen gemacht.
Die Aufgaben 9 und 10 starten mit vorhandenen Bildern. Alle drei stammen aus der öffentlichen Galerie von FontVibe, und keines wurde von einem der vier getesteten Modelle erstellt. Alle drei stammen von früheren Seedream-Modellen (Seedream 5.0 Lite und Seedream 5.0), also aus derselben Modellfamilie wie Seedream 5.0 Pro.
Aufgabe für Aufgabe
Aufgabe 1: Einladung zum Kindergeburtstag
Birthday party invitation for my daughter, "Mia's 7th Birthday" in glossy balloon letters, "Saturday, Nov 14 · 2 PM", "Sunny Park Pavilion", "RSVP by Nov 7", bright and playful, portrait card
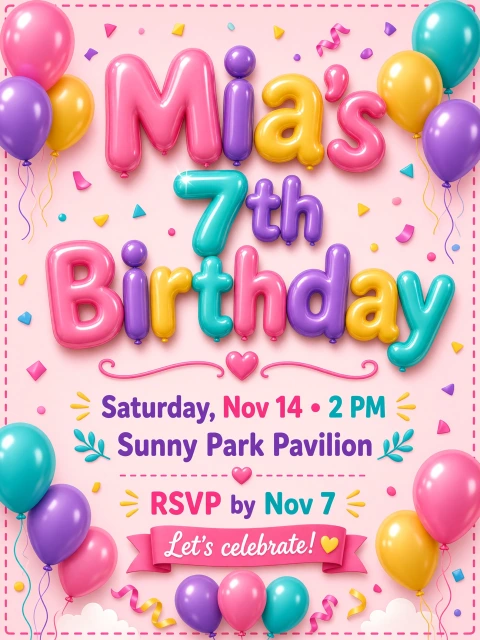
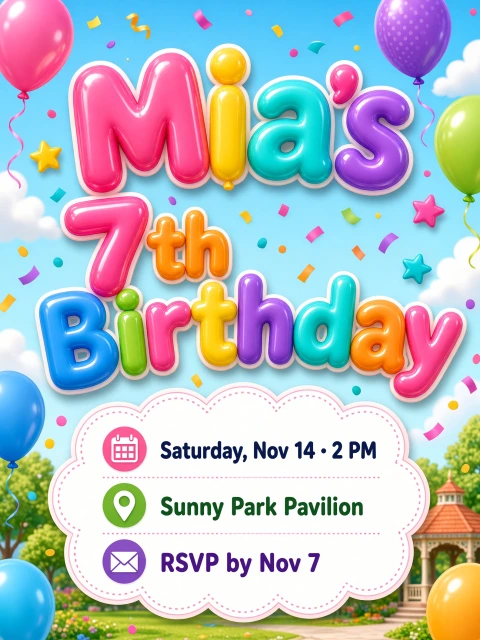
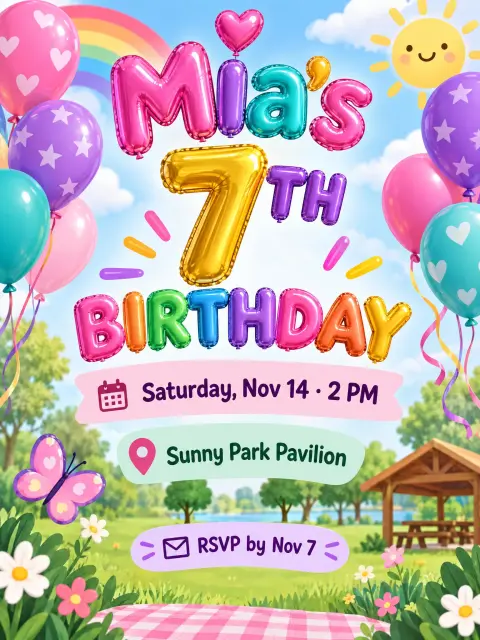
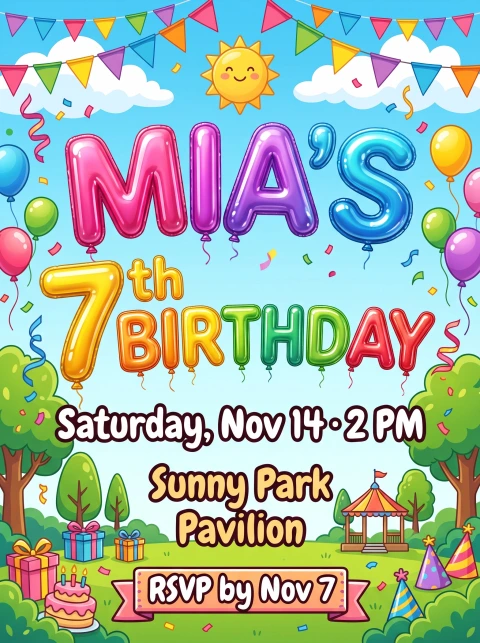
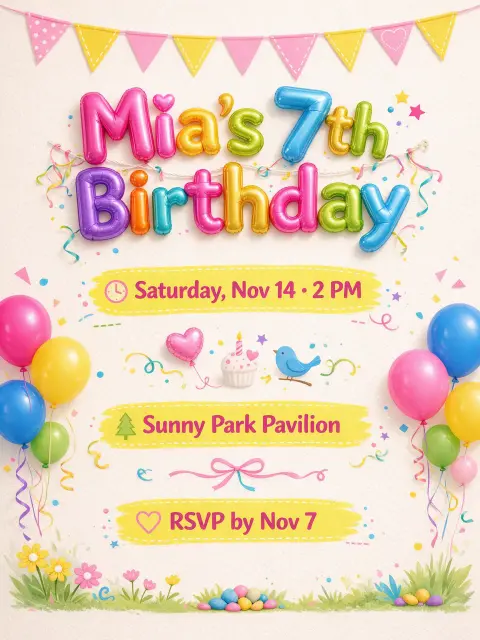
GPT Image 2.5 und Grok Imagine 2.0 Medium teilten sich die höchste Note, 9.2. Beide haben glänzende Folienballon-Buchstaben gemacht und die drei Detailzeilen in beschrifteten Karten gruppiert. Grok Imagine 2.0 Low verlor 1 Punkt bei Information und Layout, weil es ein Banner "Let's celebrate!" hinzugefügt hat. Nano Banana 2.1 erreichte die niedrigste Note, 8.55: Die Datumszeile ist eng gesetzt, und die drei Detailzeilen nutzen drei verschiedene Schriften. Ballonbuchstaben als Preset findest du beim Bubble-Letter-Stil.
Aufgabe 2: Brustdruck für ein T-Shirt
Front chest print for my streetwear brand, "NIGHTSHIFT" in wildstyle graffiti with drips, small "AFTER DARK CLUB · EST. 2026" underneath, a crescent moon graphic, isolated on plain white so I can send it to the printer
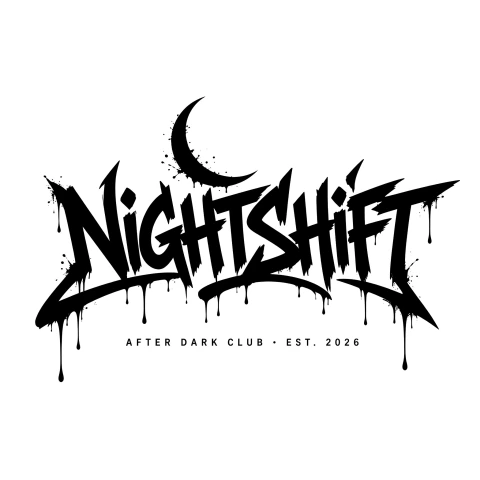
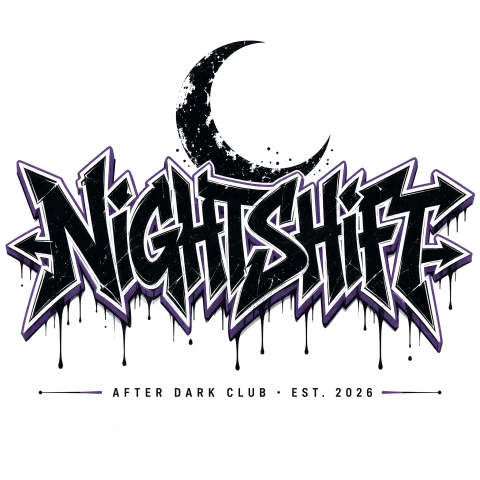
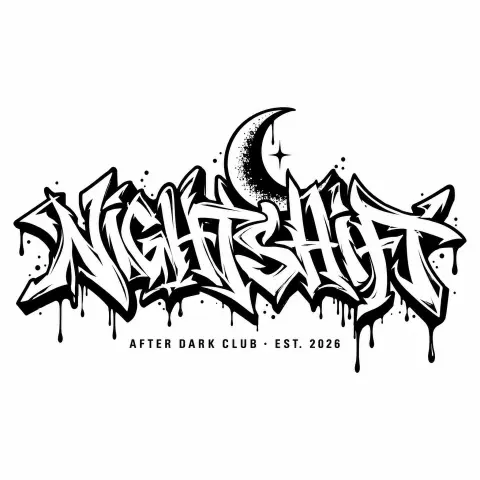
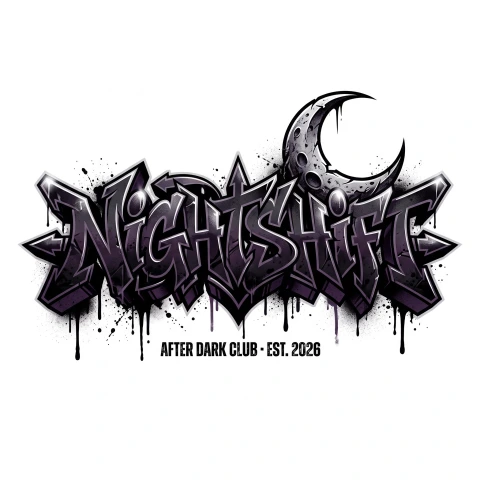
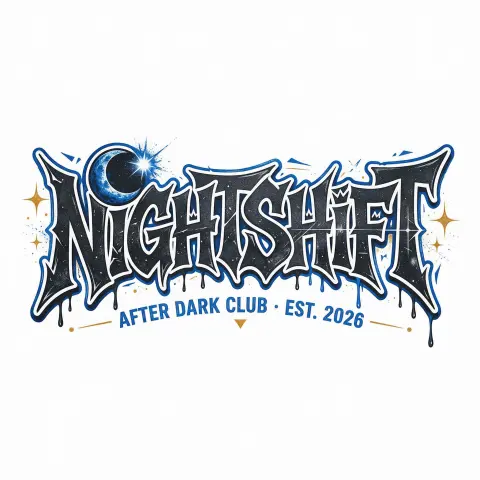
Grok Imagine 2.0 Medium erreichte die höchste Note, 9.0, mit Wildstyle-Buchstaben mit Pfeilspitzen, Drips und einer violetten 3D-Kante, die trotzdem als NIGHTSHIFT lesbar sind. GPT Image 2.5 hat den am stärksten verschlungenen Wildstyle der fünf gemacht, und seine Lesbarkeitsnote ist 7, weil man die Buchstaben nur mit Mühe liest. Grok Imagine 2.0 Low erreichte die niedrigste Note, 8.3: Seine Buchstaben sind ein Pinsel-Tag-Stil ohne die ineinandergreifenden Formen, die Wildstyle ausmachen. Nano Banana 2.1 hat aus dem "·" einen Bindestrich gemacht. Mehr zu diesem Look findest du beim Graffiti-Textstil.
Aufgabe 3: Konzertplakat
A3 gig poster for my band "BURNING ORCHARD", band name in molten fire lettering as the main focus, "with special guests THE LOW TIDES", "SAT 14 NOV · DOORS 8 PM", "THE CELLAR · 22 MILL STREET", "TICKETS £12 ON THE DOOR", gritty rock atmosphere with burning trees

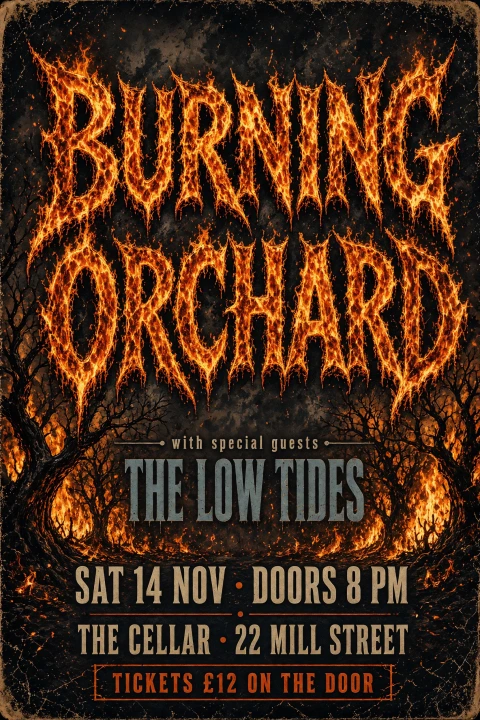
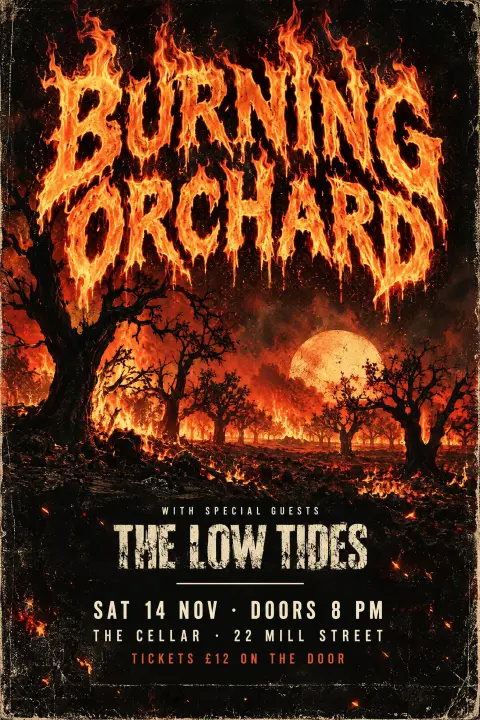
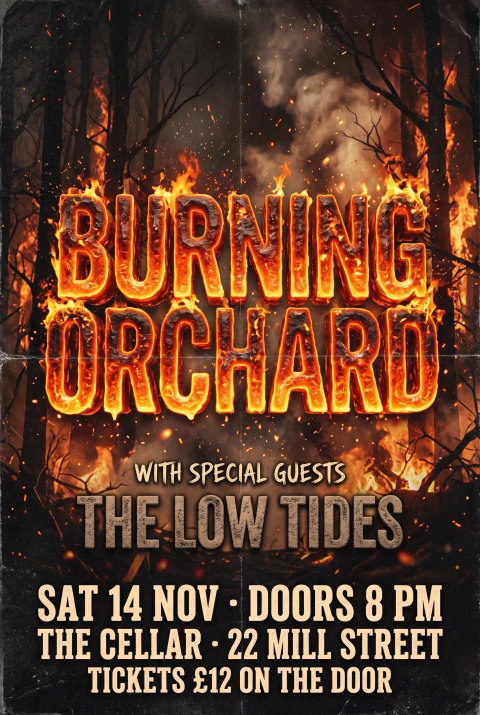
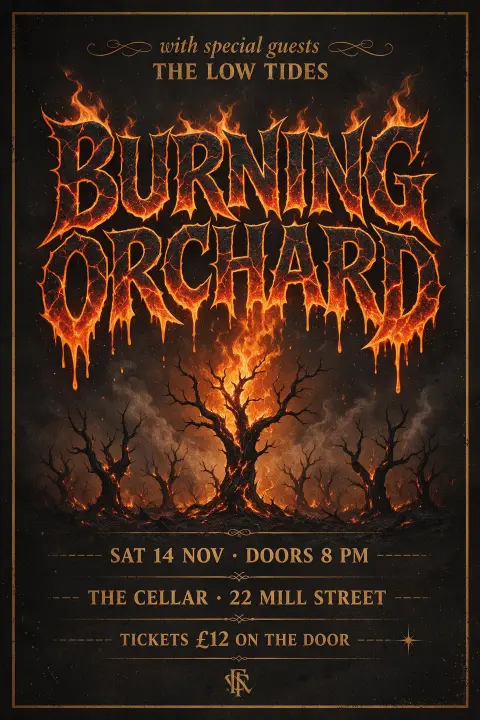
Grok Imagine 2.0 Medium erreichte die höchste Note, 9.2, ohne Abzug bei Information und Layout: Bandname, Vorband, Datum, Location und Preis lesen sich in dieser Reihenfolge. Grok Imagine 2.0 Low hat unten die Zeile "LIVE HARD. BURN LOUD. NO APOLOGIES." hinzugefügt, die nicht im Prompt stand. Seedream 5.0 Pro erreichte die niedrigste Note, 8.5, weil es die Vorband über den Headliner gesetzt hat, und damit stimmt die Rangfolge auf dem Plakat nicht. Feuerschrift als Preset findest du beim Feuer-Textstil.
Aufgabe 4: Café-Speisekarte auf Kreidetafel
Chalkboard menu for my coffee shop, title "SUNNY SIDE CAFÉ" in hand-chalked lettering, then this exact list with prices, one item per line: "Espresso 3.20", "Cappuccino 4.10", "Flat White 4.30", "Oat Latte 4.60", "Matcha Latte 4.80", "Cold Brew 4.50", "Croissant 3.40", "Banana Bread 3.80", "Avocado Toast 7.90", and a small footer "Free Wi-Fi · Open 7 AM–4 PM"
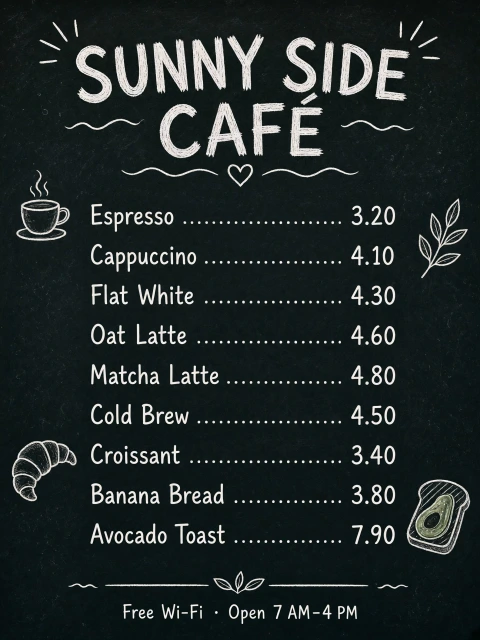
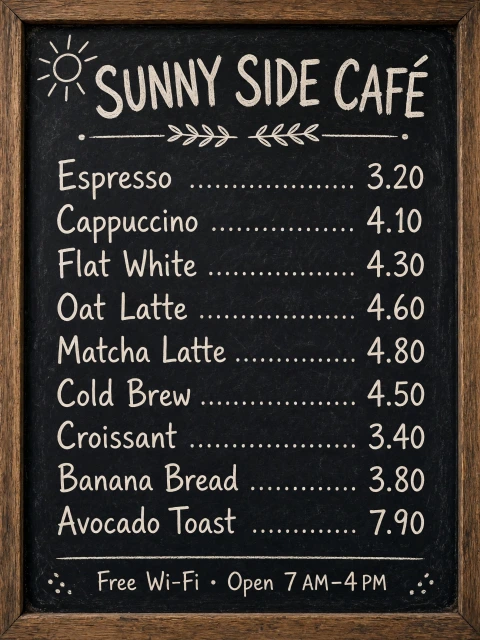
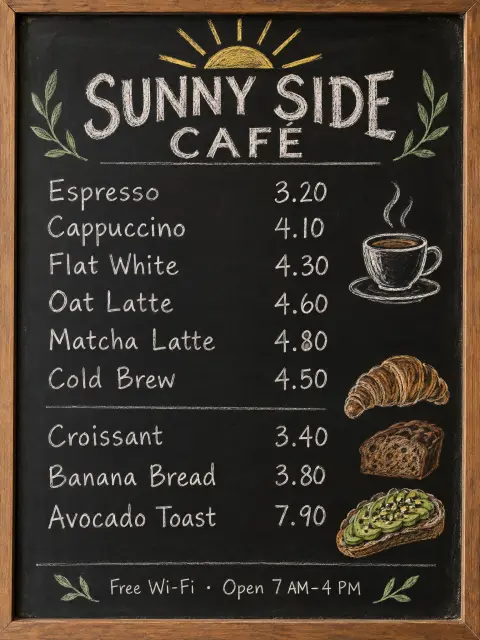
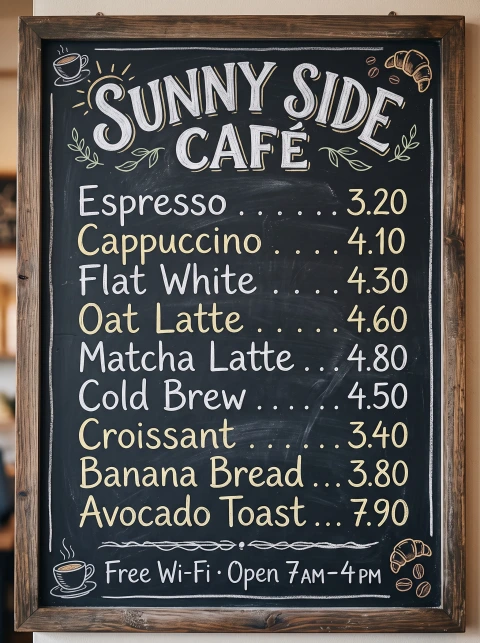
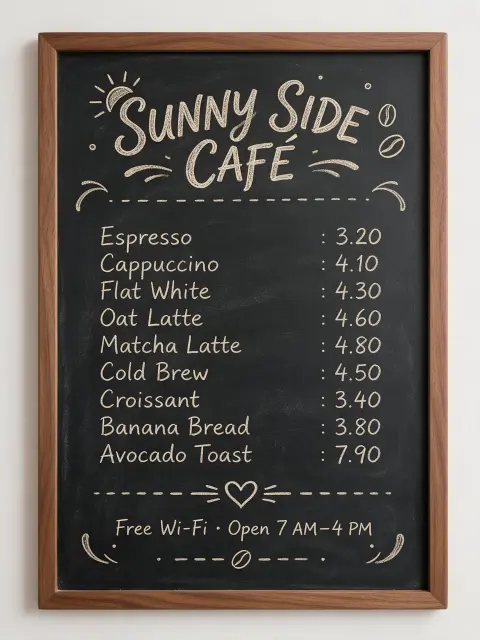
Alle fünf Modelle haben alle 11 geforderten Zeilen richtig geschrieben, inklusive des É in CAFÉ und des Halbgeviertstrichs in 7 AM–4 PM. GPT Image 2.5 erreichte die höchste Note, 9.2: Seine Buchstaben haben sichtbare Kreidekörnung, und es hat Getränke und Essen mit einer Linie getrennt. Die Speisekarten von Grok Imagine 2.0 und Nano Banana 2.1 nutzen sauberere Buchstaben, die nach Druckschrift aussehen. Seedream 5.0 Pro erreichte die niedrigste Note, 7.75: Die Tafel ist klein im Bild, und vor jedem Preis wurde ein Doppelpunkt eingefügt. Kreideschrift als Preset findest du beim Kreide-Textstil.
Aufgabe 5: Chinesisches Filmplakat
Movie poster, title "长夜将尽" in heavy cracked-steel lettering, below it "十一月十五日 全国上映" and the tagline "黎明之前 无路可退", rainy city at night, all text in Simplified Chinese, no other text
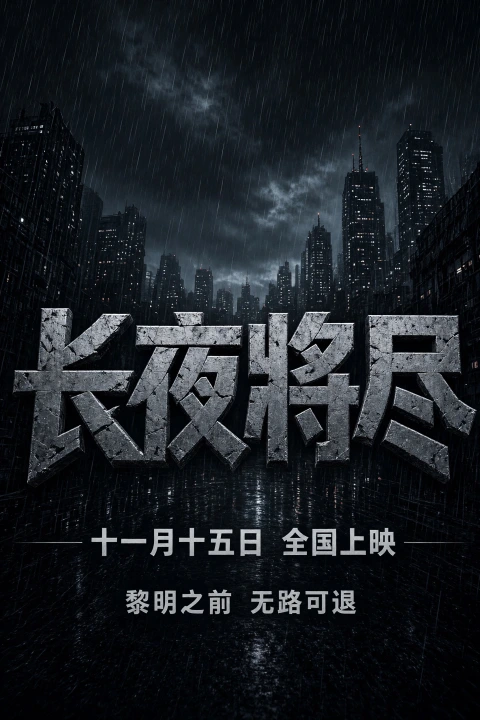
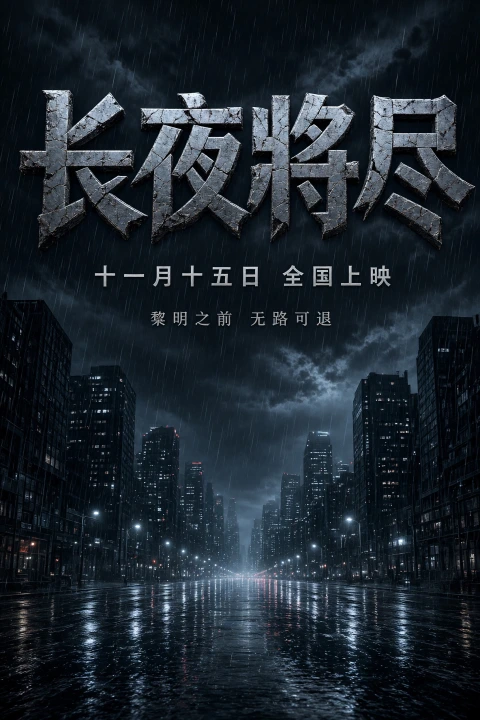
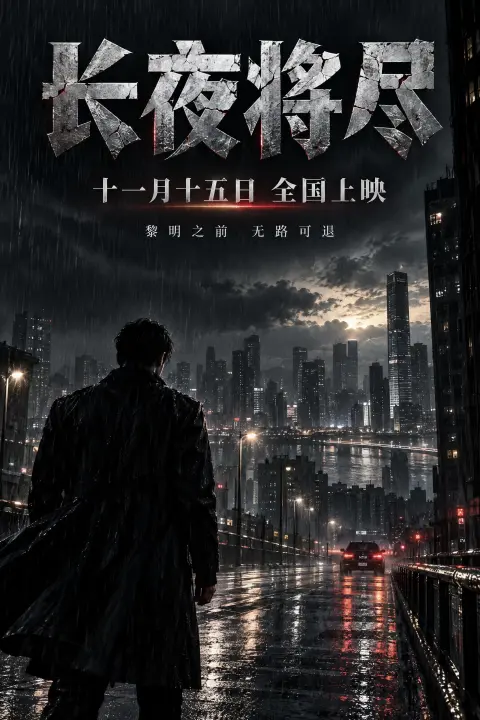
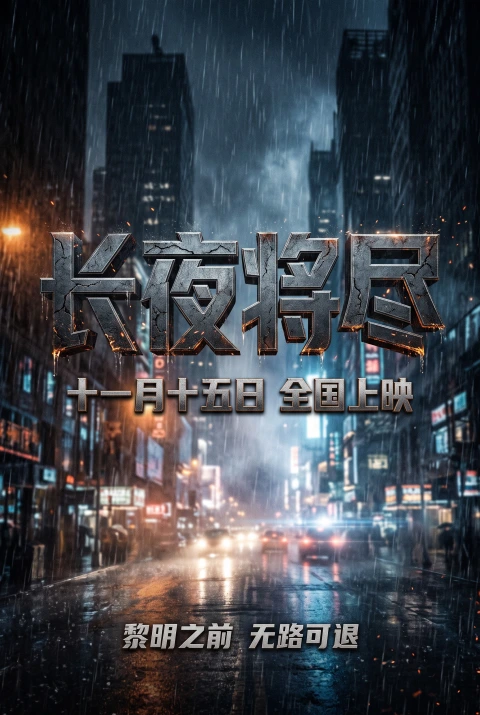
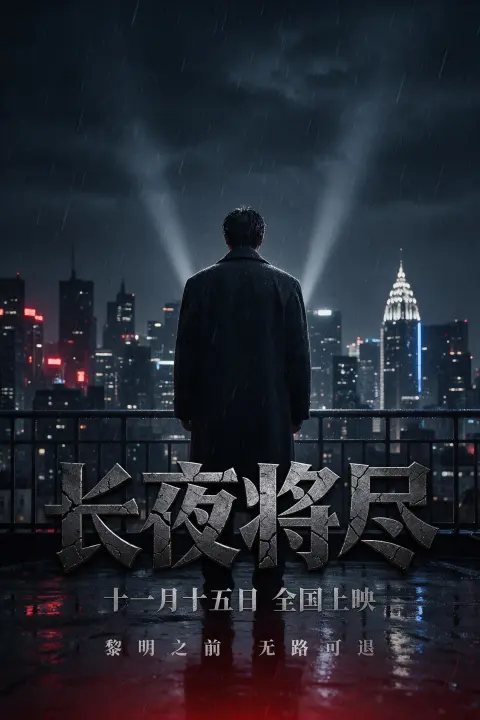
Alle fünf Modelle haben vereinfachtes Chinesisch verwendet, alle 22 geforderten Zeichen richtig geschrieben und keinen weiteren Text hinzugefügt. Grok Imagine 2.0 Low erreichte die höchste Note, 9.0. Die Risse bei GPT Image 2.5 sind die tiefsten der fünf, und seine Lesbarkeitsnote ist 8, weil das letzte Zeichen, 尽, einen zweiten Blick braucht. Nano Banana 2.1 erreichte die niedrigste Note, 8.05: Seine Buchstaben wirken wie rostiges Metall statt wie rissiger Stahl. Schrift aus Stahl und Chrom findest du beim Metallic-Textstil.
Aufgabe 6: Japanisches Ramen-Plakat
Summer menu poster for a ramen shop, headline "冷やし中華はじめました" in bold brush lettering, sub-line "期間限定 8月31日まで", price tag "980円(税込)", fresh blue and white summer feel, no other text
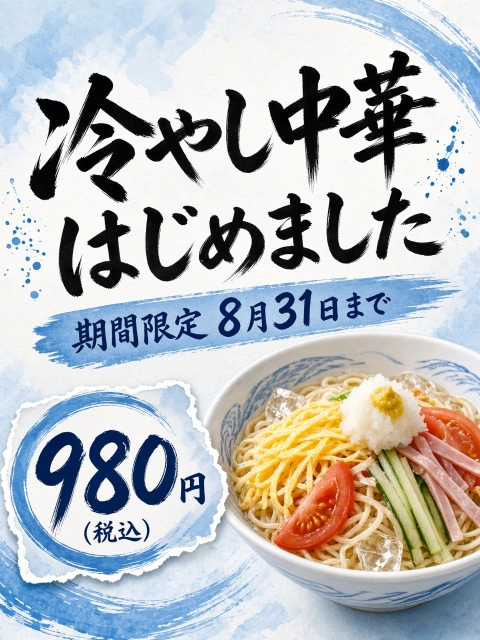
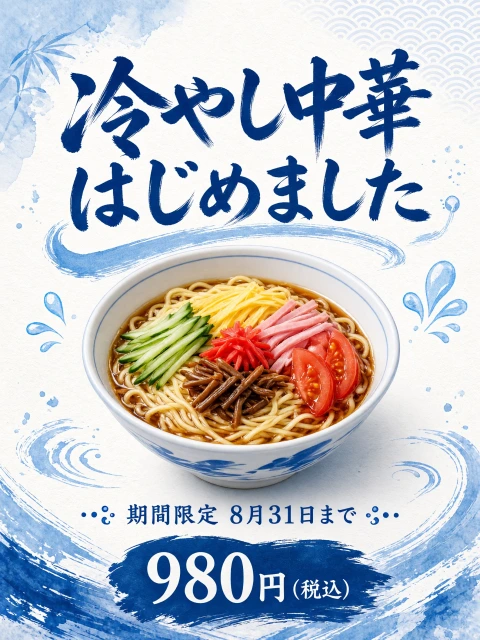
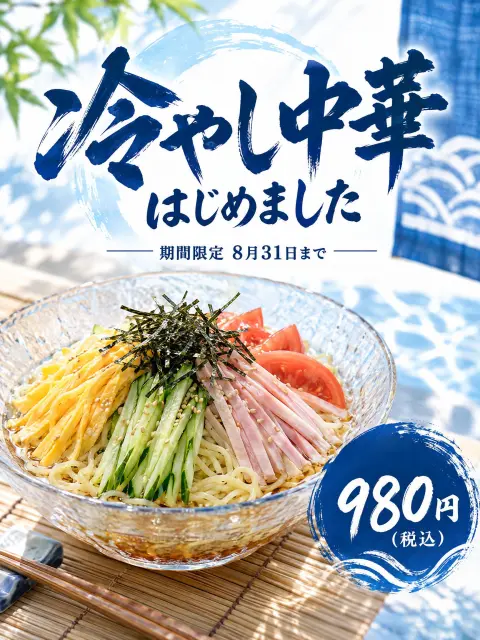
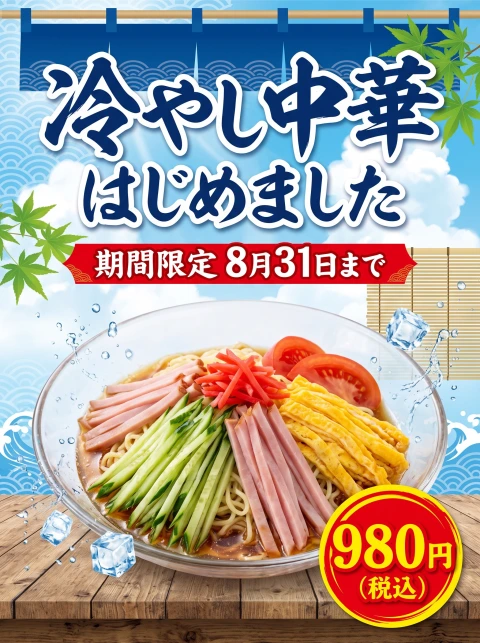
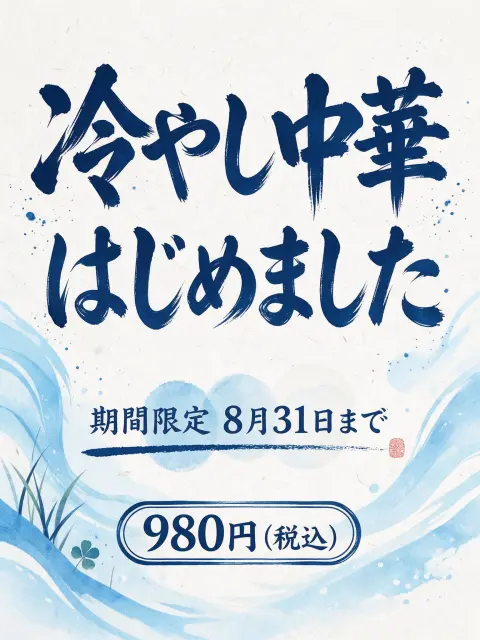
Alle fünf Modelle haben Kana, Kanji und die Klammern in voller Breite richtig geschrieben. Grok Imagine 2.0 Low erreichte die höchste Note, 9.2, mit sichtbaren Pinselstrichen und dem Gericht unter der Überschrift. Die Überschrift von Nano Banana 2.1 ist eine Konturschrift statt Pinselschrift. Seedream 5.0 Pro hat mit die beste Pinselschrift dieser Runde, zeigt aber kein Essen, also ist die untere Hälfte eines Speisekarten-Plakats leer. Beide erreichten 8.3. Pinselschrift findest du beim japanischen Pinsel-Tusche-Stil.
Aufgabe 7: Wortmarke für eine Bäckerei
Wordmark logo for a small bakery called "Crumb & Co.", hand-lettered with a playful baseline and a tiny wheat sprig on the ampersand, flat vector look, one color, on plain white, no other text
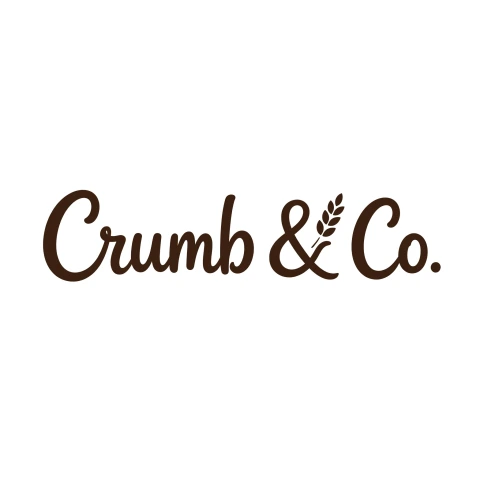
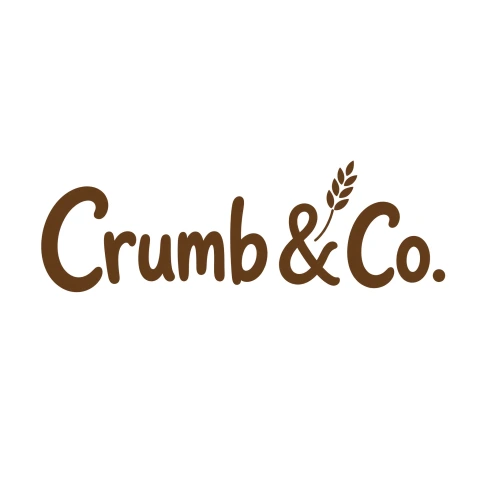
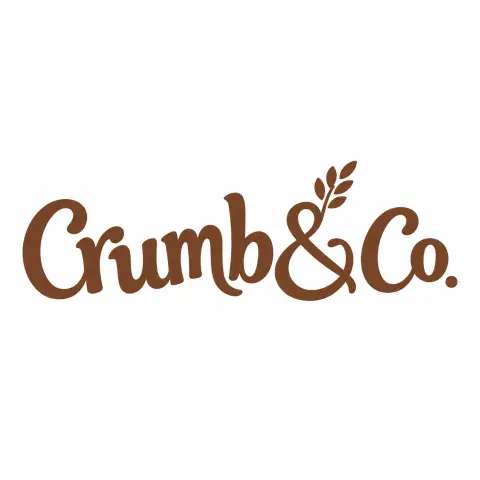
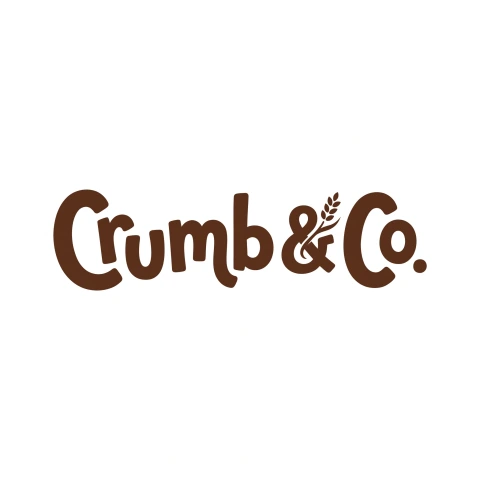
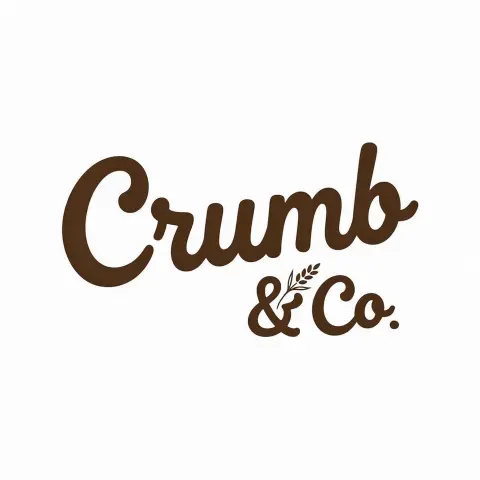
GPT Image 2.5 erreichte die höchste Note, 9.2: Die Grundlinie hüpft, und der Weizenzweig wächst aus dem Et-Zeichen, so wie der Prompt es verlangt hat. Nano Banana 2.1 erreichte 9.0 mit einem ähnlichen Ergebnis. Beide Stufen von Grok Imagine 2.0 erreichten 7.85, die niedrigste Note dieser Aufgabe: Die Grundlinie ist fast flach, und die Buchstaben sehen aus wie eine vorhandene Schrift statt wie Handlettering.
Aufgabe 8: Foto eines Nudelladens
Realistic photo of a small noodle shop at dusk, a glowing neon sign above the door that reads "LUNA NOODLE BAR" and a hand-painted window sign "OPEN LATE · TAKEAWAY", wet street reflections, shot on a 35mm lens
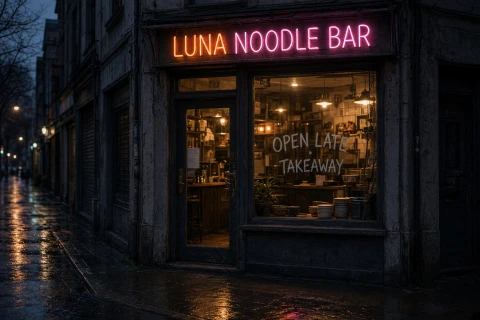
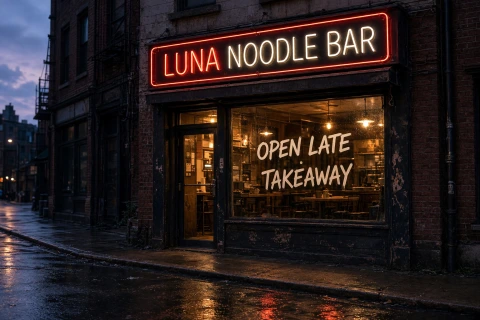
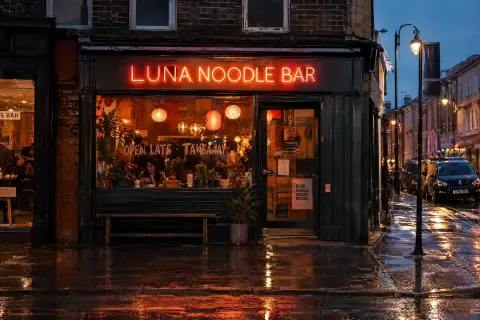
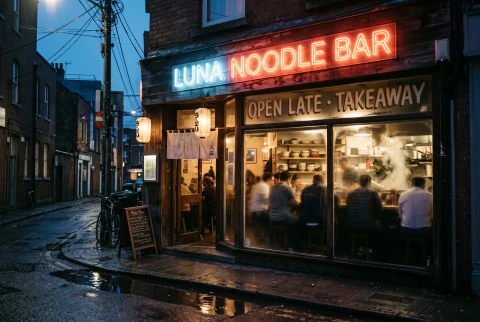
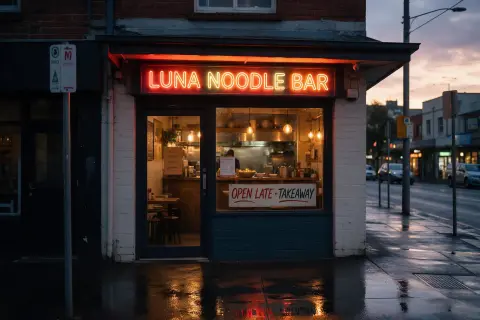
Grok Imagine 2.0 Medium erreichte die höchste Note, 9.2: Beide Schilder sitzen mit der richtigen Perspektive in der Szene, und sonst trägt nichts Text. Nano Banana 2.1 und Seedream 5.0 Pro haben jeweils zusätzliche Schilder mit verstümmelter Schrift hinzugefügt. Verstümmelte Schrift ist nach dem Schema ein harter Fehler, deshalb bekamen beide eine Lesbarkeitsnote von 4, und die nicht verlangten Schilder kosteten jedes Modell 1 Punkt bei Information und Layout. Seedream 5.0 Pro erreichte die niedrigste Note, 7.2, und Nano Banana 2.1 erreichte 7.75. GPT Image 2.5 hat die überzeugendste Straße gemacht, aber ein Plakat "GOOD NOODLES GOOD MOOD" hinzugefügt. Schilder als Preset findest du beim Neonschild-Textstil.
Aufgabe 9: Ein vorhandenes Bild bearbeiten
Change the headline "Thank you" to "Welcome back" and keep everything else exactly as it is
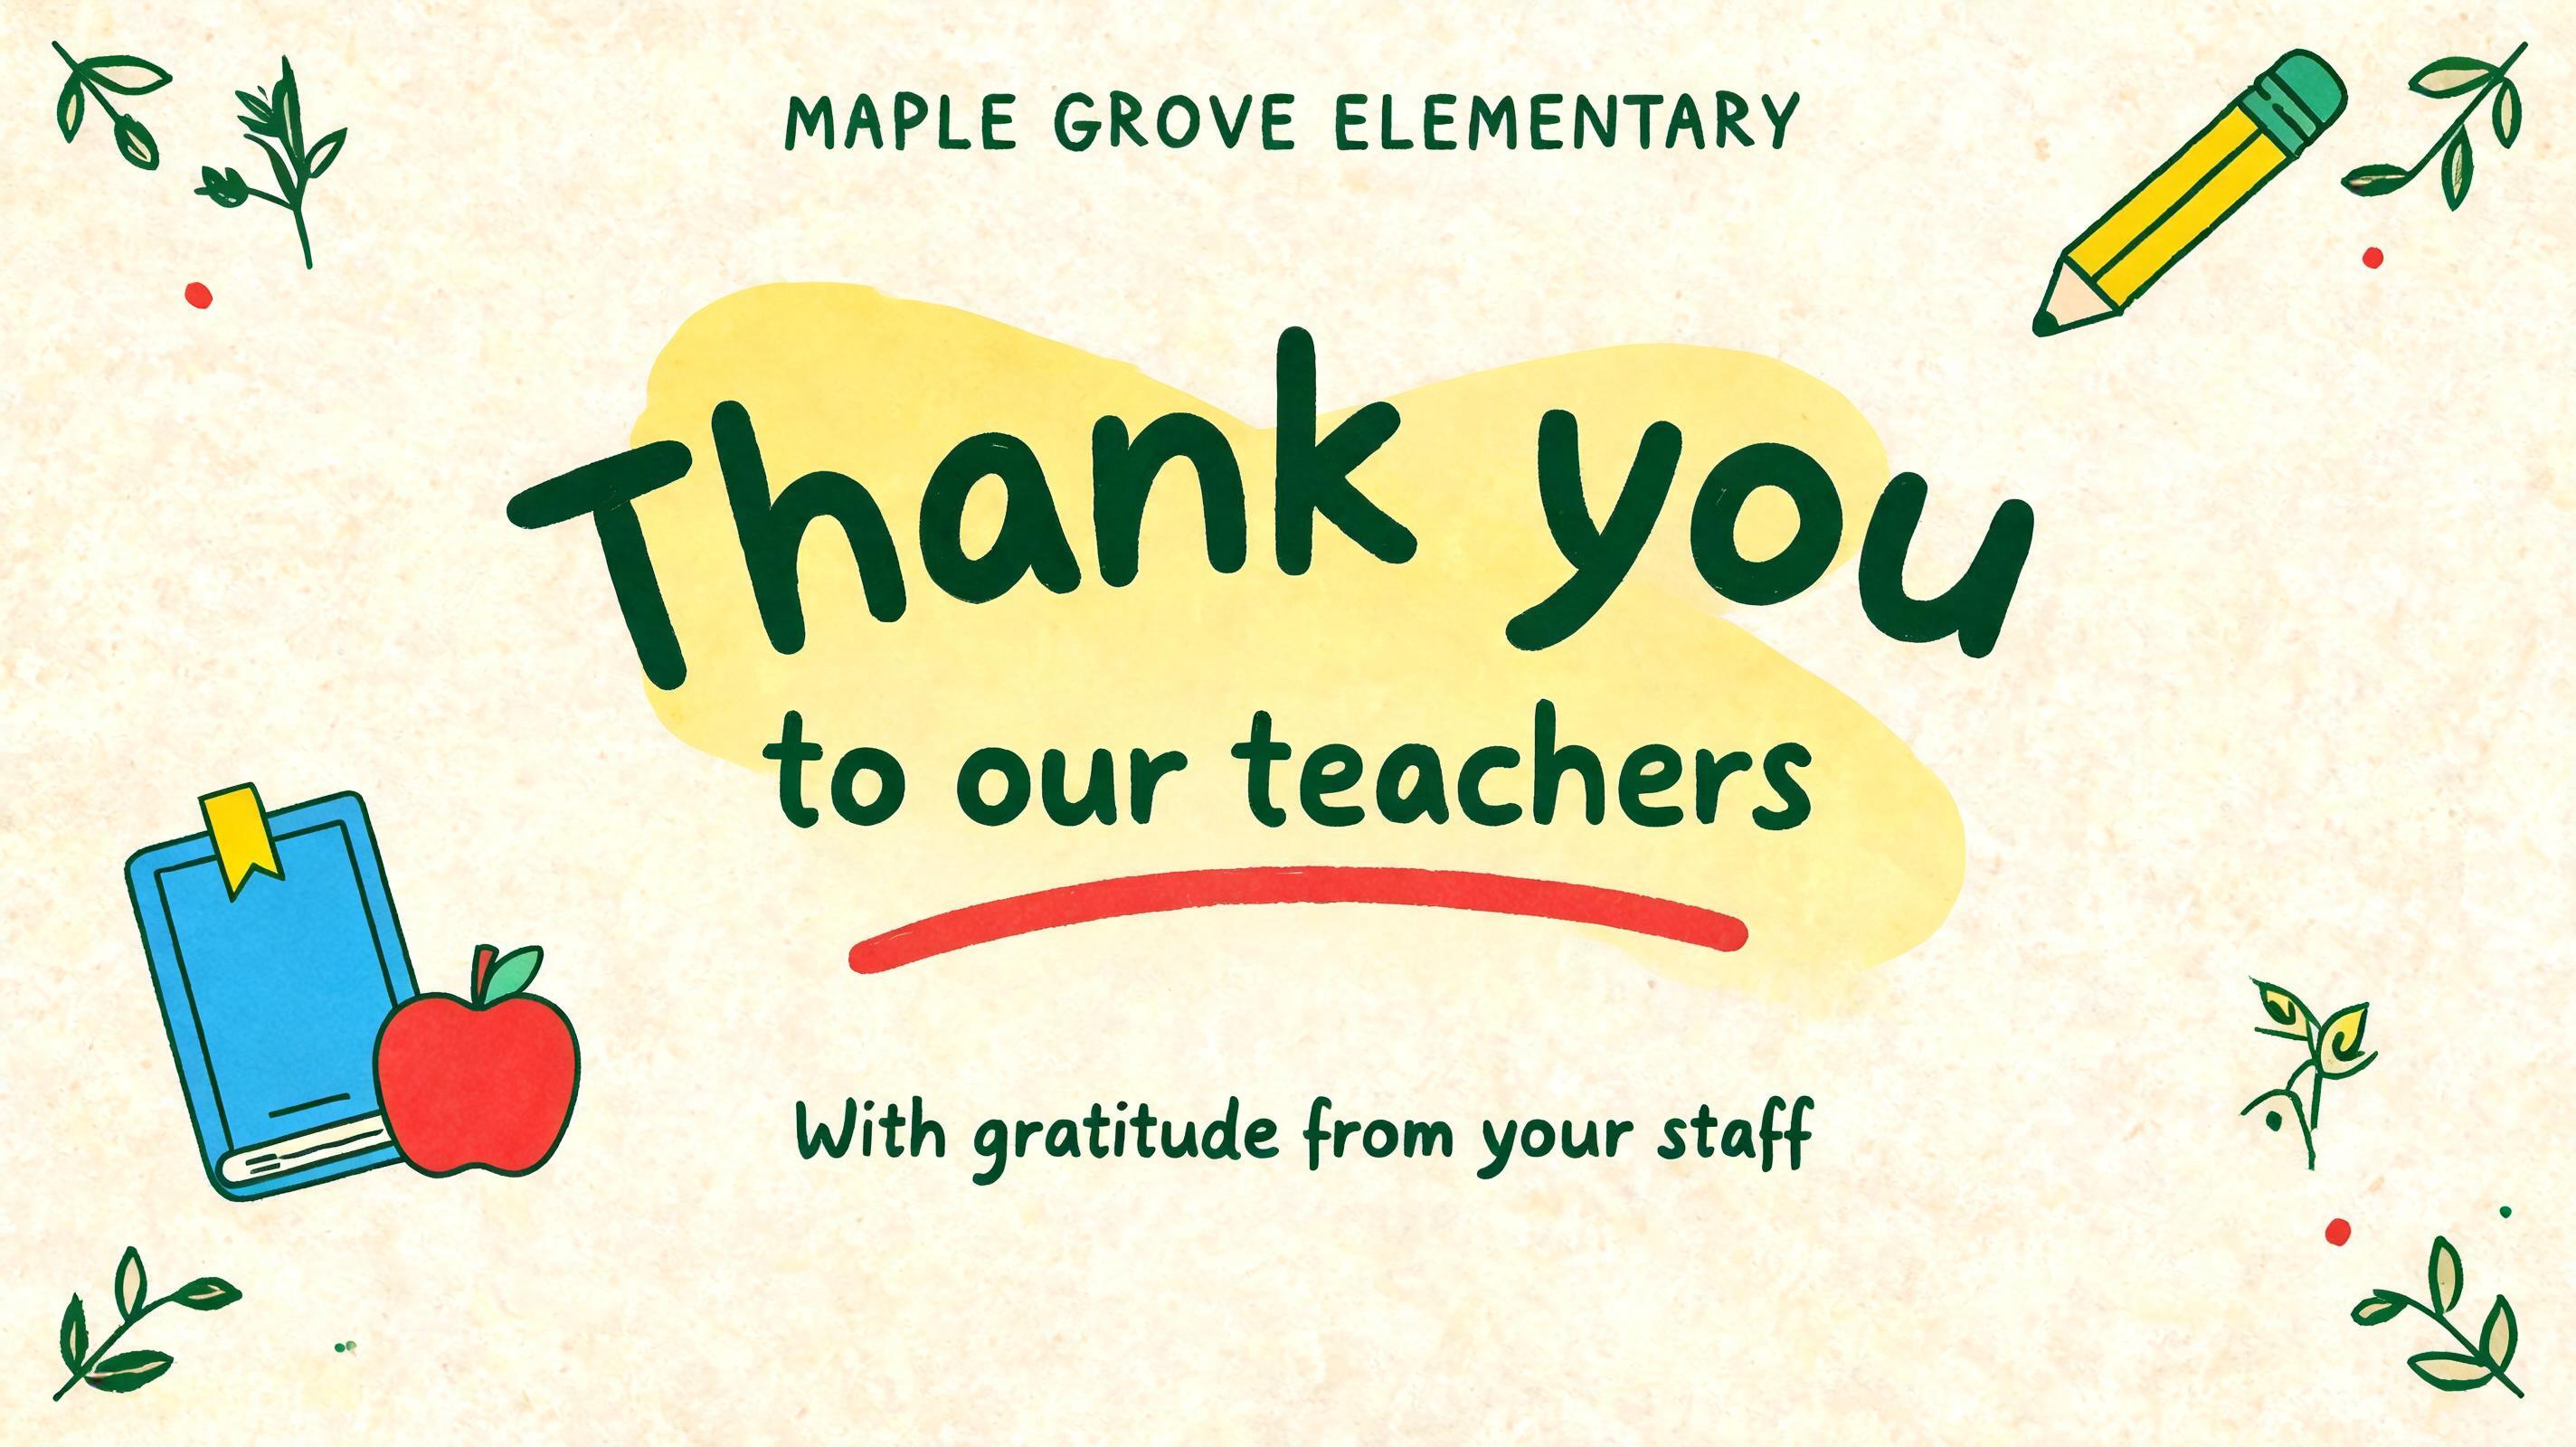
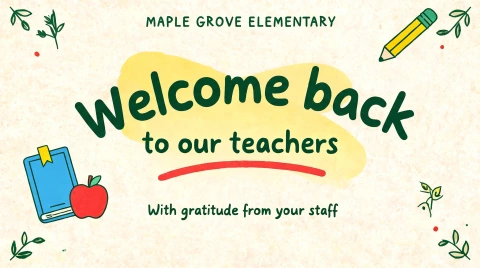
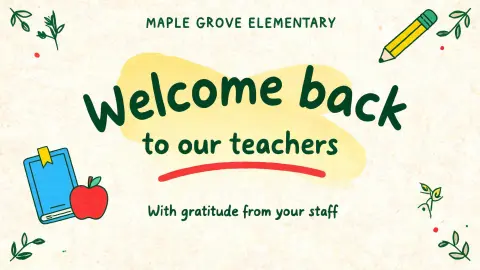
Alle fünf Modelle haben die Überschrift geändert, den handgeschriebenen Stil beibehalten und die anderen drei Zeilen unverändert gelassen, also erreichten alle fünf 9.0. Das Schema misst nicht, ob der Rest des Bildes gleich geblieben ist, deshalb habe ich das separat gemessen. Jedes Ergebnis und das Original wurden auf 800 × 450 verkleinert und in Graustufen umgewandelt, und ich habe die mittlere absolute Pixeldifferenz (0 bis 255) außerhalb eines Rahmens um die Überschrift berechnet. Niedriger heißt näher am Original.
| Modell | Abweichung vom Original |
|---|---|
| Seedream 5.0 Pro | 3.2 |
| GPT Image 2.5 Sunburst | 3.8 |
| Nano Banana 2.1 | 7.0 |
| Grok Imagine 2.0 Medium | 8.6 |
| Grok Imagine 2.0 Low | 8.9 |
Das Original hat 2848 × 1600 Pixel. Seedream 5.0 Pro und GPT Image 2.5 haben dieselbe Größe geliefert. Nano Banana 2.1 lieferte 2752 × 1536 und Grok Imagine 2.0 lieferte 2816 × 1584, also stammt ein Teil ihrer Abweichung vom Skalieren. Beim zweiten Bild lag die Abweichung von Grok Imagine 2.0 Low bei 15.9.
Aufgabe 10: Zwei Referenzbilder
Square social post that says "WEEKEND MARKET" with a small line "Every Saturday · 9 AM". Use the lettering style of reference image 1 and the color palette of reference image 2.
Referenzbild 1 zeigte Ballonbuchstaben in Pastell. Referenzbild 2 war eine Comic-Explosion im Pop-Art-Stil in Rot, Gelb und Blau. Das richtige Ergebnis sind ballonförmige Buchstaben in Rot, Gelb und Blau.


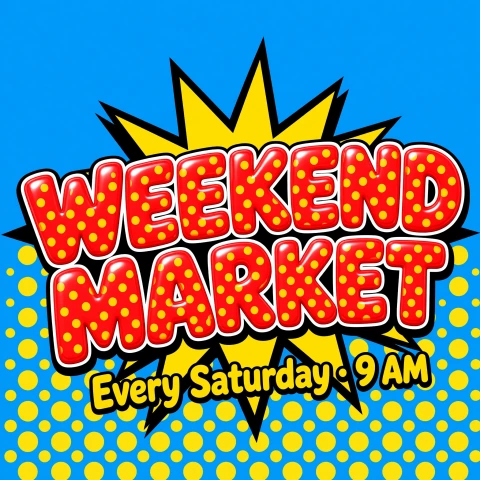
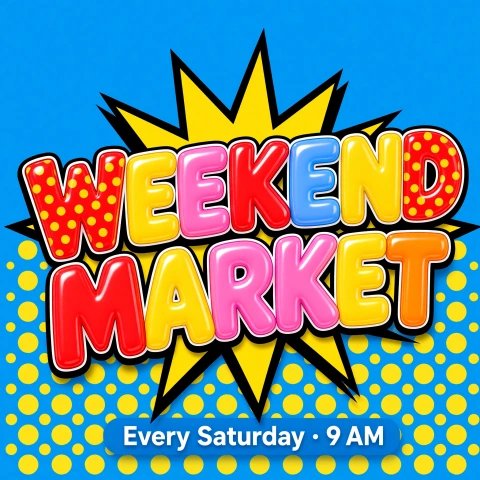
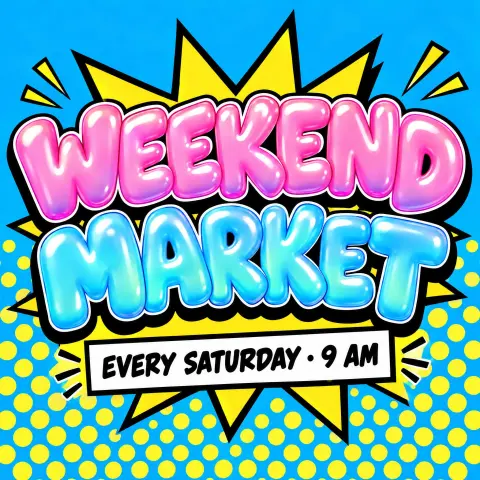
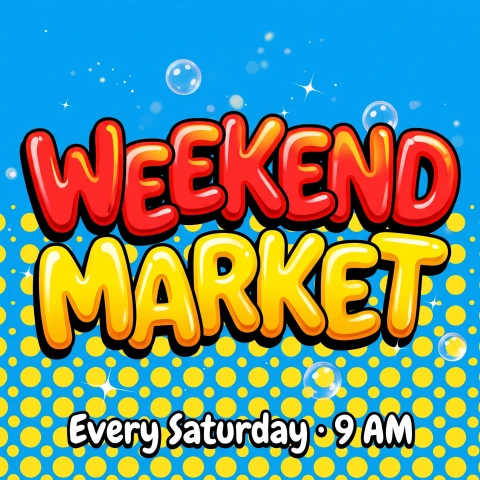
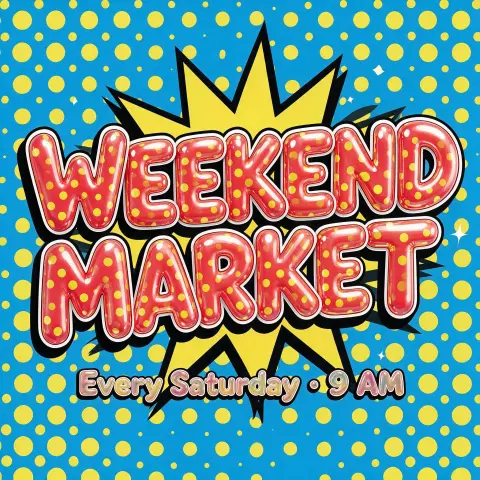
Nano Banana 2.1 war das einzige Modell, dessen erstes Bild beide Teile richtig umgesetzt hat, und es erreichte 9.2. GPT Image 2.5 hat Ballonbuchstaben gemacht, sie aber in den Pastelltönen von Referenz 1 eingefärbt. Grok Imagine 2.0 Medium hat Ballonbuchstaben überwiegend in Rot und Gelb gemacht, mit etwas Rosa und Blau aus Referenz 1. Grok Imagine 2.0 Low und Seedream 5.0 Pro haben die Comic-Schrift mit Punkten aus Referenz 2 übernommen statt der Ballonformen. Seedream 5.0 Pro erreichte 7.1, die niedrigste Note in diesem Test.
Grok Imagine 2.0: Low oder Medium?

Grok Imagine 2.0 Medium erreichte insgesamt 8.84 und Grok Imagine 2.0 Low 8.59. Medium lag bei der Schrift vorne (8.5 zu 8.1) und bei Information und Layout (8.8 zu 8.6), und keines seiner 10 bewerteten Bilder enthält Text, den der Prompt nicht verlangt hat. Low hat in 2 von 10 Bildern nicht verlangten Text hinzugefügt. Die mittlere Zeit von Medium lag bei 84 Sekunden pro Bild, bei Low bei 23 Sekunden, und auf FontVibe kostet ein 2K-Bild in Medium 40 Credits, in Low 30.
Für ein finales Bild, das gedruckt oder veröffentlicht wird, hat Medium besser abgeschnitten. Wenn du schnell mehrere Ideen ausprobieren willst: Die mittlere Zeit von Low lag bei 27% der Zeit von Medium.
Grok Imagine 2.0 Medium hatte in diesem Test die höchste Lesbarkeitsnote, 9.9, und die höchste Note in 4 der 9 Aufgaben ohne Gleichstand (Einladung, T-Shirt, Plakat, Nudelladen). Seine niedrigste Note war das Bäckerei-Logo, 7.85.
Um Grok Imagine 2.0 auszuprobieren, wähl es im Modellmenü des FontVibe-Generators. Wenn du mit der Maus über ein Grok-Bild in diesem Beitrag fährst, erscheint ein Recreate-Button, der denselben Prompt ausführt.
Jedes Modell in Kürze
GPT Image 2.5 Sunburst (High), 8.90. Höchste Noten bei Schrift, Information und Layout sowie Wirkung (bei Information und Layout gleichauf mit Grok Imagine 2.0 Medium). Höchste Note in 3 der 9 Aufgaben ohne Gleichstand (Einladung, geteilt mit Grok Imagine 2.0 Medium; Speisekarte; Logo). Niedrigste Note 8.5, bei der Referenzaufgabe. Getestet auf High; Extra High und Max wurden nicht getestet.
Grok Imagine 2.0 Medium, 8.84. Höchste Lesbarkeitsnote, 9.9. Höchste Note in 4 der 9 Aufgaben ohne Gleichstand (Einladung, geteilt mit GPT Image 2.5; T-Shirt; Plakat; Nudelladen). Niedrigste Note 7.85, beim Logo. Mittlere Zeit 84 Sekunden.
Grok Imagine 2.0 Low, 8.59. Mittlere Zeit 23 Sekunden, die schnellste in diesem Test. Höchste Note in 2 Aufgaben (chinesisches Plakat, japanisches Plakat). Hat in 2 von 10 Bildern Text hinzugefügt, den der Prompt nicht verlangt hat.
Nano Banana 2.1, 8.55. Kostet auf FontVibe 25 Credits pro 2K-Bild, am wenigsten von den vier Modellen. Das einzige Modell, dessen erstes Bild in Aufgabe 10 beide Referenzbilder richtig umgesetzt hat. Verstümmelter Hintergrundtext in Aufgabe 8.
Seedream 5.0 Pro, 8.20. Niedrigste Gesamtnote und niedrigste Note bei Information und Layout, 7.8. Am nächsten am Original bei der Bearbeitungsaufgabe, mit einer Pixeldifferenz von 3.2. Verstümmelter Hintergrundtext in Aufgabe 8.
Ein Blindtest
Weil ich beim Bewerten wusste, welches Modell welches Bild gemacht hat, habe ich zusätzlich einen Blindtest gemacht. Eine private Seite zeigte die fünf Bilder jeder Aufgabe in zufälliger Reihenfolge ohne Modellnamen. Jedes Bild bekam eine Note von 1 bis 5 für die Schrift, eine Note von 1 bis 5 für das Layout und eines von drei Urteilen: sofort nutzbar, braucht eine kleine Korrektur oder unbrauchbar.
| Modell | Blind Schrift (1–5) | Blind Layout (1–5) | Nutzbar / kleine Korrektur / unbrauchbar |
|---|---|---|---|
| GPT Image 2.5 Sunburst | 4.7 | 4.5 | 8 / 2 / 0 |
| Nano Banana 2.1 | 4.5 | 4.5 | 7 / 2 / 1 |
| Grok Imagine 2.0 Medium | 4.6 | 4.7 | 6 / 4 / 0 |
| Grok Imagine 2.0 Low | 4.4 | 4.6 | 6 / 4 / 0 |
| Seedream 5.0 Pro | 4.2 | 4.1 | 4 / 4 / 2 |
Blindtest und Bewertungsschema stimmen beim ersten Platz (GPT Image 2.5) und beim letzten Platz (Seedream 5.0 Pro) überein. Bei der Reihenfolge der mittleren drei weichen sie voneinander ab.
Dieselbe Anfrage an den Designer von FontVibe
FontVibe hat auch einen Designer-Modus: Du beschreibst, was du willst, und er schreibt den Prompt für das Modell. Ich habe die Aufgaben 3 und 4 damit durchlaufen lassen, mit Grok Imagine 2.0 Low und dem Prompt der jeweiligen Aufgabe als Anfrage. Diese Bilder fließen nicht in die Noten ein.
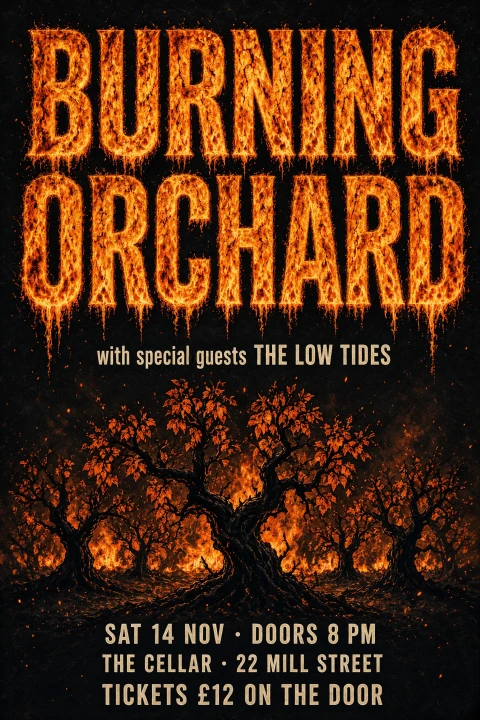
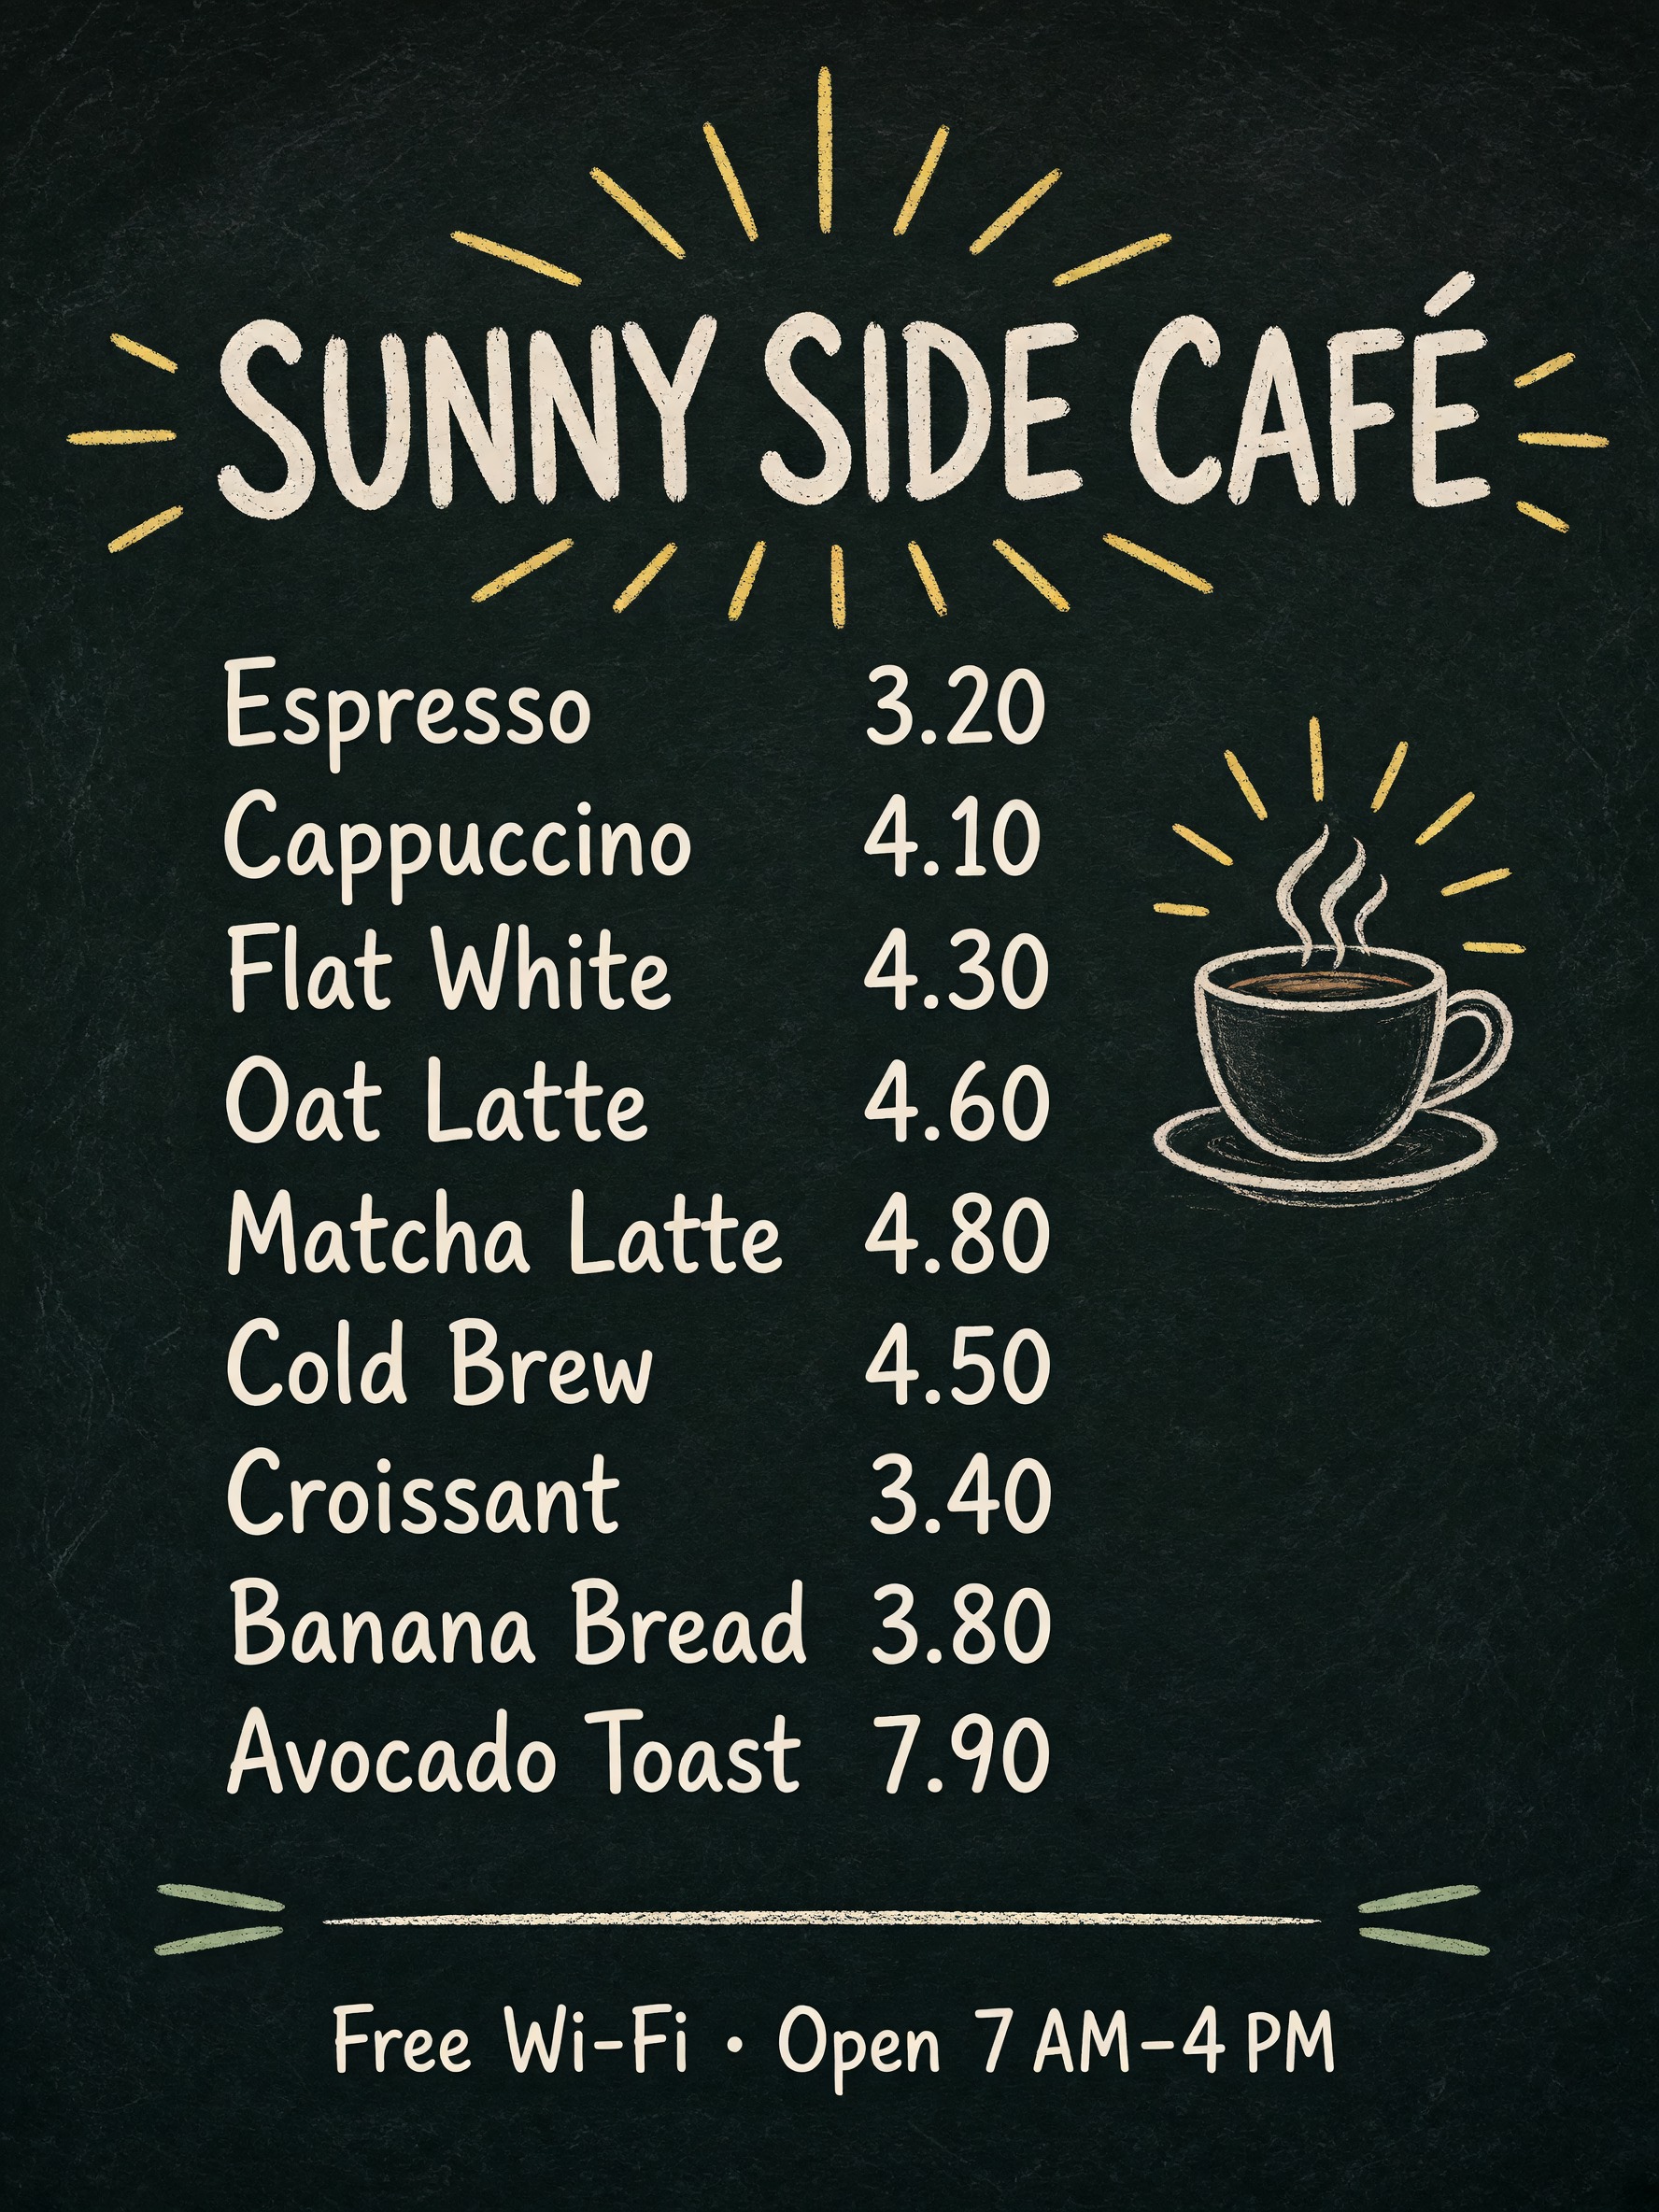
Die Designer-Version des Plakats enthält die Zeile "LIVE HARD. BURN LOUD. NO APOLOGIES." nicht, die Grok Imagine 2.0 Low von sich aus hinzugefügt hat. Layout und Schrift waren nicht besser als bei Groks eigenen Versionen: Der Plakattitel wechselte von stacheliger Feuerschrift im Metal-Plakat-Stil zu einer schlichten schmalen Schrift, und auf der Speisekarte fehlen die Punktlinien zwischen Positionen und Preisen.
Der Designer bekam dieselben vollständigen Prompts wie im Test, in denen Schrift, Szene und jede Textzeile schon festgelegt waren. Der Designer-Modus ist für Anfragen in einem Satz gedacht, etwa "a poster for my band's Saturday show at The Cellar", bei denen er den fehlenden Inhalt und das Design selbst schreibt. Diese Nutzung wurde hier nicht getestet.
Grenzen dieses Tests
- Pro Modell und Aufgabe wurde ein Bild bewertet, und eine Person hat alle 50 bewertet.
- GPT Image 2.5 und Grok Imagine 2.0 Medium liegen 0.06 auseinander, Grok Imagine 2.0 Low und Nano Banana 2.1 liegen 0.04 auseinander. Ändert man eine Note in einer Aufgabe um 2 Punkte, verschiebt sich der Durchschnitt eines Modells um 0.04 bis 0.07, also hängen diese beiden Reihenfolgen an einzelnen Noten.
- GPT Image 2.5 wurde auf der dritten seiner fünf Qualitätsstufen getestet. Grok Imagine 2.0 wurde auf beiden Stufen getestet.
- Die Bilder für Bearbeitung und Referenzen stammen von früheren Seedream-Modellen.
- Die Ergebnisse beschreiben diese Modellversionen am 21. Oktober 2026.
Jedes Bild ist öffentlich auf FontVibe, und jede Note hat einen schriftlichen Grund. Wenn du einen Prompt erneut ausführst und ein deutlich anderes Ergebnis bekommst, schreib an hello@fontvibe.ai, und ich nehme es in diesen Beitrag auf.
Anhang: alle Noten
Lesbarkeit / Schrift / Information und Layout / Wirkung, danach die gewichtete Gesamtnote. Jeweils das erste Bild jeder Konfiguration.
| Aufgabe | Grok Low | Grok Medium | GPT Image 2.5 (High) | Nano Banana 2.1 | Seedream 5.0 Pro |
|---|---|---|---|---|---|
| 1 Einladung | 10/9/8/9 = 8.95 | 10/9/9/9 = 9.20 | 10/9/9/9 = 9.20 | 9/9/8/8 = 8.55 | 10/9/8/8 = 8.75 |
| 2 T-Shirt | 10/7/9/8 = 8.30 | 9/9/9/9 = 9.00 | 7/9/9/9 = 8.60 | 8/9/8/8 = 8.35 | 9/8/9/8 = 8.45 |
| 3 Plakat | 10/9/8/9 = 8.95 | 10/9/9/9 = 9.20 | 9/9/9/9 = 9.00 | 10/8/9/8 = 8.65 | 9/9/7/9 = 8.50 |
| 4 Speisekarte | 10/8/9/8 = 8.65 | 10/8/9/8 = 8.65 | 10/9/9/9 = 9.20 | 10/8/9/8 = 8.65 | 9/8/7/7 = 7.75 |
| 5 Chinesisches Plakat | 10/9/9/8 = 9.00 | 10/9/8/8 = 8.75 | 8/9/9/9 = 8.80 | 10/7/8/8 = 8.05 | 10/9/7/8 = 8.50 |
| 6 Japanisches Plakat | 10/9/9/9 = 9.20 | 10/8/9/9 = 8.85 | 10/9/8/9 = 8.95 | 10/7/9/8 = 8.30 | 10/9/7/7 = 8.30 |
| 7 Logo | 10/7/8/7 = 7.85 | 10/7/8/7 = 7.85 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/8/8/8 = 8.40 |
| 8 Nudelladen | 8/8/8/8 = 8.00 | 10/9/9/9 = 9.20 | 8/9/8/9 = 8.55 | 4/9/8/9 = 7.75 | 4/8/8/8 = 7.20 |
| 9 Bearbeitung | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 |
| 10 Referenzen | 10/6/9/8 = 7.95 | 10/8/9/8 = 8.65 | 10/7/9/9 = 8.50 | 10/9/9/9 = 9.20 | 8/6/8/7 = 7.10 |
Der schriftliche Grund für jede Note ist dokumentiert und auf Anfrage erhältlich.
Häufige Fragen
Ist Grok Imagine gut bei Design mit Text?
In diesem Test erreichte Grok Imagine 2.0 Medium 8.84 von 10, 0.06 unter der höchsten Note, und hat in allen 10 bewerteten Bildern jedes geforderte Wort richtig geschrieben. Seine niedrigste Note war 7.85, bei einem handgeschriebenen Logo. Auf Qualität Low hat es in 2 von 10 Bildern Text hinzugefügt, den der Prompt nicht verlangt hat.
Welches KI-Bildmodell hat bei Design mit Text am besten abgeschnitten?
GPT Image 2.5 Sunburst auf Qualität High erreichte 8.90 von 10, die höchste Note von fünf Konfigurationen über 10 Aufgaben. Grok Imagine 2.0 Medium erreichte 8.84, Grok Imagine 2.0 Low 8.59, Nano Banana 2.1 8.55 und Seedream 5.0 Pro 8.20.
Ist Grok Imagine 2.0 Medium besser als Low?
Grok Imagine 2.0 Medium erreichte in diesem Test 8.84 und Low 8.59. Die mittlere Zeit von Medium lag bei 84 Sekunden pro Bild, die von Low bei 23 Sekunden.
Können diese Modelle Chinesisch und Japanisch schreiben?
Alle vier Modelle haben auf einem Plakat in vereinfachtem Chinesisch und einem japanischen Plakat jedes geforderte Zeichen richtig geschrieben, ohne zusätzliche Zeichen.
Wurde GPT Image 2.5 auf seiner höchsten Qualitätsstufe getestet?
Nein. GPT Image 2.5 Sunburst wurde auf High getestet, der dritten seiner fünf Qualitätsstufen und der Standardstufe auf FontVibe. Extra High und Max wurden nicht getestet.
Kann ich alle vier Modelle an einem Ort ausprobieren?
Alle vier Modelle stehen im Modellmenü auf FontVibe, und derselbe Prompt lässt sich mit jedem ausführen.
Bereit, es selbst auszuprobieren?
Setz diese Prompt-Techniken direkt um — kein Konto nötig, um loszulegen.
✦ Jetzt generierenFontVibe in Google als bevorzugte Quelle festlegen
Setz diese Prompt-Techniken direkt um — kein Konto nötig, um loszulegen.
Jetzt gestalten
Kommentare