Qwen Image 3.0 vs GPT Image, Nano Banana, Seedream y Grok
Di a Qwen Image 3.0 Pro y a cuatro modelos rivales los mismos 10 prompts con mucho texto y califiqué la primera imagen de cada uno. Sin elegir las mejores.
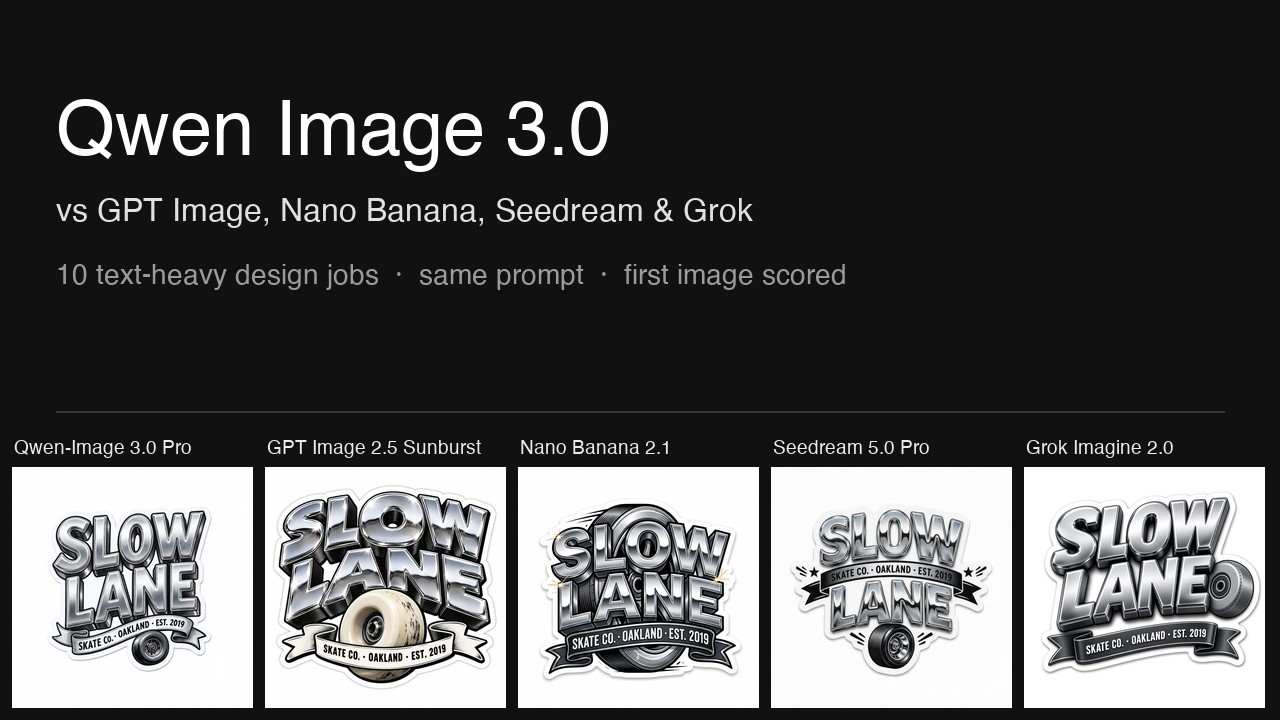
Qwen Image 3.0 Pro es el modelo de imagen de Alibaba. Sus creadores dicen que muestra texto de hasta 10 píxeles, que escribe 12 idiomas de forma nativa y que maneja composiciones con mucha información. Lo probé contra otros cuatro modelos de imagen en 10 encargos de diseño que llevan texto: una invitación, un sticker, un póster, el programa de una conferencia, una etiqueta de té bilingüe, un póster japonés en vertical, un logo, una foto, una edición y un encargo con dos referencias. Cada modelo recibió el mismo prompt, y califiqué la primera imagen que devolvió cada uno.
Las cinco configuraciones, todas a resolución 2K:
- Qwen Image 3.0 Pro (Alibaba). Qwen Image 3.0 Pro tiene dos resoluciones, 1K y 2K, y no tiene ajuste de calidad. Su reescritura de prompt integrada estaba desactivada, así que recibió el prompt sin cambios, igual que los otros cuatro.
- GPT Image 2.5 Sunburst (OpenAI), calidad High. GPT Image 2.5 tiene cinco niveles de calidad: Low, Medium, High, Extra High y Max. Probé High, que es el predeterminado en FontVibe. Extra High y Max no se probaron.
- Nano Banana 2.1 (Google). Nano Banana 2.1 no tiene ajuste de calidad.
- Seedream 5.0 Pro (ByteDance). Seedream 5.0 Pro no tiene ajuste de calidad.
- Grok Imagine 2.0 (xAI), calidad Medium. Medium es el nivel más alto de Grok Imagine 2.0. Mi prueba de Grok Imagine 2.0 comparó sus niveles Low y Medium, y Medium sacó más nota.
Los resultados
| Modelo (ajuste) | Legibilidad | Letras y acabado | Información y composición | Atractivo | Total | Tiempo mediano | Créditos de FontVibe |
|---|---|---|---|---|---|---|---|
| Grok Imagine 2.0 (Medium) | 9.9 | 8.8 | 8.9 | 8.6 | 9.01 | 95 s | 40 |
| GPT Image 2.5 Sunburst (High) | 9.4 | 9.0 | 8.7 | 8.9 | 8.99 | 41 s | 40 |
| Nano Banana 2.1 | 9.7 | 8.8 | 8.3 | 8.3 | 8.76 | 28 s | 25 |
| Seedream 5.0 Pro | 10.0 | 8.7 | 8.0 | 8.5 | 8.75 | 73 s | 40 |
| Qwen Image 3.0 Pro | 10.0 | 8.8 | 7.7 | 7.8 | 8.57 | 23 s | 40 |
Las puntuaciones son sobre 10 y son el promedio de la primera imagen de cada uno de los 10 encargos. El tiempo mediano cubre las imágenes nuevas de los encargos 1 a 8 y 10, dos por encargo, a 2K: 18 por modelo, y 17 en el caso de Seedream 5.0 Pro por los fallos descritos en el encargo 10. Los créditos son lo que cuesta una imagen 2K en FontVibe. Cada puntuación individual está en el apéndice. En una pasada a ciegas aparte, con los nombres de los modelos ocultos, Qwen Image 3.0 Pro también quedó último y GPT Image 2.5 quedó primero.
Grok Imagine 2.0 Medium sacó la puntuación más alta, 9.01 sobre 10. GPT Image 2.5 Sunburst sacó 8.99, 0.02 menos. Nano Banana 2.1 sacó 8.76 y Seedream 5.0 Pro 8.75, a 0.01 de distancia. Qwen Image 3.0 Pro sacó la puntuación más baja, 8.57, 0.18 por debajo de Seedream 5.0 Pro. Los cinco promedios están a 0.44 puntos o menos entre sí. Cambiar una nota en 1 punto en un encargo mueve el promedio de un modelo entre 0.02 y 0.035, así que el orden de los dos primeros, y el orden del tercero y el cuarto, dependen cada uno de notas sueltas.
Qwen Image 3.0 Pro y Seedream 5.0 Pro tuvieron la nota de legibilidad más alta, 10.0: la línea principal de cada una de sus imágenes calificadas se lee de un vistazo. Qwen Image 3.0 Pro tuvo la nota más baja en información y composición, 7.7, y la nota más baja en atractivo, 7.8. Tres de sus 10 imágenes calificadas cambiaron o escribieron mal una línea pedida, en el encargo 5 dibujó una lata de té en lugar de la etiqueta que pedía el prompt, y su programa es la composición más sencilla de ese encargo. No sacó la nota más alta en ningún encargo.
GPT Image 2.5 se probó en High, el tercero de sus cinco niveles de calidad. Los otros cuatro modelos se probaron en su nivel más alto. Esta prueba no muestra qué puntuación sacarían GPT Image 2.5 Extra High o Max.
Precisión del texto
De las 50 imágenes calificadas, 47 tienen todas las líneas pedidas bien escritas. Las tres que no son todas de Qwen Image 3.0 Pro:
- Encargo 1: "Mia's" se convirtió en "MiA'S", con mayúsculas en medio del nombre.
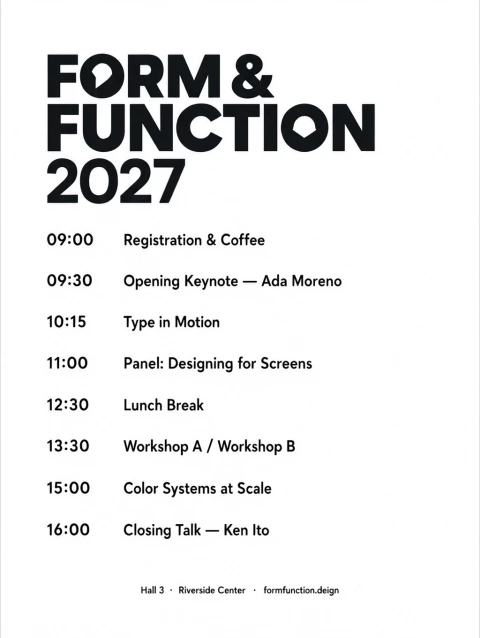
- Encargo 4: la URL del pie, "formfunction.design", se convirtió en "formfunction.deign".
- Encargo 9: la edición tenía que dejar "18+" sin cambios, y se convirtió en "$Z+".
Problemas menores en las imágenes calificadas de los otros modelos:
- GPT Image 2.5, encargo 8: añadió una pizarra con cinco platos que el prompt no pedía, y una línea de esa pizarra tiene letras deformadas e ilegibles. El "·" de la pizarra de menú pedida se convirtió en una línea ondulada.
- Nano Banana 2.1, encargo 8: el "·" de la pizarra de menú está fuera de lugar.
- Líneas que el prompt no pedía: Seedream 5.0 Pro añadió "ONE-DAY DESIGN CONFERENCE" en el encargo 4; Nano Banana 2.1 añadió "WEEKEND ART EVENT" en el encargo 10; Grok Imagine 2.0 repitió "OPEN STUDIO" en el encargo 10; Qwen Image 3.0 Pro copió "NEON OUTLINE" de una imagen de referencia en el encargo 10.
- GPT Image 2.5 y Nano Banana 2.1 añadieron cada uno un sello rojo con caracteres a la etiqueta de té del encargo 5, que no pedía ningún otro texto.
Las tres afirmaciones de Qwen Image 3.0, comprobadas
Afirmación 1: texto de hasta 10 píxeles. Se cumple en parte. El encargo 4 pedía 10 líneas de texto de programa. Las 10 líneas de la imagen de Qwen Image 3.0 Pro son nítidas y legibles, y su nota de legibilidad fue 10. Pero a la URL del pie le faltó una letra ("formfunction.deign"), y el mismo error apareció en 3 de las 4 imágenes de programa de Qwen (las dos imágenes 1K y la primera imagen 2K). Los otros cuatro modelos escribieron bien la URL en sus 8 imágenes de programa.
Afirmación 2: 12 idiomas de forma nativa. Se cumple en los dos idiomas probados. En el encargo 5, Qwen Image 3.0 Pro escribió bien las cuatro líneas en chino y en inglés, en chino simplificado, incluido el 〇 de "二〇二七年春". En el encargo 6, compuso las tres líneas en japonés en vertical y sin errores. Los otros 10 idiomas no se probaron.
Afirmación 3: composiciones con mucha información. Esta prueba no la respalda. El programa de Qwen Image 3.0 Pro en el encargo 4 sacó 7.4, la nota más baja de ese encargo: texto negro sobre una página blanca, sin agrupar y con una gran zona vacía abajo. Su nota media en información y composición, 7.7, fue la más baja de los cinco modelos.
Cómo hice la prueba
Los 10 encargos. Los encargos 1 y 3 usan los mismos prompts que mi prueba de Grok Imagine 2.0 y mi prueba anterior de siete herramientas de diseño con IA. Los otros ocho prompts son nuevos.
- Invitación de cumpleaños infantil (3:4): letras de globo brillantes, tres líneas de datos
- Sticker para una tienda de skate (1:1): letras 3D cromadas y gruesas, una línea en una cinta, aislado sobre blanco
- Póster de concierto (2:3): letras de fuego fundido, cuatro líneas de datos
- Programa de una conferencia (3:4): 8 franjas horarias, una raya (em dash), una barra y una URL
- Etiqueta para una lata de té (3:4): caligrafía china a pincel con una línea en inglés
- Póster japonés de librería (2:3): todas las líneas en vertical
- Insignia de una marca outdoor (1:1): un monograma "FW" y el nombre completo en versalitas
- Foto de un food truck (3:2): letras pintadas en el camión y una pizarra de menú
- Editar una imagen existente (2:3): cambiar una fecha y un precio, dejar todo lo demás igual
- Dos imágenes de referencia (3:4): la composición de la imagen 1, las letras de la imagen 2
La prueba cubre imágenes de diseño con texto. No se probaron retratos, paisajes ni otras imágenes sin texto. El prompt completo de cada encargo aparece en su sección más abajo. Las reglas:
- Cada modelo recibió el mismo prompt, palabra por palabra, a través del modo DIY de FontVibe, que envía el prompt al modelo sin cambios. Sin reescritura del prompt y sin estilos preestablecidos.
- La relación de aspecto se fijó como parámetro, la misma para todos los modelos.
- Cada configuración hizo dos imágenes por encargo. Solo la primera se califica y se muestra. La segunda imagen se usó solo para comprobar que la ortografía se mantenía. Cuando la primera imagen falló, se reintentó una vez, y la que se califica es la primera imagen que salió bien.
- Todas las imágenes se generaron el 21 de octubre de 2026 y son públicas en FontVibe.
La rúbrica de puntuación
La rúbrica es el estándar interno de FontVibe para calificar diseños generados, escrita en octubre de 2026, antes de esta prueba. Es la misma rúbrica que usé en la prueba de Grok Imagine 2.0. Cada imagen recibe cuatro notas del 1 al 10, y anoté el motivo de cada descuento antes de poner el número.
| Qué califiqué | Peso | Qué miré |
|---|---|---|
| Legibilidad | 20% | Primero, una revisión de errores graves: letras deformadas, texto cortado, texto tapado por otros elementos, formas de letra rotas. Sin errores graves, la nota va de 7 a 10 según lo fácil que se lea la línea principal. Con cualquier error grave, va de 1 a 4. |
| Letras y acabado | 35% | Si la imagen tiene el efecto de letra que pedía el prompt (globos, cromo, fuego, pincel, neón) y qué tan bien está hecho. |
| Información y composición | 25% | Primero, si la imagen es lo que pedía el prompt y si la información está completa y es correcta: cada línea del prompt está presente, escrita y puntuada como se pidió, y no se añade nada que el prompt no pidiera. Cada línea o signo que falta, cambia o sobra cuesta al menos 1 punto. Segundo, si la línea más importante se lee primero y las líneas van en el orden correcto. |
| Atractivo | 20% | Si la imagen parece hecha por un diseñador profesional. |
El total se calcula, no se decide a ojo: 0.20 × legibilidad + 0.35 × letras + 0.25 × información y composición + 0.20 × atractivo.
Cuatro precisiones sobre cómo se aplicó la rúbrica. La legibilidad se juzga sobre la línea principal, como dice la rúbrica; las líneas secundarias demasiado pequeñas o pálidas para leerse con facilidad se calificaron en información y composición. Un tratamiento coherente en mayúsculas, como "WITH SPECIAL GUESTS", no se contó como cambio, pero sí las mayúsculas puestas al azar dentro de una palabra, como en "MiA'S". Las letras deformadas en un cartel o una pizarra lo bastante grandes como para que alguien intente leerlos contaron como error grave, igual que en la prueba de Grok Imagine 2.0; las etiquetas diminutas del fondo que no se pueden leer a la resolución de la propia imagen, no. Cuando el prompt pedía un archivo de diseño, como una etiqueta o un programa impreso, y la imagen lo mostraba como un objeto fotografiado, información y composición perdió 3 puntos, porque el resultado no se puede mandar a imprenta tal cual.
Al calificar, yo sabía qué modelo había hecho cada imagen. Para comprobar si había sesgo, también hice una pasada a ciegas con los nombres de los modelos ocultos.
Los encargos 9 y 10 parten de imágenes existentes. Las tres se tomaron de la galería pública de FontVibe, y ninguna la hizo alguno de los cinco modelos de la prueba. Las tres las hizo Seedream 5.0, el modelo anterior de la misma familia que Seedream 5.0 Pro.
Encargo por encargo
Encargo 1: Invitación de cumpleaños infantil
Birthday party invitation for my daughter, "Mia's 7th Birthday" in glossy balloon letters, "Saturday, Nov 14 · 2 PM", "Sunny Park Pavilion", "RSVP by Nov 7", bright and playful, portrait card
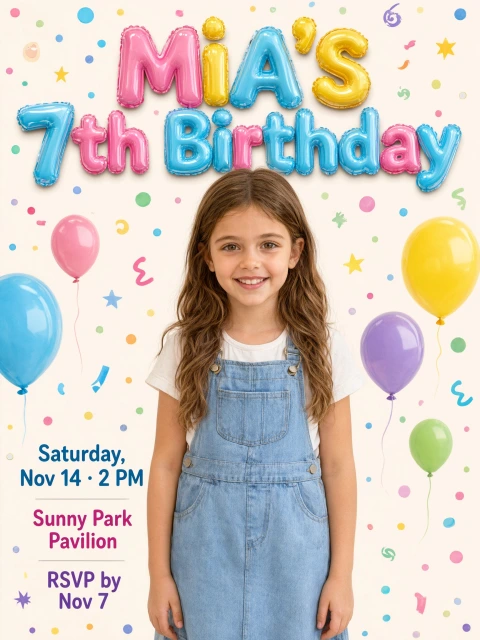
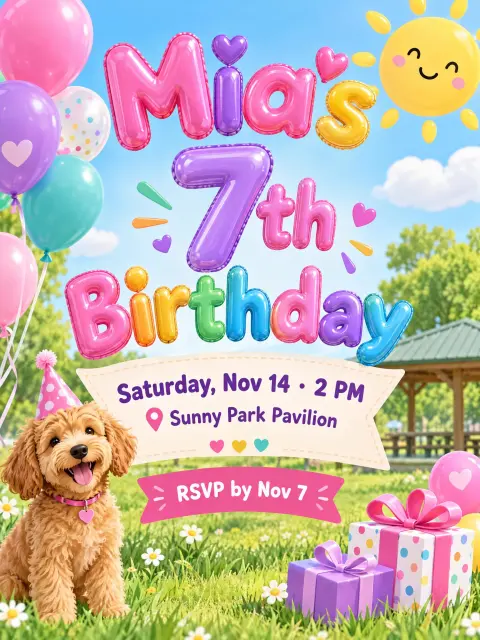
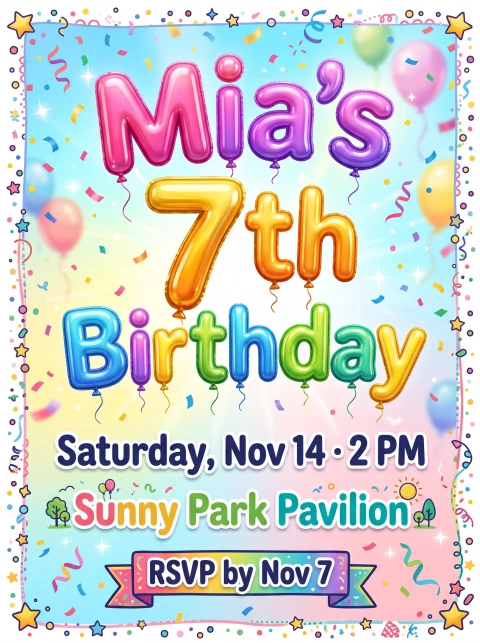
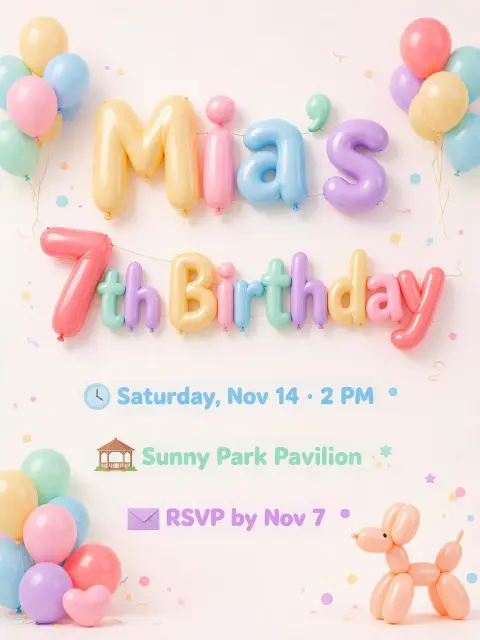
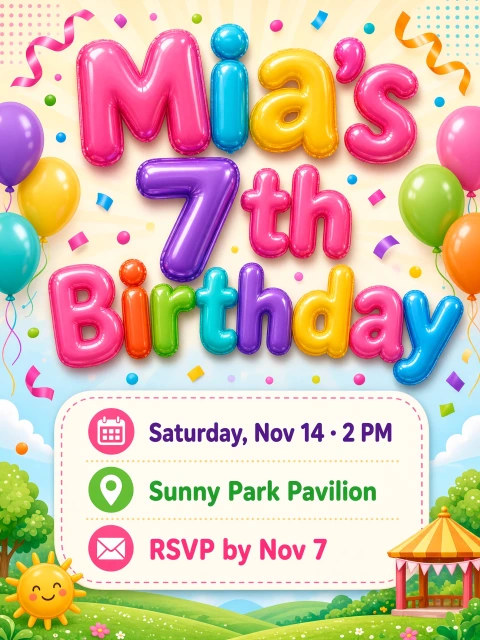
GPT Image 2.5 y Grok Imagine 2.0 empataron en la puntuación más alta, 9.2. Los dos agruparon con claridad las tres líneas de datos, GPT Image 2.5 en una cinta y Grok en una tarjeta con iconos. Qwen Image 3.0 Pro sacó la nota más baja, 8.3: escribió el nombre como "MiA'S", y una foto de una niña ocupa el centro de la tarjeta, lo que deja las tres líneas de datos en una columna estrecha a la izquierda. Seedream 5.0 Pro puso las tres líneas de datos en texto pálido sobre un fondo pálido, lo que le costó un punto en información y composición. Para letras de globo como estilo preestablecido, mira el estilo de letras burbuja.
Encargo 2: Sticker para una tienda de skate
Die-cut sticker for my skate shop, "SLOW LANE" in chunky chrome 3D lettering, small "SKATE CO. · OAKLAND · EST. 2019" on a ribbon banner underneath, a skateboard wheel graphic, thick white sticker border, isolated on plain white
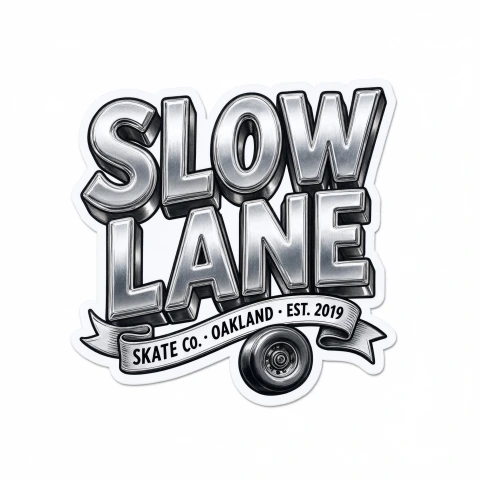
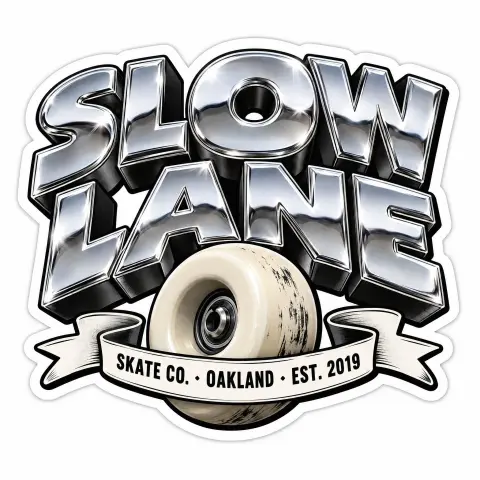
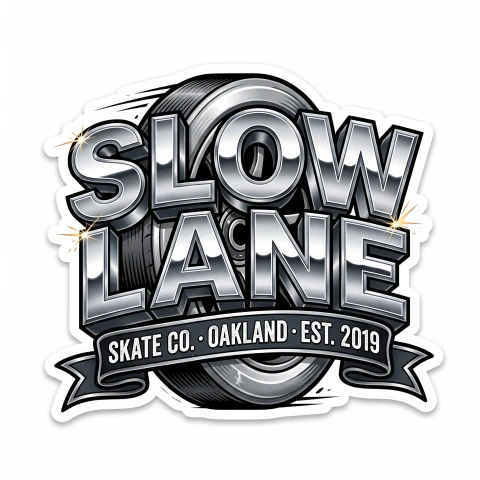
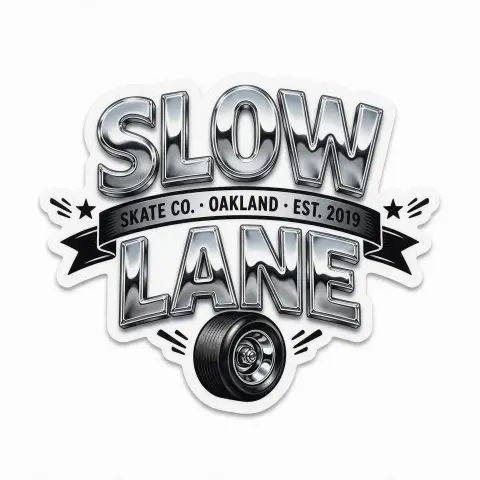
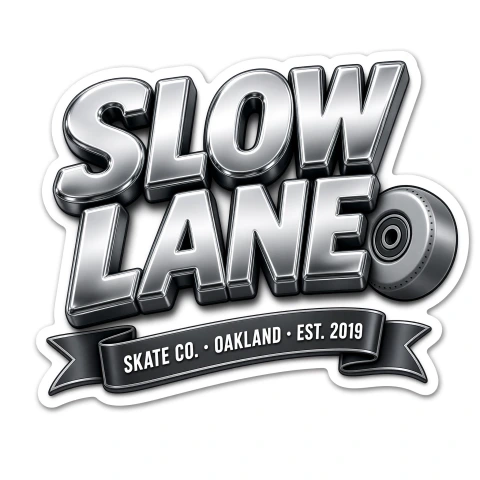
Los cinco modelos escribieron bien las dos líneas. GPT Image 2.5 y Nano Banana 2.1 empataron en la puntuación más alta, 9.2: las letras cromadas de GPT Image 2.5 tienen la mayor profundidad, y Nano Banana 2.1 puso una rueda grande detrás de las letras. Qwen Image 3.0 Pro y Grok Imagine 2.0 sacaron los dos 9.0. Seedream 5.0 Pro sacó la nota más baja, 8.15, porque puso la cinta entre "SLOW" y "LANE" en lugar de debajo. Para letras cromadas como estilo preestablecido, mira el estilo de texto metálico.
Encargo 3: Póster de concierto
A3 gig poster for my band "BURNING ORCHARD", band name in molten fire lettering as the main focus, "with special guests THE LOW TIDES", "SAT 14 NOV · DOORS 8 PM", "THE CELLAR · 22 MILL STREET", "TICKETS £12 ON THE DOOR", gritty rock atmosphere with burning trees
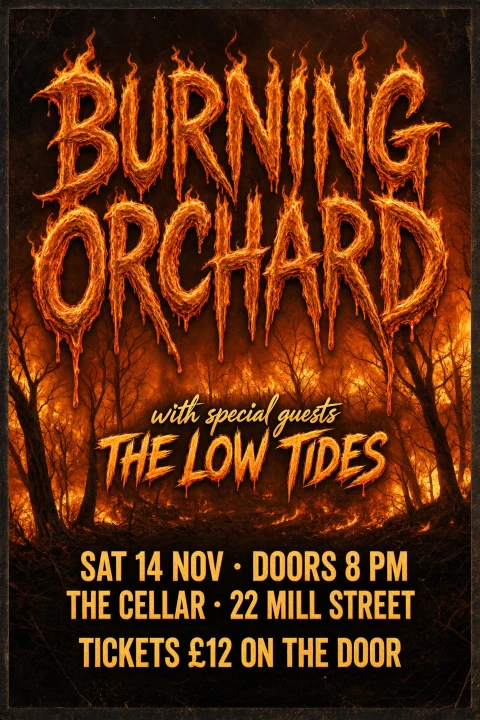
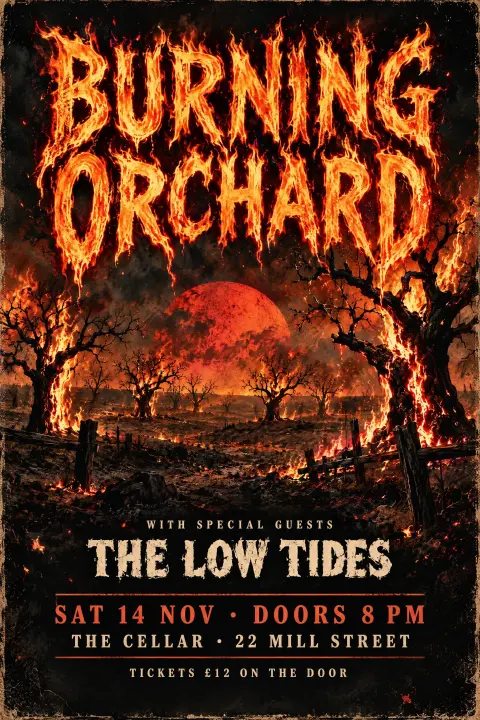
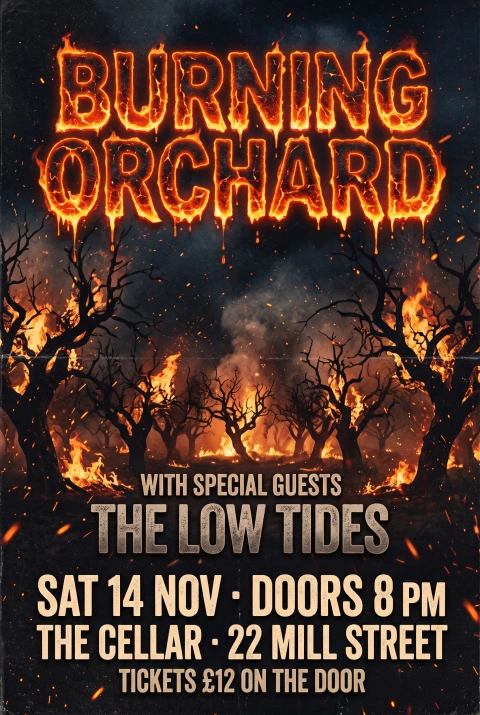
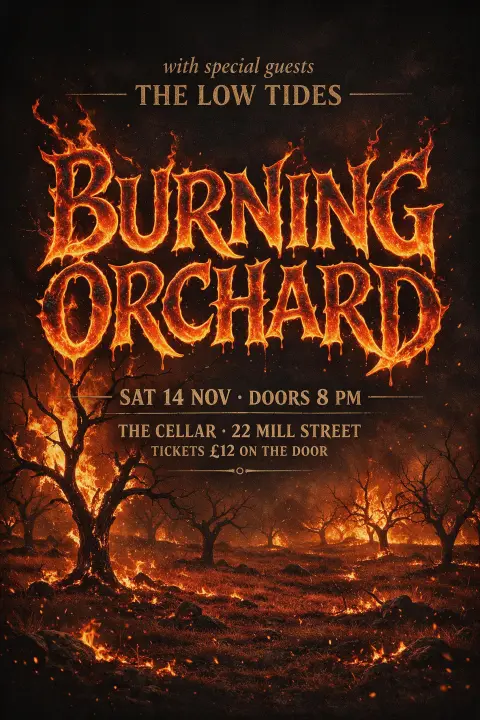
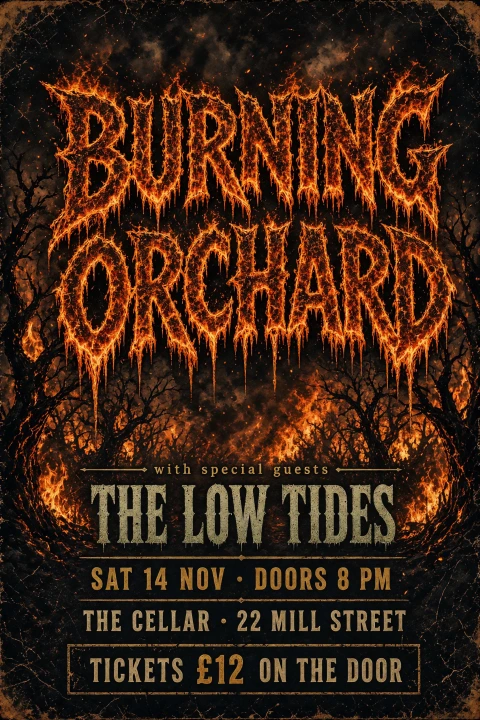
GPT Image 2.5 sacó la nota más alta, 9.2: legibilidad 10 y 9 en cada una de las otras tres notas, con una luna rojo sangre sobre el huerto en llamas. Qwen Image 3.0 Pro, Nano Banana 2.1 y Grok Imagine 2.0 sacaron 9.0; Qwen y Nano Banana 2.1 sacaron 8 en atractivo, y Grok sacó 9 en legibilidad. Qwen puso a la banda invitada en una letra manuscrita que la separa de la principal. La textura de fuego de Grok es la más cargada de las cinco, así que su título hay que mirarlo dos veces. Seedream 5.0 Pro sacó 8.5 porque puso a la banda invitada encima de la principal, el mismo error de orden del cartel que cometió con este prompt en la prueba de Grok Imagine 2.0. Para letras de fuego como estilo preestablecido, mira el estilo de texto de fuego.
Encargo 4: Programa de una conferencia
Printed schedule for a one-day design conference, title "FORM & FUNCTION 2027" in bold geometric lettering, then this exact list, one line each: "09:00 Registration & Coffee", "09:30 Opening Keynote — Ada Moreno", "10:15 Type in Motion", "11:00 Panel: Designing for Screens", "12:30 Lunch Break", "13:30 Workshop A / Workshop B", "15:00 Color Systems at Scale", "16:00 Closing Talk — Ken Ito", and a small footer "Hall 3 · Riverside Center · formfunction.design"
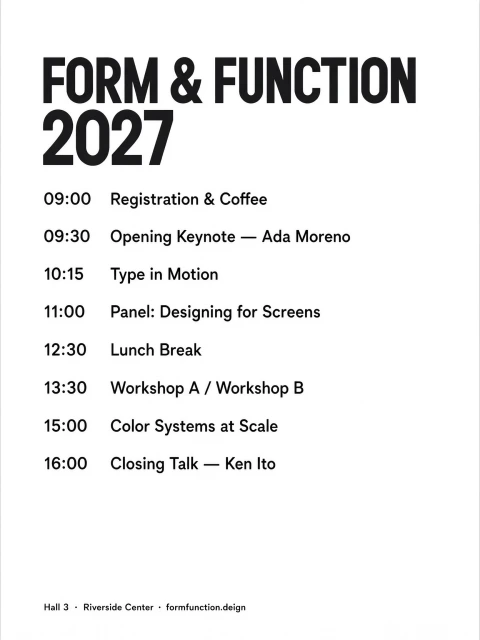
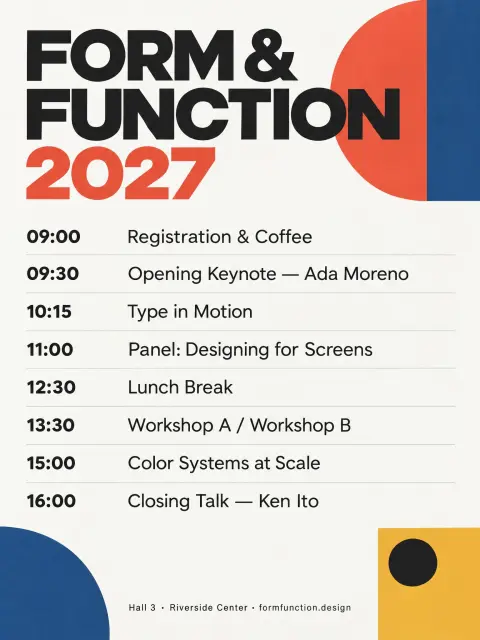
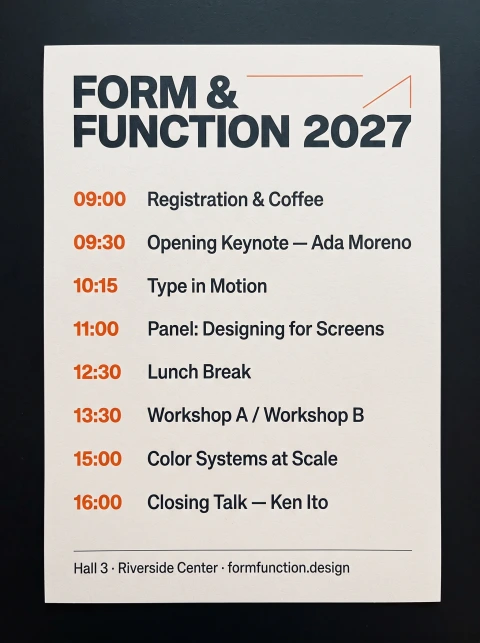
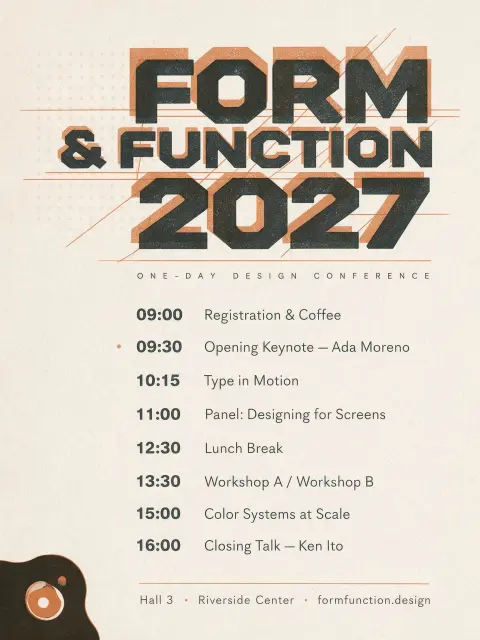
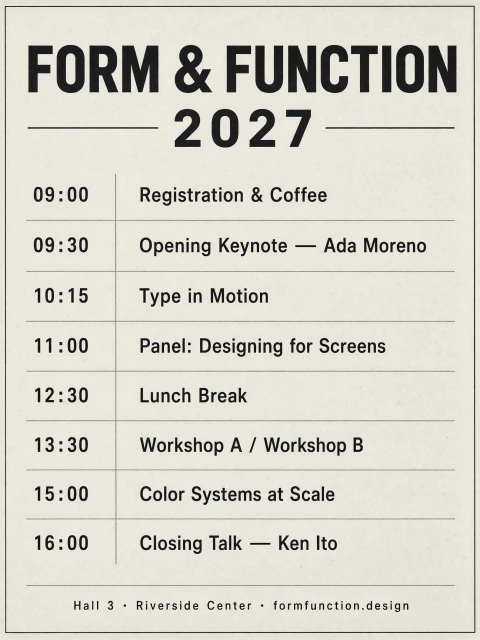
GPT Image 2.5 sacó la nota más alta, 9.2, con un título de estilo Bauhaus, bloques de color y una línea entre cada franja horaria. Los cinco modelos escribieron bien las 8 franjas horarias, las rayas y la barra en sus imágenes calificadas. Nano Banana 2.1 tiene el texto más grande y claro, pero entregó una foto de una tarjeta impresa sobre una mesa oscura en lugar del programa en sí, y sacó 7.9. Qwen Image 3.0 Pro y Grok Imagine 2.0 pusieron el título en una sans serif condensada en lugar de las letras geométricas que pedía el prompt; Grok sacó 8.3. Qwen Image 3.0 Pro además escribió la URL del pie como "formfunction.deign" y sacó 7.4, la nota más baja de este encargo: su página es texto negro sobre blanco, sin agrupar y con una gran zona vacía abajo. Seedream 5.0 Pro añadió un subtítulo, "ONE-DAY DESIGN CONFERENCE", que el prompt no tenía. En la segunda imagen de GPT Image 2.5, que no se calificó, falta la línea "Panel: Designing for Screens" y solo queda "11:00".
Encargo 5: Etiqueta para una lata de té
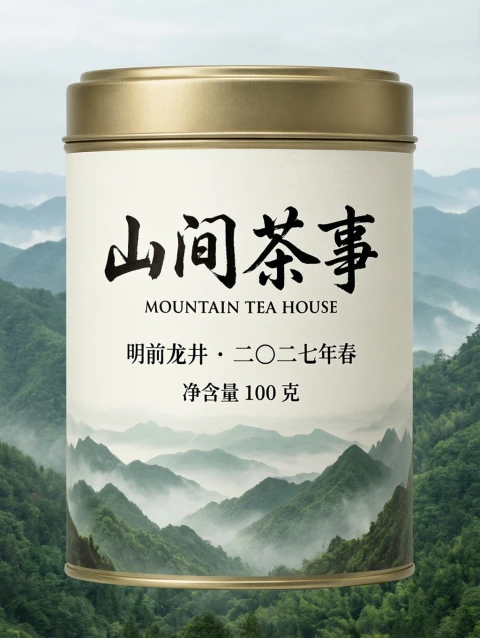
Front label for a tea tin, brand name "山间茶事" in elegant brush-and-ink calligraphy, English line "MOUNTAIN TEA HOUSE", product line "明前龙井 · 二〇二七年春", net weight "净含量 100 克", misty green mountains, no other text
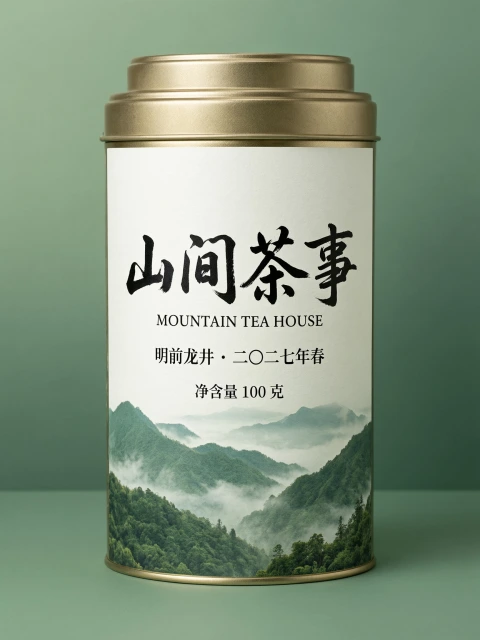
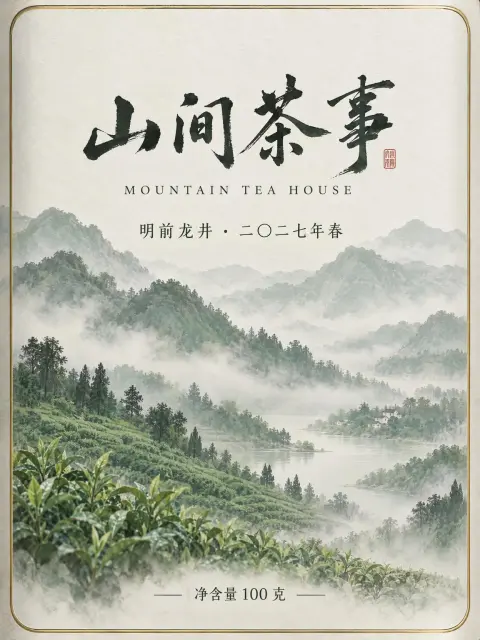
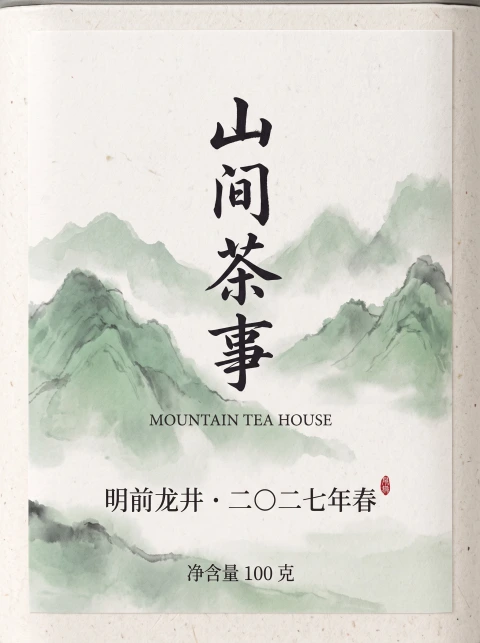
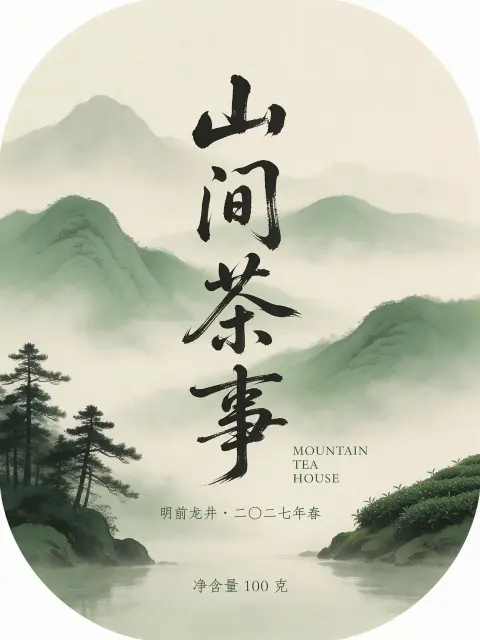
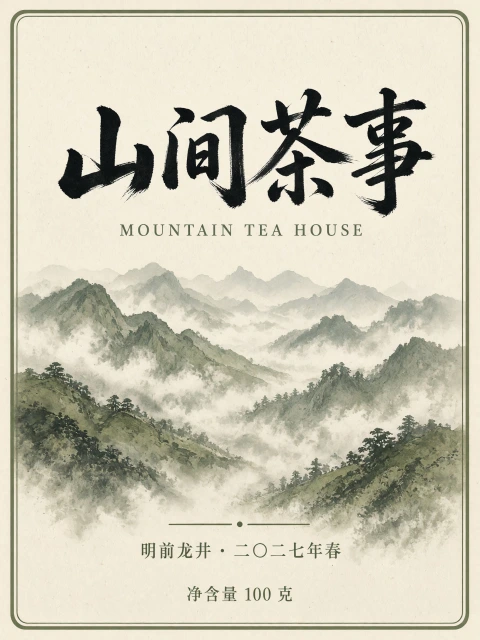
Los cinco modelos escribieron bien las cuatro líneas en chino simplificado, incluidos 龙 (no el tradicional 龍) y 〇. El prompt pedía la etiqueta, y cuatro modelos entregaron una etiqueta plana. Qwen Image 3.0 Pro dibujó una foto de una lata de té entera con la etiqueta puesta, que no se puede imprimir como etiqueta, y sacó 8.45, la nota más baja de este encargo. Grok Imagine 2.0 sacó la nota más alta, 9.2: una etiqueta plana con cada línea en su sitio y nada añadido. GPT Image 2.5 y Nano Banana 2.1 añadieron cada uno un pequeño sello rojo con caracteres, algo que el "no other text" del prompt descarta, y los dos sacaron 8.95. Para caligrafía a pincel como estilo preestablecido, mira el estilo de tinta china a pincel.
Encargo 6: Póster japonés de librería
Poster for a bookstore's autumn reading week, headline "秋の読書週間" set vertically in elegant Mincho lettering, sub-line "十月二十七日〜十一月九日", and "全品ポイント二倍", warm maple leaves, all Japanese text written vertically, no other text
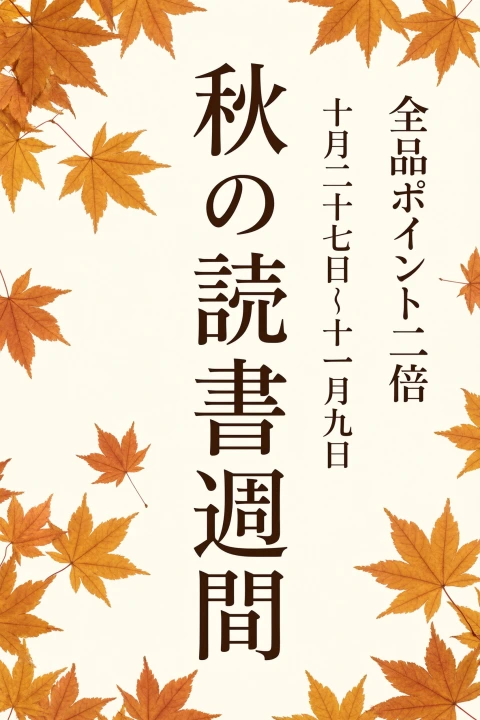
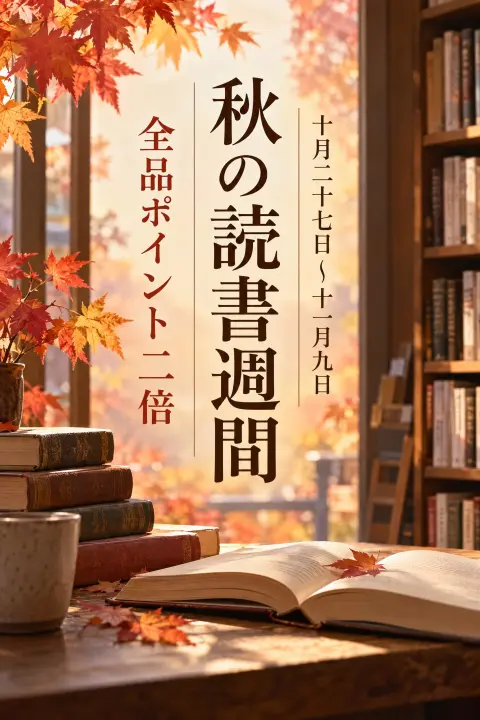
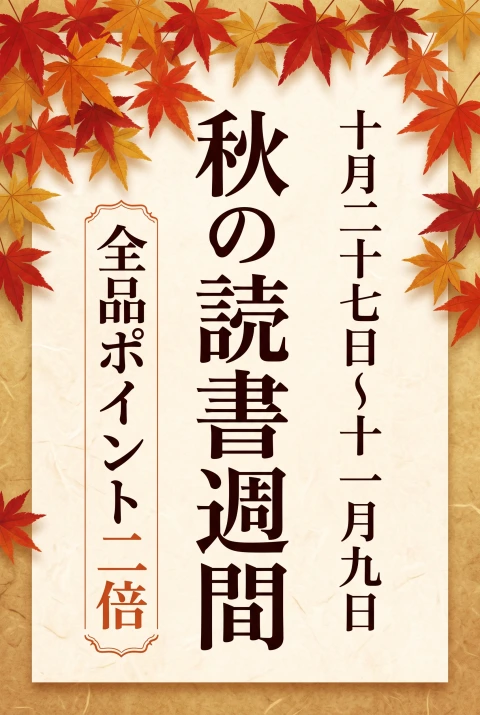
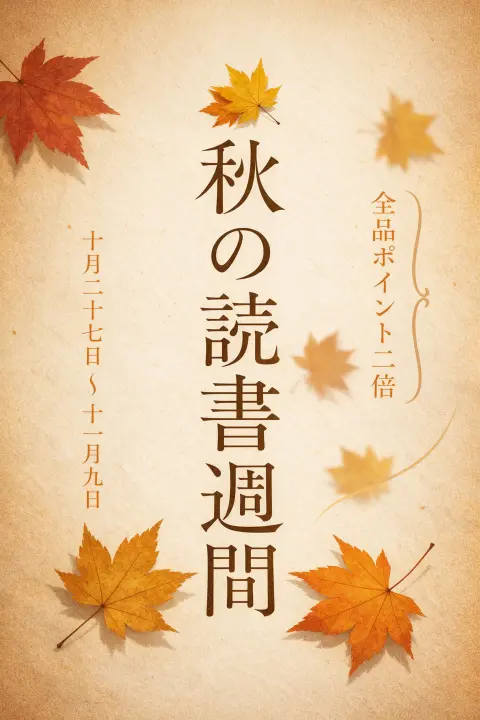

Los cinco modelos compusieron las tres líneas en vertical y las escribieron bien, y los cinco usaron las letras Mincho que pedía el prompt. GPT Image 2.5 sacó la nota más alta, 9.2, con una escena de librería y la oferta de puntos en un banner rojo vertical. Qwen Image 3.0 Pro, Nano Banana 2.1 y Grok Imagine 2.0 sacaron 9.0. Seedream 5.0 Pro sacó 8.95: su columna de fechas es pálida y fina.
Encargo 7: Insignia de una marca outdoor
Badge logo for a hiking outfitter called "Fernwood Outfitters", an interlocking "FW" monogram with a fern leaf in the center, the full name in clean small caps around the badge, flat vector look, two colors, on plain white, no other text
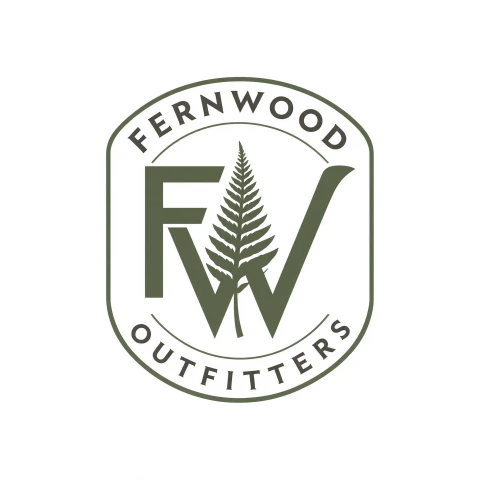
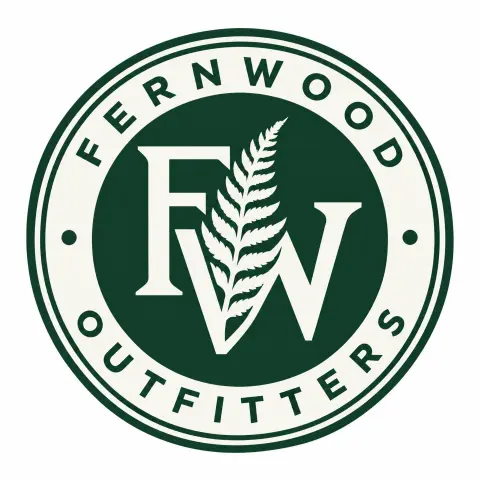
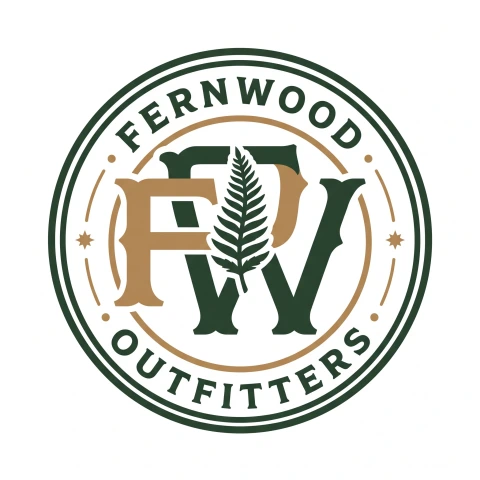
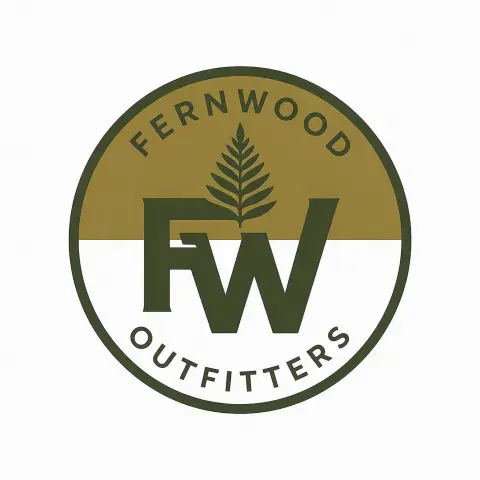
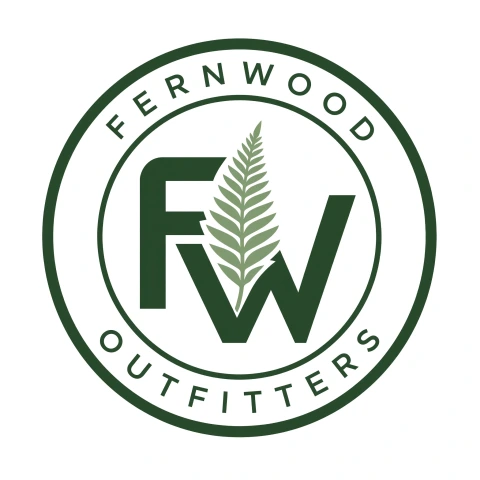
GPT Image 2.5 y Grok Imagine 2.0 empataron en la puntuación más alta, 9.2. Qwen Image 3.0 Pro sacó 9.0 con un helecho que crece a través del monograma. Nano Banana 2.1 sacó la nota más baja, 8.05: su monograma tiene un óvalo de más que hace que a primera vista se lea como "FPW". Seedream 5.0 Pro sacó 8.3: su F y su W están una al lado de la otra en lugar de entrelazadas, y el helecho está encima de las letras en lugar de en el centro. En la segunda imagen de Qwen, que no se calificó, el nombre completo aparece dos veces alrededor de la insignia.
Encargo 8: Foto de un food truck
Realistic photo of a vintage food truck parked by the beach at noon, hand-painted lettering on its side reads "SALT & LIME TACOS", a menu board next to it reads "3 TACOS $9 · HORCHATA $4", bright sunlight, shot on a 50mm lens
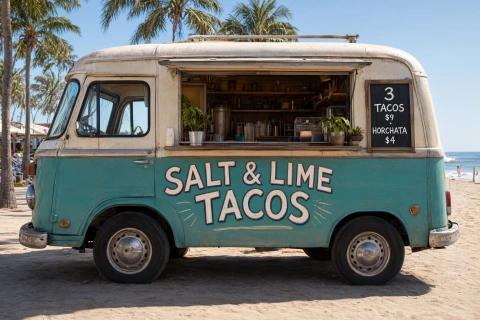
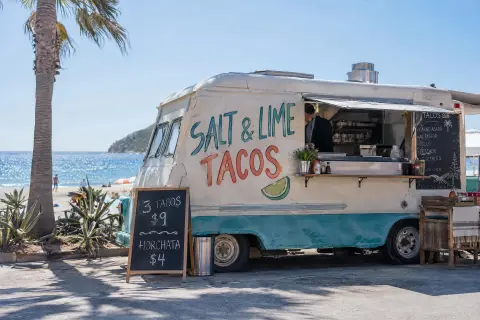
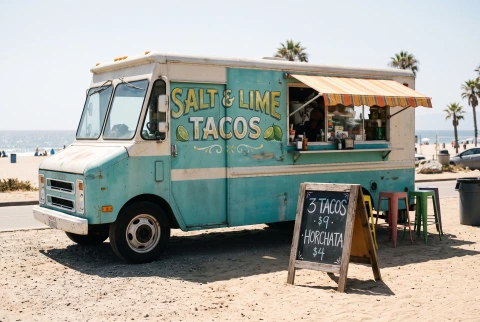
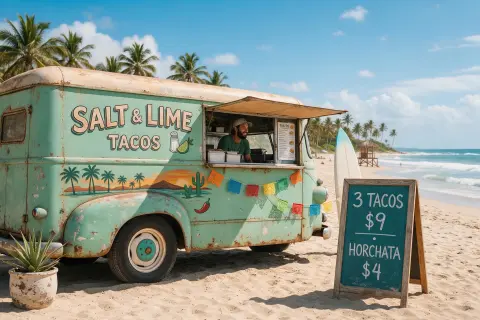
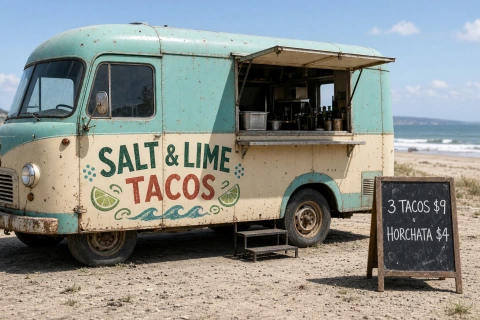
Los cinco modelos escribieron bien las dos líneas pedidas. Seedream 5.0 Pro y Grok Imagine 2.0 empataron en la puntuación más alta, 9.2, con la pizarra de menú de pie junto al camión, como pedía el prompt. GPT Image 2.5 sacó la nota más baja, 7.5: junto a la ventanilla añadió una segunda pizarra con cinco platos, y una línea de esa pizarra tiene letras deformadas, que son un error grave según la rúbrica, así que su nota de legibilidad es 4. También dibujó el "·" de la pizarra de menú pedida como una línea ondulada. Qwen Image 3.0 Pro colgó la pizarra de menú en el camión en lugar de ponerla al lado y sacó 8.75.
Encargo 9: Editar una imagen existente
Change the date to "FRIDAY • NOVEMBER 13 • 2026" and the price to "$20", and keep everything else exactly as it is
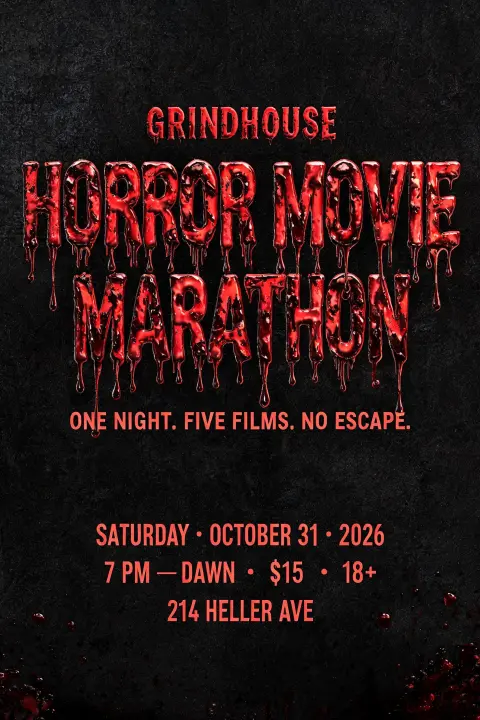
El póster original tiene seis líneas de texto. El prompt pedía cambiar dos: la fecha y el precio. Las otras cuatro líneas y el "18+" tenían que quedar igual.
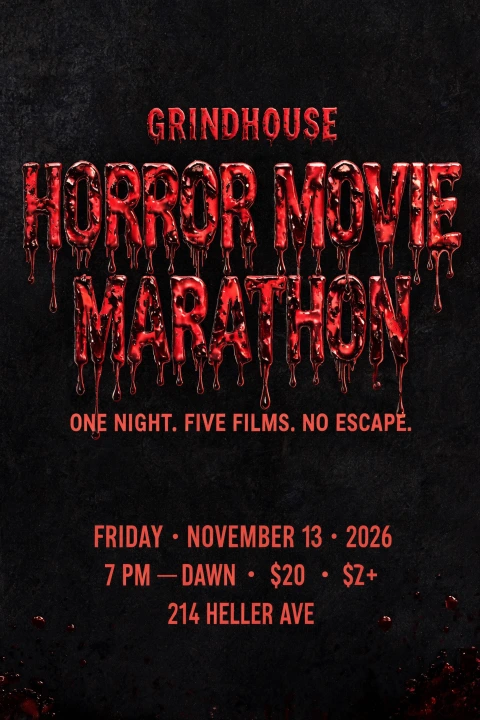
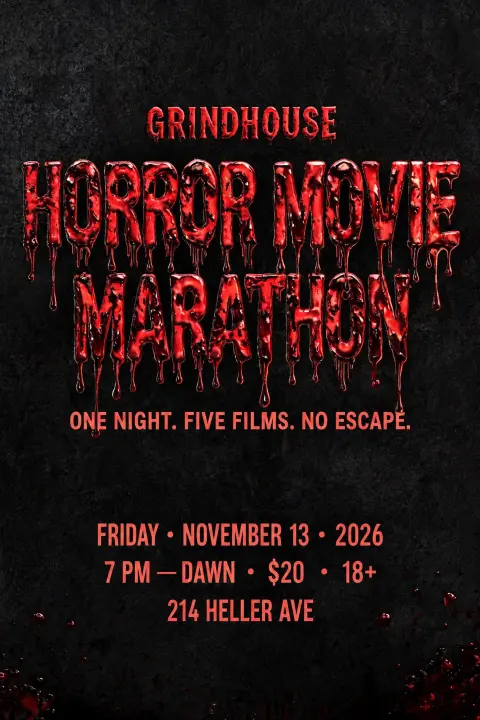
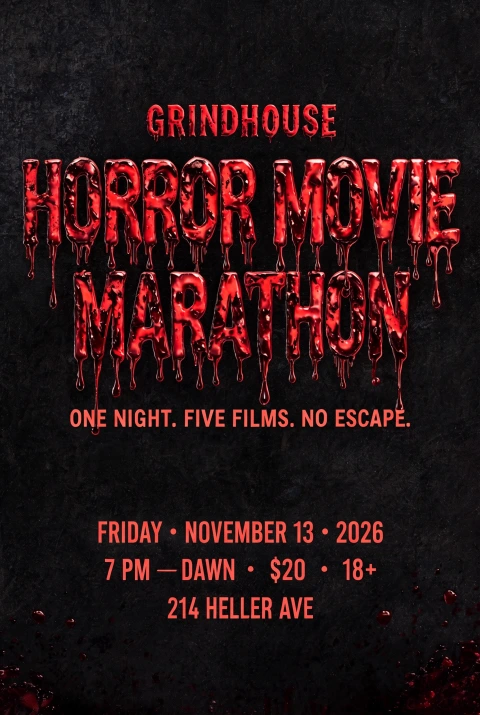
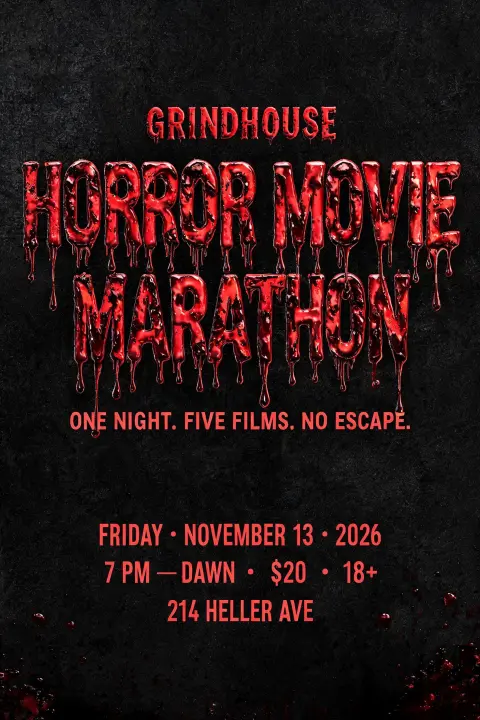
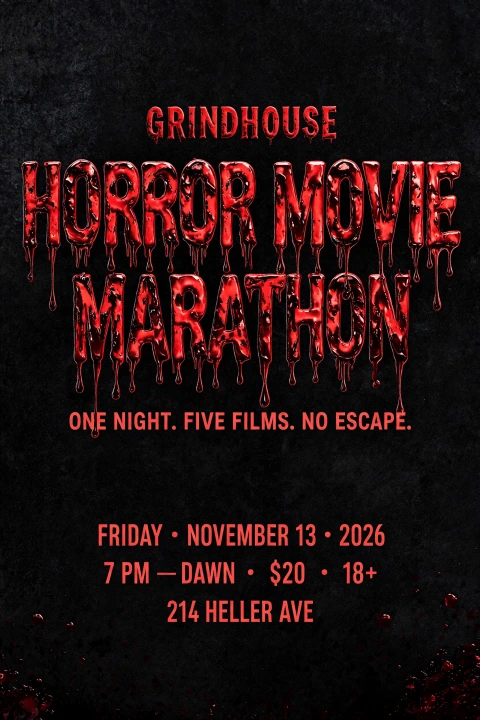
Cuatro modelos cambiaron bien la fecha y el precio y dejaron todo lo demás sin cambios, y los cuatro sacaron 9.0. Qwen Image 3.0 Pro cambió bien la fecha y el precio, pero también cambió "18+" por "$Z+", y sacó 8.5. Su segunda imagen mantuvo bien el "18+".
La rúbrica no mide si el resto de la imagen se mantuvo igual, así que lo medí aparte, como en la prueba de Grok. Redimensioné cada resultado y el original a 800 × 1200, los pasé a escala de grises y calculé la diferencia absoluta media de píxeles (0 a 255) fuera de las dos líneas que debían cambiar. Menos significa más cerca del original.
| Modelo | Diferencia con el original |
|---|---|
| Seedream 5.0 Pro | 2.6 |
| GPT Image 2.5 Sunburst | 5.7 |
| Nano Banana 2.1 | 8.2 |
| Grok Imagine 2.0 Medium | 10.0 |
| Qwen Image 3.0 Pro | 12.2 |
El original mide 1664 × 2496 píxeles. Todos los modelos devolvieron ese tamaño excepto Nano Banana 2.1, que devolvió 1696 × 2528, así que parte de su diferencia viene del redimensionado. Seedream 5.0 Pro también fue el más cercano al original en el encargo de edición de la prueba de Grok. Su tiempo mediano de edición aquí fue de 118 segundos, frente a 23 a 55 segundos de los otros cuatro.
Encargo 10: Dos imágenes de referencia
Portrait poster that says "OPEN STUDIO" with a small line "Sat & Sun · 11 AM–6 PM". Use the layout of reference image 1 and the lettering style of reference image 2.


La imagen de referencia 1 es un póster de galería pop art: una franja azul arriba, un título enorme en dos líneas sobre un fondo rojo de semitono y una fecha abajo. La imagen de referencia 2 es un logotipo de neón azul de contorno fino sobre un fondo estrellado. El resultado correcto es la composición de la referencia 1 con las letras de neón de la referencia 2.
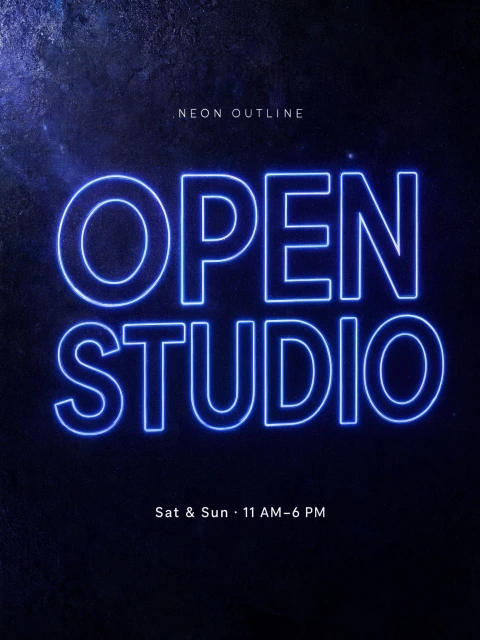
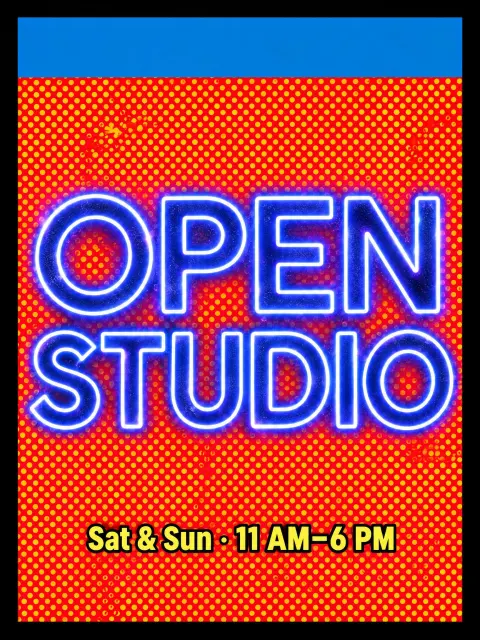
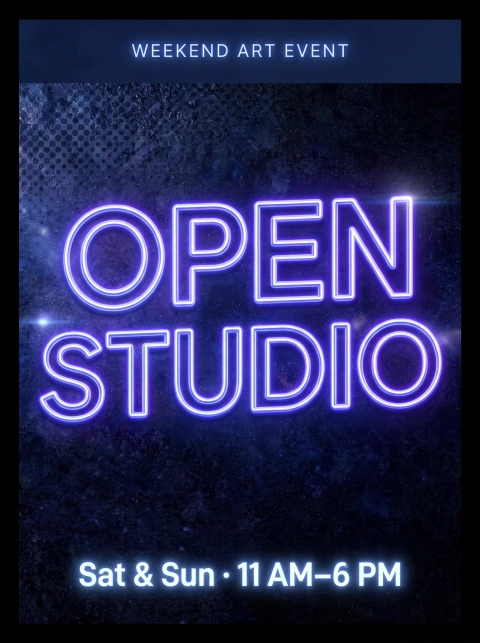
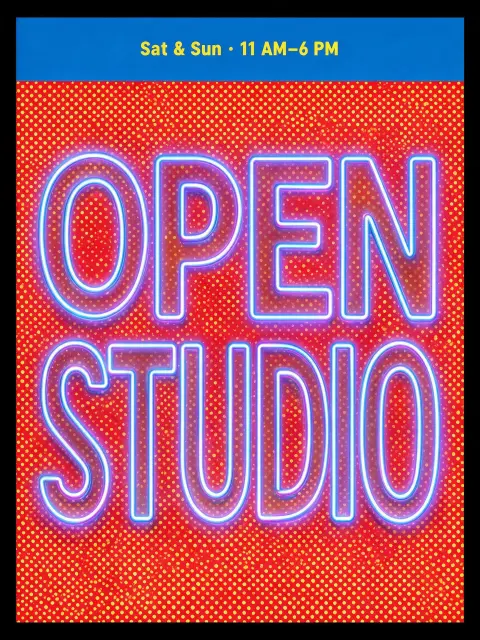
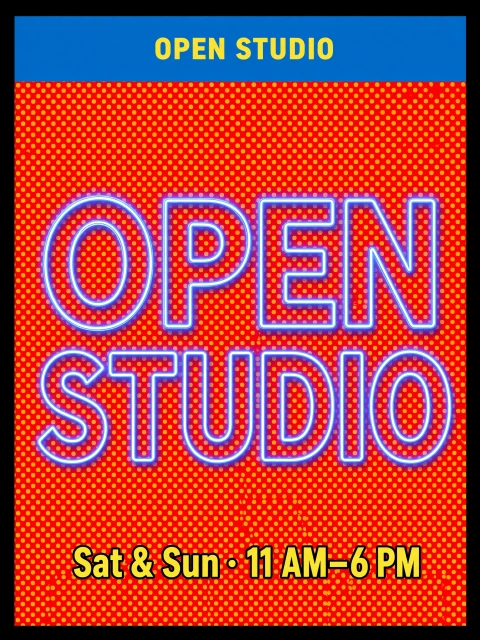
GPT Image 2.5 y Seedream 5.0 Pro acertaron en las dos partes y empataron en la puntuación más alta, 9.2. Grok Imagine 2.0 también acertó en las dos partes, pero escribió "OPEN STUDIO" una segunda vez en la franja superior, y sacó 8.95. Nano Banana 2.1 usó las letras de neón y la franja superior, pero las puso sobre el fondo estrellado de la referencia 2, y añadió una línea, "WEEKEND ART EVENT", que el prompt no tenía. Qwen Image 3.0 Pro siguió la referencia 2 tanto para las letras como para la composición, y copió de ella las palabras "NEON OUTLINE". Su segunda imagen hizo lo mismo.
El primer intento de Seedream 5.0 Pro en este encargo falló. En FontVibe, una petición a Seedream 5.0 Pro se detiene a los 2 minutos. Seedream 5.0 Pro llegó a ese límite en 3 de sus 4 intentos en este encargo, a 2K y con dos imágenes de referencia, y la única imagen que salió bien tardó 121 segundos. Esa es la imagen calificada. Nano Banana 2.1 también falló una vez, en su segunda imagen del encargo 7, y salió bien al reintentar. En FontVibe, las peticiones fallidas se reembolsan.
Qwen Image 3.0: ¿1K o 2K?
En FontVibe, una imagen de Qwen Image 3.0 Pro cuesta 22 créditos a 1K y 40 créditos a 2K. Hice también a 1K los encargos 4 y 5, los dos con el texto más pequeño, dos imágenes cada uno.
Las imágenes 1K miden 1024 × 1360 píxeles y las 2K, 1728 × 2304. A 1K, las 10 líneas del programa y las cuatro líneas de la etiqueta de té se siguen leyendo, y los dos encargos sacaron la misma nota que a 2K: 7.4 y 8.45. A 1K, Qwen también dibujó una lata de té en lugar de una etiqueta. Los dos programas a 1K tienen el error "formfunction.deign", frente a uno de los dos programas a 2K. El tiempo mediano a 1K fue de 14 segundos, frente a 23 segundos a 2K.
Para borradores e imágenes para redes que se ven en el móvil, 1K cuesta el 55% de 2K en esta prueba y su texto siguió siendo legible. Para imprimir, 2K tiene 2.9 veces más píxeles.
Para probar Qwen Image 3.0 Pro, elígelo en el menú de modelos del generador de FontVibe. Acepta hasta 3 imágenes por petición, contando la imagen que se edita y cualquier imagen de referencia. Al hacer clic en cualquier imagen de este artículo se abre su página en FontVibe, y al pasar el cursor sobre ella aparece un botón Recreate que ejecuta el mismo prompt.
Dos pruebas comparadas
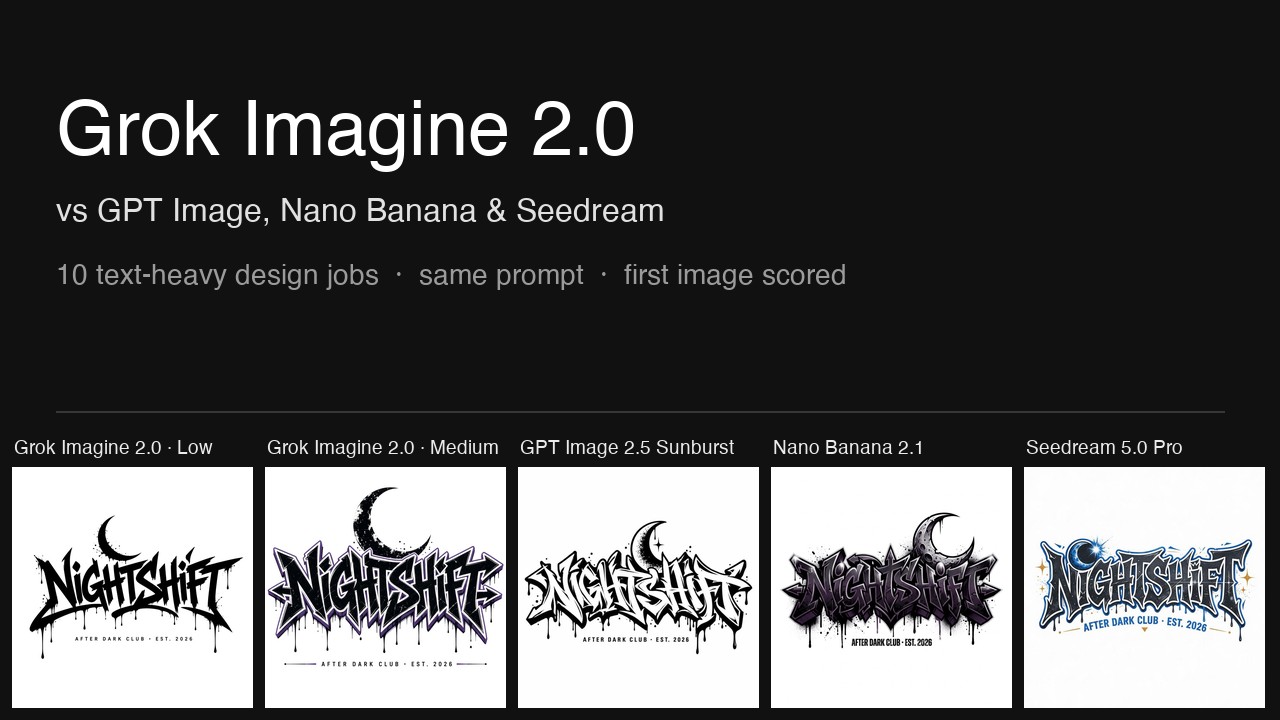
GPT Image 2.5 Sunburst, Grok Imagine 2.0 Medium, Nano Banana 2.1 y Seedream 5.0 Pro también estaban en mi prueba de Grok Imagine 2.0, que usó ocho prompts distintos.
| Modelo | Prueba de Grok Imagine 2.0 | Esta prueba |
|---|---|---|
| GPT Image 2.5 Sunburst (High) | 8.90 (1.º) | 8.99 (2.º) |
| Grok Imagine 2.0 Medium | 8.84 (2.º) | 9.01 (1.º) |
| Nano Banana 2.1 | 8.55 (4.º de 5 configuraciones) | 8.76 (3.º) |
| Seedream 5.0 Pro | 8.20 (5.º) | 8.75 (4.º) |
GPT Image 2.5 y Grok Imagine 2.0 Medium intercambiaron el primer y el segundo puesto: estaban a 0.06 de distancia en la prueba de Grok y aquí están a 0.02. Nano Banana 2.1 quedó por delante de Seedream 5.0 Pro en las dos pruebas, por 0.35 en la prueba de Grok y por 0.01 aquí. Nano Banana 2.1 figura en 4.º lugar en la prueba de Grok porque esa prueba también incluía Grok Imagine 2.0 Low, que sacó 8.59.
Los encargos 1 y 3 usaron los mismos prompts en las dos pruebas, así que permiten una comparación directa. En el encargo 1, Qwen Image 3.0 Pro sacó 8.3, menos que cualquiera de los otros cuatro modelos en cualquiera de las dos pruebas. En el encargo 3, sacó 9.0, lo mismo que GPT Image 2.5 y Nano Banana 2.1 en esta prueba.
Cada modelo, en breve
Grok Imagine 2.0 Medium, 9.01. La nota más alta en información y composición, 8.9. La nota más alta, sola o empatada, en 5 de los 10 encargos. Ningún texto que falte o esté mal escrito en ninguna imagen calificada. Nota más baja 8.3, en el programa, donde su título es una sans serif condensada en lugar de letras geométricas. Tiempo mediano de 95 segundos, el más lento de esta prueba.
GPT Image 2.5 Sunburst (High), 8.99. La nota más alta en letras, 9.0, y la nota más alta en atractivo, 8.9. La nota más alta, sola o empatada, en 8 de los 10 encargos. Nota más baja 7.5, en la foto del food truck, donde añadió una pizarra con una línea deformada. Probado en High; Extra High y Max no se probaron.
Nano Banana 2.1, 8.76. Cuesta 25 créditos por imagen 2K en FontVibe, el precio más bajo de los cinco modelos. Nota más baja 7.9, en el programa, donde entregó una foto de una tarjeta impresa. Siguió solo la mitad de la referencia de composición en el encargo 10.
Seedream 5.0 Pro, 8.75. La nota de legibilidad más alta, 10.0, compartida con Qwen Image 3.0 Pro. El más cercano al original en el encargo de edición, con una diferencia de píxeles de 2.6. Llegó al límite de 2 minutos de FontVibe en 3 de 4 intentos en el encargo de dos referencias. Nota más baja 8.15, en el sticker.
Qwen Image 3.0 Pro, 8.57. La nota de legibilidad más alta, 10.0, compartida con Seedream 5.0 Pro, y el tiempo mediano más rápido, 23 segundos. La nota más baja en información y composición, 7.7, y la nota más baja en atractivo, 7.8. Cambió o escribió mal una línea pedida en 3 de sus 10 imágenes calificadas, y dibujó una lata de té cuando el prompt pedía una etiqueta. No sacó la nota más alta en ningún encargo.
Una comprobación a ciegas
Como al calificar yo sabía qué modelo había hecho cada imagen, también hice una pasada a ciegas. Una página privada mostraba las cinco imágenes de cada encargo en orden aleatorio y con los nombres de los modelos ocultos. Cada imagen recibió una nota del 1 al 5 para las letras, una nota del 1 al 5 para la composición y uno de tres veredictos: lista para usar, necesita un arreglo pequeño o inservible.
| Modelo | Letras a ciegas (1–5) | Composición a ciegas (1–5) | Lista / arreglo pequeño / inservible |
|---|---|---|---|
| GPT Image 2.5 Sunburst | 4.4 | 4.8 | 8 / 2 / 0 |
| Seedream 5.0 Pro | 4.3 | 4.3 | 4 / 4 / 2 |
| Nano Banana 2.1 | 4.3 | 4.2 | 4 / 4 / 2 |
| Grok Imagine 2.0 Medium | 4.0 | 4.2 | 4 / 5 / 1 |
| Qwen Image 3.0 Pro | 3.4 | 3.5 | 1 / 2 / 7 |
La pasada a ciegas y la rúbrica coinciden en el último puesto, Qwen Image 3.0 Pro. La pasada a ciegas puso primero a GPT Image 2.5, mientras que la rúbrica lo deja 0.02 por detrás de Grok Imagine 2.0 Medium, y ordenó a Seedream 5.0 Pro, Nano Banana 2.1 y Grok Imagine 2.0 al revés que la rúbrica. La pasada a ciegas fue más dura con Qwen Image 3.0 Pro que la rúbrica: marcó como inservibles 7 de sus 10 imágenes, frente a 2 o menos en cada uno de los otros cuatro modelos.
Límites de esta prueba
- Se calificó una imagen por modelo y por encargo, y una sola persona calificó las 50.
- Grok Imagine 2.0 Medium y GPT Image 2.5 están a 0.02 de distancia, y Nano Banana 2.1 y Seedream 5.0 Pro están a 0.01. Cambiar una nota en 1 punto en un encargo mueve el promedio de un modelo entre 0.02 y 0.035, así que esos dos órdenes dependen de notas sueltas.
- GPT Image 2.5 se probó en el tercero de sus cinco niveles de calidad. Los otros cuatro modelos se probaron en su nivel más alto.
- Qwen Image 3.0 Pro se probó con su reescritura de prompt integrada desactivada. Con ella activada, el modelo reescribe el prompt antes de generar, así que sus resultados podrían ser distintos.
- Las imágenes de edición y de referencia venían de Seedream 5.0, el modelo anterior de la familia de Seedream 5.0 Pro.
- De los 12 idiomas que anuncia Qwen Image 3.0 Pro, solo se probaron el chino y el japonés.
- Los resultados describen estas versiones de los modelos el 21 de octubre de 2026.
Todas las imágenes son públicas en FontVibe y cada nota tiene un motivo escrito. Si repites un prompt y obtienes un resultado muy distinto, escribe a hello@fontvibe.ai y lo añadiré a este artículo.
Apéndice: todas las notas
Legibilidad / letras / información y composición / atractivo, y luego el total ponderado. Primera imagen de cada modelo (encargo 10, Seedream 5.0 Pro: la única imagen generada con éxito).
| Encargo | Qwen Image 3.0 Pro | GPT Image 2.5 (High) | Nano Banana 2.1 | Seedream 5.0 Pro | Grok Imagine 2.0 Medium |
|---|---|---|---|---|---|
| 1 Invitación | 10/9/7/7 = 8.30 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/9/7/8 = 8.50 | 10/9/9/9 = 9.20 |
| 2 Sticker | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 10/9/9/9 = 9.20 | 10/8/7/8 = 8.15 | 10/9/9/8 = 9.00 |
| 3 Póster | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/9/7/8 = 8.50 | 9/9/9/9 = 9.00 |
| 4 Programa | 10/7/7/6 = 7.40 | 10/9/9/9 = 9.20 | 10/8/6/8 = 7.90 | 10/9/8/9 = 8.95 | 10/7/9/8 = 8.30 |
| 5 Etiqueta de té | 10/9/6/9 = 8.45 | 10/9/8/9 = 8.95 | 10/9/8/9 = 8.95 | 10/9/7/9 = 8.70 | 10/9/9/9 = 9.20 |
| 6 Póster japonés | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/9/8/9 = 8.95 | 10/9/9/8 = 9.00 |
| 7 Insignia | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 7/8/9/8 = 8.05 | 10/7/9/8 = 8.30 | 10/9/9/9 = 9.20 |
| 8 Food truck | 10/9/8/8 = 8.75 | 4/9/7/9 = 7.50 | 10/9/8/9 = 8.95 | 10/9/9/9 = 9.20 | 10/9/9/9 = 9.20 |
| 9 Edición | 10/9/7/8 = 8.50 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 |
| 10 Referencias | 10/9/6/8 = 8.25 | 10/9/9/9 = 9.20 | 10/9/7/8 = 8.50 | 10/9/9/9 = 9.20 | 10/9/8/9 = 8.95 |
Qwen Image 3.0 Pro a 1K (no incluido en los promedios): encargo 4, 10/7/7/6 = 7.40; encargo 5, 10/9/6/9 = 8.45.
El motivo escrito de cada nota está archivado y disponible si lo pides.
Preguntas frecuentes
¿Qwen Image 3.0 es bueno para diseños con texto?
En esta prueba, Qwen Image 3.0 Pro empató con Seedream 5.0 Pro en la nota de legibilidad más alta, 10.0, y tuvo la nota total más baja de cinco modelos, 8.57 sobre 10. Tres de sus 10 imágenes calificadas cambiaron o escribieron mal una línea pedida, y sus composiciones sacaron la nota más baja en información y composición, 7.7.
¿Qué modelo de imagen con IA sacó la nota más alta en diseños con texto?
Grok Imagine 2.0 Medium sacó 9.01 sobre 10, la nota más alta de cinco modelos en 10 encargos, y GPT Image 2.5 Sunburst en calidad High sacó 8.99, 0.02 menos. Nano Banana 2.1 sacó 8.76, Seedream 5.0 Pro 8.75 y Qwen Image 3.0 Pro 8.57.
¿Qwen Image 3.0 puede escribir chino y japonés?
Sí, en esta prueba. Escribió bien en chino simplificado una etiqueta de té bilingüe en chino e inglés, y compuso en vertical un póster japonés de tres líneas con todos los caracteres correctos. Los otros cuatro modelos hicieron lo mismo.
¿Qwen Image 3.0 puede editar imágenes?
Sí. En el encargo de edición cambió bien una fecha y un precio, pero en su primera imagen también cambió "18+" por "$Z+", y su resultado tuvo la mayor diferencia de píxeles con el original de los cinco modelos, 12.2 en una escala de 0 a 255.
¿Qwen Image 3.0 a 1K es suficiente?
En los dos encargos con el texto más pequeño, las imágenes 1K sacaron la misma nota que las 2K, 7.4 y 8.45, y todas las líneas se siguieron leyendo. 1K cuesta 22 créditos en FontVibe y 2K cuesta 40.
¿GPT Image 2.5 se probó en su calidad más alta?
No. GPT Image 2.5 Sunburst se probó en High, el tercero de sus cinco niveles de calidad y el predeterminado de FontVibe. Extra High y Max no se probaron.
¿Puedo probar los cinco modelos en un solo lugar?
Los cinco modelos están en el menú de modelos de FontVibe, y puedes ejecutar el mismo prompt en cada uno.
¿Listo para probarlo tú mismo?
Pon en práctica estas técnicas de prompts — no necesitas cuenta para empezar.
✦ Empieza a generarAñade FontVibe como fuente preferida en Google
Pon en práctica estas técnicas de prompts — no necesitas cuenta para empezar.
Empieza a crear
Comentarios