GPT-6.1 Terra実測:AIデザイナー8モデル比較
OpenAI・Anthropic・Googleの言語モデル8つに同じデザイン課題12問を各3回出し、287枚すべてブラインド採点。
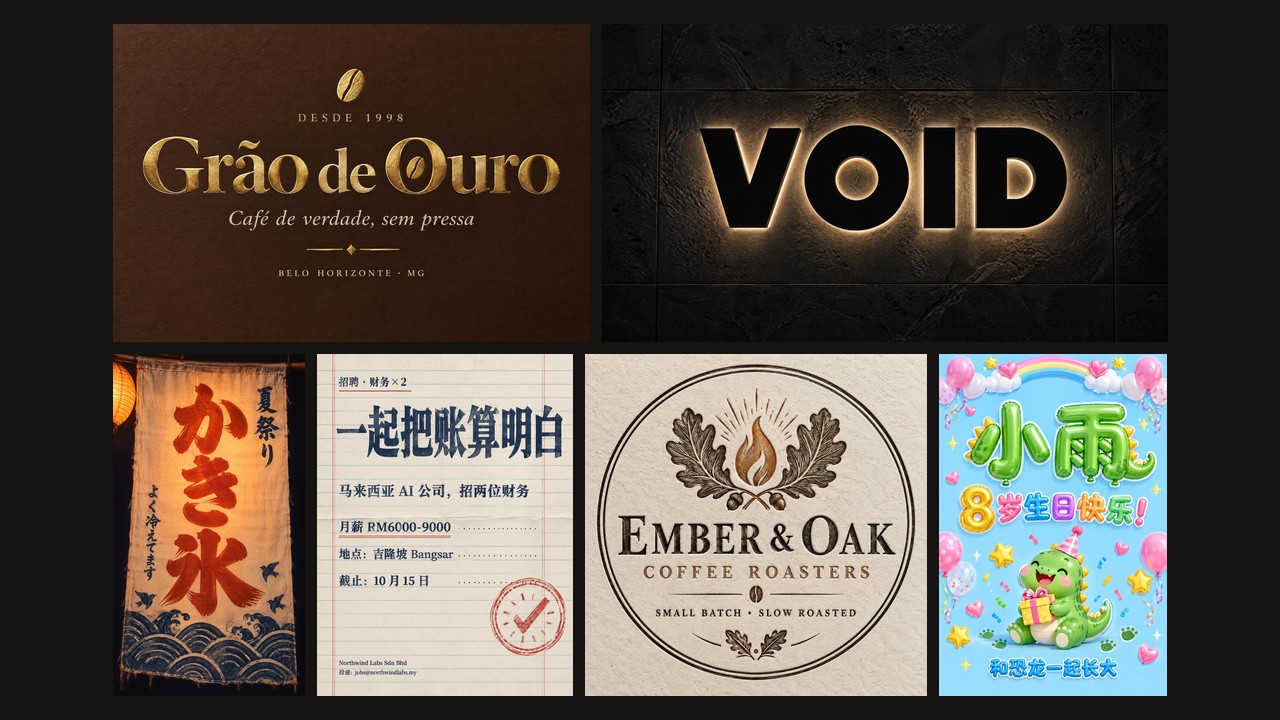
FontVibeにデザインを頼むと、画像が描かれる前に、言語モデルがデザイナーの仕事をします。依頼文を読み、デザインの方向性を3つ提案し、画像モデルが描くための指示を書きます。GPT-6.1 Terraは2026年10月26日に公開されたので、FontVibeが現在使っているGPT-5.6 Terraよりこの仕事をうまくこなせるかをテストし、OpenAI、Anthropic、Googleのほかの言語モデル6つとも比較しました。
どのモデルにも同じ依頼文12問を、それぞれ3回ずつ渡しました。画像モデルはすべてのデザインで同じで、GPT Image 2.5 Sunburst(2K、品質Medium)です。私のQwen Image 3.0のテストとGrok Imagine 2.0のテストで2位だったモデルです。デザインごとに変わるのは、どの言語モデルがデザイナー役を務めたかだけです。287枚のデザインは、モデル名を伏せたブラインドで採点しました。
結果
| # | モデル | 完成数 | 総合(95% CI) | 可読性 | 文字表現と仕上がり | 情報とレイアウト | 見栄え | 依頼にない行(1枚あたり) | 1枚あたりのコスト | 提案時間(中央値) |
|---|---|---|---|---|---|---|---|---|---|---|
| – | Claude Opus 5.5 | 18 / 36 | 7.97(7.40–8.46) | 8.7 | 8.0 | 7.4 | 7.8 | 0.22 | $0.41 | 65 s |
| 1 | GPT-6 Luna | 36 / 36 | 7.69(7.50–7.88) | 9.1 | 7.2 | 7.5 | 7.2 | 0.36 | $0.005 | 44 s |
| 2 | GPT-5.6 Terra | 35 / 36 | 7.58(7.14–7.97) | 8.7 | 7.5 | 7.0 | 7.5 | 0.46 | $0.09 | 29 s |
| 3 | Gemini 4 Argon | 36 / 36 | 7.56(7.21–7.89) | 8.6 | 7.9 | 6.2 | 7.7 | 1.56 | $0.11 | 40 s |
| 4 | Claude Sonnet 5.5 | 36 / 36 | 7.43(7.14–7.75) | 8.7 | 7.9 | 5.6 | 7.8 | 1.11 | $0.18 | 27 s |
| 5 | GPT-6.1 Sol | 36 / 36 | 7.35(7.03–7.71) | 9.4 | 6.6 | 7.5 | 6.4 | 0.28 | $0.09 | 62 s |
| 6 | Gemini 3.8 Flash | 36 / 36 | 7.33(6.94–7.69) | 8.8 | 7.7 | 5.4 | 7.7 | 2.36 | $0.04 | 32 s |
| 7 | GPT-6.1 Terra | 36 / 36 | 7.08(6.59–7.56) | 9.1 | 6.5 | 7.0 | 6.1 | 0.17 | $0.04 | 37 s |
スコアは10点満点で、完成したすべてのデザインの平均です。Claude Opus 5.5は順位に入れていません。デザインが完成したのは12問のうち8問だけで、その多くが易しい依頼文だったため、平均をほかのモデルと比べられないからです(同じ依頼文での比較)。95%信頼区間は、依頼文をリサンプリングして求めました。1つの依頼文の3回の実行は、同じ依頼文と同じ1回の採点を共有しているためです。2つのモデルに差があるとみなすのは、依頼文ごとの差の信頼区間が0をまたがない場合だけです。28組の比較はすべて付録に載せています。1枚あたりのコストは、デザイン1枚にかかる言語モデルのコスト(提案と画像への指示)の中央値で、2026年10月30日時点の各社の公開価格で計算しています。画像そのもののコストはどのモデルでも同じなので、含めていません。課題ごとのスコアはすべて付録に載せています。
目立った結果が4つあります。
デザイナー役の言語モデルを何にするかで結果は変わりますが、質だけで見ると、大半のモデルには差がつきませんでした。 画像モデルと設定が同じでも、平均スコアは7.08点から7.97点まで開きました。28組のモデルの組み合わせのうち、依頼文ごとに比べてはっきり差が出たのは5組です。GPT-6.1 TerraはGPT-5.6 Terra、GPT-6 Luna、Claude Opus 5.5より低く、GPT-6.1 SolはGPT-6 LunaとClaude Opus 5.5より低い結果でした。残りの23組は、このテストでは同率です。
質・コスト・速度・安定性を合わせて見ると、差が開きます。 質が同じグループのモデルでも、デザイン1枚あたりのコストは30倍以上違いました(GPT-6 Lunaは$0.005、Claude Sonnet 5.5は$0.18)。提案して画像への指示を書くまでの時間は約2倍違いました(GPT-5.6 TerraとClaude Sonnet 5.5は約41秒、GPT-6.1 Solは約87秒)。失敗の理由もモデルごとに異なります(詳細)。総合すると、いくつかのモデルは少なくとも1つの点で劣り、ほかの点でそれを取り戻せていません。GPT-6.1 SolはGPT-5.6 Terraと同じコストで、質に差はつきませんでしたが、時間は2倍かかりました。Gemini 3.8 FlashはGPT-6 Lunaの8倍のコストで、質に差はつかず、プロバイダーのエラーが8回出ました。GPT-6.1 TerraはGPT-6 Lunaよりコストが高く、スコアははっきり低い結果でした。
どこでも勝つモデルはなく、それぞれ向いている仕事が違います。 平均が最も高かったのはClaude Opus 5.5の7.97点ですが、これは8問の依頼文での18枚だけによるものです。メインの実行では、ほかのどのモデルよりはるかに長い提案が、FontVibeが自社の本番用に定めた6,600トークンの上限で17回途中で切れ、さらに1回は画像への指示が壊れた形で返ってきて失敗しました。上限を2倍にして再実行すると毎回完成し、36枚全体では、GPT-5.6 Terra、Claude Sonnet 5.5、Gemini 3.8 Flash、2つのGPT-6.1モデルよりはっきり高く、GPT-6 LunaやGemini 4 Argonとは差がつきませんでした(詳細)。最も遅く、最も高いモデルでもあります。デザイン1枚あたりのコストは中央値で$0.41、失敗した実行も含めると完成したデザイン1枚あたり$0.72です。急がず、その優位に見合う価格を払える複雑なデザインの仕事に向いています。GPT-6 Lunaは質がトップのグループに入り、毎回完成し、コストは最も低いので、コストパフォーマンスが最も高く、大量の制作に向いています。GPT-5.6 Terraは速くてバランスが取れており、誰かが結果を待っているリアルタイムの用途に向いています。
依頼にない文字は測定できる欠陥で、モデル間で14倍の差がありました。 GPT-6.1 Terraが加えた依頼文にない行はデザイン1枚あたり平均0.17行、Gemini 3.8 Flashは2.36行で、創業年、スローガン、サービス一覧、架空の数字などです。情報で点を落とした理由として最も多かったのが依頼にない文字なので、どのモデルを使うにしても、パイプラインには文言のチェックが必要です。
GPT-6.1 Terraはこのテストの出発点なので、ひとこと触れておきます。同じパイプライン、同じプロンプトで、GPT-6.1 TerraはGPT-5.6 Terraより保守的でした。依頼文ごとに比べると0.50点低く(95% CI −0.81〜−0.21)、12問のうち9問で下回りました。負けたのは文字表現と仕上がり(−0.93)と見栄え(−1.38、12問すべてで下回った)で、可読性はわずかに高かった(+0.47)ものの、誤差の範囲内です。デザインは依頼にない文字が最も少なく、最も地味でした。36枚のうち17枚は、依頼文が求めた雰囲気に一部しか合っていません。これが示すのは、依頼文を読み、方向性を決め、画像への指示を書くという作業での出来であって、ほかのタスクでの出来ではありません。
コスト・速度・安定性
モデル選びにおいて、デザインの質は一部にすぎません。同じ実行で、デザイン1枚にかかるコスト、時間、失敗の頻度も計測しました。
| モデル | 提案時間(中央値 / 最も遅い10%) | 画像への指示の作成時間(中央値 / 最も遅い10%) | 1枚あたりのコスト(中央値) | 完成1,000枚あたりの支出 | 1回目で完成 | モデル自身の失敗 | プロバイダーのエラー | 内部リトライ |
|---|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 37 s / 45 s | 13 s / 17 s | $0.041 | $41 | 36 / 36 | 0 | 0 | 0 |
| GPT-5.6 Terra | 29 s / 38 s | 12 s / 14 s | $0.090 | $93 | 33 / 36 | 1 | 0 | 0 |
| GPT-6.1 Sol | 62 s / 79 s | 25 s / 30 s | $0.090 | $91 | 34 / 36 | 0 | 0 | 0 |
| GPT-6 Luna | 44 s / 58 s | 16 s / 23 s | $0.005 | $5 | 36 / 36 | 0 | 0 | 1 |
| Claude Opus 5.5 | 65 s / 75 s | 25 s / 35 s | $0.41 | $721 | 18 / 36 | 18 | 0 | 19 |
| Claude Sonnet 5.5 | 27 s / 32 s | 14 s / 16 s | $0.18 | $162 | 36 / 36 | 0 | 0 | 0 |
| Gemini 4 Argon | 40 s / 73 s | 22 s / 33 s | $0.11 | $102 | 36 / 36 | 0 | 0 | 3 |
| Gemini 3.8 Flash | 32 s / 49 s | 13 s / 35 s | $0.043 | $49 | 29 / 36 | 0 | 8 | 4 |
時間は、完成した実行での、各ステップの言語モデル自体の処理時間です。これに加えて画像の描画に中央値で20秒かかり、これはどのモデルでも同じです。コストは2026年10月30日時点の各社の公開価格で計算し、言語モデルの2つのステップを含め、画像は含めていません。画像のコストは、どのモデルがデザインしても同じです。「完成1,000枚あたりの支出」は、失敗した実行や再実行も含めて使った費用をすべて合計し、完成したデザインの数で割ったものです。「1回目で完成」は、再実行なしで画像まで出た実行の数です。FontVibeの受付が質問をするために止めたGPT-5.6 Terraの2回とGPT-6.1 Solの2回は、モデルの責任ではありませんが、1回目で完成しなかったものとして数えています。内部リトライは、試行が失敗したあと、FontVibeのパイプラインが1つのリクエストの中で同じモデルをもう一度試した回数です。
コスト。 GPT-6 Lunaが群を抜いて安く、完成1,000枚あたり約$5でした。GPT-5.6 Terraは$93、Claude Opus 5.5は$721で、Claude Opus 5.5は失敗した実行のコストが完成した実行とほぼ同じくらいかかっています。GPT-6.1 TerraのコストはGPT-5.6 Terraの半分未満でした。最も高かったのはClaude Opus 5.5で、その一因は提案が最も長かったことです。提案の長さの中央値が、上限の6,600トークンに達していました。
速度。 提案が最も速かったのはClaude Sonnet 5.5で中央値27秒、GPT-5.6 Terraも29秒と僅差でした。GPT-6.1 SolとClaude Opus 5.5は1分を超えました。Gemini 4 Argonの中央値は40秒ですが、最も遅い10%は73秒以上かかり、ばらつきは全モデルで最も大きい結果です。
安定性。 GPT-6.1 Terra、GPT-6 Luna、Claude Sonnet 5.5、Gemini 4 Argonは、36回すべてを1回目で完成させました。Gemini 3.8 Flashの出力自体は一度も失敗しませんでしたが、Googleのサービスが7回の実行で計8回のエラー(レート制限とタイムアウト)を返しました。いずれも再実行で完成しています。Claude Opus 5.5は18回失敗しました。17回は提案が出力上限で途中で切れたもの、1回は画像への指示が壊れた形で返ってきたものです。19回の内部リトライのほとんどは、途中で切れた提案をもう一度試し、また途中で切れたものでした。
テスト方法
パイプライン
このテストが測るのは、デザイナーという1つの仕事です。FontVibeのデザインモードでは、リクエストは3つのステップを通ります。
- 提案。 言語モデルが依頼文を読み、デザインの方向性を3つ提案します。それぞれに、タイトル、印刷する正確な文字、配色、レイアウト、文字スタイルの選択が含まれます。
- 画像への指示を書く。 1つ目の方向性について、言語モデルが画像モデル向けの指示をすべて書きます。
- 描画。 画像モデルが描きます。
テスト対象のモデルが担当したのはステップ1と2です。ステップ3は常にGPT Image 2.5 Sunburst(2K、品質Medium)でした。すべてのリクエストはFontVibeの本番パイプラインを通り、システムプロンプト、出力形式、推論強度の設定(medium)はどのモデルでも同じです。モデルごとの専用プロンプトや専用設定はありません。描画したのは常に1つ目の方向性で、私が方向性を選んだことはありません。
8つのモデル
| 提供元 | モデル | 選んだ理由 |
|---|---|---|
| OpenAI | GPT-6.1 Terra | 2026年10月26日に公開された新モデル。採用を検討している対象 |
| OpenAI | GPT-5.6 Terra | FontVibeが現在ステップ1に使っているモデル |
| OpenAI | GPT-6.1 Sol | OpenAIのフラッグシップ |
| OpenAI | GPT-6 Luna | OpenAIの低価格モデル。FontVibeが現在ステップ2に使っているモデル |
| Anthropic | Claude Opus 5.5 | Anthropicのフラッグシップ |
| Anthropic | Claude Sonnet 5.5 | Anthropicの中価格帯モデル |
| Gemini 4 Argon | Googleのフラッグシップ | |
| Gemini 3.8 Flash | Googleの低価格モデル |
12問の依頼文と4つの層
デザイナーがつまずくパターンは4種類あるので、依頼文は3問ずつ4つの層に分け、1つの層で1つのパターンを試しています。
| 層 | 何を試すか | なぜ重要か |
|---|---|---|
| 1. 日常的な依頼 | 短く、目的が1つの依頼文 | 実際の依頼の大半はこの形なので、日常の使い方に最も近い層です |
| 2. 情報を正しく伝える | 正確に載せる必要がある文字。重要度の順番が決まっている場合もある | 画像モデルに文字を渡すのは言語モデルだけです。ここで落としたり変えたりした文字は、あとから取り戻せません |
| 3. デザインの判断 | 矛盾する要件、なじみのない分野、2つの対象層を同時に満たすこと | 依頼主がデザイナーにお金を払うのはこの部分で、モデルの差が最も出やすいところです |
| 4. 言語と文化 | 文化的な背景を含む、日本語、ドイツ語、メキシコのスペイン語の依頼文 | 文化的な手がかりを間違えると、誤字より損失が大きくなります |
依頼文は6言語(英語、中国語、スペイン語、ポルトガル語、ドイツ語、日本語)で、FontVibeのインターフェースの6言語と同じです。どの依頼文も、デザインに文字を入れるよう求めています。12問のうち8問は、2026年9月にOpenAIの3モデルで行った社内テストで最初に使ったものです。求人ポスターの会社と、依頼文に出てくる名前と住所はすべて架空です。各課題の依頼文の全文は、以下の各セクションに載せています。
実行回数と失敗
各モデルは各依頼文を3回実行しました。1モデルあたり36枚、合計288枚です。デザインが失敗したときは、原因によってその後の扱いを決めました。
- モデル自身の出力が失敗した場合(本番のトークン上限で途中で切れた、または提案が空か壊れていた):失敗として数え、再実行していません。この失敗は19枚で、Claude Opus 5.5が18枚(上限で途中で切れた提案が17回、壊れた画像への指示が1回)、GPT-5.6 Terraの空の提案が1枚です。
- プロバイダーのサービスが失敗した場合(レート制限、サーバーエラー、タイムアウト):再実行しました。8回発生し、すべてGemini 3.8 Flashです。
- FontVibe自身の受付が先に質問した場合。 リクエストがデザイナーに届く前に、別の固定モデルが足りない情報がないかを確認します。ナイトクラブの依頼文では、依頼をそのまま渡さずに「ほとんど見えないくらいにしますか、それとも50メートル先から読めるようにしますか?」と聞き返すことがありました。これはテスト対象のモデルのせいではないので、この4回は再実行し、再実行で得たデザインを採点しました。すべての試行はオープンデータセットに載せています。
287枚のデザイン(メインの実行の269枚と、後述するOpusの再実行の18枚)はすべて2026年10月30日に、FontVibeの本番サイトで公式アカウントを使って生成し、FontVibeで公開しています。
採点
各デザインは、結果を集計する前に書いたFontVibeのベンチマーク採点基準に沿って採点しました。この基準は、私が以前行ったAIデザインツール7種のテストの評価基準と、画像モデルの2つのテストをもとにしています。審査員は依頼文を書いた依頼主の立場で、次の順に判断します。頼んだものになっているか。手を加えずに使えるか。求めた雰囲気になっているか。細部の作りはよいか。ひと目で「すごい」と思えるか。
| 採点項目 | 重み | 内容 |
|---|---|---|
| 可読性 | 20% | まず、メインの文字が実際のサイズで読めない、または読み間違えられるような重大なエラーがないかを確認します。重大なエラーが1つでもあれば1〜4点、なければ7〜10点です。 |
| 文字表現と仕上がり | 35% | 文字表現と素材感が依頼文の求める効果と雰囲気を実現しているか、そしてその作りの出来です。 |
| 情報とレイアウト | 25% | 正しい成果物になっているか、すべての文字がそのまま使えるか。つまり欠けがなく、依頼主が書いたとおりで、依頼主が言っていないこと・責任を持てないことが入っていないか。そのうえで、階層、順序、バランスを見ます。 |
| 見栄え | 20% | 第一印象と、視覚的なプロらしさだけを見ます。文字のエラーは情報とレイアウトで一度だけ採点し、ここで重ねて減点はしません。 |
総合スコアは審査員の判断ではなく、計算で出します:0.20 × 可読性 + 0.35 × 文字表現 + 0.25 × 情報とレイアウト + 0.20 × 見栄え。
多くのスコアを左右したルールが1つあるので、全文を載せます。すべての行について問うたのは、依頼主は使う前にこれを直す必要があるか、そして依頼主はこれを一度でも言ったかという点です。依頼文がすでに言っている内容の言い換え(コーヒー焙煎所の「COFFEE ROASTERS」)や、ありふれたあいさつ(「Happy birthday」)は認めました。依頼主が出していない事実、数字、約束、スローガンは、1つごとに減点です。依頼主はそれを削除するか、気づかずに事実でない内容を公開するかのどちらかになるからです。{{fecha}}のようなプレースホルダーがそのまま印刷されたものや、「7 de la noche」が「7:00 p. m.」になるような依頼主の書き方の変更も減点しました。
採点者。 スコアはClaude Opus 5.5で動くAI審査員がつけました。依頼文3問ごとに審査員1人が担当し、各審査員は、1つの依頼文のどの画像を採点する前にも、その依頼文の元画像をすべて見ています。画像にはランダムなIDを付け、審査員はどのモデルがどのデザインを作ったかを知りません。テストした8モデルのうちClaude Opus 5.5は、審査員と同じモデルです。そのスコアは、この点を踏まえて読んでください。審査員がOpus自身のデザインをひいきするかどうかは検証していません。人によるブラインド選択が、このテストで唯一の人の目によるチェックです。
課題ごとの結果
各グリッドには、各モデルで最初に完成したデザインを載せているので、手で選んだデザインはありません。キャプションには、その画像のスコアと、その課題の3回の実行でのモデルの平均を書いています。
第1層:日常的な依頼
課題1:コーヒー焙煎所のロゴタイプ
A logo-style title for my new coffee roastery called EMBER & OAK
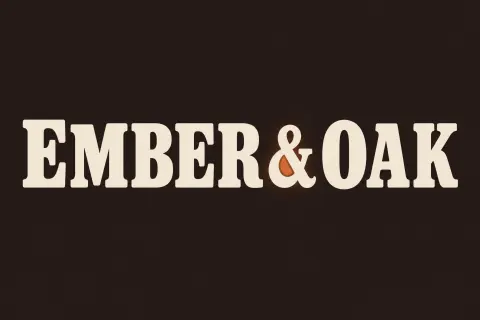
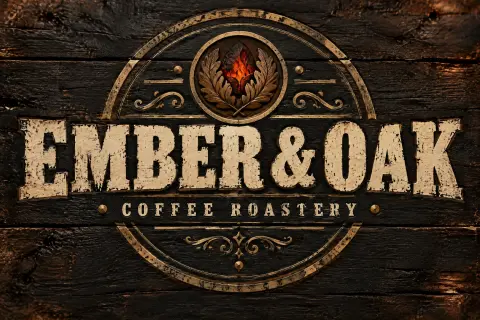
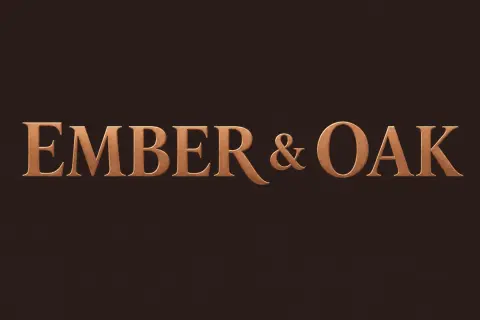
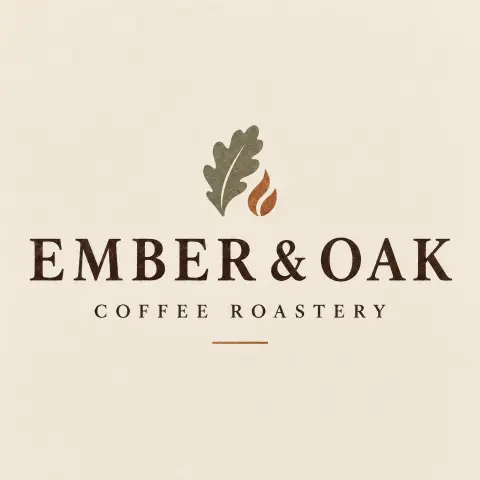
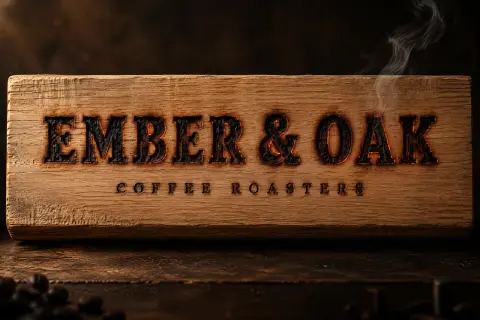
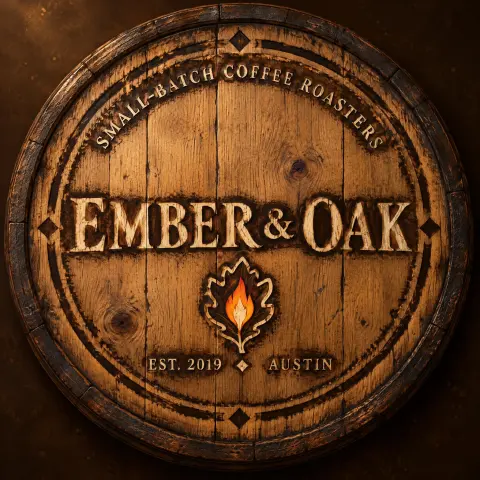
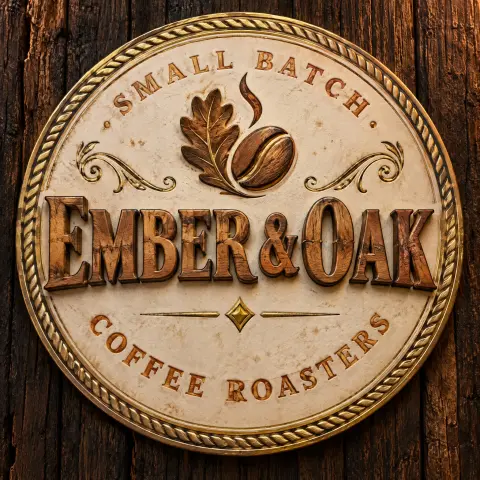
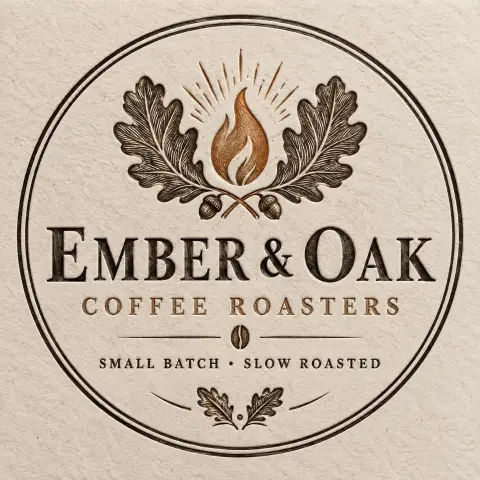
Claude Opus 5.5が平均8.38点で最高でした。店名を木に焼き付け、各文字の縁を焦がしています。GPT-5.6 Terra(8.13点)とGPT-6 Luna(8.05点)が僅差で続きました。GPT-6.1 Terra(6.62点)とGPT-6.1 Sol(6.43点)は、すっきりしているもののありふれた書体で店名を組み、審査員は依頼文の「ember and oak(残り火とオーク)」に一部しか合っていないと判定しました。Claude Sonnet 5.5のデザインには、依頼主が出していない創業年と都市名「EST. 2019」「AUSTIN」が入っていました。
課題2:恐竜の誕生日ポスター
给我做一张生日海报,寿星叫小雨,今年 8 岁,喜欢恐龙(誕生日ポスター。主役の女の子は小雨(Xiaoyu)で、8歳になり、恐竜が大好き。)
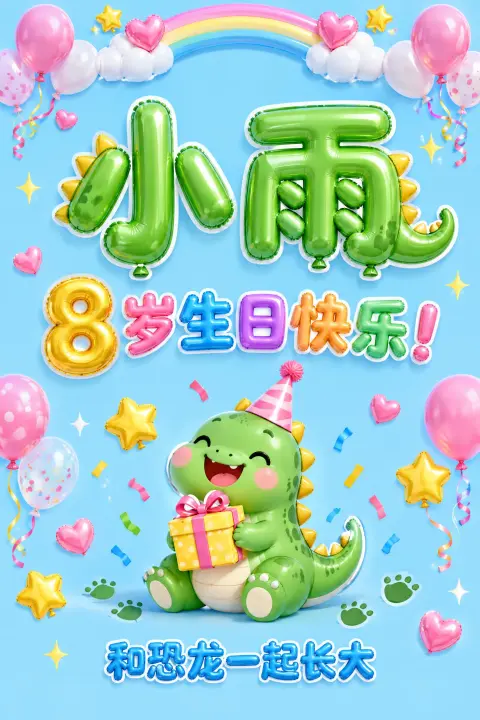
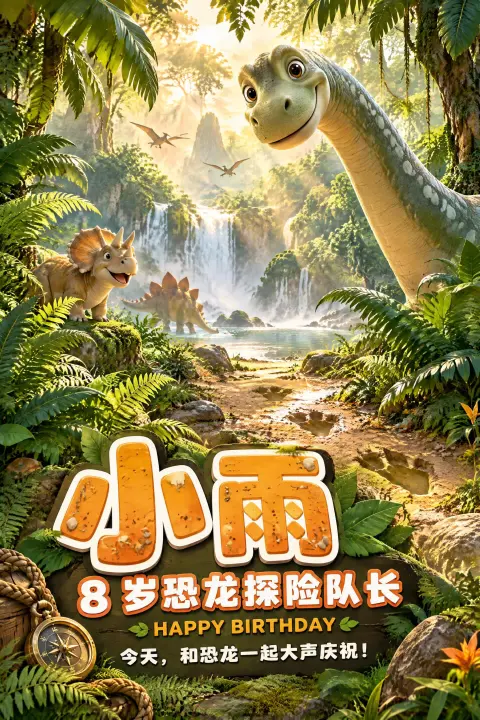
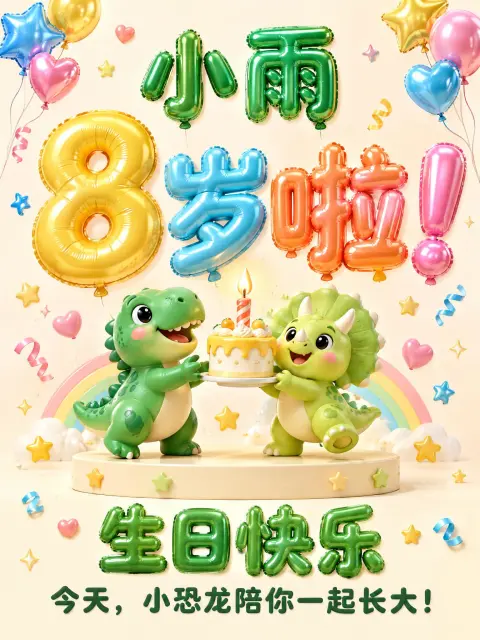
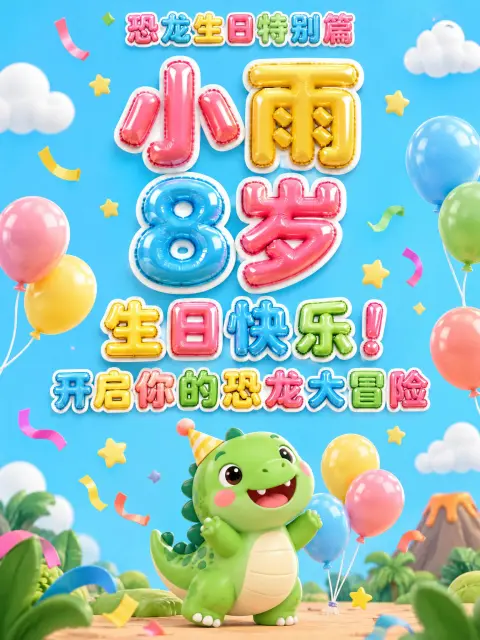
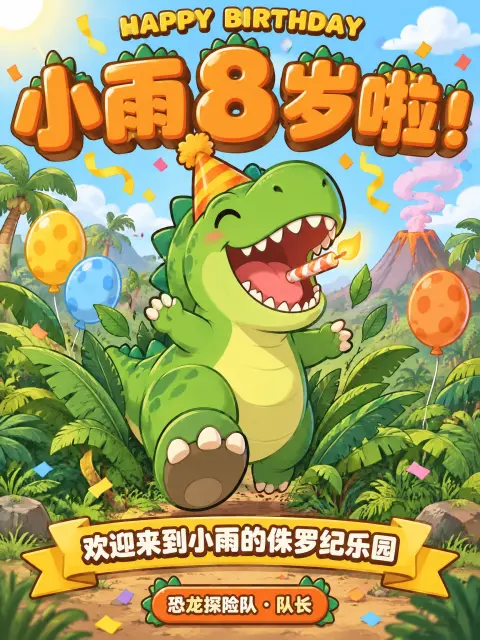
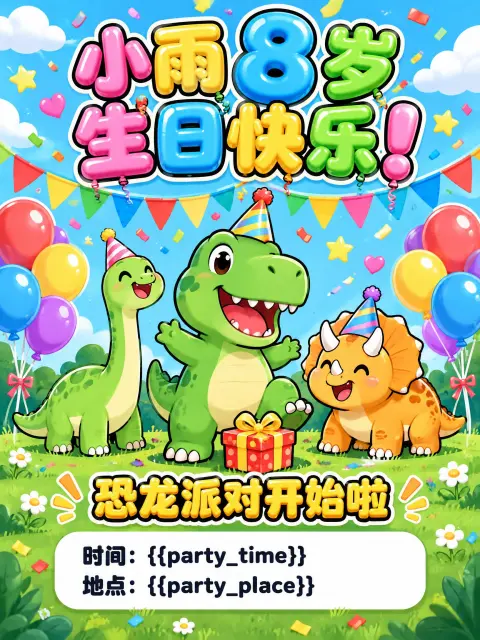
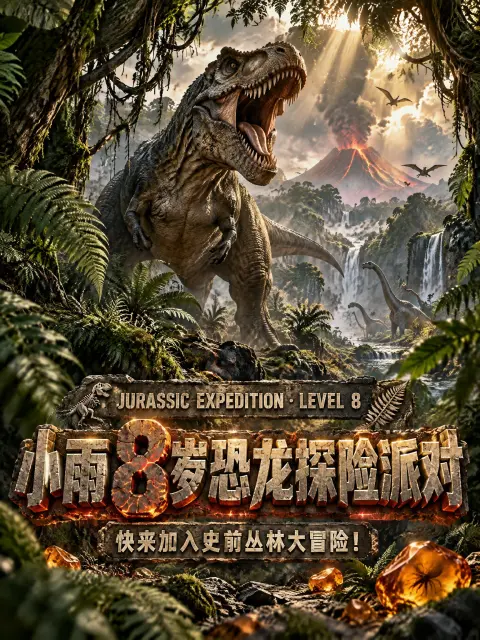
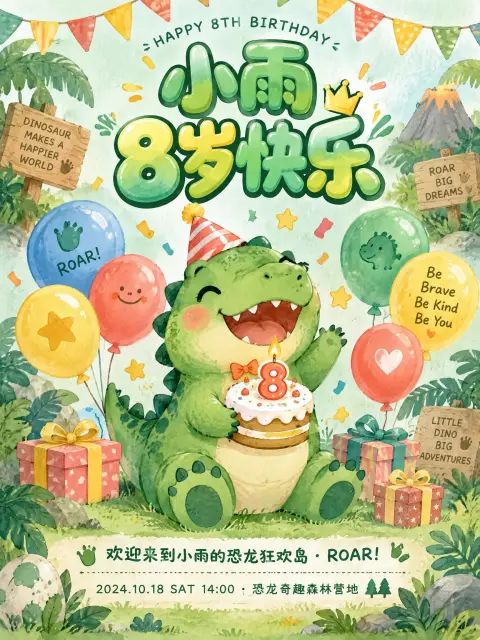
最も良かったのはOpenAIのモデルです。GPT-6.1 Solは8.73点、GPT-6.1 Terraは8.43点で、GPT-6.1 Terraにとってはこれが最高の課題でした。小雨の「雨」の字から恐竜のしっぽが生えています。最下位はGemini 4 Argonの6.48点です。写実的なジャングルと、依頼主が一度も触れていない「Jurassic Expedition · Level 8」というパーティーを描き、審査員は8歳の誕生日に一部しか合っていないと判定しました。GPT-6.1 Solのようなバルーン文字なら、バブル文字ジェネレーターを見てください。Gemini 3.8 Flashの1枚目は、存在しないパーティーの日付、時刻、会場をでっち上げ、しかもその日付はすでに過ぎていました。
課題3:卒業パーティーのポスター
Un cartel para la fiesta de graduación de secundaria, dice PROMOCIÓN 2026(高校の卒業パーティーのポスター。「PROMOCIÓN 2026」と入れる。)
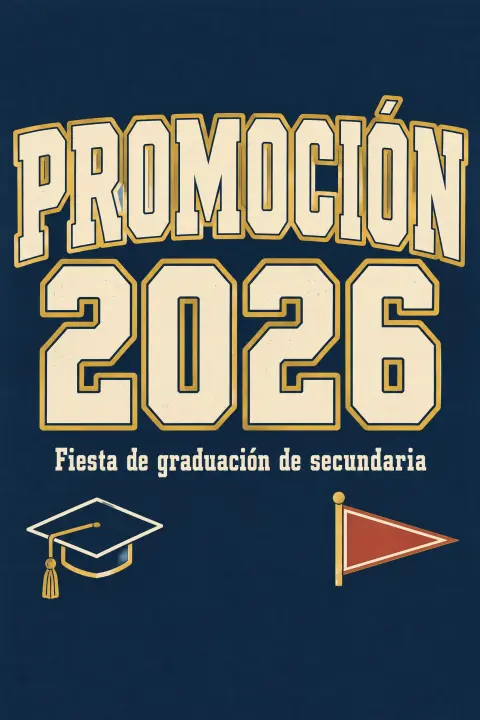
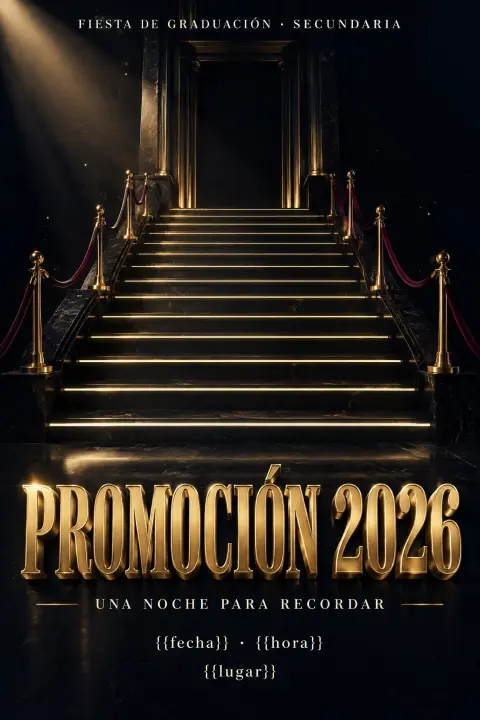
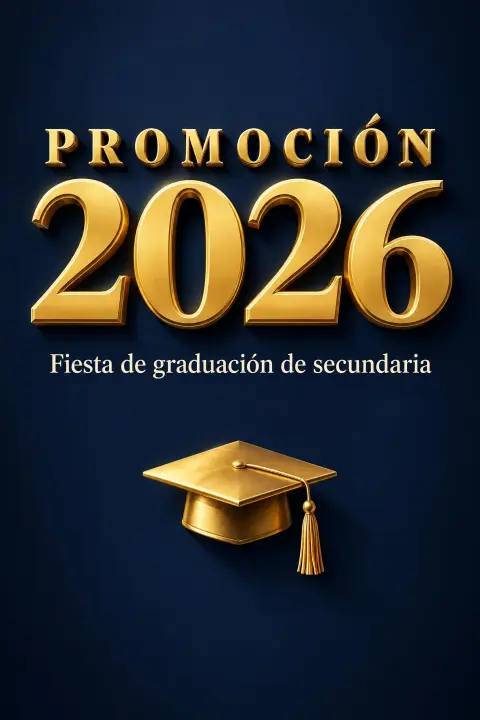
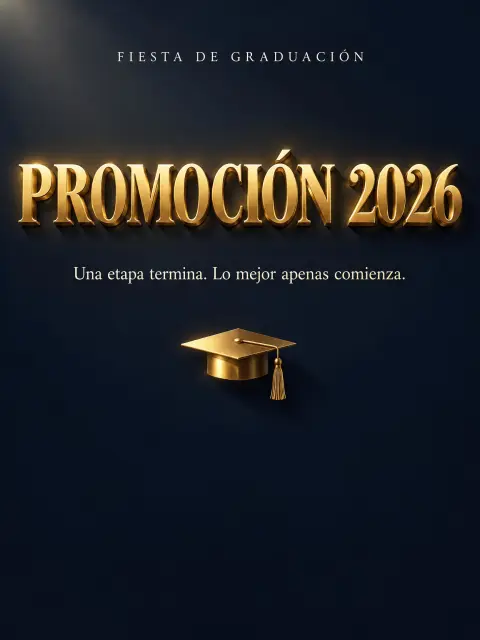
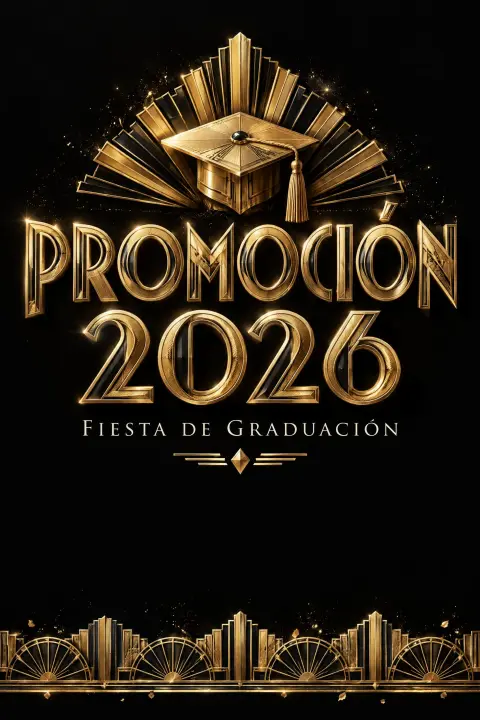
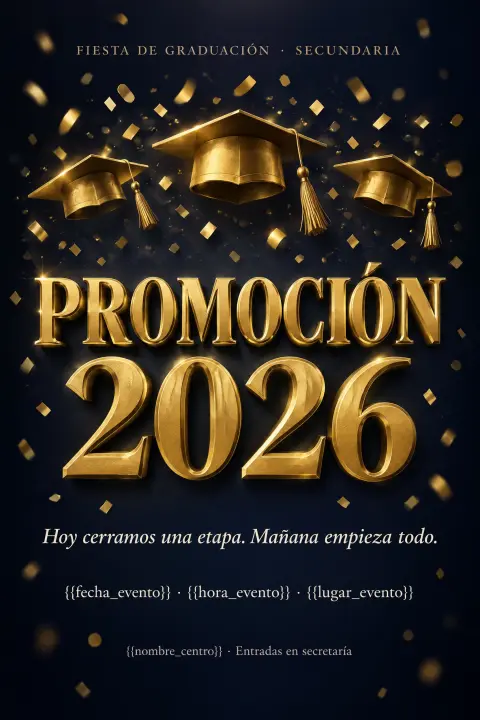
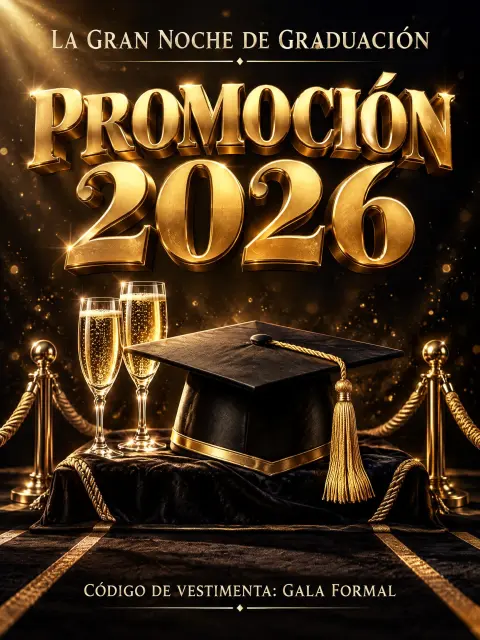
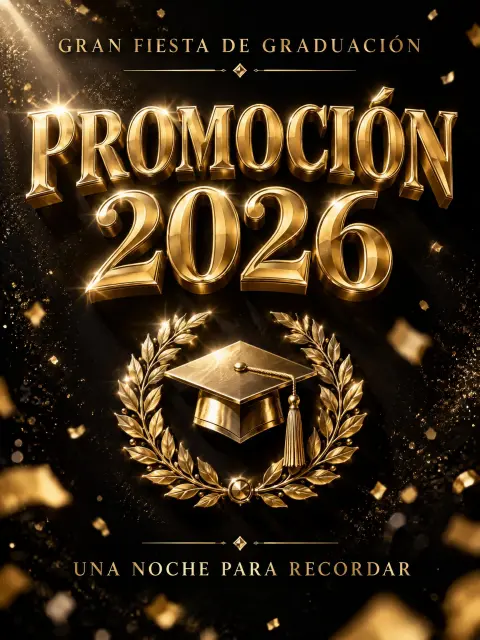
どのモデルも、PROMOCIÓNをアクセント記号付きで書きました。最も高かったのはGemini 4 Argon(8.40点)とGemini 3.8 Flash(8.28点)で、金色の文字と月桂樹をあしらっています。ただしArgonのデザインの1枚にはフォーマルなドレスコードが加えられ、この課題では2枚のデザインが学校のパーティーにシャンパングラスを描いていました。この依頼文には日時も場所もなく、多くのデザインは、そうした情報が入るはずの下部を空白のまま残すか、そこに{{fecha}}のようなプレースホルダーを印刷していました。
第2層:情報を正しく伝える
課題4:YouTubeサムネイル
YouTube thumbnail text for a video about losing 30 pounds, title THE SHIFT
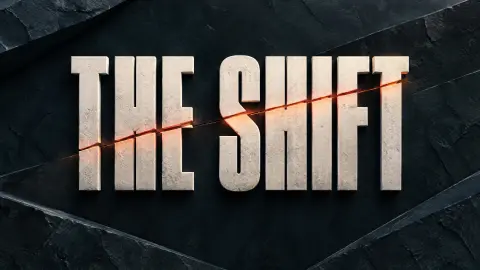
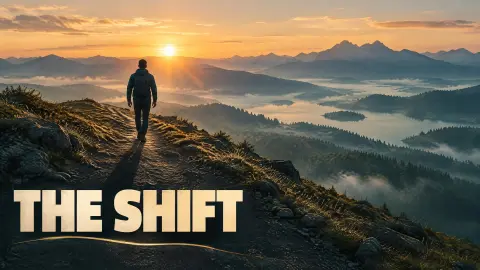
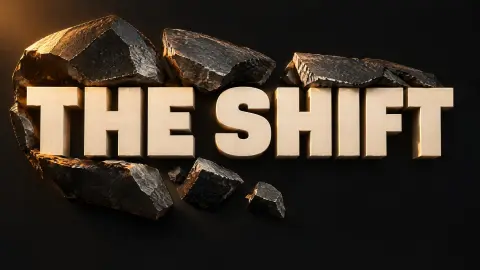
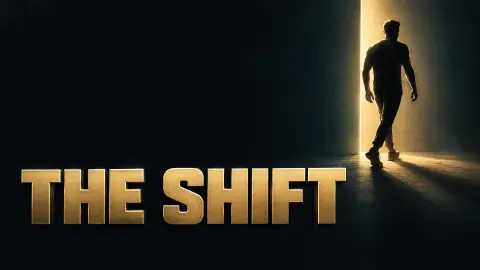
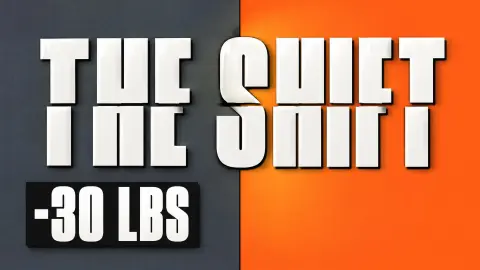
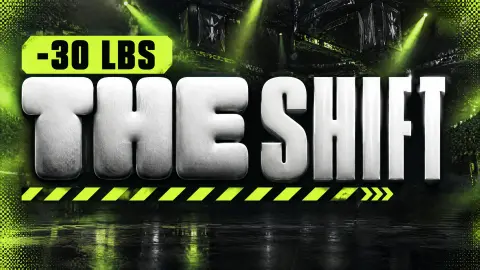
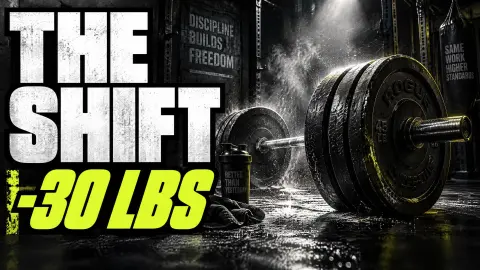
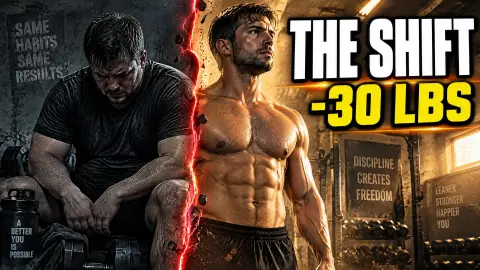
Claude Sonnet 5.5が8.20点で最高でした。粘土の「THE」と鏡面仕上げの「SHIFT」を対比させ、変化を表しています。GPT-6 Lunaは7.97点です。最下位はClaude Opus 5.5の6.53点で、1枚目は各文字を半分ずつずらしていて、印刷ミスのように見えます。Gemini 4 ArgonとGemini 3.8 Flashは、依頼主が書いていないジム向けのスローガンで背景を埋めました。
課題5:7つの情報を載せる求人ポスター
招聘海报:标题「一起把账算明白」,副标题「马来西亚 AI 公司,招两位财务」,要写上公司名 Northwind Labs Sdn Bhd、月薪 RM6000-9000、地点吉隆坡 Bangsar、投递邮箱 jobs@northwindlabs.my、截止 10 月 15 日。标题最大,邮箱最小。(求人ポスター。タイトル、サブタイトル、会社名、月給、勤務地、応募用メールアドレス、締め切りを載せる。タイトルを最大、メールアドレスを最小に。)
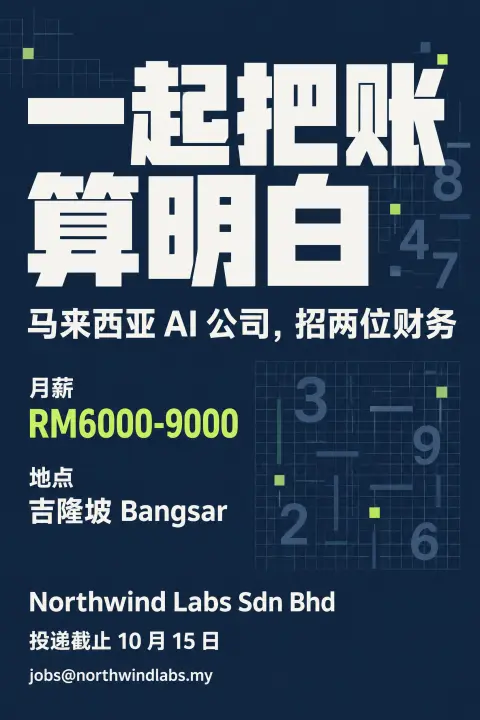
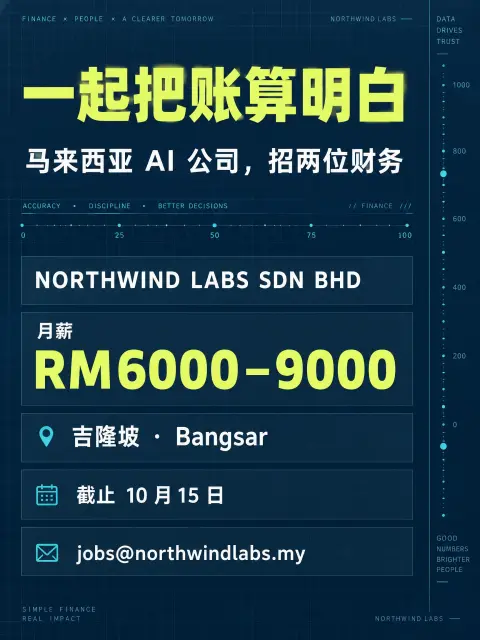
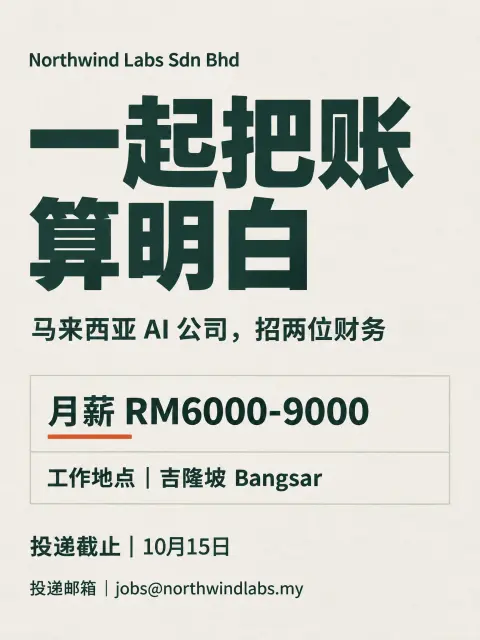
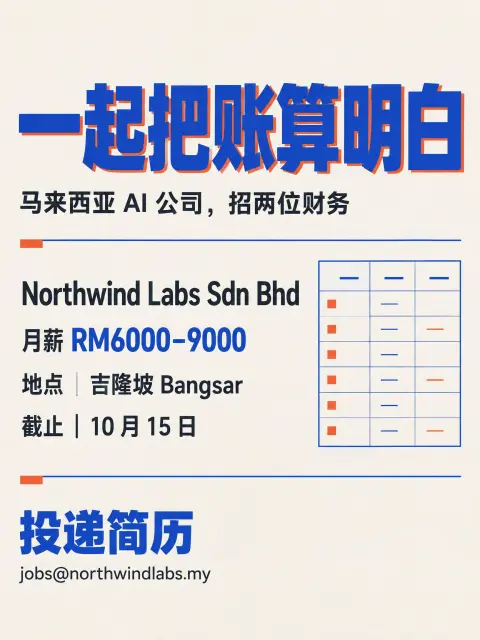
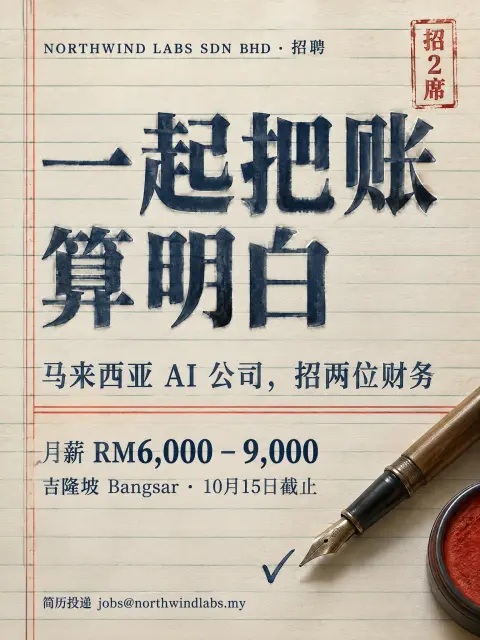
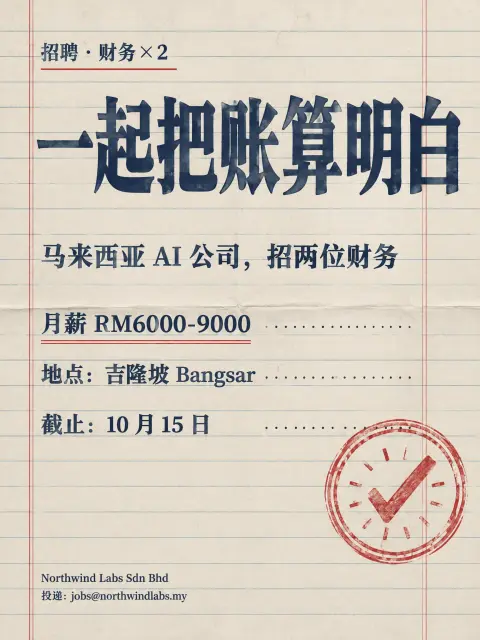
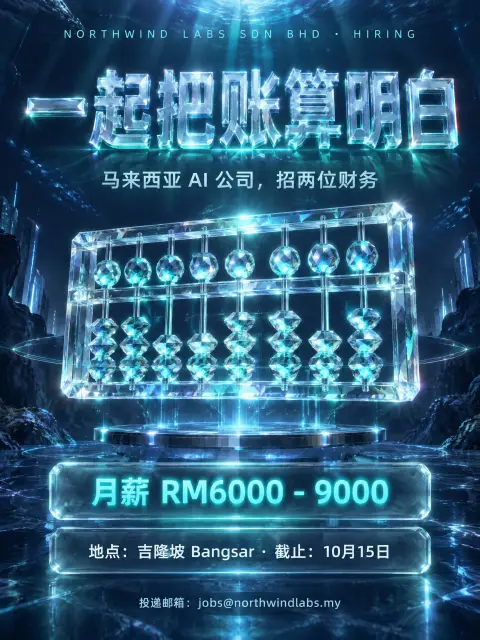
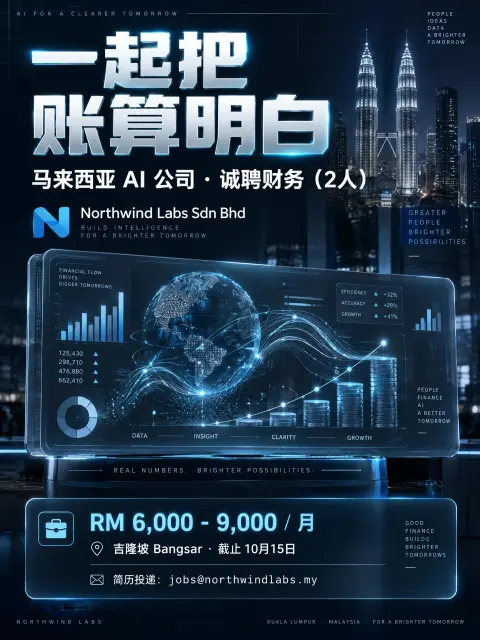
この課題で、モデルの差が最もはっきり出ました。Claude Sonnet 5.5は帳簿用紙風のデザインに赤いスタンプを押し、7つの情報とサイズの順番をすべて守って7.92点です。最も低かったのはGemini 3.8 Flashの6.12点で、1枚目は英語のスローガン、ロゴ、架空の数字が並ぶダッシュボードでポスターを埋め、依頼主のサブタイトルも変えていました。Claude Opus 5.5は3回とも本番のトークン上限で失敗しました。上限を2倍にすると、この課題で最高の8.95点のデザインを作りました。似たような紙にインクで書いたタイトルに、印章と万年筆を添えています。
課題6:コーヒーカップスリーブ
Uma capa para o copo de café para viagem da minha cafeteria em Belo Horizonte, a Grão de Ouro. Tem que ter o slogan "Café de verdade, sem pressa" e "Desde 1998".(自分のカフェのテイクアウト用カップのスリーブ。店名、スローガン、「1998年から」を入れる。)
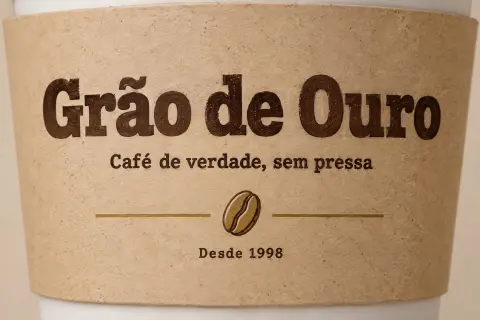
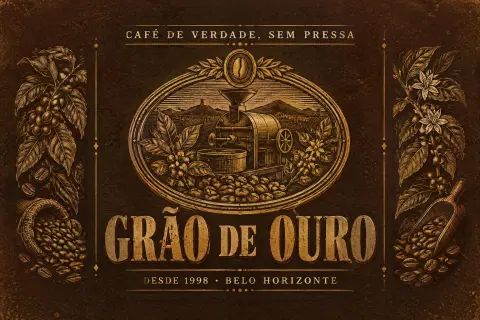
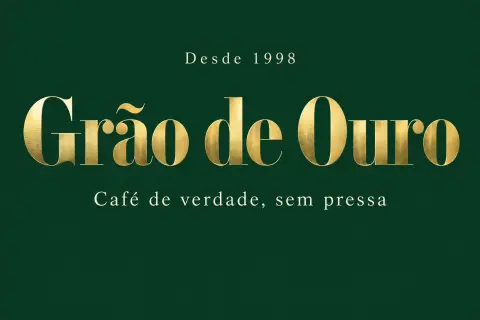
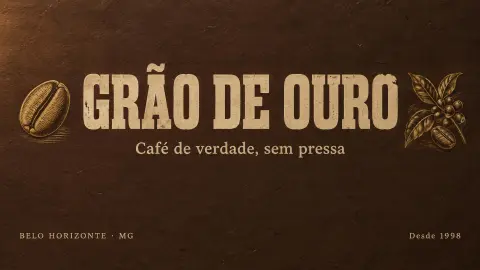
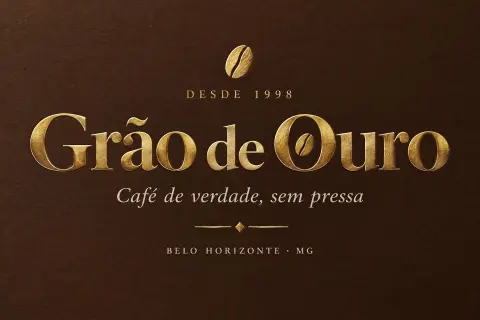
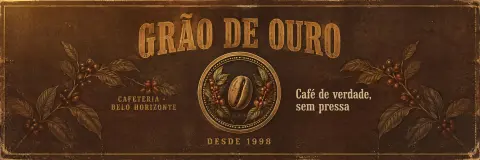
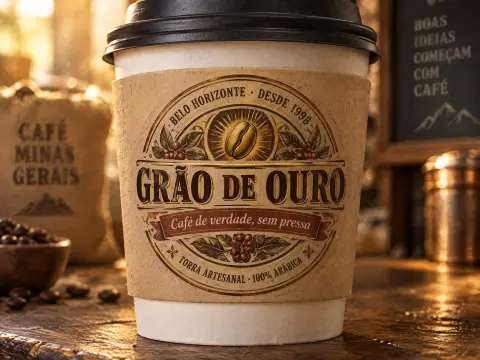
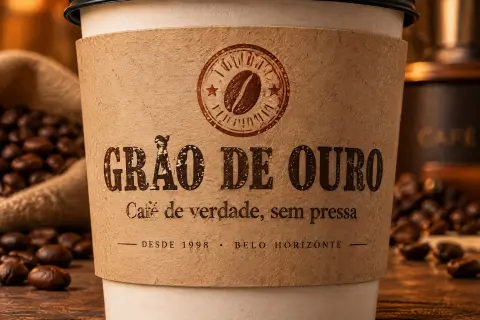
Claude Opus 5.5は完成した2回で8.97点でした。金箔のセリフ体の文字に、コーヒー豆の形のOを組み合わせています。続いたのはGPT-5.6 Terra(8.30点)とClaude Sonnet 5.5(8.38点)です。Gemini 3.8 Flashの1枚目はGRÃOのチルダを間違えて描き、店名が「GRÁO」に近く読めます。Gemini 4 Argonは「100% ARÁBICA」など、カフェが言っていない主張を加えました。金箔の文字だけを作るなら、ゴールド文字ジェネレーターを試してください。
第3層:デザインの判断
課題7:要件が矛盾するナイトクラブのロゴタイプ
I want an extremely minimal, quiet, almost invisible wordmark for my nightclub — but it also has to scream across a dark street from 50 metres away and feel expensive. The name is VOID.
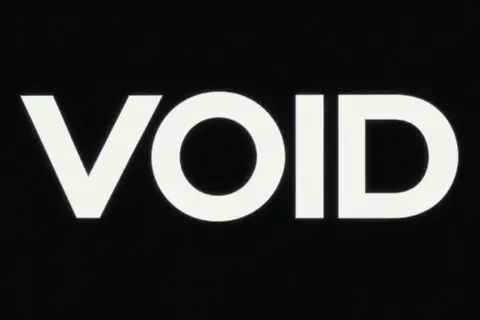
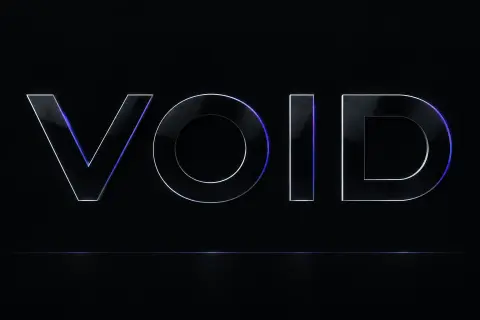
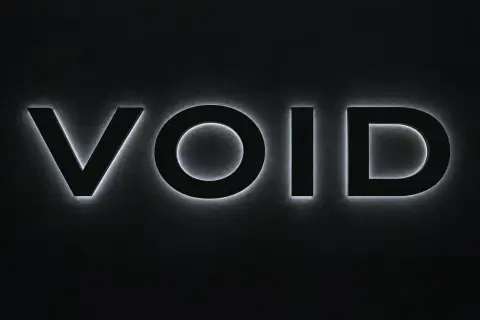
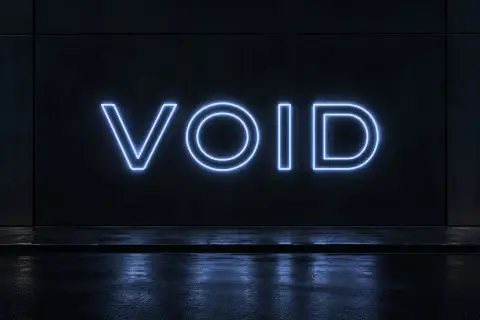
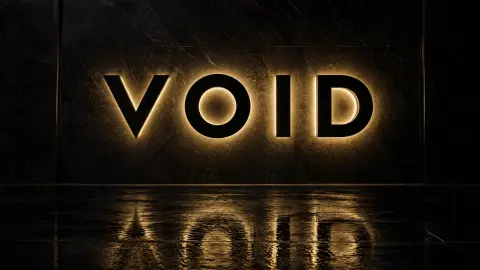
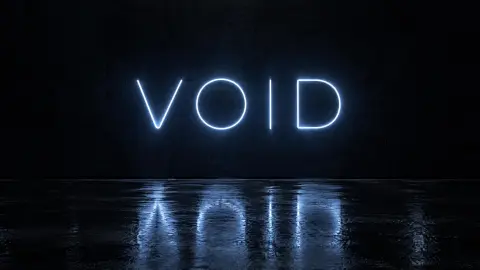
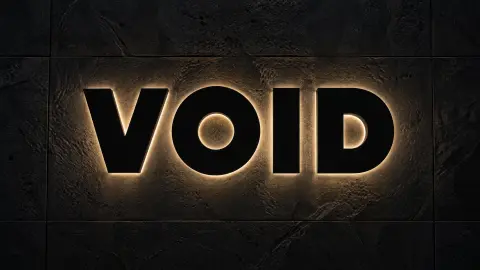
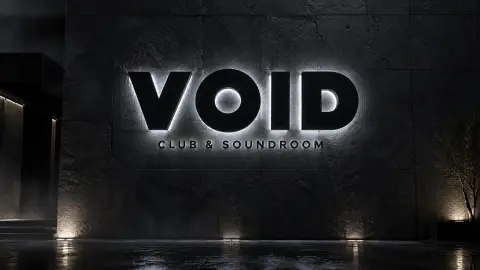
最も強いデザインは、バックライトで矛盾を解決していました。黒い壁に黒い文字を置き、近くでは消えるように見え、夜には光ります。これを最もうまくやったのはGemini 4 Argon(8.13点)、Gemini 3.8 Flash(8.05点)、Claude Opus 5.5(7.88点)です。最下位はGPT-6.1 Terraの5.48点で、1枚目は黒地に白い太字をフラットに置いただけでした。目立ちはしますが、静かでも高級でもありません。GPT-5.6 Terraは5.90点です。光る看板なら、店舗看板メーカーで光る店の看板から始められます。
課題8:学術誌の表紙
Cover art for a peer-reviewed paper on cryo-EM structural determination of amyloid fibrils. Title: CONFORMATIONAL POLYMORPHISM. It has to look like it belongs on the cover of Nature, not like a startup pitch deck.
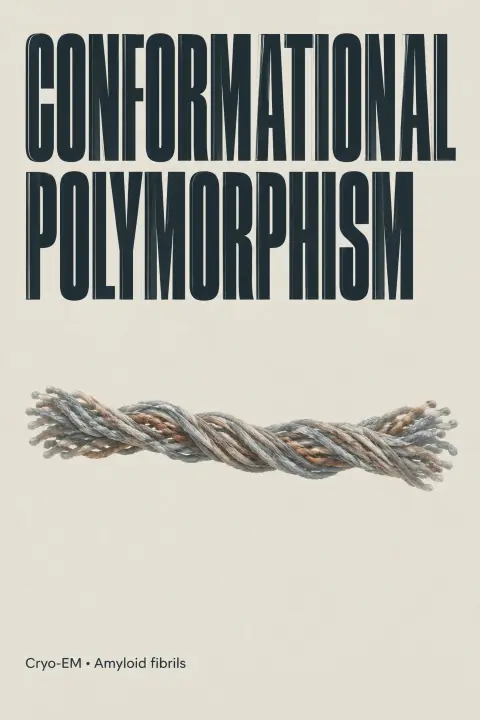
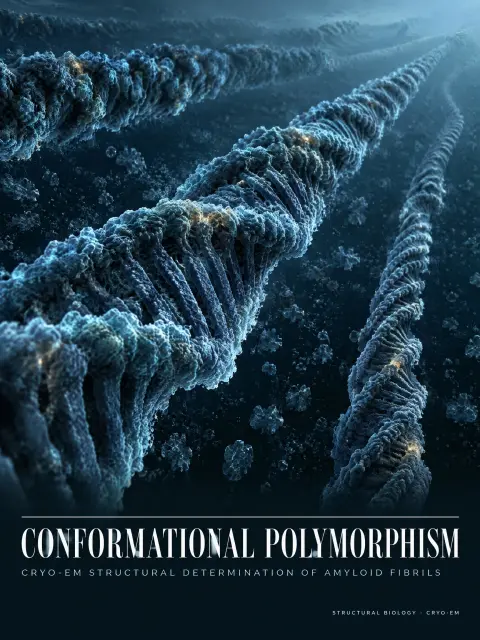
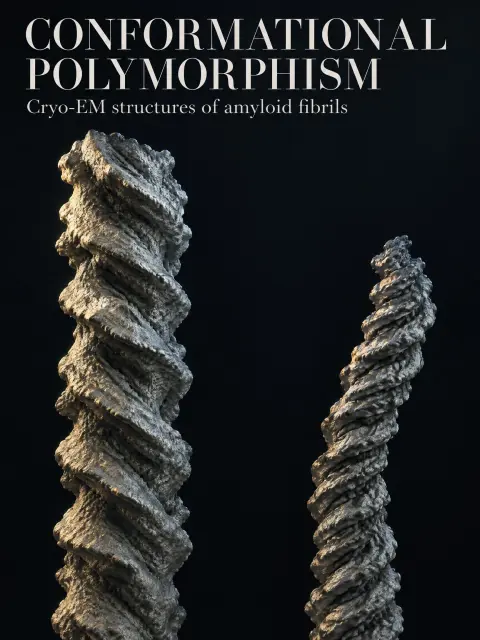
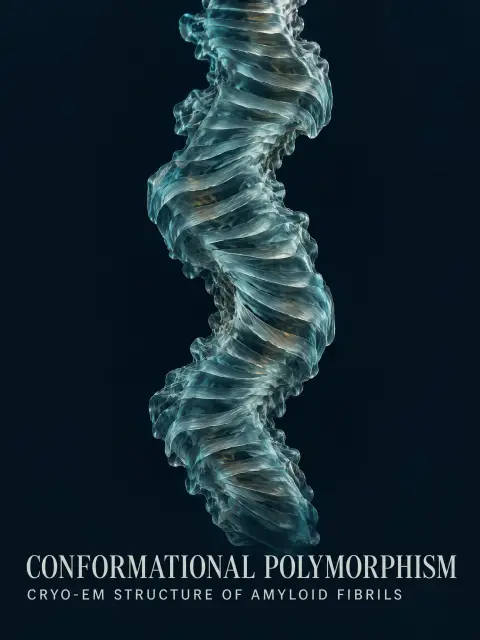
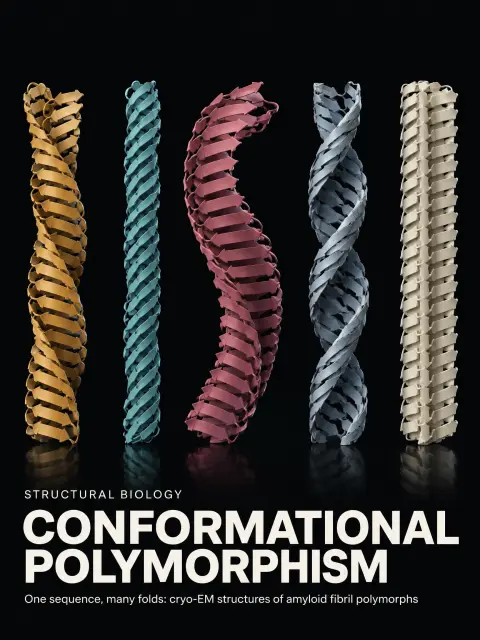
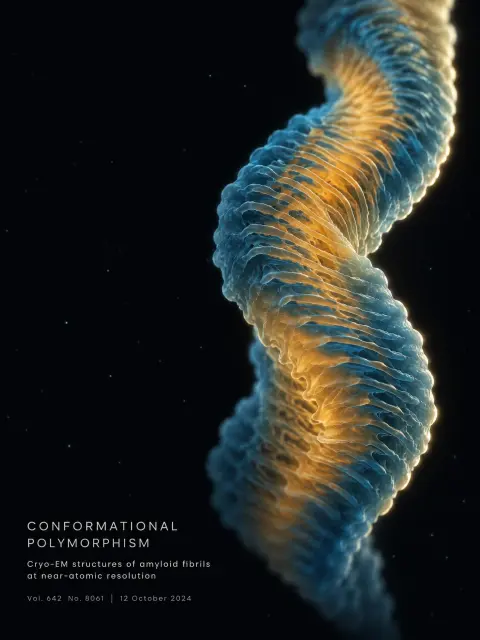
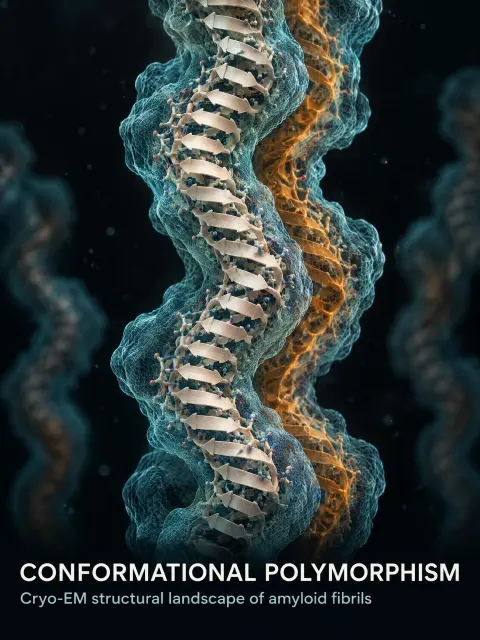
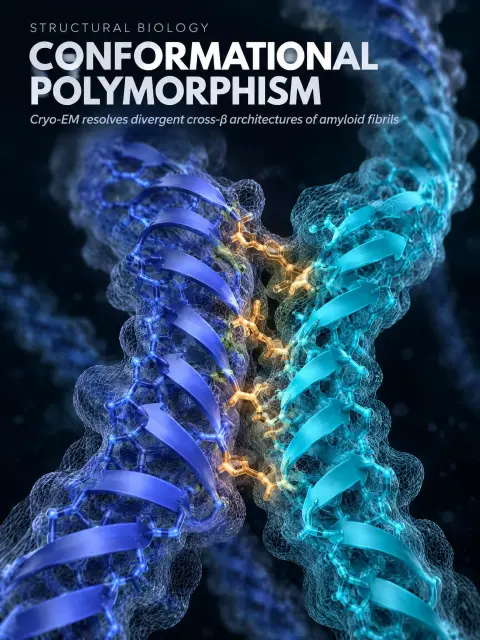
最も高かったのはGPT-6.1 Sol(7.65点)、GPT-5.6 Terra(7.47点)、GPT-6 Luna(7.43点)で、控えめなセリフ体のタイトルとガラスのような線維を描いています。いくつかのデザインは線維をはしご状の二重らせんとして描き、DNAのように見えました。アミロイドがテーマの表紙では、科学的な誤りです。Claude Sonnet 5.5は巻、号、日付をでっち上げました。Claude Opus 5.5は3回とも本番の上限で失敗しました。
課題9:2つの世代に向けたタトゥースタジオの看板
A shop sign for my tattoo studio called INKWELL. It should still feel welcoming to my grandmother's generation.
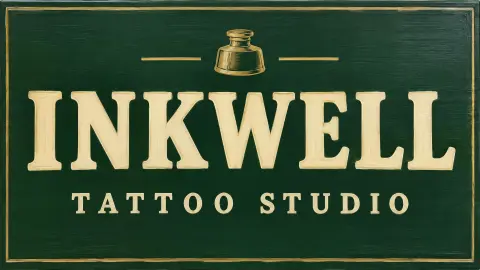
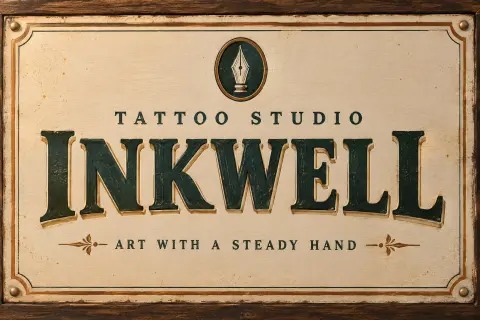
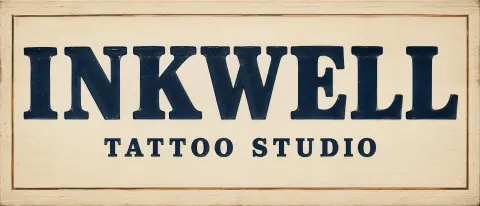
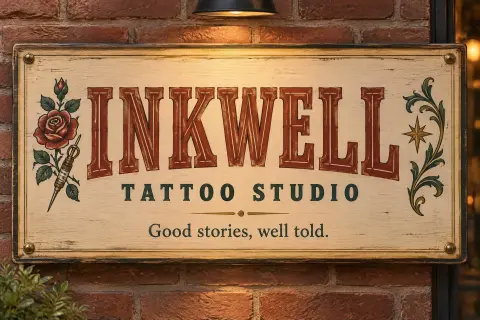
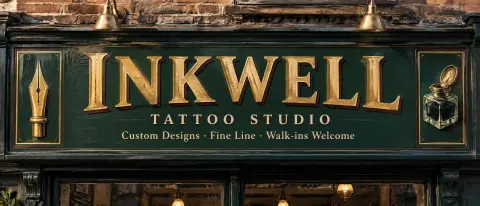
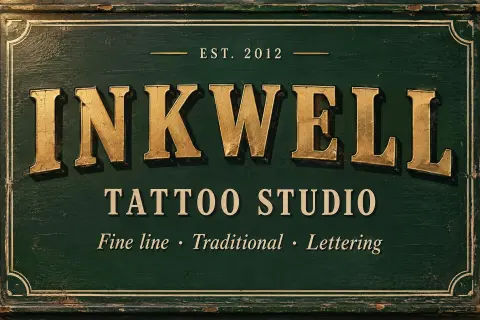
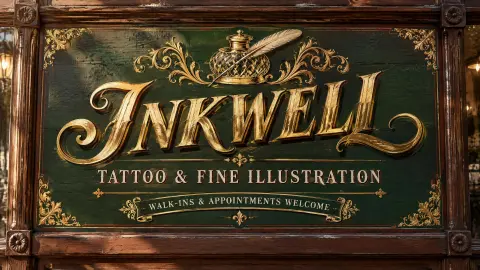
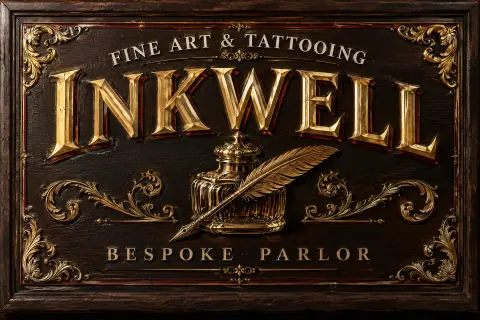
この課題では、依頼にない文字がいたるところにありました。キャッチコピー、サービス一覧、「Walk-ins welcome」、そして2つの架空の創業年です。Claude Opus 5.5が8.25点で最高、GPT-6 Lunaが7.95点でした。最下位はGemini 4 Argonの6.37点で、1枚目は装飾的な大文字のIがJに見え、店名が「JNKWELL」と読めます。店名と「Tattoo Studio」だけを載せたデザインは正確でしたが、地味なものが多くありました。
第4層:言語と文化
課題10:日本のかき氷屋台の看板
夏祭りの屋台の看板を作ってください。「かき氷」と書いて、昭和レトロな駄菓子屋の雰囲気で。提灯の灯りみたいな温かさがほしい。
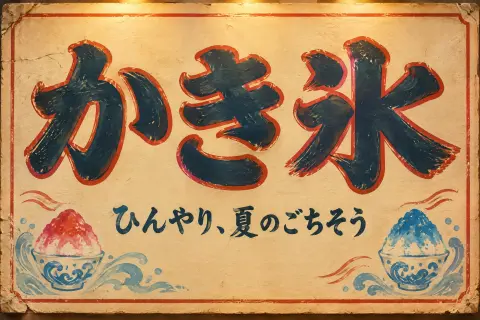
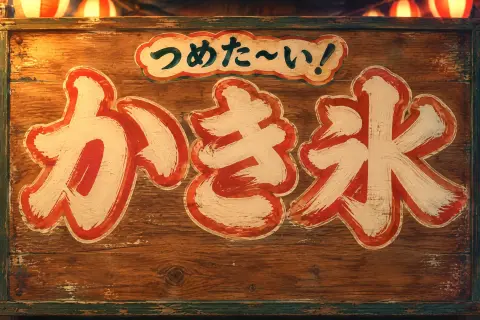
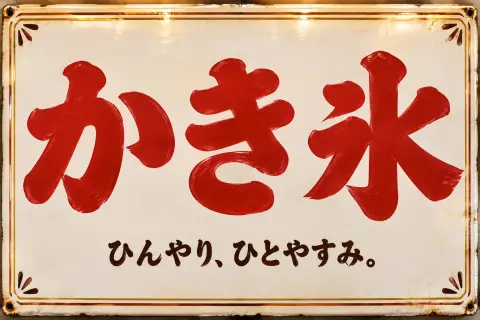
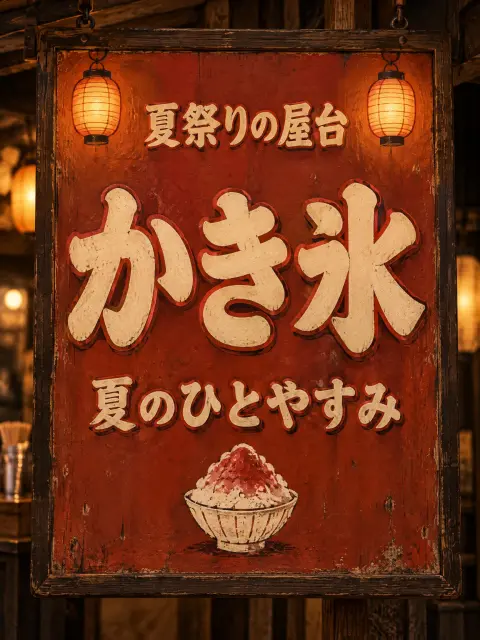
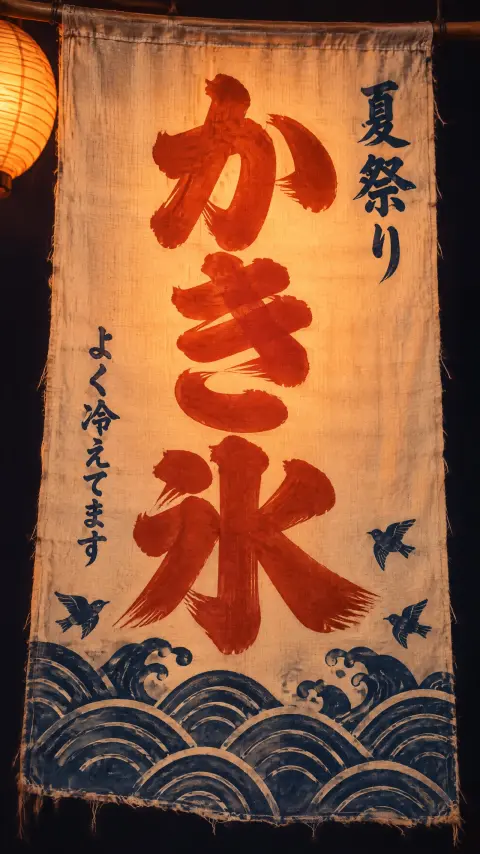
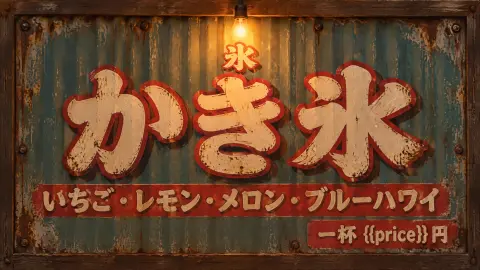
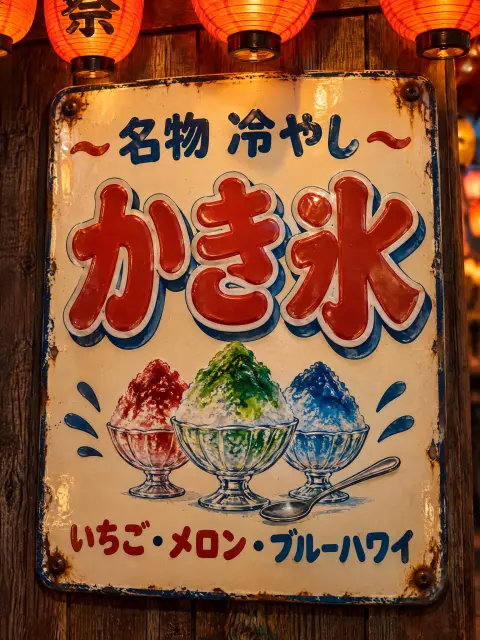
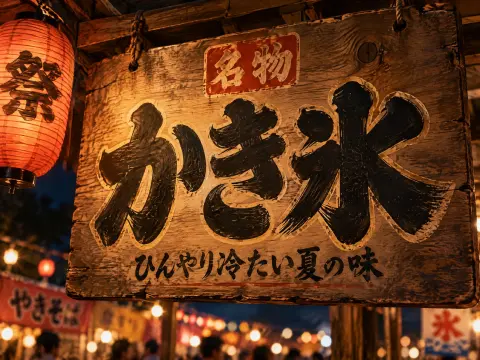
どのモデルも「かき氷」を正しく書きました。最も高かったのはClaude Opus 5.5(8.55点)、Gemini 4 Argon(8.38点)、GPT-5.6 Terra(8.27点)で、染め布ののぼりやホーロー看板を描いています。多くのデザインが「ひんやり」のような短いフレーズやシロップの味の一覧を加え、これは減点の対象になりました。2枚のデザインは{{price}}をそのまま印刷し、1枚は価格をでっち上げていました。
課題11:ドイツのベーカリーの開店看板
Ein Schild für die Neueröffnung unserer Bäckerei „Großmanns Backstube" in Leipzig. Öffnungszeiten: Mo–Sa 6:30–18 Uhr, So 7–12 Uhr. Gemütlich, aber nicht kitschig.(私たちのベーカリーの開店看板。店名と営業時間を入れる。居心地はよく、でもキッチュではなく。)
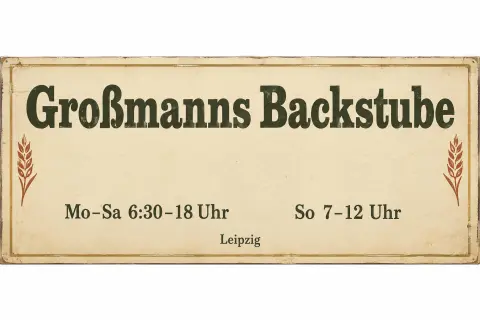
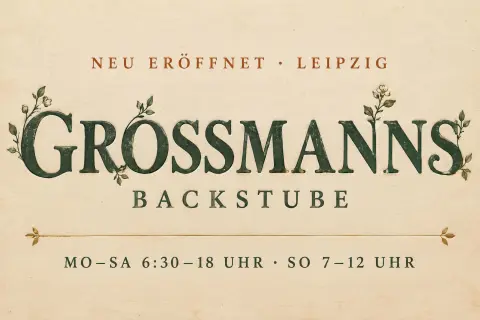
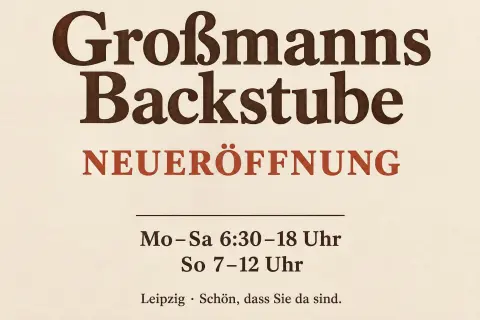
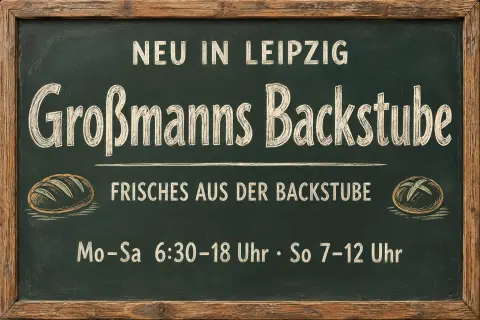
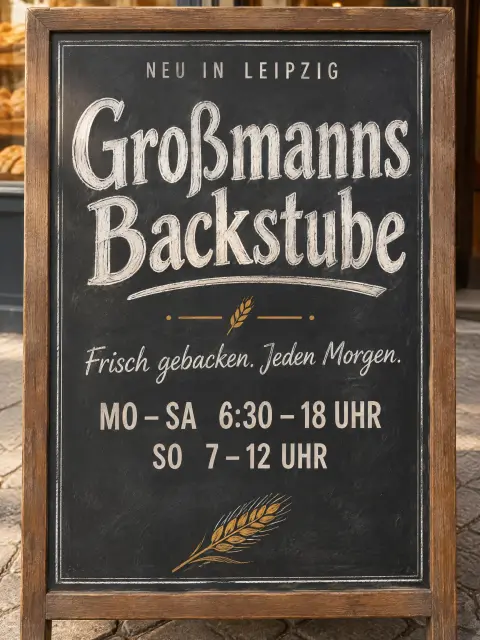
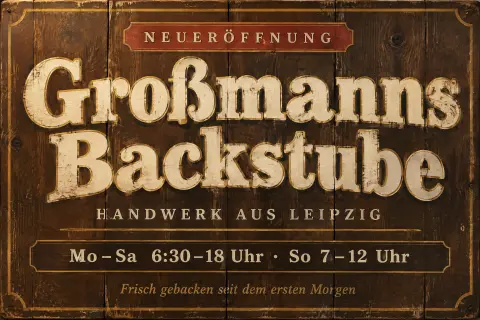
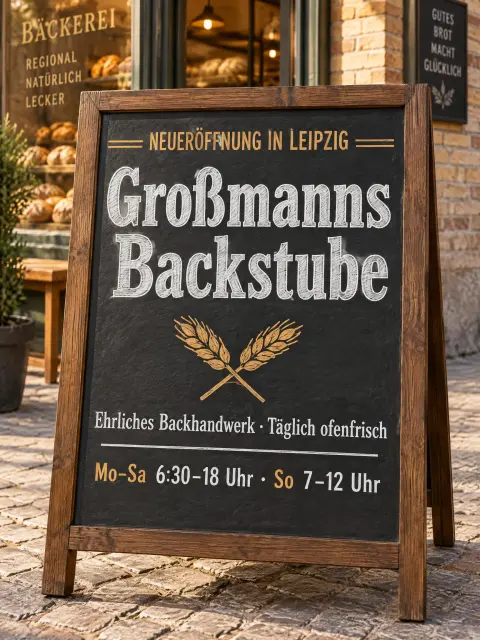
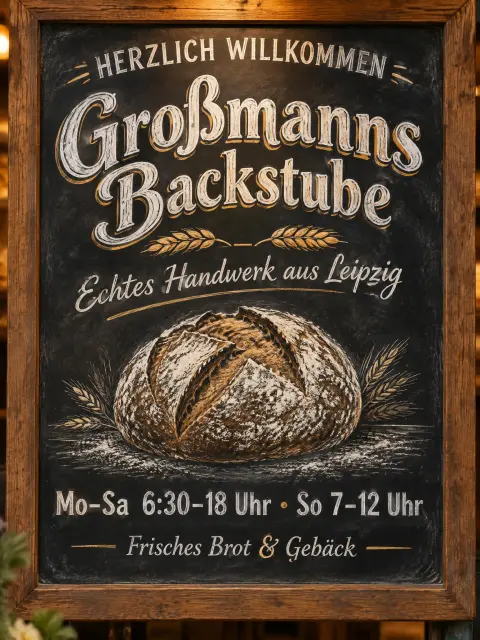
どのモデルも、Großmannsをßを使って正しくつづりました。Claude Sonnet 5.5が8.03点で最高で、使い込まれた風合いの縁取り文字を木の板に載せています。GPT-6.1 Terra(6.32点)とGPT-6.1 Sol(6.62点)は、温かみのないフラットなデジタル書体で看板を組みました。Claude Sonnet 5.5の3枚はすべて、「Frisch gebacken seit dem ersten Morgen」(最初の朝から焼きたて)のような、ベーカリーが書いていないスローガンを加えており、Gemini 3.8 Flashも同様でした。Claude Opus 5.5は3回とも本番の上限で失敗しました。
課題12:死者の日の招待状
Invitación para la reunión familiar de Día de Muertos en casa de la abuela Rosa. Domingo 1 de noviembre de 2026, 7 de la noche, Calle Hidalgo 45, Oaxaca. Algo cálido y respetuoso, no de disfraz.(Rosaおばあちゃんの家で開く、死者の日の家族の集まりへの招待状。日付、時刻、住所を入れる。温かく敬意のあるもので、仮装パーティーのようにはしない。)
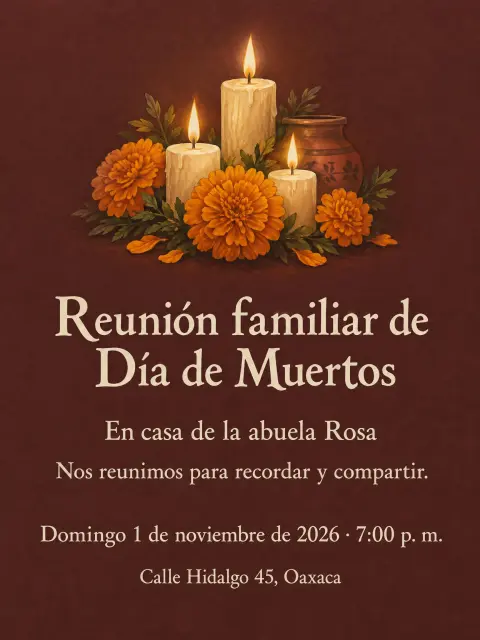
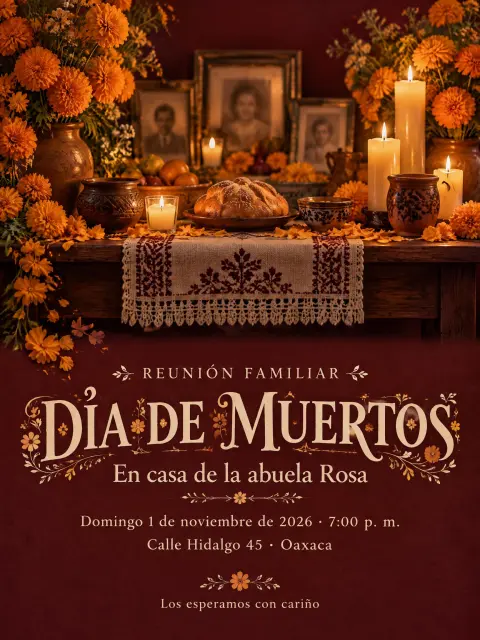
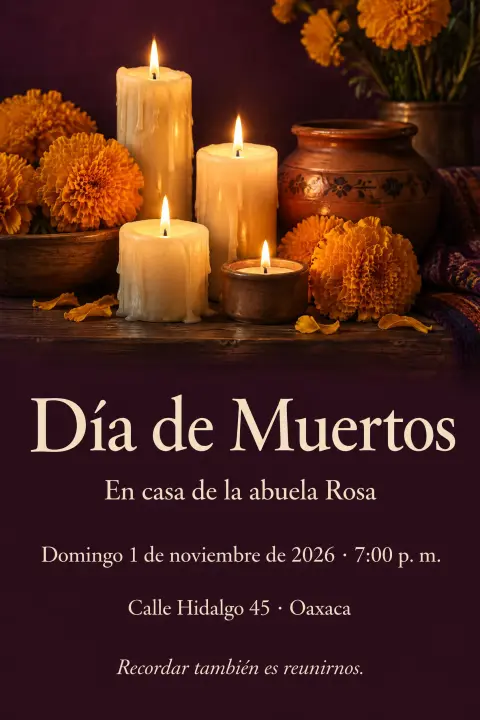
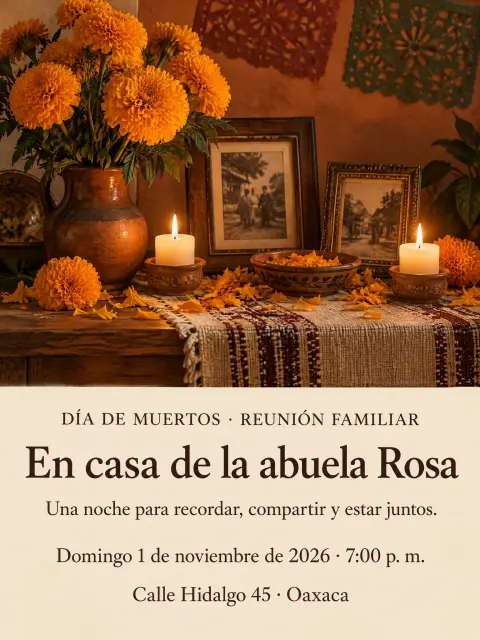
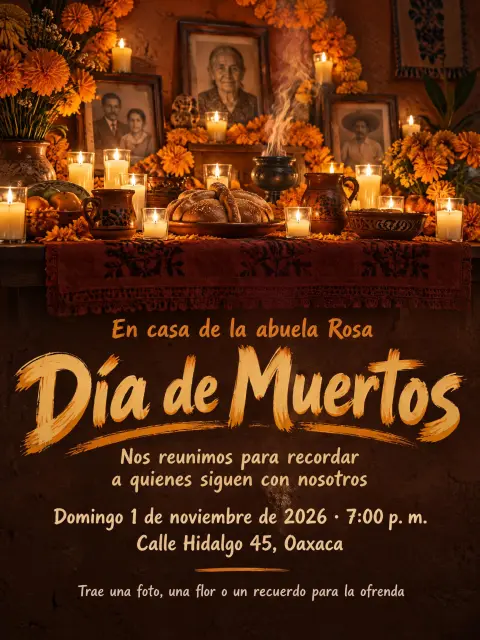
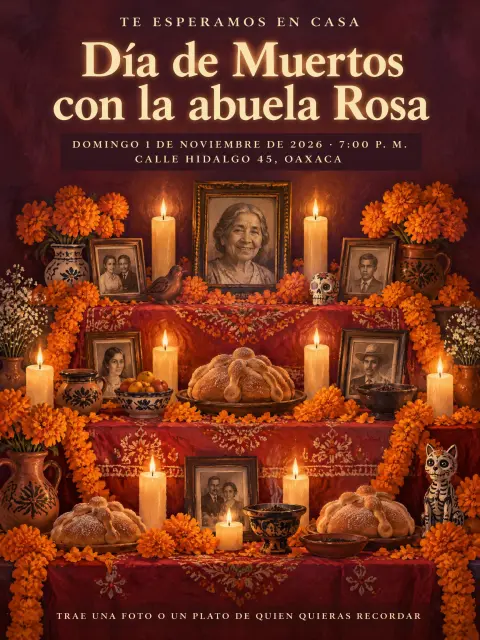
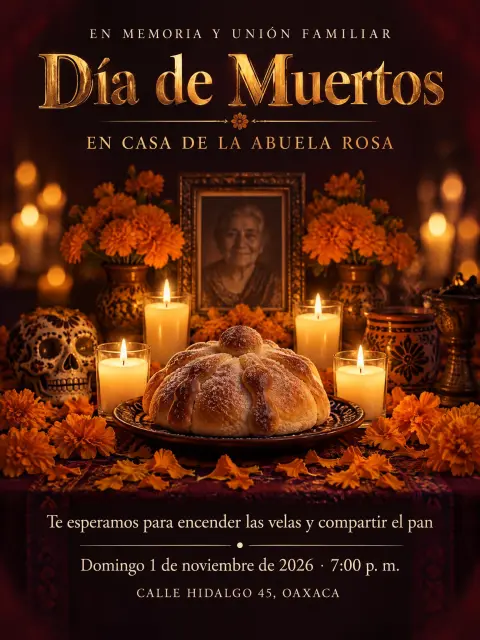
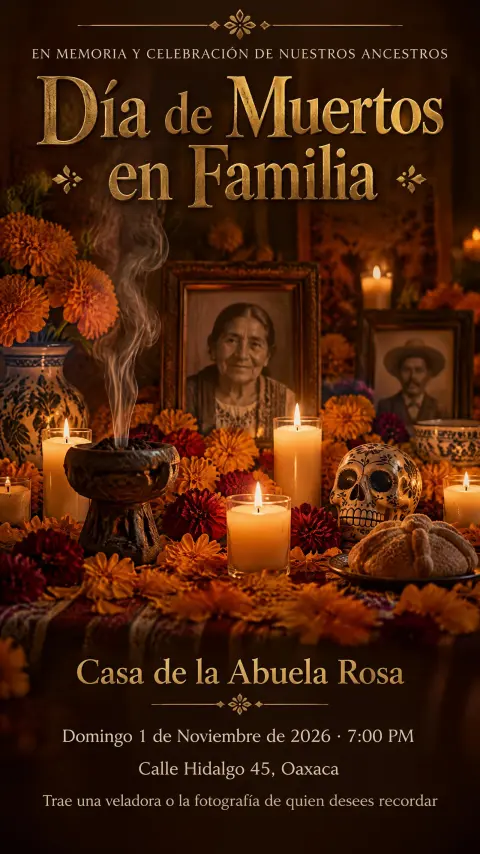
集まりをハロウィンの仮装パーティーにしたデザインはなく、どのデザインも日付と住所を残していました。ほぼすべてが「7 de la noche」を「7:00 p. m.」に変えています。最も高かったのはGPT-5.6 Terraの8.22点です。いくつかのデザインには、もっと気づきにくい問題がありました。祭壇の中央、「abuela Rosa」のすぐ隣に年配の女性の肖像を置いていて、Rosa本人が亡くなったように読めてしまいます。Claude Opus 5.5は3回とも本番の上限で失敗しました。
予算を増やしたClaude Opus 5.5
FontVibeは、1回のデザイン提案の出力を、思考部分も含めて6,600トークンまでに制限しています。Claude Opus 5.5はほかのどのモデルよりも長い提案を書きました。36回のうち19回で提案がこの上限に達し、17回は途中で切れて失敗、2回はそれでも完成しました。さらに1回は別の理由で失敗しています。提案は上限内でしたが、2つ目のステップの画像への指示が壊れた出力で返ってきました。ほかのモデルで上限に達したのはGPT-6 Lunaの提案1回だけで、それも完成しています。
途中で切れなかった場合にOpusがどうなるかを見るため、失敗した18回だけを、2つの出力上限をどちらも2倍にし、ほかは何も変えずに再実行しました。18回すべてが完成しました。そのうち13回は提案に6,600トークンを超えて使い(中央値7,286、最長8,890)、提案時間の中央値は76秒でした。この18枚のスコアは8.10点で、Opusの36枚全体では8.04点(95% CI 7.70–8.30)です。12問すべての依頼文でほかのモデルと依頼文ごとに比べると、この36枚はGPT-5.6 Terra(+0.46)、Claude Sonnet 5.5(+0.60)、GPT-6.1 Sol(+0.68)、Gemini 3.8 Flash(+0.71)、GPT-6.1 Terra(+0.96)よりはっきり高く、GPT-6 Luna(+0.35、95% CI −0.06〜+0.71)やGemini 4 Argon(+0.48、−0.05〜+0.98)とは差がつきませんでした。
ほかのモデルには大きな予算を与えていないので、この再実行はメインの順位には入れていません。6,600トークンという上限は、FontVibeが自社の本番用に定めたもので、モデルの限界ではありません。再実行からわかるのは、予算が十分ならOpusは毎回完成し、質も保たれるということです。その代わり、コストは高く、待ち時間も長くなります。メインの表の平均は8問の依頼文での18枚によるもので、失敗した依頼文の多くは、計画すべき文字が多い第2〜4層のものでした。そのため、この平均は易しい依頼文に偏っており、メインの表で順位に入れていないのはこのためです。
依頼主ではない人によるブラインド選択
FontVibeの創業者が、課題ごとに各モデルのデザインを1枚ずつ、ランダムな順番でモデル名を伏せて見て、自分なら使う1枚を選びました。12回の選択の内訳は、Gemini 3.8 Flashが4回、Claude Sonnet 5.5が3回、GPT-5.6 Terraが2回、Gemini 4 Argonが2回、Claude Opus 5.5が1回です。GPT-6 Lunaと2つのGPT-6.1モデルは一度も選ばれませんでした。
課題ごとに彼が見た8枚のうち、彼の選んだデザインが審査員の最高スコアだったのは12課題のうち2課題で、その課題全体での最高スコアのデザインだったことは一度もありません。この違いには明確な原因が1つあります。彼が選んだ12枚のうち8枚に、依頼文にない文字が入っていたのです。文字表現と見栄えでは、彼が選んだデザインはほぼ毎回7〜9点で、審査員もこれらを視覚的に強いデザインと見ていたことがわかります。点を落としたのは情報の項目でした。
彼はこの差を次のように読んでいます。どの依頼文でも彼は依頼主ではなかったので、第一印象で選んだ。デザインを必要とする依頼主は、まず雰囲気を、次に細部を見て、間違った文字や依頼にない文字を重大なエラーとして扱う。だから順位は評価基準のスコアで決め、この選択は参考にとどめています。第一印象で選ぶ人にとってのリスクも、ここに表れています。最初に目を引くデザインは、自分が書いていない文字が加えられたデザインであることが多いのです。
各モデルのまとめ
- Claude Opus 5.5:文字表現と見栄えは最高で、依頼にない行も少ない(1枚あたり0.22行)。提案が最も長く、思考も最も長いため、FontVibeの本番用より広い出力上限が必要。最も遅く、コストも飛び抜けて高い。急がない複雑な仕事に向いている。
- GPT-6 Luna:コストパフォーマンスが最も高い。質はトップのグループで、毎回完成し、可読性が高く、依頼にない行が少なく、価格は大差で最も安い。文字表現は良いものの、記憶に残るほどではない。
- GPT-5.6 Terra:速くてバランスが良い。第4層と日常的な依頼の大半で強く、第3層が最も弱い。難しい依頼文に、地味な書体で応えることが多かった。
- Gemini 4 Argon:素材感はこのテストで最も豊かな部類で、依頼にない行は1枚あたり1.56行。
- Claude Sonnet 5.5:提案が最も速く、文字表現も強いが、プレースホルダーをそのまま印刷した数が最も多い(5枚)。
- GPT-6.1 Sol:最も読みやすいデザインで、依頼にない行も少ないが、文字表現は地味で、2つのステップがどちらも遅い(合わせて約87秒)。
- Gemini 3.8 Flash:見た目は強いが、依頼にない文字が最も多く(1枚あたり2.36行)、プロバイダーのエラーが出た唯一のモデル(8回)。
- GPT-6.1 Terra:文字は最もクリーンで、デザインは最も地味。
このテストの限界
- 審査員はClaude Opus 5.5で動いており、これはテスト対象のモデルの1つでもあります。画像は匿名でしたが、審査員と出場モデルの1つは同じモデルで、審査員がそのデザインをひいきするかどうかは検証していません。
- 各依頼文の採点は1回だけで、1人の審査員が1回で行いました。採点の繰り返しも、2人目の審査員もありません。
- Claude Opus 5.5のメインのスコアは8問の依頼文での18枚によるもので、その多くは易しい依頼文です。
- すべてのデザインを1つの画像モデルで描画しました。別の画像モデルなら、デザイナーの指示がどれだけ効くかが変わる可能性があります。
- 各モデルは各依頼文を3回実行し、各実行で描画したのは提案した3つの方向性のうち1つ目だけです。依頼文が12問なので、モデル間の差の多くは小さすぎて見分けられません。28組の比較では、多重比較の補正を行っていません。
- 採点基準は、文字を含むデザインが対象です。文字のない画像はテストしていません。
- すべてのモデルで、FontVibeの本番のプロンプトと上限を使いました。ほかのアプリのプロンプトや上限なら、別のモデルが有利になる可能性があります。
- 結果は、2026年10月30日時点のこれらのモデルのバージョンについてのものです。
すべてのデザインはFontVibeで公開しており、すべてのスコアに書面の理由があります。依頼文、すべての提案、画像生成の指示、スコアと理由は、オープンデータセットAI Design Benchmark(CC BY 4.0)で公開しています。すべての試行と、本記事のすべての表を再計算できるスクリプトも付いています。FontVibeの本番プロンプトは公開していませんが、必要な研究者はhello@fontvibe.aiまでお問い合わせください。
付録:すべてのスコア
完成した実行での、モデル・課題ごとの総合スコアの平均です(完成した実行が3回未満の場合は、括弧内にその回数を記載)。
| 課題 | GPT-6.1 Terra | GPT-5.6 Terra | GPT-6.1 Sol | GPT-6 Luna | Claude Opus 5.5 | Claude Sonnet 5.5 | Gemini 4 Argon | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|---|---|
| 1. コーヒー焙煎所のロゴタイプ | 6.62 | 8.13 | 6.43 | 8.05 | 8.38 | 7.50 | 7.53 | 7.92 |
| 2. 恐竜の誕生日ポスター | 8.43 | 8.33 | 8.73 | 8.17 | 8.20 | 7.03 | 6.48 | 7.33 |
| 3. 卒業パーティーのポスター | 6.37 | 7.03 | 7.07 | 7.28 | 7.50(1) | 7.13 | 8.40 | 8.28 |
| 4. YouTubeサムネイル | 7.18 | 7.12 | 7.27 | 7.97 | 6.53 | 8.20 | 7.88 | 7.75 |
| 5. 求人ポスター | 7.20 | 6.98 | 7.30 | 7.43 | 失敗 | 7.92 | 7.50 | 6.12 |
| 6. コーヒーカップスリーブ | 7.83 | 8.30 | 7.58 | 7.93 | 8.97(2) | 8.38 | 7.27 | 7.25 |
| 7. ナイトクラブのロゴタイプ | 5.48 | 5.90 | 6.67 | 7.25 | 7.88 | 7.28 | 8.13 | 8.05 |
| 8. 学術誌の表紙 | 6.22 | 7.47 | 7.65 | 7.43 | 失敗 | 6.63 | 7.28 | 6.68 |
| 9. タトゥースタジオの看板 | 7.53 | 7.80(2) | 7.33 | 7.95 | 8.25(2) | 6.78 | 6.37 | 6.38 |
| 10. かき氷屋台の看板 | 8.20 | 8.27 | 7.78 | 7.45 | 8.55(1) | 6.98 | 8.38 | 7.80 |
| 11. ベーカリーの開店看板 | 6.32 | 7.43 | 6.62 | 7.25 | 失敗 | 8.03 | 7.78 | 7.02 |
| 12. 死者の日の招待状 | 7.57 | 8.22 | 7.80 | 8.08 | 失敗 | 7.32 | 7.68 | 7.40 |
すべての組み合わせの比較
各組は、2つのモデルがどちらもデザインを完成させた依頼文で比べています。依頼文ごとのスコアの差(前のモデルから後のモデルを引いたもの)の平均と、その95%信頼区間です。区間に0が含まれる場合、このテストでは2つのモデルに差がつかなかったことになります。
| モデル | 比較相手 | 依頼文数 | 差(95% CI) | はっきり高い側 |
|---|---|---|---|---|
| Claude Opus 5.5 | GPT-6 Luna | 8 | +0.28(−0.27〜+0.73) | 同率 |
| Claude Opus 5.5 | GPT-5.6 Terra | 8 | +0.42(0.00〜+0.96) | 同率 |
| Claude Opus 5.5 | Gemini 4 Argon | 8 | +0.48(−0.33〜+1.29) | 同率 |
| Claude Opus 5.5 | Claude Sonnet 5.5 | 8 | +0.62(−0.11〜+1.18) | 同率 |
| Claude Opus 5.5 | GPT-6.1 Sol | 8 | +0.68(+0.10〜+1.27) | Claude Opus 5.5 |
| Claude Opus 5.5 | Gemini 3.8 Flash | 8 | +0.44(−0.27〜+1.15) | 同率 |
| Claude Opus 5.5 | GPT-6.1 Terra | 8 | +0.83(+0.20〜+1.47) | Claude Opus 5.5 |
| GPT-6 Luna | GPT-5.6 Terra | 12 | +0.11(−0.19〜+0.43) | 同率 |
| GPT-6 Luna | Gemini 4 Argon | 12 | +0.13(−0.35〜+0.62) | 同率 |
| GPT-6 Luna | Claude Sonnet 5.5 | 12 | +0.25(−0.10〜+0.60) | 同率 |
| GPT-6 Luna | GPT-6.1 Sol | 12 | +0.33(+0.03〜+0.66) | GPT-6 Luna |
| GPT-6 Luna | Gemini 3.8 Flash | 12 | +0.36(−0.08〜+0.77) | 同率 |
| GPT-6 Luna | GPT-6.1 Terra | 12 | +0.61(+0.21〜+0.98) | GPT-6 Luna |
| GPT-5.6 Terra | Gemini 4 Argon | 12 | +0.02(−0.63〜+0.64) | 同率 |
| GPT-5.6 Terra | Claude Sonnet 5.5 | 12 | +0.15(−0.39〜+0.68) | 同率 |
| GPT-5.6 Terra | GPT-6.1 Sol | 12 | +0.23(−0.12〜+0.63) | 同率 |
| GPT-5.6 Terra | Gemini 3.8 Flash | 12 | +0.25(−0.38〜+0.78) | 同率 |
| GPT-5.6 Terra | GPT-6.1 Terra | 12 | +0.50(+0.21〜+0.81) | GPT-5.6 Terra |
| Gemini 4 Argon | Claude Sonnet 5.5 | 12 | +0.13(−0.28〜+0.55) | 同率 |
| Gemini 4 Argon | GPT-6.1 Sol | 12 | +0.21(−0.42〜+0.76) | 同率 |
| Gemini 4 Argon | Gemini 3.8 Flash | 12 | +0.23(−0.08〜+0.53) | 同率 |
| Gemini 4 Argon | GPT-6.1 Terra | 12 | +0.48(−0.25〜+1.16) | 同率 |
| Claude Sonnet 5.5 | GPT-6.1 Sol | 12 | +0.08(−0.47〜+0.60) | 同率 |
| Claude Sonnet 5.5 | Gemini 3.8 Flash | 12 | +0.10(−0.35〜+0.61) | 同率 |
| Claude Sonnet 5.5 | GPT-6.1 Terra | 12 | +0.35(−0.24〜+0.91) | 同率 |
| GPT-6.1 Sol | Gemini 3.8 Flash | 12 | +0.02(−0.55〜+0.57) | 同率 |
| GPT-6.1 Sol | GPT-6.1 Terra | 12 | +0.27(−0.02〜+0.60) | 同率 |
| Gemini 3.8 Flash | GPT-6.1 Terra | 12 | +0.25(−0.40〜+0.96) | 同率 |
採点基準
審査員への指示の要約です。審査員は、依頼文を書き、このデザインを使う依頼主の立場に立ちます。判断の順番は、頼んだものになっているか、すべての文字がそのまま使えるか、明示された、または無理なく読み取れる求めた雰囲気があるか、文字表現・素材・質感・線・色の作りはよいか、ひと目で心を動かすか、です。4つのスコアはそれぞれ自分の問いだけを扱い、1つの問題は、それが属するスコアで一度だけ減点します。
よくある質問
GPT-6.1 TerraはGPT-5.6 Terraよりデザインが上手ですか?
このテストではそうではありませんでした。依頼文ごとに比べると、GPT-6.1 TerraはGPT-5.6 Terraより10点満点で0.50点低く、95%信頼区間は−0.81〜−0.21で、12問のうち9問でスコアが下回りました。文字はよりクリーンでしたが、文字表現は平板で、見栄えも劣りました。2つのモデルは同じプロンプトと設定を使っています。この結果が示すのは、依頼文を読み、方向性を決め、画像への指示を書くという作業での出来であって、ほかのタスクでの出来ではありません。
デザイナーとして最も優れた言語モデルはどれですか?
デザインの質だけで見ると、このテストでは8つのモデルの大半に差がつきませんでした。はっきり劣っていたのはGPT-6.1 TerraとGPT-6.1 Solだけです。平均が最も高かったのはClaude Opus 5.5ですが、GPT-6 LunaやGemini 4 Argonよりはっきり上とは言えず、コストははるかに高く、時間もかかりました。GPT-6 Lunaは質がトップのグループに入り、毎回完成し、デザイン1枚あたり$0.005で、コストパフォーマンスは群を抜いて最高です。リアルタイムで使うなら、GPT-5.6 Terraが速くてバランスが取れていました。
AIデザイナーは文字をでっち上げますか?
はい。Gemini 3.8 Flashは、創業年、スローガン、架空の統計など、依頼文にない行をデザイン1枚あたり平均2.36行加えました。最も少なかったのはGPT-6.1 Terraで、1枚あたり0.17行です。情報で点を落とした理由として最も多かったのが、依頼にない文字でした。
AIデザイナーのコストはデザイン1枚あたりいくらですか?
2026年10月30日時点の各社の公開価格で、デザイン1枚にかかる言語モデル部分のコストの中央値は、GPT-6 Lunaが$0.005、GPT-6.1 TerraとGemini 3.8 Flashが$0.04、GPT-5.6 TerraとGPT-6.1 Solが$0.09、Gemini 4 Argonが$0.11、Claude Sonnet 5.5が$0.18、Claude Opus 5.5が$0.41でした。画像生成のコストは含みません。
これらのAIデザイナーを自分で試せますか?
FontVibeのデザインモードは、このテストと同じパイプラインを使っています。必要なものを説明するとデザインの方向性を提案し、選んだものを描画します。
コメント