GPT-6.1 Terra vs Claude e Gemini: teste de design
Dei a 8 modelos de linguagem da OpenAI, Anthropic e Google os mesmos 12 briefings, 3 rodadas cada, e avaliei os 287 designs às cegas.
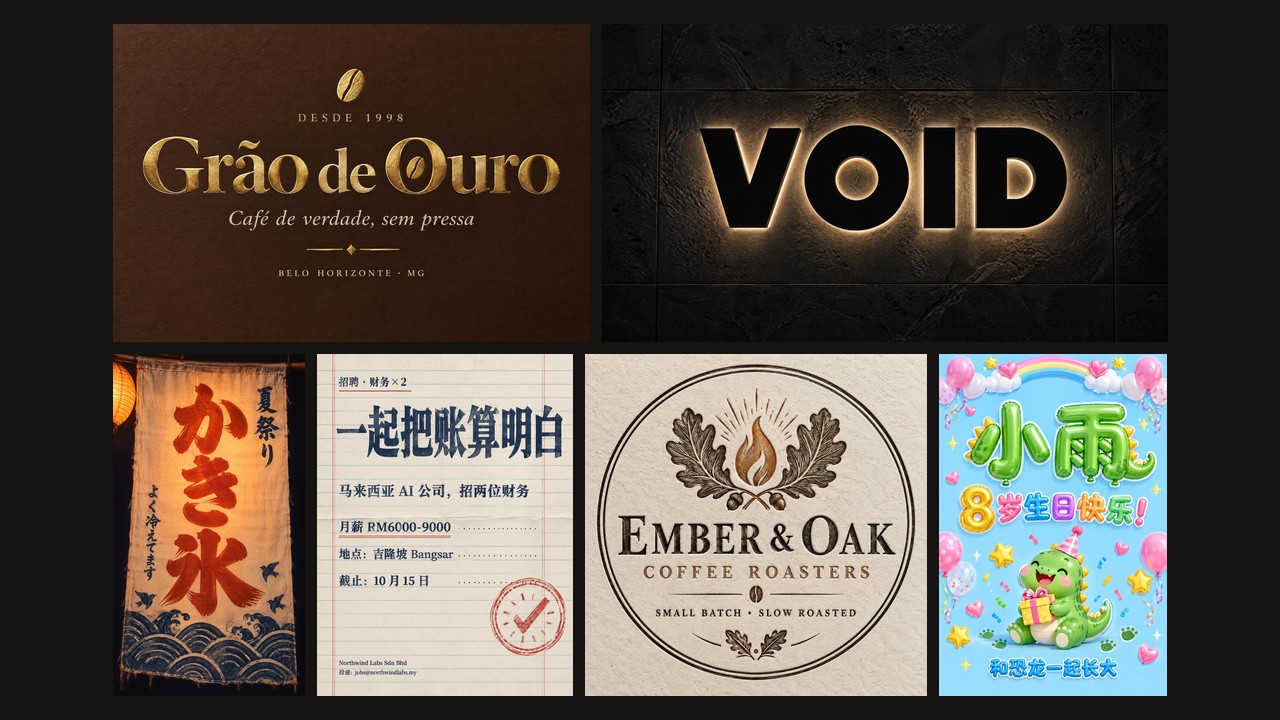
Quando você pede um design ao FontVibe, um modelo de linguagem faz o trabalho do designer antes de qualquer imagem ser desenhada. Ele lê o briefing, propõe três direções de design e depois escreve as instruções que o modelo de imagem renderiza. O GPT-6.1 Terra saiu em 26 de outubro de 2026, então testei se ele faz esse trabalho melhor que o GPT-5.6 Terra, o modelo que o FontVibe usa hoje, e contra outros seis modelos de linguagem da OpenAI, da Anthropic e do Google.
Todos os modelos receberam os mesmos 12 briefings, três vezes cada. O modelo de imagem foi o mesmo em todos os designs: GPT Image 2.5 Sunburst em 2K e qualidade Medium, o modelo que ficou em segundo no meu teste do Qwen Image 3.0 e no meu teste do Grok Imagine 2.0. A única coisa que mudou de um design para o outro foi qual modelo de linguagem fez o papel de designer. Os 287 designs receberam nota às cegas, com os nomes dos modelos escondidos.
Os resultados
| # | Modelo | Designs terminados | Geral (IC 95%) | Legibilidade | Lettering e acabamento | Informação e layout | Apelo | Linhas inventadas por design | Custo por design | Tempo mediano da proposta |
|---|---|---|---|---|---|---|---|---|---|---|
| – | Claude Opus 5.5 | 18 / 36 | 7.97 (7.40–8.46) | 8.7 | 8.0 | 7.4 | 7.8 | 0.22 | $0.41 | 65 s |
| 1 | GPT-6 Luna | 36 / 36 | 7.69 (7.50–7.88) | 9.1 | 7.2 | 7.5 | 7.2 | 0.36 | $0.005 | 44 s |
| 2 | GPT-5.6 Terra | 35 / 36 | 7.58 (7.14–7.97) | 8.7 | 7.5 | 7.0 | 7.5 | 0.46 | $0.09 | 29 s |
| 3 | Gemini 4 Argon | 36 / 36 | 7.56 (7.21–7.89) | 8.6 | 7.9 | 6.2 | 7.7 | 1.56 | $0.11 | 40 s |
| 4 | Claude Sonnet 5.5 | 36 / 36 | 7.43 (7.14–7.75) | 8.7 | 7.9 | 5.6 | 7.8 | 1.11 | $0.18 | 27 s |
| 5 | GPT-6.1 Sol | 36 / 36 | 7.35 (7.03–7.71) | 9.4 | 6.6 | 7.5 | 6.4 | 0.28 | $0.09 | 62 s |
| 6 | Gemini 3.8 Flash | 36 / 36 | 7.33 (6.94–7.69) | 8.8 | 7.7 | 5.4 | 7.7 | 2.36 | $0.04 | 32 s |
| 7 | GPT-6.1 Terra | 36 / 36 | 7.08 (6.59–7.56) | 9.1 | 6.5 | 7.0 | 6.1 | 0.17 | $0.04 | 37 s |
As notas vão até 10 e são a média de todos os designs que terminaram. O Claude Opus 5.5 não entra no ranking: ele terminou designs em só 8 dos 12 briefings, a maioria os mais fáceis, então a média dele não é comparável com a dos outros (como ele se compara nos mesmos briefings). Os intervalos de confiança de 95% vêm de reamostragem dos briefings, porque as três rodadas de um briefing compartilham o mesmo briefing e a mesma passada de avaliação. Dois modelos só contam como diferentes quando o intervalo da diferença entre eles, briefing por briefing, fica longe do zero; as 28 comparações estão no apêndice. O custo por design é o custo mediano do modelo de linguagem em um design (a proposta mais as instruções de imagem) pelo preço público de cada fornecedor em 30 de outubro de 2026; a imagem em si custa o mesmo para todos os modelos e não está incluída. Todas as notas por trabalho estão no apêndice.
Quatro resultados se destacam.
O modelo de linguagem que faz o papel de designer faz diferença, mas só em qualidade a maioria dos modelos não pôde ser diferenciada. Com o mesmo modelo de imagem e as mesmas configurações, as notas médias foram de 7.08 a 7.97. Dos 28 pares de modelos, 5 diferem claramente quando comparados briefing por briefing: o GPT-6.1 Terra tirou nota menor que o GPT-5.6 Terra, o GPT-6 Luna e o Claude Opus 5.5, e o GPT-6.1 Sol, menor que o GPT-6 Luna e o Claude Opus 5.5. Os outros 23 pares empatam neste teste.
Junte qualidade, custo, velocidade e confiabilidade e as diferenças aparecem. Modelos do mesmo grupo de qualidade tiveram uma diferença de mais de 30 vezes no custo por design (GPT-6 Luna $0.005, Claude Sonnet 5.5 $0.18). O tempo para propor e escrever as instruções de imagem variou cerca do dobro (cerca de 41 segundos para o GPT-5.6 Terra e o Claude Sonnet 5.5, cerca de 87 para o GPT-6.1 Sol). E os modelos falharam por motivos diferentes (detalhes). Somando tudo, vários modelos perdem em pelo menos um quesito sem ganhar em outro: o GPT-6.1 Sol custou o mesmo que o GPT-5.6 Terra e não pôde ser diferenciado dele em qualidade, mas levou o dobro do tempo; o Gemini 3.8 Flash custou oito vezes mais que o GPT-6 Luna, não pôde ser diferenciado dele em qualidade e teve 8 erros do fornecedor; o GPT-6.1 Terra custou mais que o GPT-6 Luna e tirou nota claramente menor.
Nenhum modelo ganha em tudo; cada um combina com um tipo de trabalho. O Claude Opus 5.5 teve a maior média, 7.97, mas com só 18 designs em 8 briefings. Na rodada principal, as propostas dele, muito mais longas que as de qualquer outro modelo, foram cortadas 17 vezes pelo limite de 6600 tokens que o FontVibe definiu para o próprio uso em produção, e mais uma rodada falhou quando as instruções de imagem dele voltaram quebradas. Rodado de novo com o limite dobrado, ele terminou todas as vezes; nos 36 designs, tirou nota claramente maior que o GPT-5.6 Terra, o Claude Sonnet 5.5, o Gemini 3.8 Flash e os dois modelos GPT-6.1, e não pôde ser diferenciado do GPT-6 Luna nem do Gemini 4 Argon (detalhes). Ele também é o mais lento e o mais caro: uma mediana de $0.41 por design, ou $0.72 por design terminado quando as rodadas que falharam entram na conta. Combina com trabalhos de design complexos sem pressa, em que a vantagem dele vale o preço. O GPT-6 Luna ficou no grupo de qualidade mais alta, terminou todas as rodadas e foi o que custou menos, o que faz dele o melhor custo-benefício e combina com alto volume. O GPT-5.6 Terra foi rápido e equilibrado, o que combina com uso em tempo real, quando alguém está esperando o resultado.
Texto inventado é um defeito mensurável, e variou 14 vezes entre os modelos. O GPT-6.1 Terra acrescentou em média 0.17 linha por design que o briefing nunca deu; o Gemini 3.8 Flash acrescentou 2.36: anos de fundação, slogans, listas de serviços e números falsos. Texto inventado foi o motivo mais comum para um design perder pontos em informação, então, seja qual for o modelo, o pipeline precisa de uma checagem do texto.
O GPT-6.1 Terra foi o ponto de partida deste teste, então vale uma palavra sobre ele. No mesmo pipeline, com os mesmos prompts, ele foi mais conservador que o GPT-5.6 Terra. Comparando briefing por briefing, ele tirou 0.50 ponto a menos (IC 95% de −0.81 a −0.21) e nota menor em 9 dos 12 briefings. Ele perdeu em lettering e acabamento (−0.93) e em apelo (−1.38, menor em todos os 12 briefings); a legibilidade dele foi um pouco maior (+0.47), dentro da margem de erro. Os designs dele foram os com menos texto inventado e os mais sem graça; 17 dos seus 36 só combinaram em parte com o clima que o briefing pedia. Isso descreve como ele lê um briefing, escolhe uma direção e escreve instruções de imagem, não como ele se sai em outras tarefas.
Custo, velocidade e confiabilidade
A qualidade do design é só uma parte da escolha de um modelo. As mesmas rodadas também mediram quanto cada design custa, quanto tempo leva e com que frequência falha.
| Modelo | Tempo da proposta (mediana / 10% mais lentos) | Tempo das instruções de imagem (mediana / 10% mais lentos) | Custo por design (mediana) | Gasto por 1000 designs terminados | Terminou na primeira tentativa | Falhas do próprio modelo | Erros do fornecedor | Novas tentativas internas |
|---|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 37 s / 45 s | 13 s / 17 s | $0.041 | $41 | 36 / 36 | 0 | 0 | 0 |
| GPT-5.6 Terra | 29 s / 38 s | 12 s / 14 s | $0.090 | $93 | 33 / 36 | 1 | 0 | 0 |
| GPT-6.1 Sol | 62 s / 79 s | 25 s / 30 s | $0.090 | $91 | 34 / 36 | 0 | 0 | 0 |
| GPT-6 Luna | 44 s / 58 s | 16 s / 23 s | $0.005 | $5 | 36 / 36 | 0 | 0 | 1 |
| Claude Opus 5.5 | 65 s / 75 s | 25 s / 35 s | $0.41 | $721 | 18 / 36 | 18 | 0 | 19 |
| Claude Sonnet 5.5 | 27 s / 32 s | 14 s / 16 s | $0.18 | $162 | 36 / 36 | 0 | 0 | 0 |
| Gemini 4 Argon | 40 s / 73 s | 22 s / 33 s | $0.11 | $102 | 36 / 36 | 0 | 0 | 3 |
| Gemini 3.8 Flash | 32 s / 49 s | 13 s / 35 s | $0.043 | $49 | 29 / 36 | 0 | 8 | 4 |
Os tempos são o tempo do próprio modelo de linguagem em cada etapa, nas rodadas que terminaram. Renderizar a imagem levou uma mediana de 20 segundos a mais, igual para todos os modelos. Os custos usam o preço público de cada fornecedor em 30 de outubro de 2026, cobrem as duas etapas do modelo de linguagem e deixam de fora a imagem, que custa o mesmo seja qual for o modelo que fez o design. "Gasto por 1000 designs terminados" conta tudo o que foi gasto, incluindo rodadas que falharam e rodadas repetidas, dividido pelos designs que terminaram. "Terminou na primeira tentativa" conta as rodadas que produziram uma imagem sem precisar rodar de novo; as duas rodadas do GPT-5.6 Terra e as duas do GPT-6.1 Sol que a recepção do FontVibe interrompeu para fazer uma pergunta contam como não terminadas na primeira tentativa, embora a culpa não tenha sido do modelo. Novas tentativas internas são as vezes em que o pipeline do FontVibe tentou de novo com o mesmo modelo dentro de um pedido depois de uma tentativa que falhou.
Custo. O GPT-6 Luna foi de longe o mais barato: cerca de $5 por 1000 designs terminados, contra $93 do GPT-5.6 Terra e $721 do Claude Opus 5.5, cujas rodadas que falharam custaram quase tanto quanto as que terminaram. O GPT-6.1 Terra custou menos da metade do GPT-5.6 Terra. O Claude Opus 5.5 foi o mais caro, em parte porque escreveu as propostas mais longas: a proposta mediana dele chegou ao limite de 6600 tokens.
Velocidade. O Claude Sonnet 5.5 propôs mais rápido, com mediana de 27 segundos, e o GPT-5.6 Terra ficou perto, com 29 segundos. O GPT-6.1 Sol e o Claude Opus 5.5 levaram mais de um minuto. A mediana do Gemini 4 Argon foi de 40 segundos, mas os 10% mais lentos dele levaram 73 segundos ou mais, a maior dispersão entre todos os modelos.
Confiabilidade. O GPT-6.1 Terra, o GPT-6 Luna, o Claude Sonnet 5.5 e o Gemini 4 Argon terminaram as 36 rodadas na primeira tentativa. A saída do próprio Gemini 3.8 Flash nunca falhou, mas o serviço do Google devolveu 8 erros (limites de taxa e timeouts) em 7 das rodadas dele, e todas terminaram ao rodar de novo. O Claude Opus 5.5 falhou 18 vezes: 17 propostas cortadas no limite de saída e um conjunto de instruções de imagem que voltou quebrado. A maioria das suas 19 novas tentativas internas foram segundas tentativas depois de uma proposta cortada que acabaram cortadas de novo.
Como testei
O pipeline
Este teste mede um trabalho só: ser o designer. No modo de design do FontVibe, um pedido passa por três etapas:
- Propor. Um modelo de linguagem lê o briefing e propõe três direções de design, cada uma com um título, o texto exato a ser impresso, cores, um layout e uma escolha de estilo de lettering.
- Escrever as instruções de imagem. Para a primeira direção, um modelo de linguagem escreve as instruções completas para o modelo de imagem.
- Renderizar. Um modelo de imagem desenha.
O modelo testado fez as etapas 1 e 2. A etapa 3 foi sempre o GPT Image 2.5 Sunburst em 2K e qualidade Medium. Todos os pedidos passaram pelo pipeline de produção do FontVibe, com os mesmos prompts de sistema, o mesmo formato de saída e a mesma configuração de esforço de raciocínio (medium) para todos os modelos. Nenhum modelo recebeu prompt próprio nem configurações próprias. A primeira direção foi sempre a renderizada; eu não escolhi direções.
Os oito modelos
| Fornecedor | Modelo | Por que está aqui |
|---|---|---|
| OpenAI | GPT-6.1 Terra | Lançado em 26 de outubro de 2026; o modelo em avaliação |
| OpenAI | GPT-5.6 Terra | O que o FontVibe usa hoje na etapa 1 |
| OpenAI | GPT-6.1 Sol | O modelo topo de linha da OpenAI |
| OpenAI | GPT-6 Luna | O modelo de baixo custo da OpenAI; o que o FontVibe usa hoje na etapa 2 |
| Anthropic | Claude Opus 5.5 | O modelo topo de linha da Anthropic |
| Anthropic | Claude Sonnet 5.5 | O modelo de preço intermediário da Anthropic |
| Gemini 4 Argon | O modelo topo de linha do Google | |
| Gemini 3.8 Flash | O modelo de baixo custo do Google |
Os 12 briefings, em quatro camadas
Um designer pode errar de quatro jeitos diferentes, então os briefings vêm em quatro camadas de três, uma camada para cada jeito.
| Camada | O que testa | Por que importa |
|---|---|---|
| 1. Pedidos do dia a dia | Briefings curtos, com um só objetivo | A maioria dos pedidos reais é assim, então esta camada é a mais próxima do uso diário |
| 2. Acertar a informação | Texto que tem que aparecer exatamente como foi escrito, às vezes numa ordem de importância definida | O modelo de linguagem é a única etapa que passa o texto para o modelo de imagem; texto que ele perde ou altera não tem como ser recuperado depois |
| 3. Julgamento de design | Requisitos contraditórios, uma área pouco familiar, dois públicos ao mesmo tempo | É por esta parte que um cliente paga um designer, e é onde os modelos têm mais chance de se diferenciar |
| 4. Idioma e cultura | Briefings em japonês, alemão e espanhol mexicano com contexto cultural | Uma referência cultural errada custa mais que um erro de digitação |
Os briefings cobrem seis idiomas (inglês, chinês, espanhol, português, alemão e japonês), os seis idiomas da interface do FontVibe, e todos pedem texto no design. Oito dos 12 briefings foram usados pela primeira vez num teste interno de três modelos da OpenAI em setembro de 2026. A empresa do pôster de vagas e todos os nomes e endereços dos briefings são inventados. O briefing completo de cada trabalho está na seção dele, mais abaixo.
Rodadas e falhas
Cada modelo rodou cada briefing três vezes: 36 designs por modelo, 288 no total. Quando um design falhava, a causa decidia o que vinha depois:
- A saída do próprio modelo falhou (cortada no limite de tokens de produção, ou uma proposta vazia ou quebrada): contou como falha e não foi rodada de novo. 19 designs falharam assim: 18 do Claude Opus 5.5 (17 propostas cortadas no limite, 1 conjunto de instruções de imagem quebradas) e 1 proposta vazia do GPT-5.6 Terra.
- O serviço do fornecedor falhou (limites de taxa, erros de servidor, timeouts): rodada de novo. Isso aconteceu 8 vezes, todas com o Gemini 3.8 Flash.
- A própria recepção do FontVibe fez uma pergunta antes. Antes de um pedido chegar ao designer, um modelo fixo separado verifica se falta alguma coisa. No briefing da casa noturna, às vezes ele perguntou "quase invisível ou legível a 50 metros?" em vez de passar o briefing adiante. Isso não é culpa do modelo testado, então essas 4 rodadas foram rodadas de novo, e o design avaliado é o da rodada repetida. Todas as tentativas estão listadas no dataset aberto.
Os 287 designs (269 das rodadas principais e 18 das rodadas extras do Opus, mais abaixo) foram gerados em 30 de outubro de 2026, no site de produção do FontVibe com uma conta oficial, e estão públicos no FontVibe.
Avaliação
Cada design recebeu nota pelo padrão de avaliação de benchmark do FontVibe, escrito antes de os resultados serem contabilizados. Ele parte dos critérios do meu teste de sete ferramentas de design com IA e dos dois testes de modelos de imagem. O avaliador faz o papel do cliente que escreveu o briefing e julga nesta ordem: é o que eu pedi; consigo usar sem consertar nada; tem o clima que eu queria; os detalhes são bem feitos; me faz dizer "uau" à primeira vista.
| O que recebe nota | Peso | O que cobre |
|---|---|---|
| Legibilidade | 20% | Primeiro, uma checagem de erros graves que deixam o texto principal ilegível ou mal lido no tamanho real. Qualquer erro grave significa de 1 a 4; nenhum significa de 7 a 10. |
| Lettering e acabamento | 35% | Se o lettering e os materiais alcançam o efeito e o clima que o briefing pede, e com que qualidade são feitos. |
| Informação e layout | 25% | Se é a peça certa e se cada texto pode ser usado como está: completo, do jeito que o cliente escreveu, e sem nada que o cliente não disse e não poderia sustentar. Depois, hierarquia, ordem e equilíbrio. |
| Apelo | 20% | Só a primeira impressão e o profissionalismo visual. Erros de texto recebem nota uma vez, em informação e layout, e não de novo aqui. |
A nota geral é calculada, não julgada: 0.20 × legibilidade + 0.35 × lettering + 0.25 × informação e layout + 0.20 × apelo.
Uma regra decidiu muitas notas, então aqui vai ela completa. A pergunta para cada linha de texto foi: o cliente teria que mudar isto antes de usar, e o cliente chegou a dizer isto? Repetir o que o briefing já diz ("COFFEE ROASTERS" para uma torrefação de café) e saudações comuns ("Happy birthday") foram aceitos. Fatos, números, promessas e slogans que o cliente nunca deu foram, cada um, um desconto, porque o cliente teria que apagá-los ou publicaria algo falso sem perceber. Placeholders impressos como estão, como {{fecha}}, e mudanças no jeito como o cliente escreveu algo, como "7 de la noche" virar "7:00 p. m.", também foram descontos.
Quem deu as notas. As notas vêm de avaliadores de IA rodando o Claude Opus 5.5, um avaliador por grupo de três briefings, cada um olhando todas as imagens originais de um briefing antes de dar nota a qualquer uma delas. As imagens tinham IDs aleatórios, e os avaliadores não sabiam qual modelo tinha feito qual design. Um dos oito modelos testados, o Claude Opus 5.5, é o mesmo modelo dos avaliadores. Leve isso em conta ao ler as notas dele: não foi testado se os avaliadores favorecem os designs do próprio Opus. A escolha às cegas feita por uma pessoa é a única checagem humana deste teste.
Trabalho por trabalho
Cada grade mostra o primeiro design que terminou de cada modelo, então nenhum design foi escolhido a dedo. A legenda traz a nota desse design e a média do modelo nas suas três rodadas do trabalho.
Camada 1: Pedidos do dia a dia
Trabalho 1: Logotipo de torrefação de café
A logo-style title for my new coffee roastery called EMBER & OAK
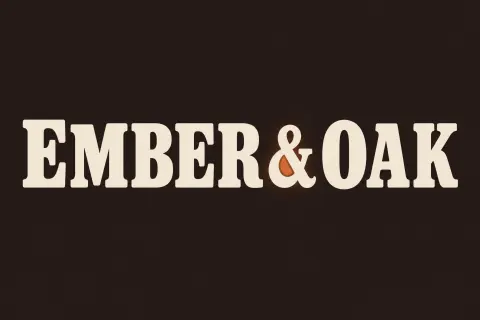
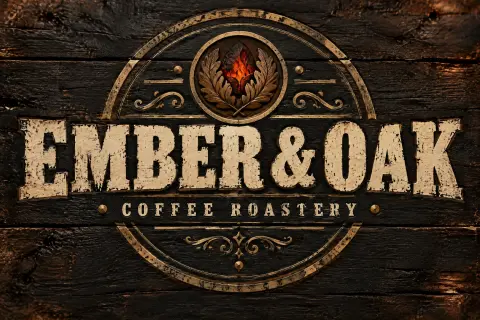
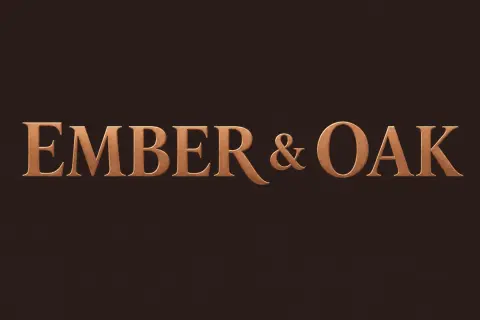
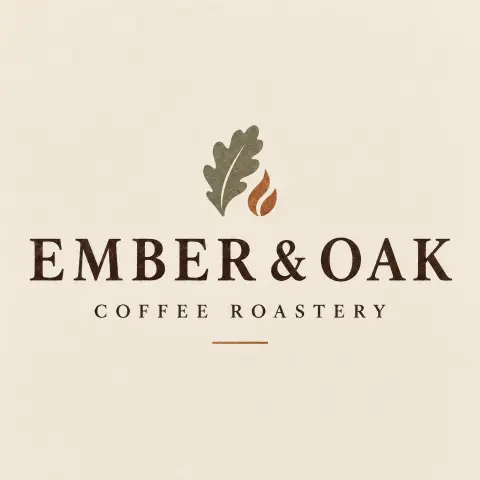
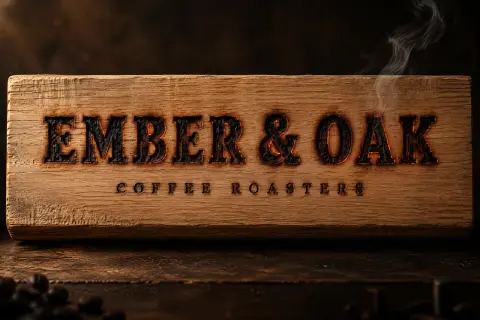
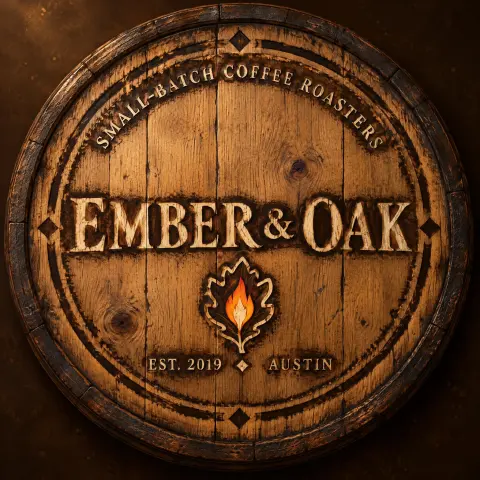
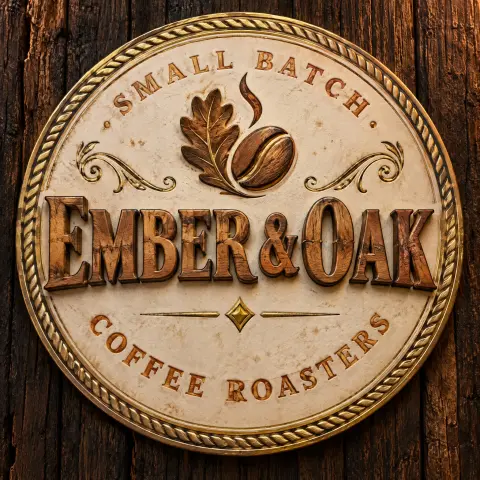
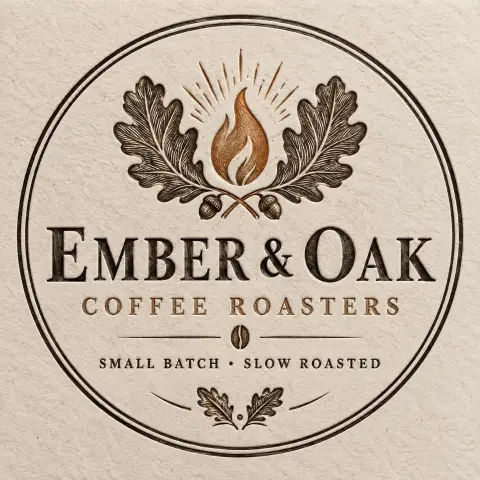
O Claude Opus 5.5 tirou a nota mais alta, 8.38 de média: ele queimou o nome na madeira, com as bordas de cada letra chamuscadas. O GPT-5.6 Terra (8.13) e o GPT-6 Luna (8.05) vieram logo atrás. O GPT-6.1 Terra (6.62) e o GPT-6.1 Sol (6.43) compuseram o nome numa tipografia limpa, mas comum, que o avaliador considerou só em parte de acordo com o "ember and oak" (brasa e carvalho) do briefing. O design do Claude Sonnet 5.5 inventou um ano de fundação e uma cidade, "EST. 2019" e "AUSTIN", que o cliente nunca deu.
Trabalho 2: Pôster de aniversário com dinossauros
给我做一张生日海报,寿星叫小雨,今年 8 岁,喜欢恐龙 (Um pôster de aniversário: a aniversariante é a Xiaoyu, ela vai fazer 8 anos e adora dinossauros.)
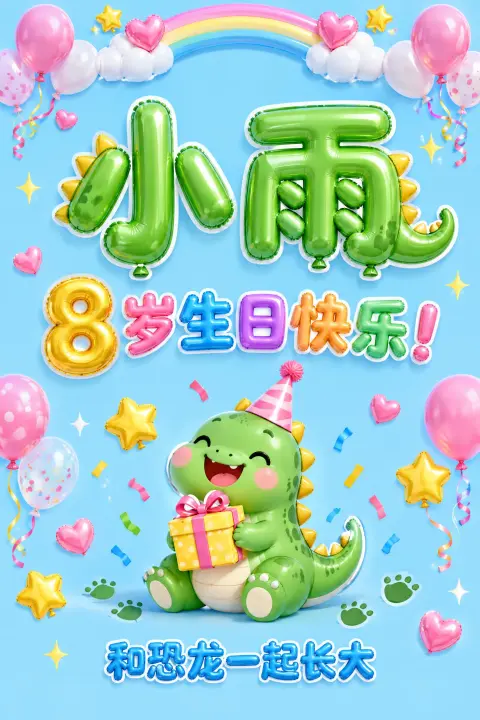
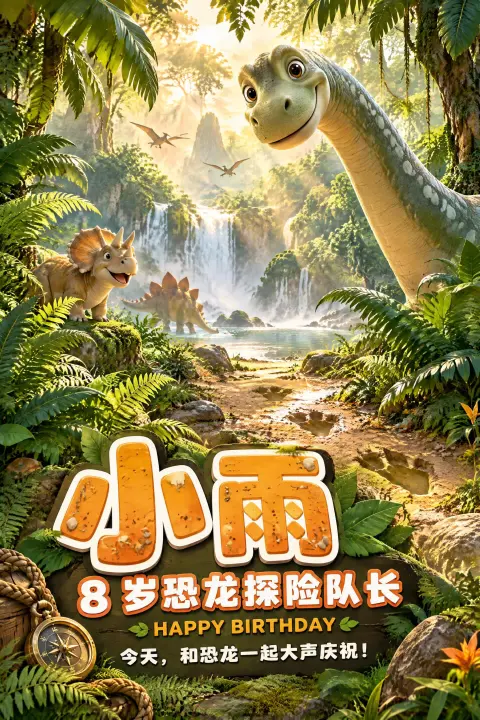
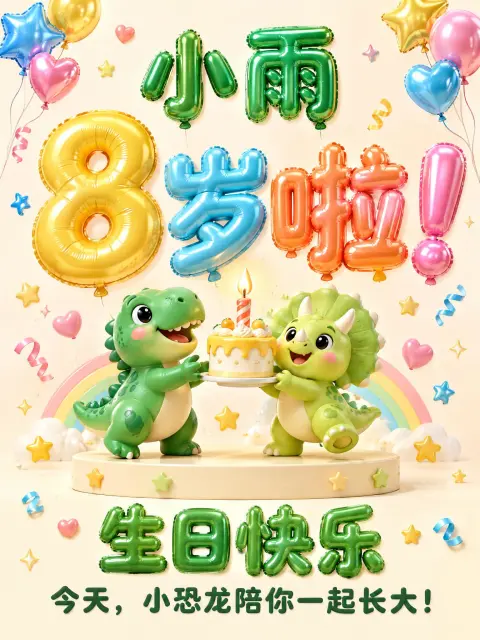
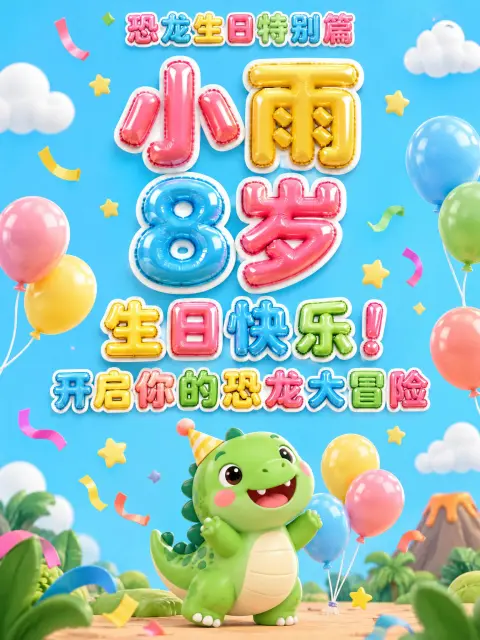
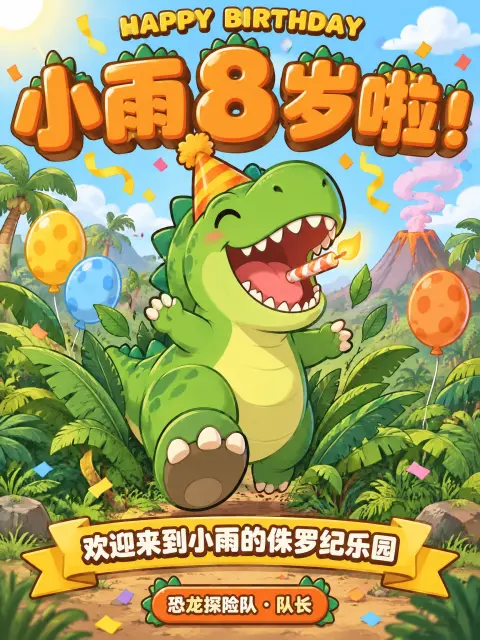
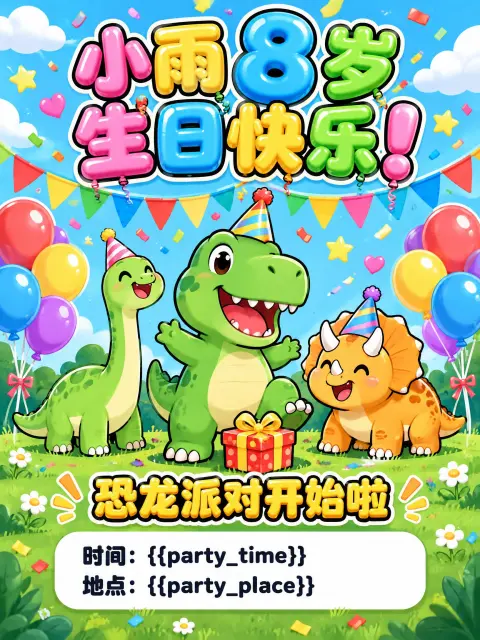
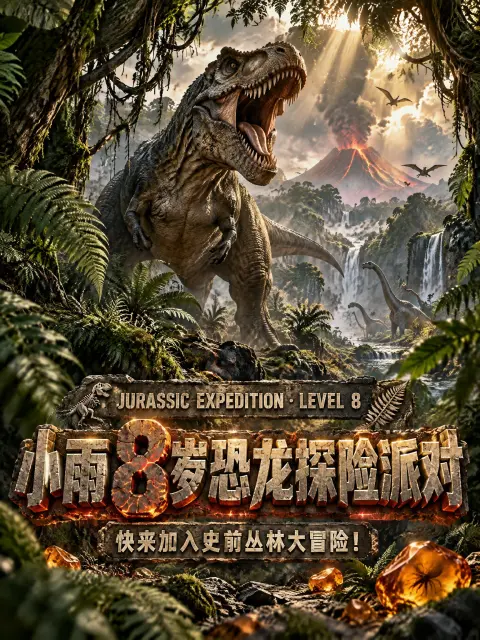
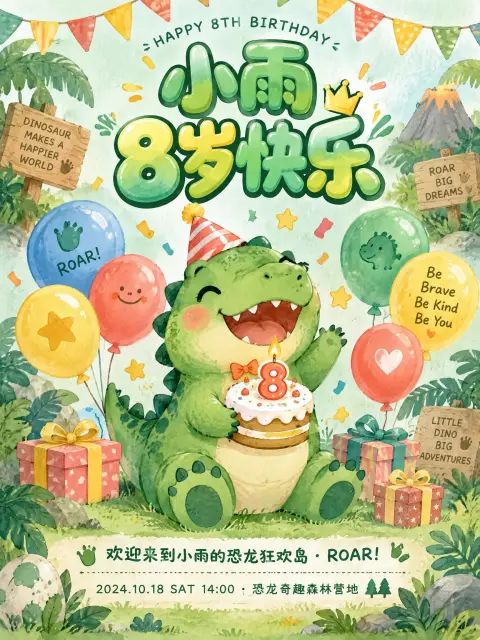
Os modelos da OpenAI se saíram melhor aqui. O GPT-6.1 Sol tirou 8.73, e o GPT-6.1 Terra 8.43, o melhor trabalho dele, com uma cauda de dinossauro saindo do caractere 雨 no nome da Xiaoyu. O Gemini 4 Argon ficou em último, 6.48: uma selva fotorrealista e uma festa "Jurassic Expedition · Level 8" que o cliente nunca mencionou, que o avaliador considerou só em parte de acordo com um aniversário de uma criança de oito anos. Para letras de balão como as do GPT-6.1 Sol, veja o gerador de letras bubble. O primeiro design do Gemini 3.8 Flash inventou uma data, um horário e um local para uma festa que não existe, e a data já tinha passado.
Trabalho 3: Pôster de festa de formatura
Un cartel para la fiesta de graduación de secundaria, dice PROMOCIÓN 2026 (Um pôster para a festa de formatura do ensino médio que diz PROMOCIÓN 2026.)
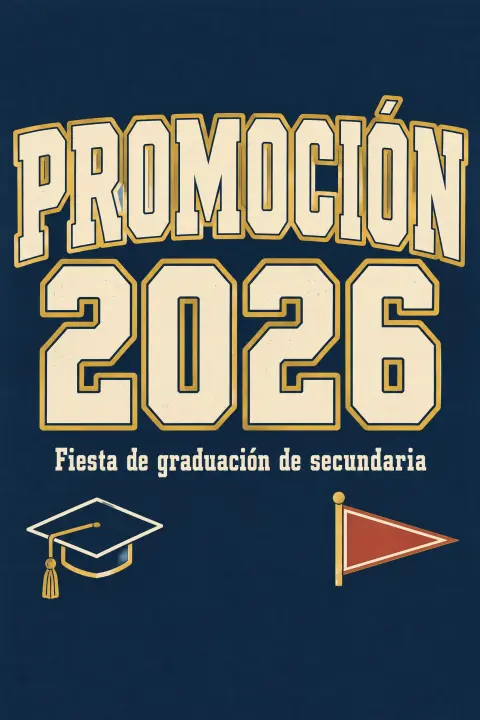
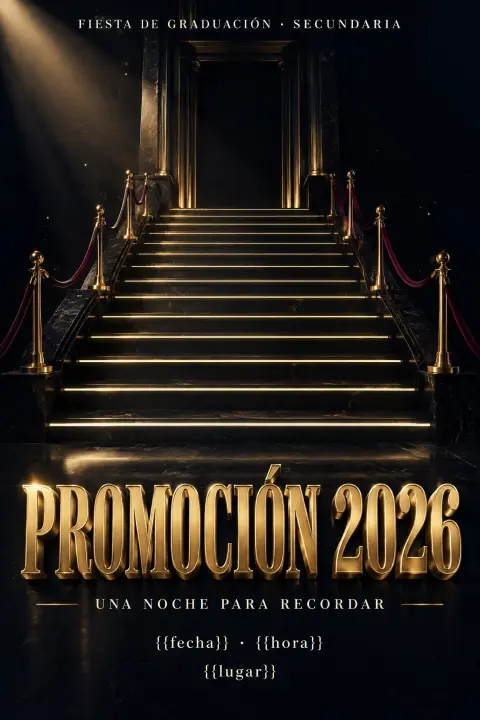
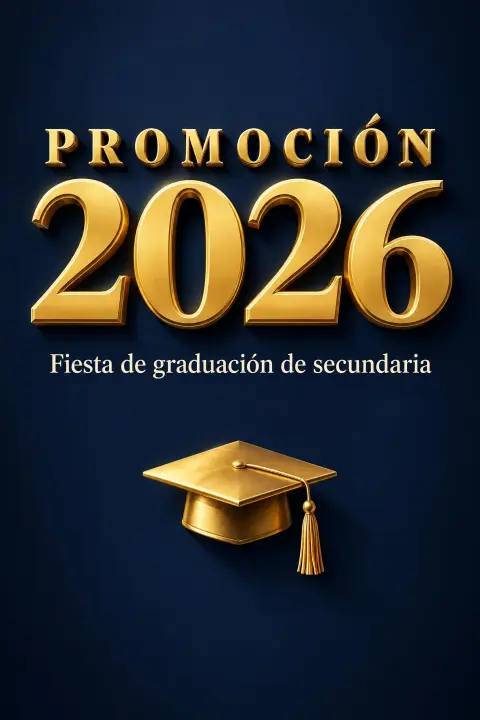
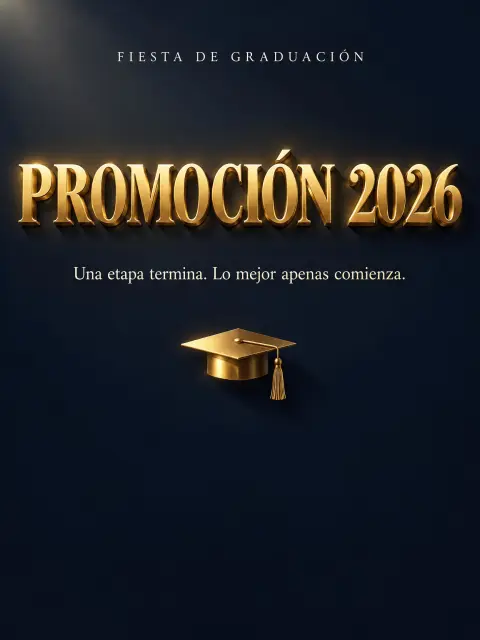
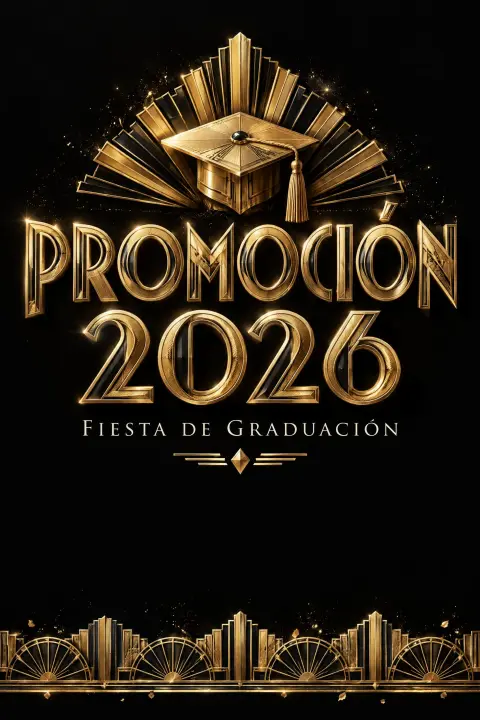
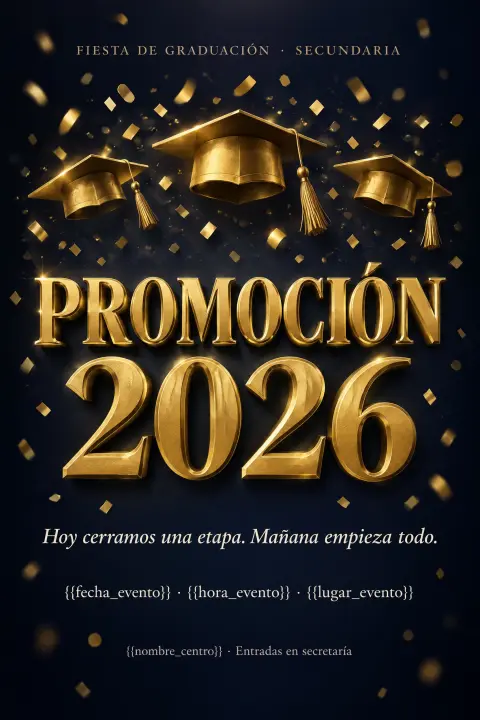
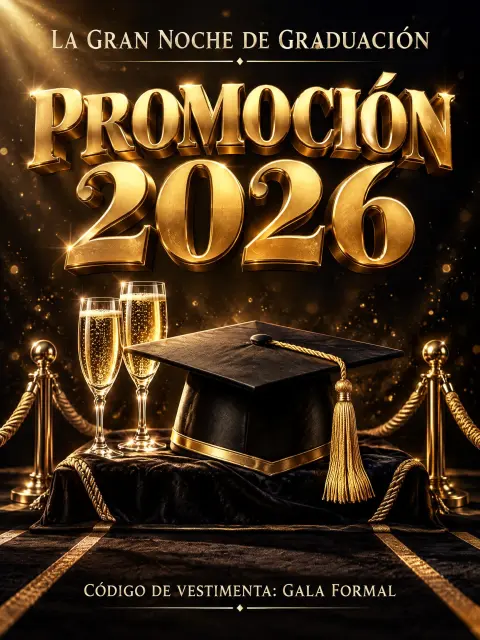
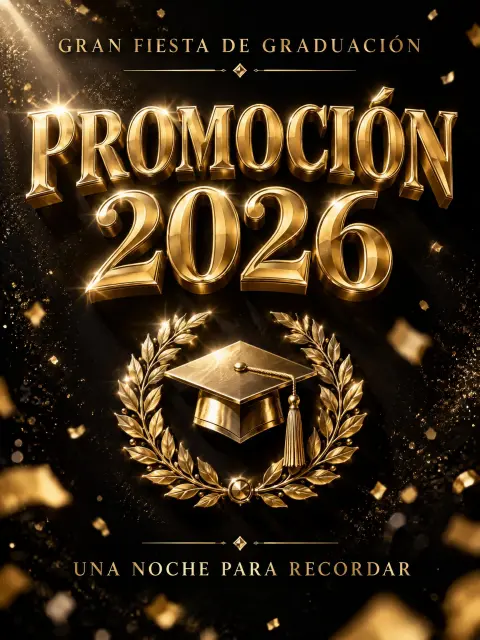
Todos os modelos escreveram PROMOCIÓN com o acento. O Gemini 4 Argon (8.40) e o Gemini 3.8 Flash (8.28) tiraram as notas mais altas com lettering dourado e louros, embora um dos designs do Argon tenha acrescentado um traje de gala obrigatório, e dois designs deste trabalho mostraram taças de champanhe numa festa de escola. Este briefing não tinha data nem local, e muitos designs deixaram uma área vazia embaixo, onde esses detalhes entrariam, ou imprimiram ali placeholders como {{fecha}}.
Camada 2: Acertar a informação
Trabalho 4: Thumbnail do YouTube
YouTube thumbnail text for a video about losing 30 pounds, title THE SHIFT
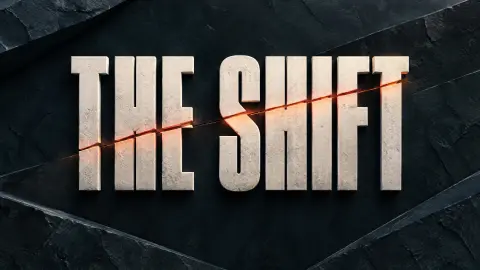
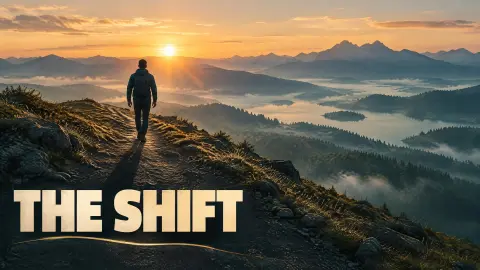
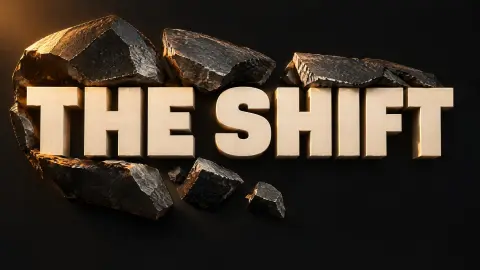
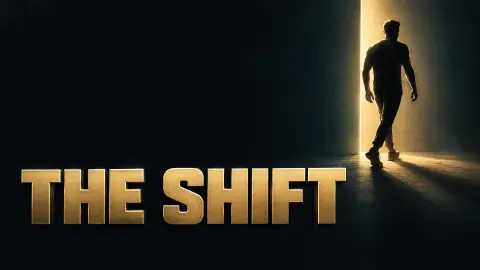
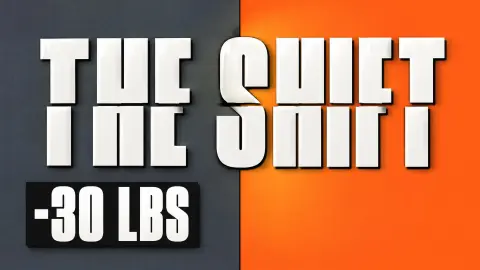
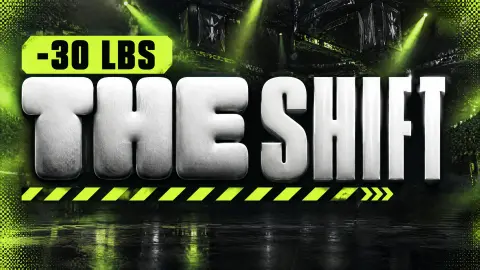
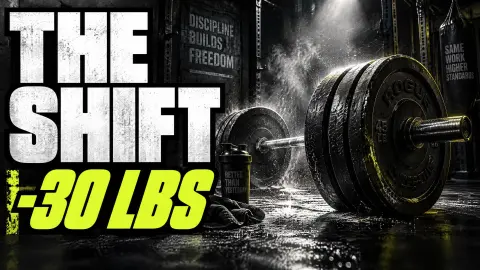
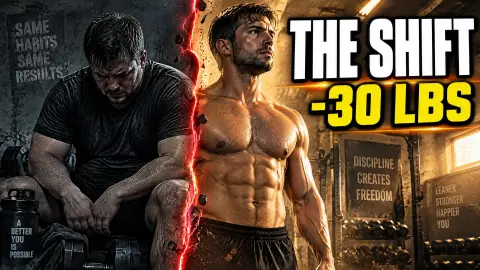
O Claude Sonnet 5.5 tirou a nota mais alta, 8.20, contrastando um "THE" de argila com um "SHIFT" espelhado para mostrar a mudança. O GPT-6 Luna tirou 7.97. O Claude Opus 5.5 ficou em último, 6.53: o primeiro design dele deslocou as metades de cada letra, o que parece um erro de impressão. O Gemini 4 Argon e o Gemini 3.8 Flash encheram o fundo de slogans de academia que o cliente nunca escreveu.
Trabalho 5: Pôster de vagas com sete informações
招聘海报:标题「一起把账算明白」,副标题「马来西亚 AI 公司,招两位财务」,要写上公司名 Northwind Labs Sdn Bhd、月薪 RM6000-9000、地点吉隆坡 Bangsar、投递邮箱 jobs@northwindlabs.my、截止 10 月 15 日。标题最大,邮箱最小。 (Um pôster de vagas com título, subtítulo, nome da empresa, salário, local, endereço de e-mail e prazo. Título maior, e-mail menor.)
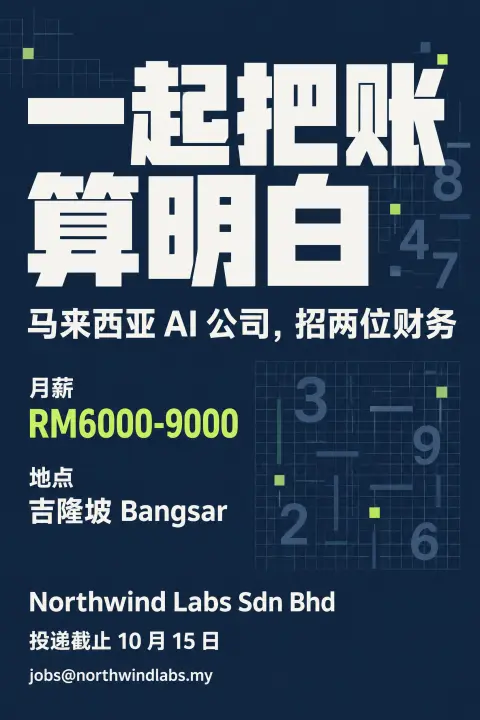
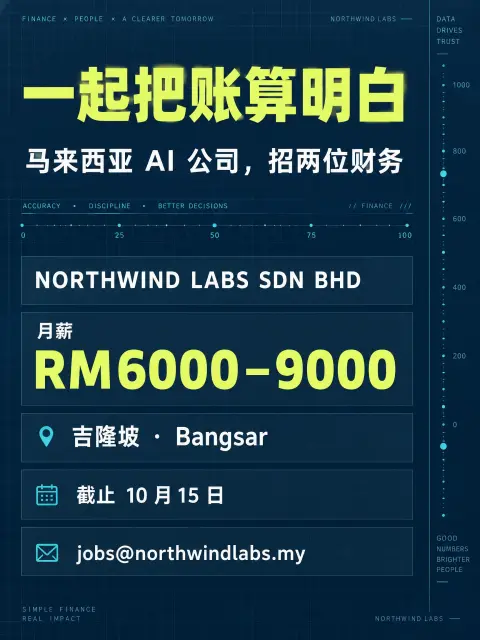
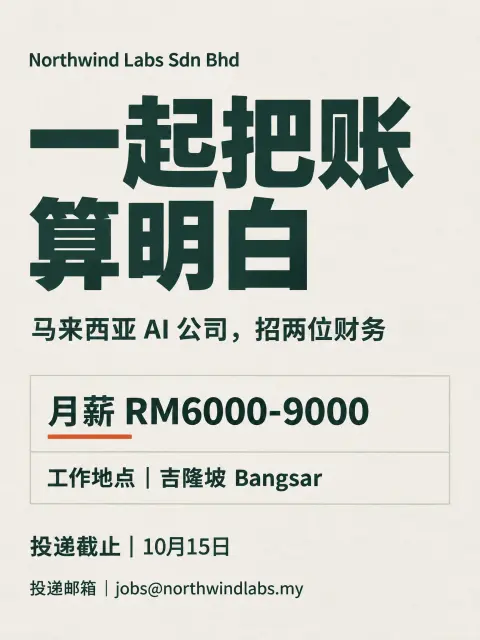
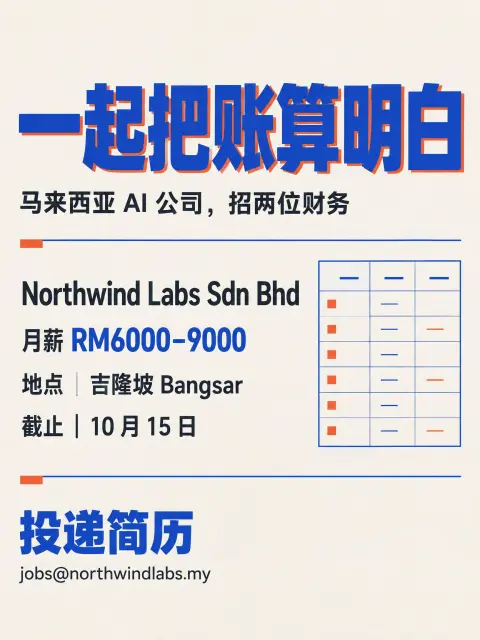
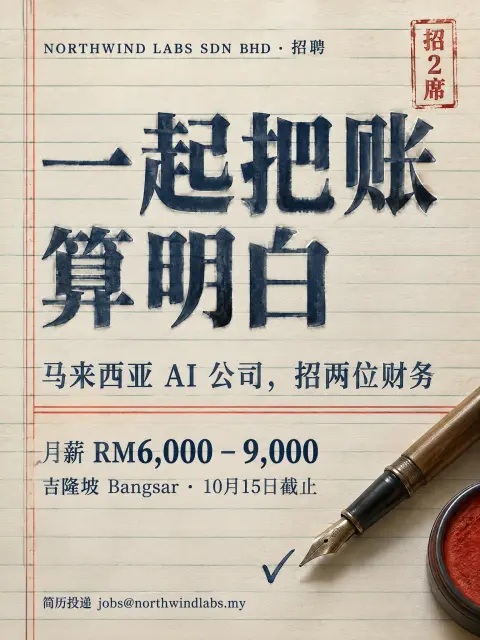
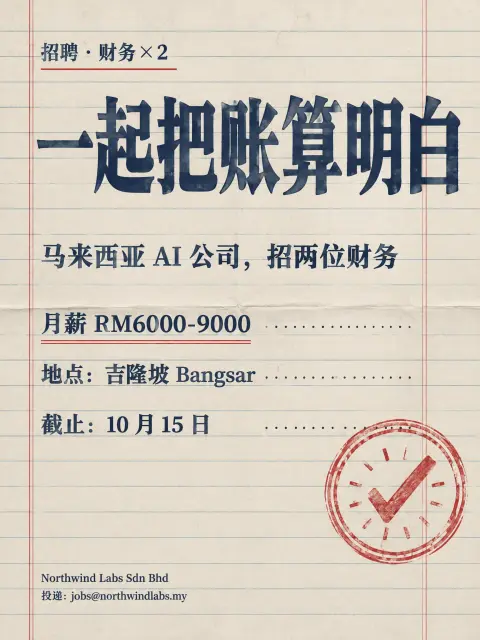
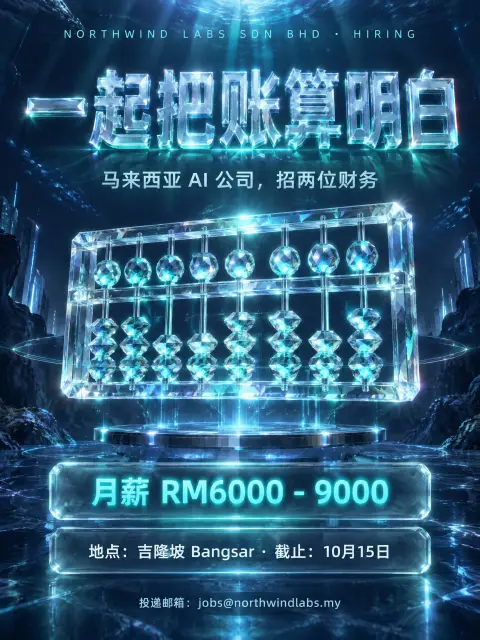
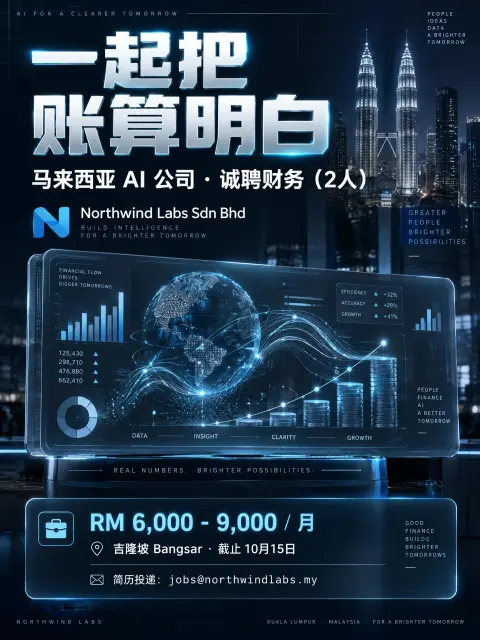
Este trabalho foi o que mais separou os modelos. O Claude Sonnet 5.5 tirou 7.92 com um design em papel de livro-caixa e um carimbo vermelho que manteve as sete informações e a ordem de tamanhos. O Gemini 3.8 Flash tirou a nota mais baixa, 6.12: o primeiro design dele encheu o pôster de slogans em inglês, um logotipo e painéis com números inventados, e alterou o subtítulo do cliente. O Claude Opus 5.5 falhou nas três rodadas no limite de tokens de produção; com o limite dobrado, ele fez o melhor design do trabalho, 8.95, com um título parecido, de tinta sobre papel, um selo e uma caneta-tinteiro.
Trabalho 6: Cinta de copo de café
Uma capa para o copo de café para viagem da minha cafeteria em Belo Horizonte, a Grão de Ouro. Tem que ter o slogan "Café de verdade, sem pressa" e "Desde 1998".
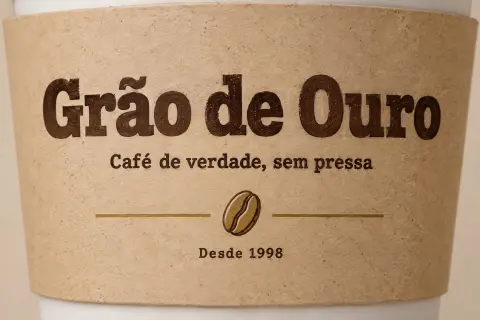
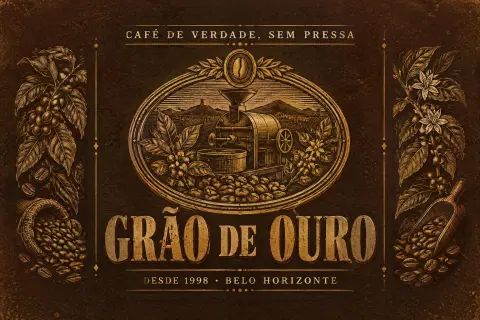
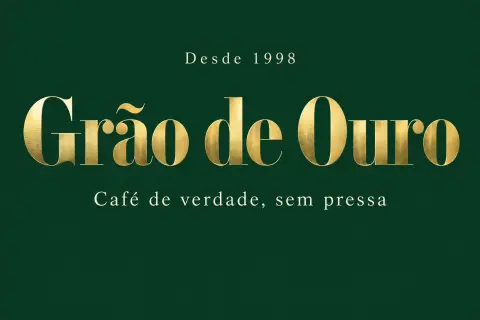
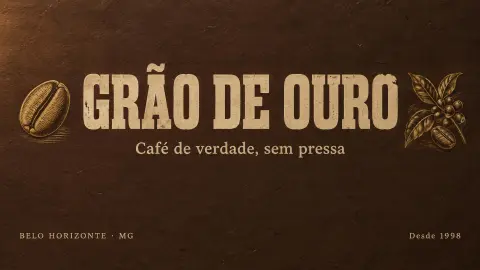
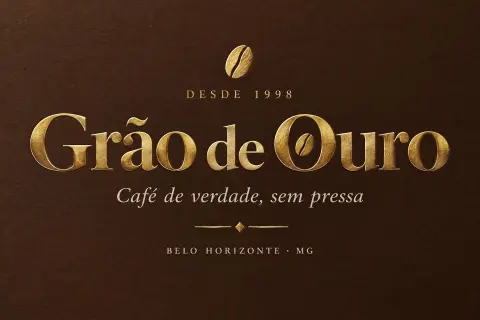
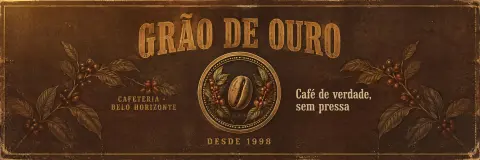
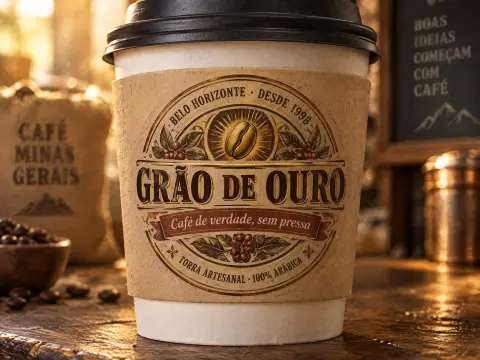
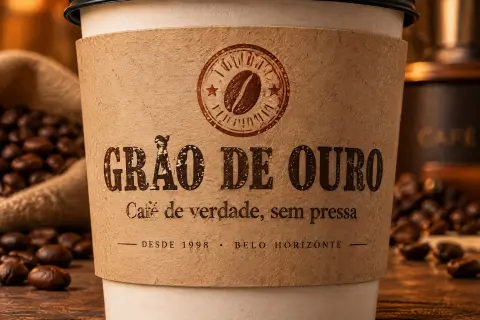
O Claude Opus 5.5 tirou 8.97 nas duas rodadas que terminaram, com lettering serifado em hot stamping dourado e um O em forma de grão de café. O GPT-5.6 Terra (8.30) e o Claude Sonnet 5.5 (8.38) vieram em seguida. O primeiro design do Gemini 3.8 Flash desenhou errado o til de GRÃO, então o nome se lê mais como "GRÁO". O Gemini 4 Argon acrescentou afirmações como "100% ARÁBICA" que a cafeteria nunca fez. Para lettering em dourado sozinho, experimente o gerador de texto dourado.
Camada 3: Julgamento de design
Trabalho 7: Logotipo de casa noturna com requisitos contraditórios
I want an extremely minimal, quiet, almost invisible wordmark for my nightclub — but it also has to scream across a dark street from 50 metres away and feel expensive. The name is VOID.
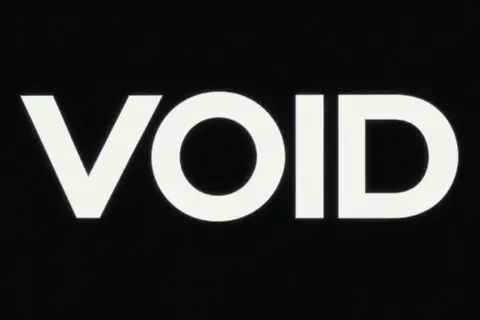
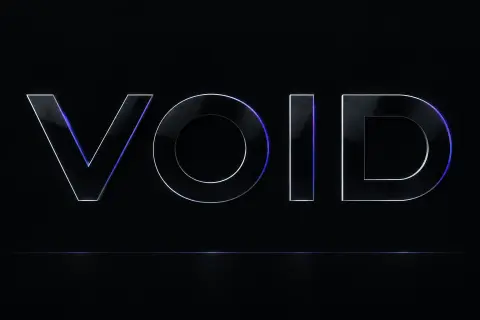
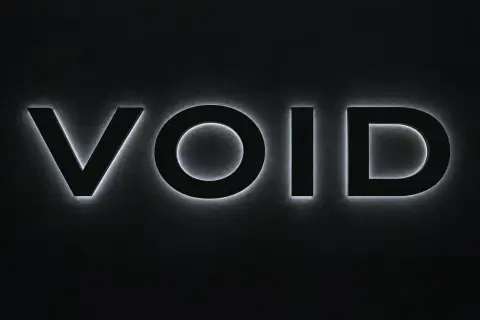
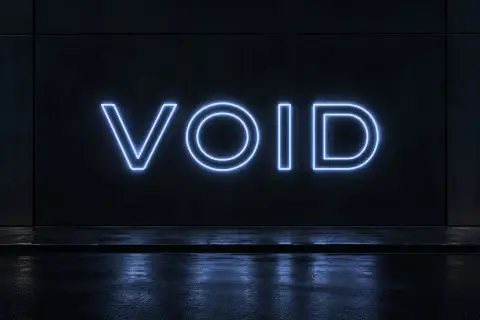
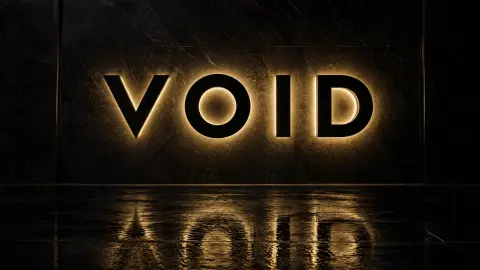
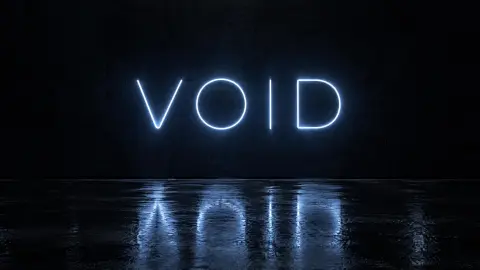
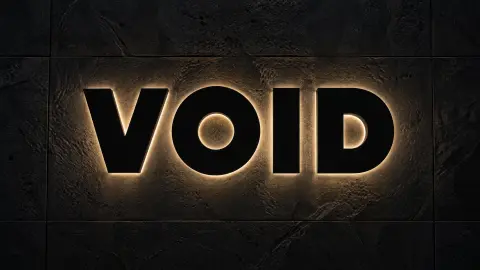
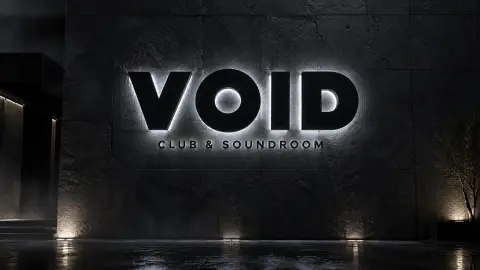
Os designs mais fortes resolveram a contradição com retroiluminação: letras pretas numa parede preta, que somem de perto e brilham à noite. O Gemini 4 Argon (8.13), o Gemini 3.8 Flash (8.05) e o Claude Opus 5.5 (7.88) fizeram isso melhor. O GPT-6.1 Terra ficou em último, 5.48: o primeiro design dele é tipografia branca em negrito, chapada, sobre preto, que grita mas não é nem discreta nem cara. O GPT-5.6 Terra tirou 5.90. Para letreiros iluminados, o criador de letreiro de fachada parte de letreiros de loja que brilham.
Trabalho 8: Capa de revista científica
Cover art for a peer-reviewed paper on cryo-EM structural determination of amyloid fibrils. Title: CONFORMATIONAL POLYMORPHISM. It has to look like it belongs on the cover of Nature, not like a startup pitch deck.
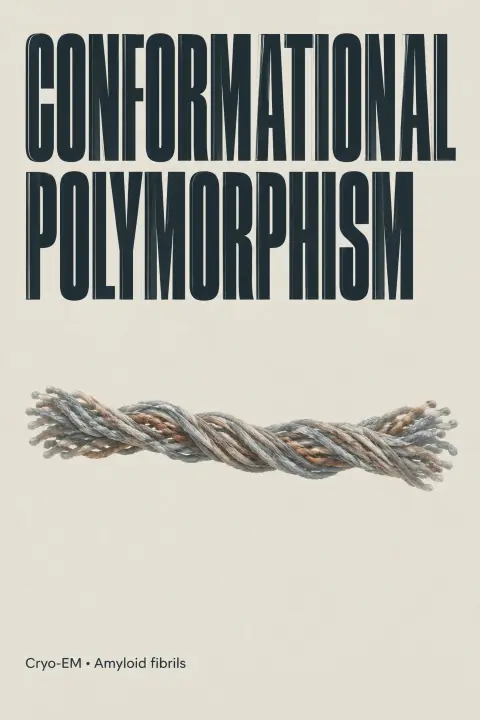
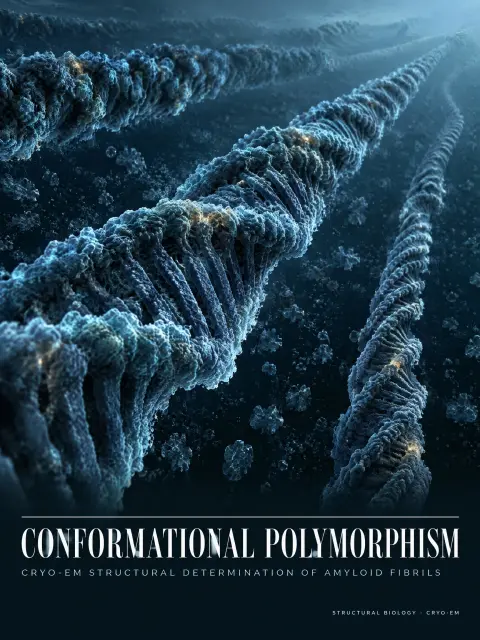
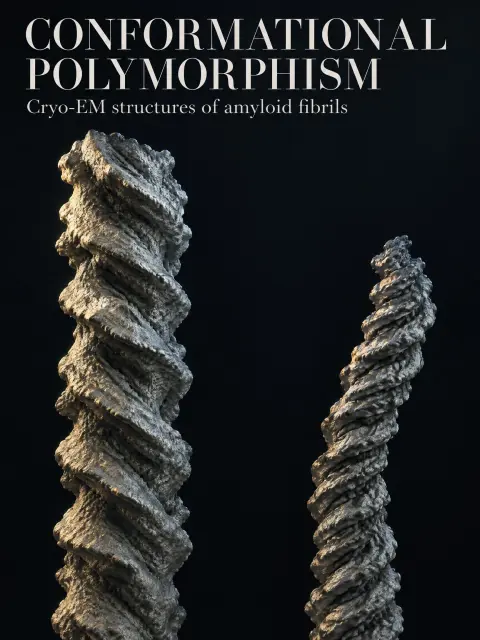
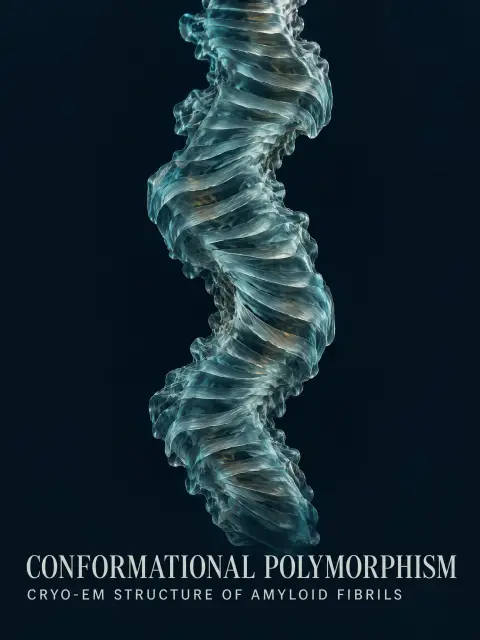
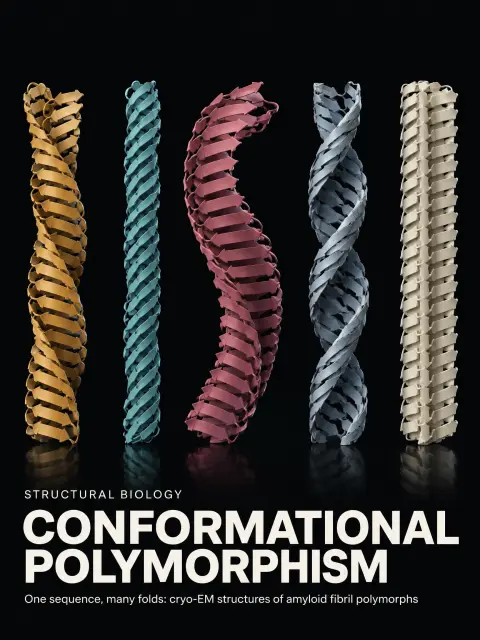
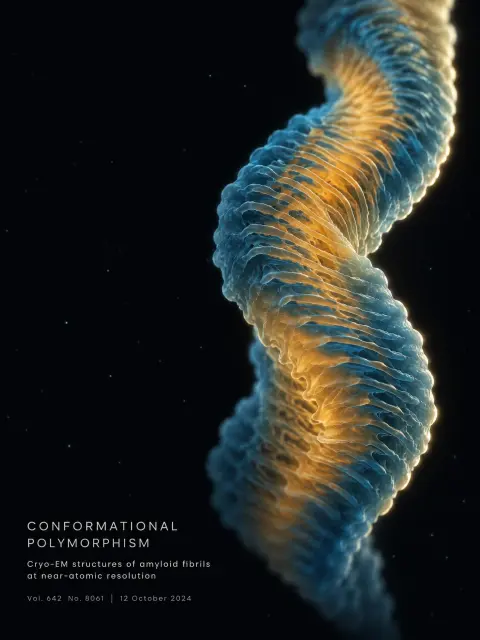
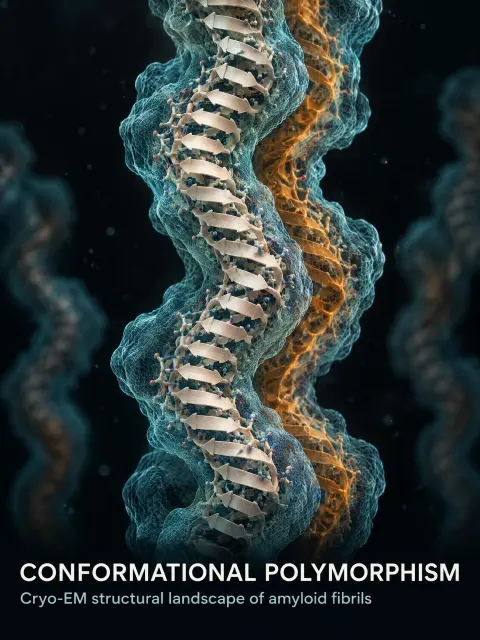
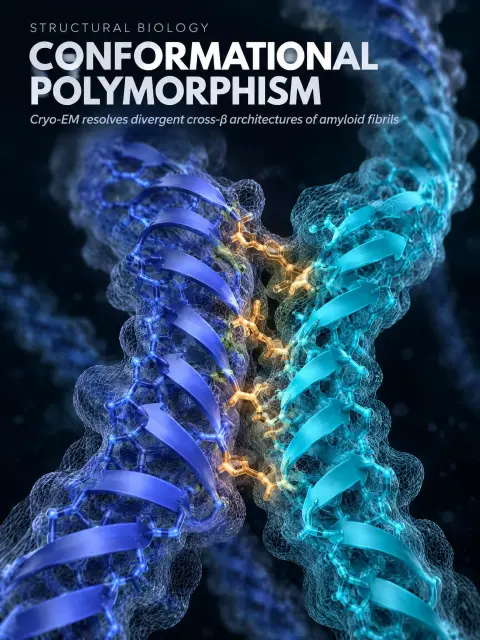
O GPT-6.1 Sol (7.65), o GPT-5.6 Terra (7.47) e o GPT-6 Luna (7.43) tiraram as notas mais altas com títulos serifados contidos e fibrilas com aspecto de vidro. Vários designs desenharam as fibrilas como uma dupla hélice em forma de escada, que parece DNA, um erro científico numa capa sobre amiloide. O Claude Sonnet 5.5 inventou volume, número e data. O Claude Opus 5.5 falhou nas três rodadas no limite de produção.
Trabalho 9: Placa de estúdio de tatuagem para dois públicos
A shop sign for my tattoo studio called INKWELL. It should still feel welcoming to my grandmother's generation.
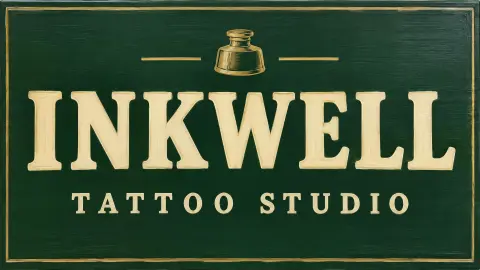
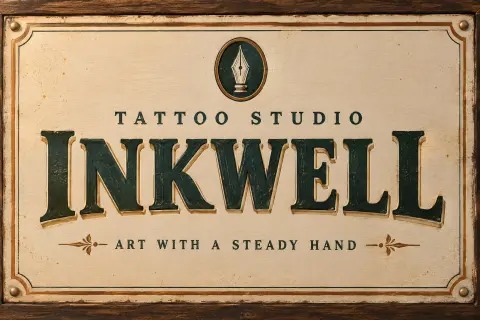
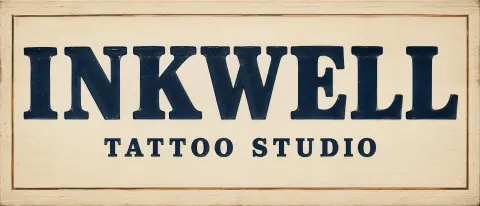
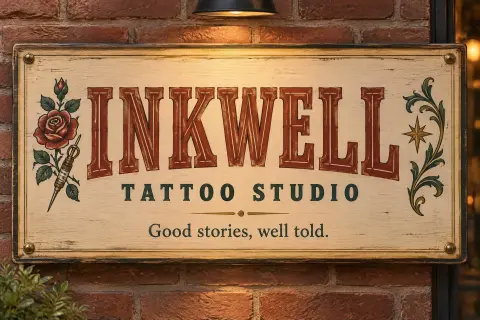
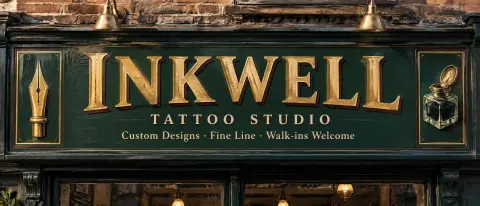
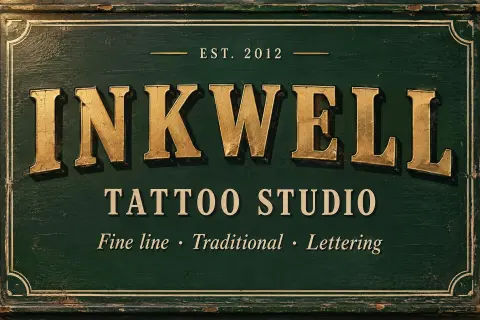
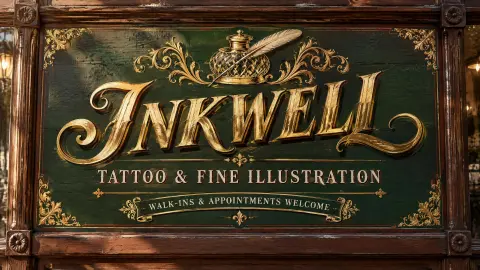
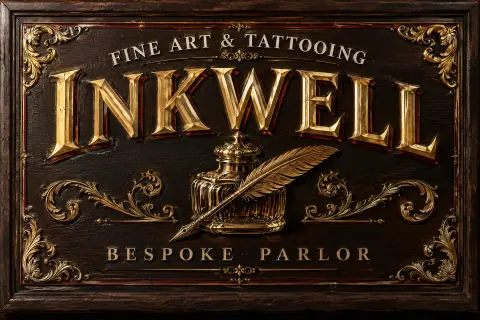
Texto inventado apareceu por toda parte neste trabalho: taglines, listas de serviços, "Walk-ins welcome" e dois anos de fundação inventados. O Claude Opus 5.5 tirou a nota mais alta, 8.25, e o GPT-6 Luna 7.95. O Gemini 4 Argon ficou em último, 6.37: o primeiro design dele usou um I maiúsculo decorativo que se lê como J, então o nome parece "JNKWELL". Os designs que imprimiram só o nome e "Tattoo Studio" estavam corretos, mas muitas vezes sem graça.
Camada 4: Idioma e cultura
Trabalho 10: Placa de barraca de raspadinha japonesa
夏祭りの屋台の看板を作ってください。「かき氷」と書いて、昭和レトロな駄菓子屋の雰囲気で。提灯の灯りみたいな温かさがほしい。 (Uma placa de barraca de festival de verão que diz かき氷, com clima de loja de doces retrô da era Showa e o calor da luz de lanternas.)
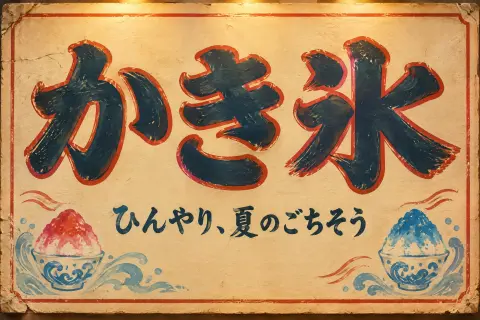
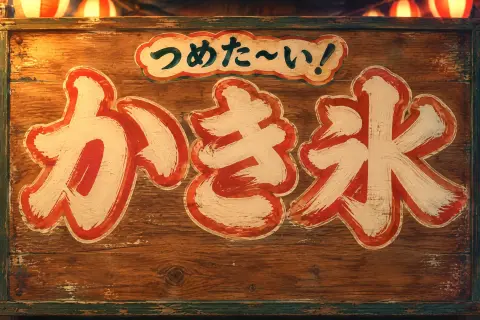
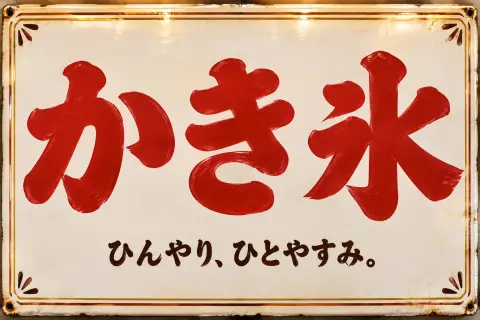
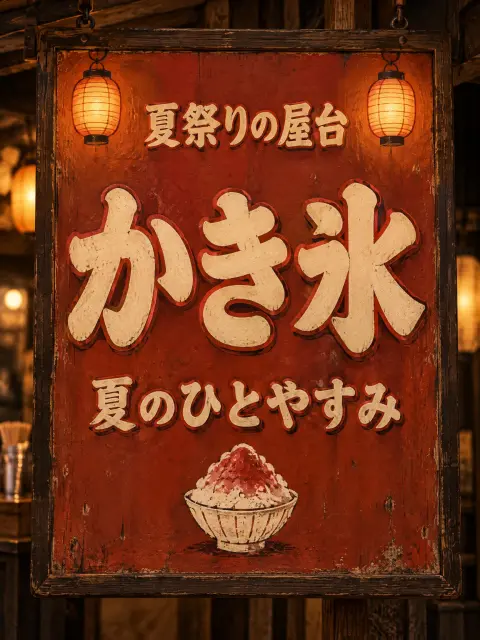
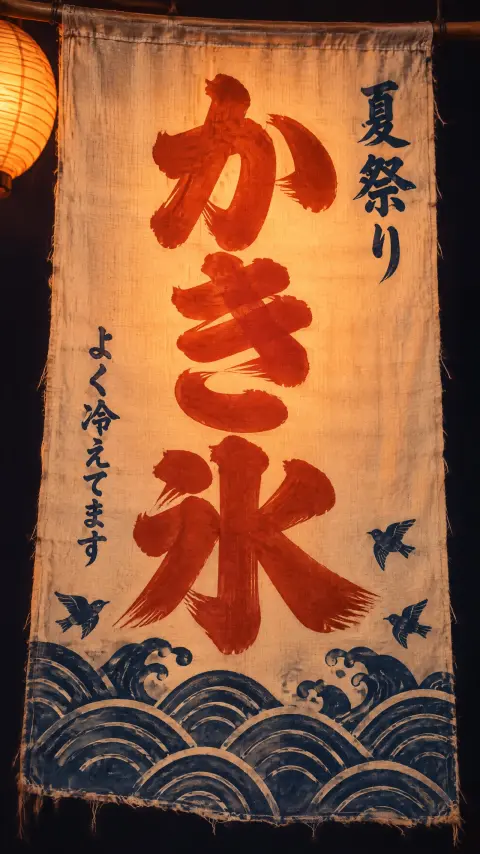
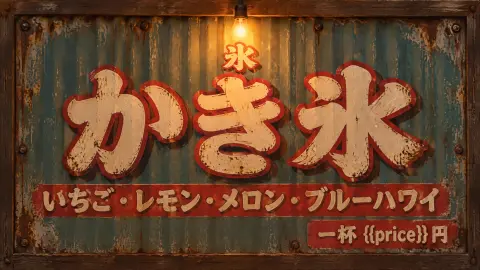
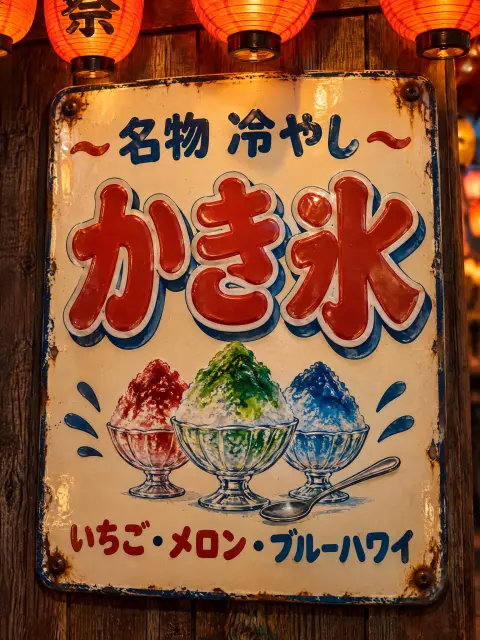
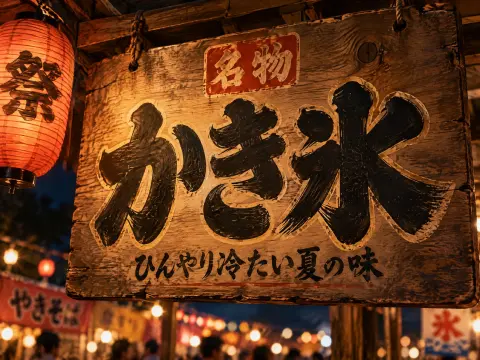
Todos os modelos escreveram かき氷 corretamente. O Claude Opus 5.5 (8.55), o Gemini 4 Argon (8.38) e o GPT-5.6 Terra (8.27) tiraram as notas mais altas com faixas de tecido tingido e placas esmaltadas. A maioria dos designs acrescentou uma linha curta como "ひんやり" (bem geladinho) ou uma lista de sabores de xarope, o que contou contra eles. Dois designs imprimiram {{price}} e um inventou um preço.
Trabalho 11: Placa de inauguração de padaria alemã
Ein Schild für die Neueröffnung unserer Bäckerei „Großmanns Backstube" in Leipzig. Öffnungszeiten: Mo–Sa 6:30–18 Uhr, So 7–12 Uhr. Gemütlich, aber nicht kitschig. (Uma placa de inauguração da nossa padaria, com o nome e o horário de funcionamento. Aconchegante, mas não brega.)
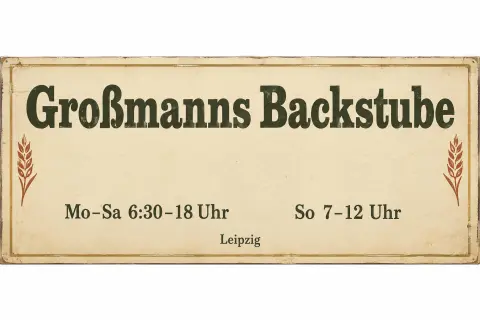
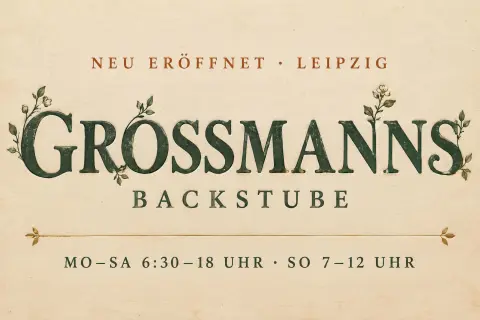
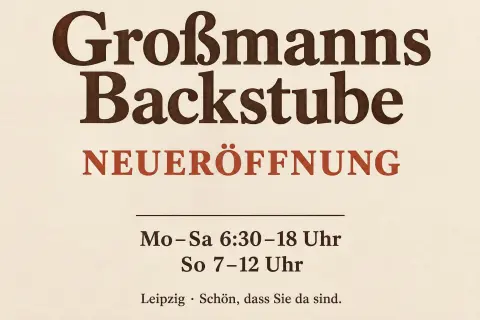
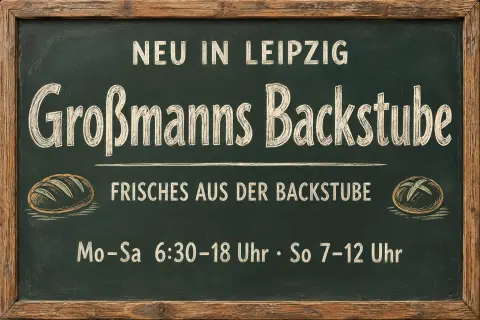
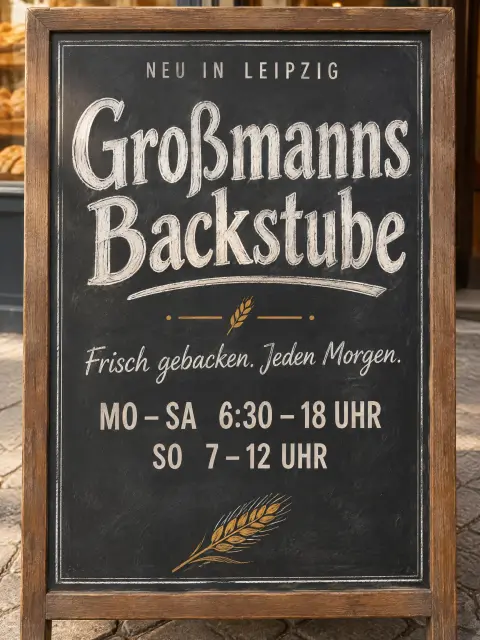
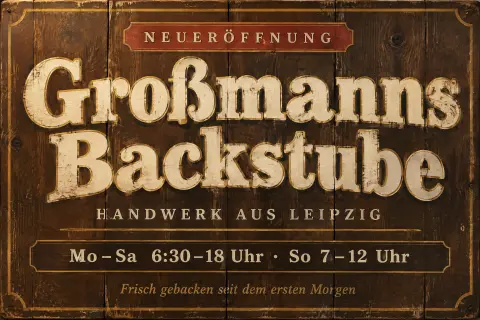
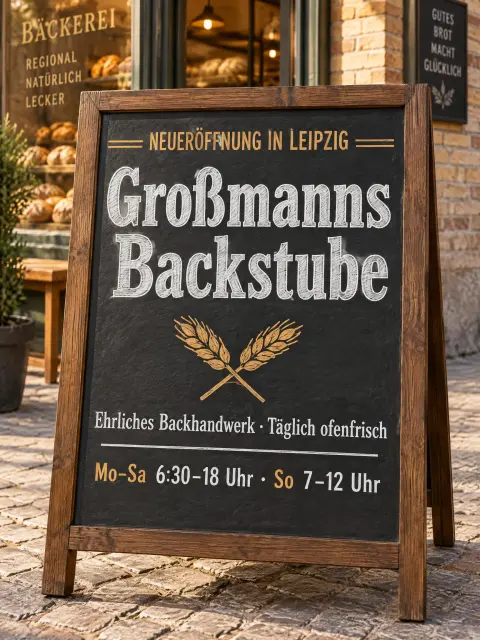
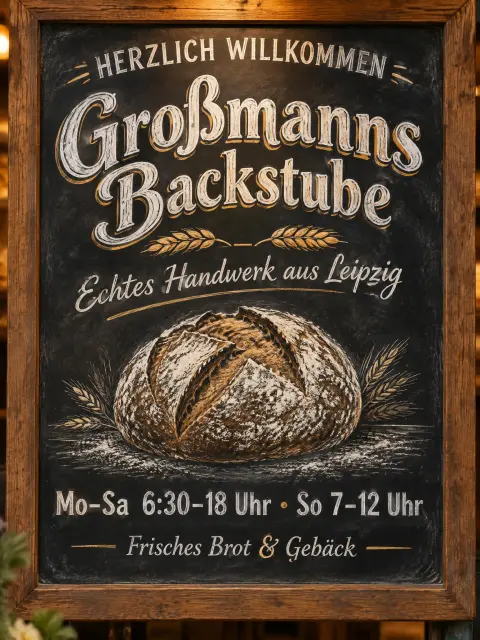
Todos os modelos escreveram Großmanns com o ß. O Claude Sonnet 5.5 tirou a nota mais alta, 8.03, com lettering gasto e contornado sobre madeira. O GPT-6.1 Terra (6.32) e o GPT-6.1 Sol (6.62) compuseram a placa numa tipografia digital chapada, sem nenhum calor. Os três designs do Claude Sonnet 5.5 acrescentaram slogans que a padaria nunca escreveu, como "Frisch gebacken seit dem ersten Morgen" (assado fresquinho desde a primeira manhã), e os do Gemini 3.8 Flash também. O Claude Opus 5.5 falhou nas três rodadas no limite de produção.
Trabalho 12: Convite de Día de Muertos
Invitación para la reunión familiar de Día de Muertos en casa de la abuela Rosa. Domingo 1 de noviembre de 2026, 7 de la noche, Calle Hidalgo 45, Oaxaca. Algo cálido y respetuoso, no de disfraz. (Um convite para o encontro de família do Dia dos Mortos na casa da vó Rosa, com data, horário e endereço. Caloroso e respeitoso, não uma festa à fantasia.)
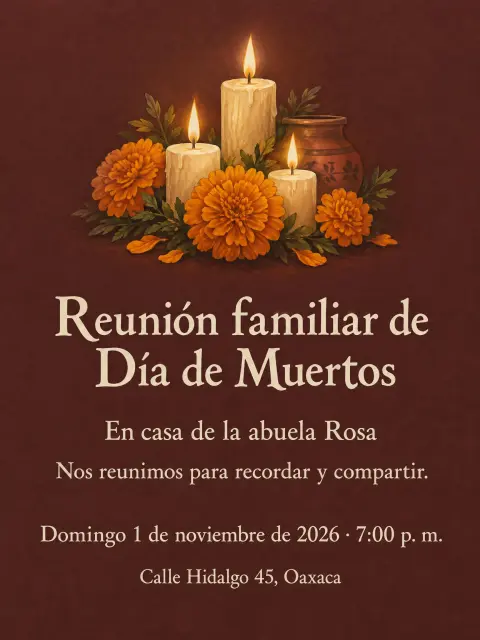
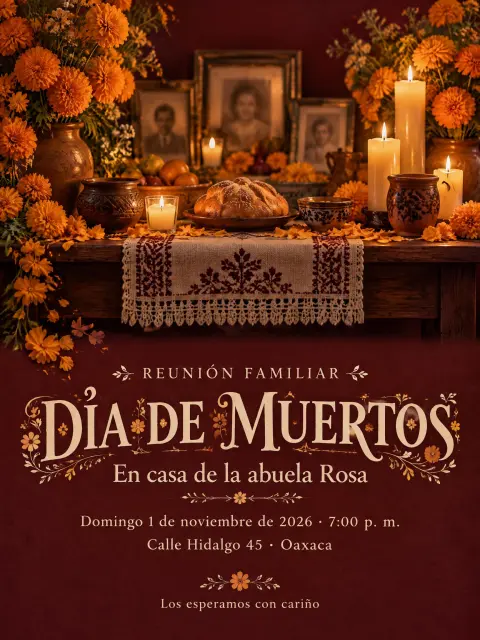
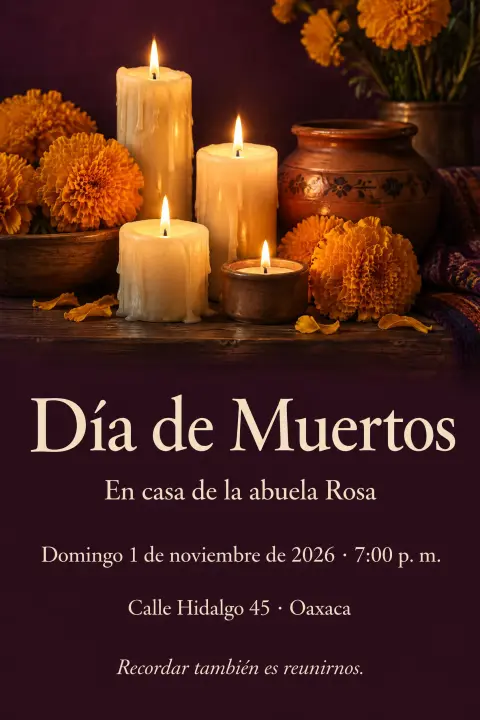
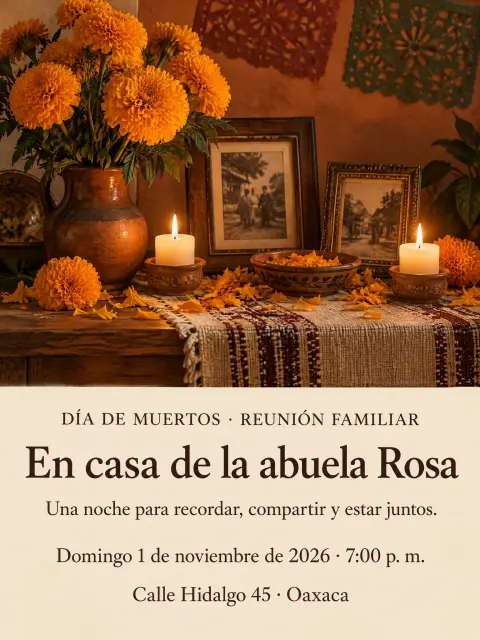
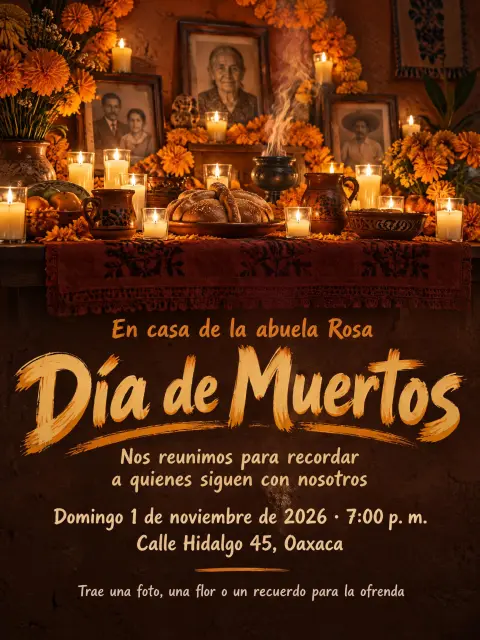
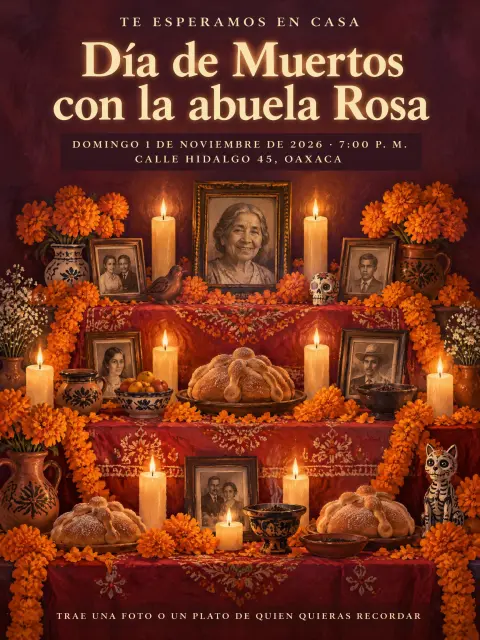
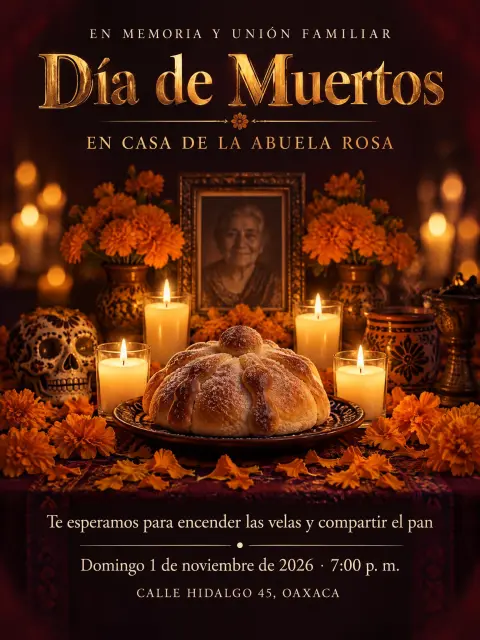
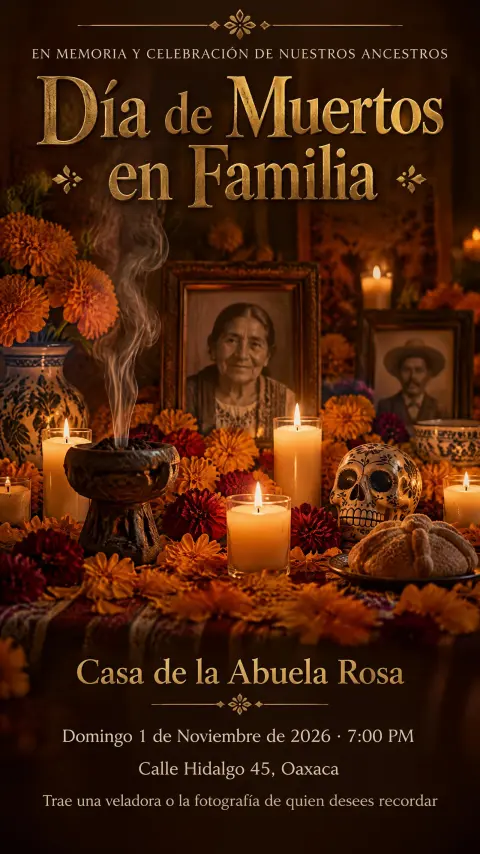
Nenhum design transformou o encontro numa festa à fantasia de Halloween, e todos mantiveram a data e o endereço. Quase todos mudaram "7 de la noche" para "7:00 p. m.". O GPT-5.6 Terra tirou a nota mais alta, 8.22. Um problema mais sutil apareceu em vários designs: o retrato de uma senhora idosa posto no centro do altar, bem ao lado de "abuela Rosa", o que dá a entender que a própria Rosa morreu. O Claude Opus 5.5 falhou nas três rodadas no limite de produção.
Claude Opus 5.5 com um orçamento maior
O FontVibe limita uma proposta de design a 6600 tokens de saída, raciocínio incluído. O Claude Opus 5.5 escreveu propostas mais longas que qualquer outro modelo. As propostas dele chegaram a esse limite em 19 das suas 36 rodadas: 17 foram cortadas e falharam, e 2 ainda assim terminaram. Mais uma rodada falhou por outro motivo: a proposta ficou abaixo do limite, mas as instruções de imagem da segunda etapa voltaram como saída quebrada. Entre os outros modelos, só uma proposta do GPT-6 Luna chegou ao limite, e ela terminou.
Para ver o que o Opus faz quando não é cortado, rodei de novo só as 18 rodadas dele que falharam, com os dois limites de saída dobrados e nada mais mudado. As 18 terminaram. 13 delas usaram mais de 6600 tokens na proposta (mediana de 7286, a mais longa com 8890), e a proposta mediana levou 76 segundos. Os 18 designs tiraram 8.10, e os 36 designs do Opus juntos tiraram 8.04 (IC 95% de 7.70 a 8.30). Comparados briefing por briefing com os outros modelos nos 12 briefings, esses 36 designs tiraram nota claramente maior que o GPT-5.6 Terra (+0.46), o Claude Sonnet 5.5 (+0.60), o GPT-6.1 Sol (+0.68), o Gemini 3.8 Flash (+0.71) e o GPT-6.1 Terra (+0.96), e não puderam ser diferenciados do GPT-6 Luna (+0.35, IC 95% de −0.06 a +0.71) nem do Gemini 4 Argon (+0.48, −0.05 a +0.98).
Essas rodadas extras não estão no ranking principal, porque nenhum outro modelo recebeu um orçamento maior. O limite de 6600 tokens é um limite que o FontVibe definiu para o próprio uso em produção, não um limite do modelo. As rodadas extras mostram que, com orçamento suficiente, o Opus termina todas as vezes e a qualidade dele se mantém, ao preço de um custo maior e de uma espera mais longa. A média dele na tabela principal vem de 18 designs em 8 briefings, e a maioria dos briefings em que ele falhou foram os das camadas 2 a 4, com mais texto para planejar, então essa média se apoia nos briefings mais fáceis; é por isso que ele não entra no ranking ali.
Uma escolha às cegas de alguém que não era o cliente
O fundador do FontVibe olhou um design por modelo em cada trabalho, em ordem aleatória e com os nomes escondidos, e escolheu o que ele usaria. As 12 escolhas dele: Gemini 3.8 Flash 4, Claude Sonnet 5.5 3, GPT-5.6 Terra 2, Gemini 4 Argon 2 e Claude Opus 5.5 1. Ele nunca escolheu o GPT-6 Luna nem nenhum dos dois modelos GPT-6.1.
Entre os oito designs que ele viu em cada trabalho, a escolha dele foi a mais bem avaliada pelos avaliadores em 2 dos 12 trabalhos; ela nunca foi o design mais bem avaliado do trabalho como um todo. A diferença tem uma causa clara: 8 das 12 escolhas dele têm texto que o briefing nunca deu. Em lettering e apelo, as escolhas dele tiraram de 7 a 9 quase sempre, o que mostra que os avaliadores também viram esses designs como visualmente fortes; as escolhas perderam pontos em informação.
Ele interpreta a diferença assim: ele não era o cliente de nenhum desses briefings, então escolheu pela primeira impressão. Um cliente que precisa do design olha primeiro o clima, depois os detalhes, e trata texto errado ou inventado como erro grave. É por isso que as notas dos critérios definem o ranking, e esta escolha é uma observação. Ela também mostra o risco para quem escolhe pela primeira impressão: o design que chama sua atenção primeiro muitas vezes é o que acrescentou texto que você não escreveu.
Cada modelo, em poucas palavras
- Claude Opus 5.5: o melhor lettering e o maior apelo, e poucas linhas inventadas (0.22 por design). As propostas mais longas e o raciocínio mais longo, então precisa de um limite de saída maior que o de produção do FontVibe; o mais lento e de longe o mais caro. Combina com trabalhos complexos sem pressa.
- GPT-6 Luna: o melhor custo-benefício: no grupo de qualidade mais alta, terminou todas as rodadas, legibilidade alta, poucas linhas inventadas e o mais barato por larga margem. O lettering dele é bom, mas não marca.
- GPT-5.6 Terra: rápido e equilibrado. Forte na camada 4 e na maioria dos briefings do dia a dia, mais fraco na camada 3, onde muitas vezes respondeu a um briefing difícil com tipografia simples.
- Gemini 4 Argon: alguns dos materiais mais ricos do teste, e 1.56 linha inventada por design.
- Claude Sonnet 5.5: as propostas mais rápidas e lettering forte, e o maior número de placeholders impressos como estão (5 designs).
- GPT-6.1 Sol: os designs mais legíveis e poucas linhas inventadas, mas lettering sem graça, e lento nas duas etapas (cerca de 87 segundos somadas).
- Gemini 3.8 Flash: visualmente forte, o maior volume de texto inventado (2.36 linhas por design) e o único modelo com erros do fornecedor (8).
- GPT-6.1 Terra: o texto mais limpo e os designs mais sem graça.
Limites deste teste
- Os avaliadores rodam no Claude Opus 5.5, que também é um dos modelos testados. As imagens eram anônimas, mas os avaliadores e um dos concorrentes usam o mesmo modelo, e não foi testado se eles favorecem os designs dele.
- Cada briefing recebeu nota uma vez, de um avaliador numa única passada. Não houve avaliação repetida nem segundo avaliador.
- A nota principal do Claude Opus 5.5 vem de 18 designs em 8 briefings, a maioria os mais fáceis.
- Um único modelo de imagem renderizou todos os designs. Outro modelo de imagem poderia mudar o peso das instruções do designer no resultado.
- Cada modelo rodou cada briefing três vezes, e cada rodada renderizou só a primeira das três direções propostas. Com 12 briefings, a maioria das diferenças entre os modelos é pequena demais para ser diferenciada; 28 pares foram comparados sem correção para comparações múltiplas.
- O padrão de avaliação cobre designs com texto. Imagens sem texto não foram testadas.
- Todos os modelos usaram os prompts e limites de produção do FontVibe. Os prompts ou limites de outro app poderiam favorecer outros modelos.
- Os resultados descrevem estas versões dos modelos em 30 de outubro de 2026.
Todos os designs estão públicos no FontVibe e toda nota tem um motivo escrito. Os briefings, todas as propostas, as instruções para o modelo de imagem, as notas e os motivos estão no dataset aberto AI Design Benchmark (CC BY 4.0), com todas as tentativas e um script que recalcula todas as tabelas deste artigo. Os prompts de produção do FontVibe não são publicados; pesquisadores que precisarem deles podem pedir em hello@fontvibe.ai.
Apêndice: todas as notas
Nota geral média por modelo e trabalho nas rodadas que terminaram (número de rodadas terminadas entre parênteses quando menos de 3).
| Trabalho | GPT-6.1 Terra | GPT-5.6 Terra | GPT-6.1 Sol | GPT-6 Luna | Claude Opus 5.5 | Claude Sonnet 5.5 | Gemini 4 Argon | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|---|---|
| 1. logotipo de torrefação de café | 6.62 | 8.13 | 6.43 | 8.05 | 8.38 | 7.50 | 7.53 | 7.92 |
| 2. pôster de aniversário com dinossauros | 8.43 | 8.33 | 8.73 | 8.17 | 8.20 | 7.03 | 6.48 | 7.33 |
| 3. pôster de festa de formatura | 6.37 | 7.03 | 7.07 | 7.28 | 7.50 (1) | 7.13 | 8.40 | 8.28 |
| 4. thumbnail do YouTube | 7.18 | 7.12 | 7.27 | 7.97 | 6.53 | 8.20 | 7.88 | 7.75 |
| 5. pôster de vagas | 7.20 | 6.98 | 7.30 | 7.43 | falhou | 7.92 | 7.50 | 6.12 |
| 6. cinta de copo de café | 7.83 | 8.30 | 7.58 | 7.93 | 8.97 (2) | 8.38 | 7.27 | 7.25 |
| 7. logotipo de casa noturna | 5.48 | 5.90 | 6.67 | 7.25 | 7.88 | 7.28 | 8.13 | 8.05 |
| 8. capa de revista científica | 6.22 | 7.47 | 7.65 | 7.43 | falhou | 6.63 | 7.28 | 6.68 |
| 9. placa de estúdio de tatuagem | 7.53 | 7.80 (2) | 7.33 | 7.95 | 8.25 (2) | 6.78 | 6.37 | 6.38 |
| 10. placa de barraca de raspadinha | 8.20 | 8.27 | 7.78 | 7.45 | 8.55 (1) | 6.98 | 8.38 | 7.80 |
| 11. placa de inauguração de padaria | 6.32 | 7.43 | 6.62 | 7.25 | falhou | 8.03 | 7.78 | 7.02 |
| 12. convite de Día de Muertos | 7.57 | 8.22 | 7.80 | 8.08 | falhou | 7.32 | 7.68 | 7.40 |
Todas as comparações entre pares
Cada par é comparado nos briefings em que os dois modelos terminaram designs: a diferença média das notas por briefing (primeiro modelo menos o segundo), com intervalo de confiança de 95%. Quando o intervalo inclui o zero, os dois não podem ser diferenciados neste teste.
| Modelo | Comparado com | Briefings | Diferença (IC 95%) | Claramente maior |
|---|---|---|---|---|
| Claude Opus 5.5 | GPT-6 Luna | 8 | +0.28 (−0.27 a +0.73) | empate |
| Claude Opus 5.5 | GPT-5.6 Terra | 8 | +0.42 (0.00 a +0.96) | empate |
| Claude Opus 5.5 | Gemini 4 Argon | 8 | +0.48 (−0.33 a +1.29) | empate |
| Claude Opus 5.5 | Claude Sonnet 5.5 | 8 | +0.62 (−0.11 a +1.18) | empate |
| Claude Opus 5.5 | GPT-6.1 Sol | 8 | +0.68 (+0.10 a +1.27) | Claude Opus 5.5 |
| Claude Opus 5.5 | Gemini 3.8 Flash | 8 | +0.44 (−0.27 a +1.15) | empate |
| Claude Opus 5.5 | GPT-6.1 Terra | 8 | +0.83 (+0.20 a +1.47) | Claude Opus 5.5 |
| GPT-6 Luna | GPT-5.6 Terra | 12 | +0.11 (−0.19 a +0.43) | empate |
| GPT-6 Luna | Gemini 4 Argon | 12 | +0.13 (−0.35 a +0.62) | empate |
| GPT-6 Luna | Claude Sonnet 5.5 | 12 | +0.25 (−0.10 a +0.60) | empate |
| GPT-6 Luna | GPT-6.1 Sol | 12 | +0.33 (+0.03 a +0.66) | GPT-6 Luna |
| GPT-6 Luna | Gemini 3.8 Flash | 12 | +0.36 (−0.08 a +0.77) | empate |
| GPT-6 Luna | GPT-6.1 Terra | 12 | +0.61 (+0.21 a +0.98) | GPT-6 Luna |
| GPT-5.6 Terra | Gemini 4 Argon | 12 | +0.02 (−0.63 a +0.64) | empate |
| GPT-5.6 Terra | Claude Sonnet 5.5 | 12 | +0.15 (−0.39 a +0.68) | empate |
| GPT-5.6 Terra | GPT-6.1 Sol | 12 | +0.23 (−0.12 a +0.63) | empate |
| GPT-5.6 Terra | Gemini 3.8 Flash | 12 | +0.25 (−0.38 a +0.78) | empate |
| GPT-5.6 Terra | GPT-6.1 Terra | 12 | +0.50 (+0.21 a +0.81) | GPT-5.6 Terra |
| Gemini 4 Argon | Claude Sonnet 5.5 | 12 | +0.13 (−0.28 a +0.55) | empate |
| Gemini 4 Argon | GPT-6.1 Sol | 12 | +0.21 (−0.42 a +0.76) | empate |
| Gemini 4 Argon | Gemini 3.8 Flash | 12 | +0.23 (−0.08 a +0.53) | empate |
| Gemini 4 Argon | GPT-6.1 Terra | 12 | +0.48 (−0.25 a +1.16) | empate |
| Claude Sonnet 5.5 | GPT-6.1 Sol | 12 | +0.08 (−0.47 a +0.60) | empate |
| Claude Sonnet 5.5 | Gemini 3.8 Flash | 12 | +0.10 (−0.35 a +0.61) | empate |
| Claude Sonnet 5.5 | GPT-6.1 Terra | 12 | +0.35 (−0.24 a +0.91) | empate |
| GPT-6.1 Sol | Gemini 3.8 Flash | 12 | +0.02 (−0.55 a +0.57) | empate |
| GPT-6.1 Sol | GPT-6.1 Terra | 12 | +0.27 (−0.02 a +0.60) | empate |
| Gemini 3.8 Flash | GPT-6.1 Terra | 12 | +0.25 (−0.40 a +0.96) | empate |
O padrão de avaliação
As instruções dos avaliadores, em resumo: você é o cliente que escreveu o briefing e vai usar este design. Julgue nesta ordem: se é o que você pediu; se cada texto pode ser usado como está; se tem o clima que você queria, dito ou razoavelmente implícito; com que qualidade o lettering, os materiais, as texturas, os traços e as cores foram feitos; e se causa impacto à primeira vista. Cada uma das quatro notas cobre a sua própria pergunta, e um problema só é descontado uma vez, na nota a que pertence.
Perguntas frequentes
O GPT-6.1 Terra é melhor que o GPT-5.6 Terra em design?
Não neste teste. Comparando briefing por briefing, o GPT-6.1 Terra tirou 0.50 ponto a menos que o GPT-5.6 Terra numa escala de 10 pontos, com intervalo de confiança de 95% de −0.81 a −0.21, e tirou nota menor em 9 dos 12 briefings. O texto dele saiu mais limpo, mas o lettering ficou mais chapado e com menos apelo. Os dois modelos usaram os mesmos prompts e as mesmas configurações; o resultado descreve como ele lê um briefing, escolhe uma direção e escreve instruções de imagem, não como ele se sai em outras tarefas.
Qual modelo de linguagem é o melhor designer?
Só em qualidade de design, a maioria dos oito não pôde ser diferenciada neste teste; só o GPT-6.1 Terra e o GPT-6.1 Sol ficaram claramente atrás. O Claude Opus 5.5 teve a maior média, mas não foi claramente melhor que o GPT-6 Luna ou o Gemini 4 Argon, e custou muito mais e foi mais lento. O GPT-6 Luna ficou no grupo de qualidade mais alta, terminou todas as rodadas e custou $0.005 por design, de longe o melhor custo-benefício. Para uso em tempo real, o GPT-5.6 Terra foi rápido e equilibrado.
Designers de IA inventam texto?
Sim. O Gemini 3.8 Flash acrescentou em média 2.36 linhas por design que o briefing nunca deu, como anos de fundação, slogans e estatísticas falsas. O GPT-6.1 Terra foi o que menos acrescentou, 0.17 linha por design. Texto inventado foi o motivo mais comum para um design perder pontos em informação.
Quanto custa um designer de IA por design?
Pelo preço público de cada fornecedor em 30 de outubro de 2026, a parte do modelo de linguagem de um design custou uma mediana de $0.005 com o GPT-6 Luna, $0.04 com o GPT-6.1 Terra ou o Gemini 3.8 Flash, $0.09 com o GPT-5.6 Terra ou o GPT-6.1 Sol, $0.11 com o Gemini 4 Argon, $0.18 com o Claude Sonnet 5.5 e $0.41 com o Claude Opus 5.5. A geração da imagem não está incluída.
Posso testar esses designers de IA eu mesmo?
O modo de design do FontVibe usa o mesmo pipeline testado aqui. Você descreve o que precisa, ele propõe direções de design e renderiza a que você escolher.
Pronto para experimentar?
Coloque essas técnicas de prompt em prática — sem precisar de conta para começar.
✦ Começar a criarAdicione a FontVibe como fonte preferida no Google
Coloque essas técnicas de prompt em prática — sem precisar de conta para começar.
Comece a criar
Comentários