Qwen Image 3.0 vs GPT Image, Nano Banana, Seedream e Grok
Dei os mesmos 10 prompts cheios de texto ao Qwen Image 3.0 Pro e a quatro modelos rivais e avaliei a primeira imagem de cada um. Sem escolher.
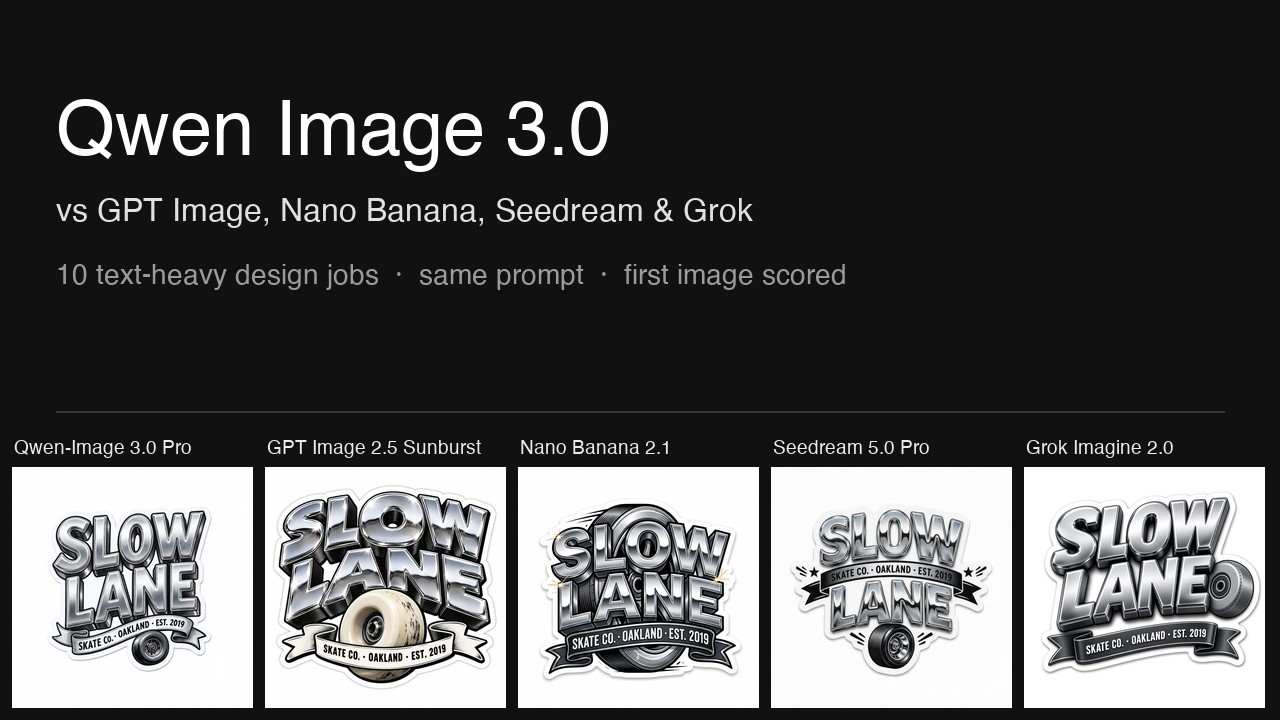
O Qwen Image 3.0 Pro é o modelo de imagem da Alibaba. Segundo os criadores, ele renderiza texto de até 10 pixels, renderiza 12 idiomas nativamente e dá conta de layouts com muita informação. Testei o modelo contra outros quatro modelos de imagem em 10 trabalhos de design que têm texto: um convite, um adesivo, um pôster, uma programação de conferência, um rótulo de chá bilíngue, um pôster japonês em escrita vertical, um logo, uma foto, uma edição e um trabalho com duas referências. Cada modelo recebeu o mesmo prompt, e dei nota à primeira imagem que cada um devolveu.
As cinco configurações, todas em resolução 2K:
- Qwen Image 3.0 Pro (Alibaba). O Qwen Image 3.0 Pro tem duas resoluções, 1K e 2K, e nenhuma configuração de qualidade. A reescrita de prompt embutida estava desligada, então ele recebeu o prompt sem mudanças, como os outros quatro.
- GPT Image 2.5 Sunburst (OpenAI), qualidade High. O GPT Image 2.5 tem cinco configurações de qualidade: Low, Medium, High, Extra High e Max. Testei a High, que é a padrão no FontVibe. Extra High e Max não foram testadas.
- Nano Banana 2.1 (Google). O Nano Banana 2.1 não tem configuração de qualidade.
- Seedream 5.0 Pro (ByteDance). O Seedream 5.0 Pro não tem configuração de qualidade.
- Grok Imagine 2.0 (xAI), qualidade Medium. Medium é a configuração mais alta do Grok Imagine 2.0. Meu teste do Grok Imagine 2.0 comparou as configurações Low e Medium, e a Medium tirou nota maior.
Os resultados
| Modelo (configuração) | Legibilidade | Lettering e acabamento | Informação e layout | Apelo | Geral | Tempo mediano | Créditos no FontVibe |
|---|---|---|---|---|---|---|---|
| Grok Imagine 2.0 (Medium) | 9.9 | 8.8 | 8.9 | 8.6 | 9.01 | 95 s | 40 |
| GPT Image 2.5 Sunburst (High) | 9.4 | 9.0 | 8.7 | 8.9 | 8.99 | 41 s | 40 |
| Nano Banana 2.1 | 9.7 | 8.8 | 8.3 | 8.3 | 8.76 | 28 s | 25 |
| Seedream 5.0 Pro | 10.0 | 8.7 | 8.0 | 8.5 | 8.75 | 73 s | 40 |
| Qwen Image 3.0 Pro | 10.0 | 8.8 | 7.7 | 7.8 | 8.57 | 23 s | 40 |
As notas vão até 10 e são a média da primeira imagem de cada um dos 10 trabalhos. O tempo mediano cobre as imagens novas dos trabalhos 1 a 8 e 10, duas por trabalho, em 2K: 18 por modelo, 17 no caso do Seedream 5.0 Pro por causa das falhas descritas no trabalho 10. Os créditos são o custo de uma imagem 2K no FontVibe. Todas as notas individuais estão no apêndice. Numa avaliação às cegas separada, com os nomes dos modelos escondidos, o Qwen Image 3.0 Pro também ficou em último, e o GPT Image 2.5 ficou em primeiro.
O Grok Imagine 2.0 Medium tirou a nota mais alta, 9.01 de 10. O GPT Image 2.5 Sunburst tirou 8.99, 0.02 a menos. O Nano Banana 2.1 tirou 8.76 e o Seedream 5.0 Pro 8.75, 0.01 de diferença. O Qwen Image 3.0 Pro tirou a nota mais baixa, 8.57, 0.18 abaixo do Seedream 5.0 Pro. As cinco médias ficaram a menos de 0.44 ponto umas das outras. Mudar uma nota em 1 ponto num trabalho move a média de um modelo entre 0.02 e 0.035, então a ordem dos dois primeiros, e a ordem do terceiro e do quarto, dependem cada uma de notas isoladas.
O Qwen Image 3.0 Pro e o Seedream 5.0 Pro tiveram a nota de legibilidade mais alta, 10.0: a linha principal de todas as imagens avaliadas deles se lê de relance. O Qwen Image 3.0 Pro teve a nota mais baixa em informação e layout, 7.7, e a nota mais baixa em apelo, 7.8. Três das suas 10 imagens avaliadas alteraram ou escreveram errado uma linha pedida, no trabalho 5 ele desenhou uma lata de chá em vez do rótulo que o prompt pedia, e a programação dele é o layout mais simples desse trabalho. Ele não tirou a nota mais alta em nenhum trabalho.
O GPT Image 2.5 foi testado na High, a terceira das suas cinco configurações de qualidade. Os outros quatro modelos foram testados na sua configuração mais alta. Este teste não mostra que nota o GPT Image 2.5 tiraria em Extra High ou Max.
Precisão do texto
Nas 50 imagens avaliadas, 47 têm todas as linhas pedidas escritas corretamente. As três que não têm são todas do Qwen Image 3.0 Pro:
- Trabalho 1: "Mia's" virou "MiA'S", com letras maiúsculas no meio do nome.
- Trabalho 4: a URL do rodapé, "formfunction.design", virou "formfunction.deign".
- Trabalho 9: a edição devia manter o "18+" sem mudança, e ele virou "$Z+".
Problemas menores nas imagens avaliadas dos outros modelos:
- GPT Image 2.5, trabalho 8: acrescentou uma lousa com cinco pratos que o prompt não pedia, e uma linha dessa lousa tem letras embaralhadas e ilegíveis. O "·" da placa de cardápio pedida virou uma linha ondulada.
- Nano Banana 2.1, trabalho 8: o "·" da placa de cardápio está fora do lugar.
- Linhas que o prompt não pedia: o Seedream 5.0 Pro acrescentou "ONE-DAY DESIGN CONFERENCE" no trabalho 4; o Nano Banana 2.1 acrescentou "WEEKEND ART EVENT" no trabalho 10; o Grok Imagine 2.0 repetiu "OPEN STUDIO" no trabalho 10; o Qwen Image 3.0 Pro copiou "NEON OUTLINE" de uma imagem de referência no trabalho 10.
- O GPT Image 2.5 e o Nano Banana 2.1 acrescentaram cada um um carimbo vermelho com caracteres ao rótulo de chá do trabalho 5, que pedia nenhum outro texto.
As três promessas do Qwen Image 3.0, conferidas
Promessa 1: texto de até 10 pixels. Confirmada em parte. O trabalho 4 pedia 10 linhas de texto de programação. As 10 linhas da imagem do Qwen Image 3.0 Pro estão nítidas e legíveis, e a nota de legibilidade dele foi 10. Mas a URL do rodapé perdeu uma letra ("formfunction.deign"), e o mesmo erro apareceu em 3 das 4 imagens de programação do Qwen (as duas imagens 1K e a primeira imagem 2K). Os outros quatro modelos escreveram a URL corretamente em todas as suas 8 imagens de programação.
Promessa 2: 12 idiomas renderizados nativamente. Confirmada para os dois idiomas testados. No trabalho 5, o Qwen Image 3.0 Pro escreveu corretamente as quatro linhas em chinês e inglês, em chinês simplificado, incluindo o 〇 de "二〇二七年春". No trabalho 6, ele compôs as três linhas em japonês na vertical e corretamente. Os outros 10 idiomas não foram testados.
Promessa 3: layouts com muita informação. Não confirmada por este teste. A programação do Qwen Image 3.0 Pro no trabalho 4 tirou 7.4, a nota mais baixa desse trabalho: texto preto numa página branca, sem agrupamento e com uma grande área vazia embaixo. A média dele em informação e layout, 7.7, foi a mais baixa dos cinco modelos.
Como testei
Os 10 trabalhos. Os trabalhos 1 e 3 usam os mesmos prompts do meu teste do Grok Imagine 2.0 e do meu teste anterior com sete ferramentas de design com IA. Os outros oito prompts são novos.
- Convite de aniversário infantil (3:4): letras de balão brilhantes, três linhas de detalhes
- Adesivo de skate shop (1:1): letras 3D cromadas e encorpadas, uma linha numa faixa, isolado no branco
- Pôster de show (2:3): letras de fogo derretido, quatro linhas de detalhes
- Programação de conferência (3:4): 8 horários, um travessão, uma barra e uma URL
- Rótulo de lata de chá (3:4): caligrafia chinesa a pincel com uma linha em inglês
- Pôster de livraria japonesa (2:3): todas as linhas na vertical
- Emblema de marca outdoor (1:1): um monograma "FW" e o nome completo em versaletes
- Foto de um food truck (3:2): letras pintadas no caminhão e uma placa de cardápio
- Editar uma imagem existente (2:3): trocar uma data e um preço, manter todo o resto
- Duas imagens de referência (3:4): layout da imagem 1, lettering da imagem 2
O teste cobre imagens de design com texto. Retratos, paisagens e outras imagens sem texto não foram testados. O prompt completo de cada trabalho está na seção dele, mais abaixo. As regras:
- Todos os modelos receberam o mesmo prompt, palavra por palavra, pelo modo DIY do FontVibe, que envia o prompt ao modelo sem mudanças. Sem reescrita de prompt e sem presets de estilo.
- A proporção foi definida como parâmetro, igual para todos os modelos.
- Cada configuração fez duas imagens por trabalho. Só a primeira imagem recebeu nota e aparece aqui. A segunda imagem serviu só para conferir se a grafia se mantinha. Quando a primeira imagem falhou, ela foi refeita uma vez, e a primeira imagem bem-sucedida é a que recebeu nota.
- Todas as imagens foram geradas em 21 de outubro de 2026 e estão públicas no FontVibe.
Os critérios de avaliação
Os critérios são o padrão interno do FontVibe para avaliar designs gerados, escritos em outubro de 2026, antes deste teste. São os mesmos critérios usados no teste do Grok Imagine 2.0. Cada imagem recebe quatro notas de 1 a 10, e anotei o motivo de cada desconto antes de dar o número.
| O que avaliei | Peso | O que observei |
|---|---|---|
| Legibilidade | 20% | Primeiro, uma checagem de erros graves: letras embaralhadas, texto cortado, texto coberto por outros elementos, formas de letra quebradas. Sem erro grave, a nota vai de 7 a 10, conforme a facilidade de ler a linha principal. Qualquer erro grave, de 1 a 4. |
| Lettering e acabamento | 35% | Se a imagem tem o efeito de letra que o prompt pediu (balões, cromado, fogo, pincel, neon) e com que qualidade ele foi feito. |
| Informação e layout | 25% | Primeiro, se a imagem é aquilo que o prompt pediu e se a informação está completa e correta: todas as linhas do prompt estão presentes, com a grafia e a pontuação escritas no prompt, e nada que o prompt não pediu foi acrescentado. Cada linha ou sinal faltando, alterado ou acrescentado custa pelo menos 1 ponto. Depois, se a linha mais importante é lida primeiro e se as linhas estão na ordem certa. |
| Apelo | 20% | Se a imagem parece feita por um designer profissional. |
A nota geral é calculada, não julgada: 0.20 × legibilidade + 0.35 × lettering + 0.25 × informação e layout + 0.20 × apelo.
Quatro observações sobre como os critérios foram aplicados. A legibilidade é julgada pela linha principal, como dizem os critérios; linhas secundárias pequenas ou claras demais para ler com facilidade entraram em informação e layout. Um tratamento consistente todo em maiúsculas, como "WITH SPECIAL GUESTS", não contou como alteração, mas maiúsculas soltas no meio de uma palavra, como em "MiA'S", contaram. Letras embaralhadas numa placa ou lousa grande o bastante para alguém tentar ler contaram como erro grave, como no teste do Grok Imagine 2.0; rótulos minúsculos de fundo, que não dá para ler na resolução da própria imagem, não contaram. Quando o prompt pedia um arquivo de design, como um rótulo ou uma programação impressa, e a imagem mostrava isso como um objeto fotografado, informação e layout perdeu 3 pontos, porque o resultado não pode ir para a gráfica do jeito que está.
Eu sabia qual modelo tinha feito cada imagem enquanto dava a nota. Para checar viés, também fiz uma avaliação às cegas com os nomes dos modelos escondidos.
Os trabalhos 9 e 10 partem de imagens existentes. As três imagens vieram da galeria pública do FontVibe, e nenhuma foi feita pelos cinco modelos testados. As três foram feitas pelo Seedream 5.0, o modelo anterior da mesma família do Seedream 5.0 Pro.
Trabalho por trabalho
Trabalho 1: Convite de aniversário infantil
Birthday party invitation for my daughter, "Mia's 7th Birthday" in glossy balloon letters, "Saturday, Nov 14 · 2 PM", "Sunny Park Pavilion", "RSVP by Nov 7", bright and playful, portrait card
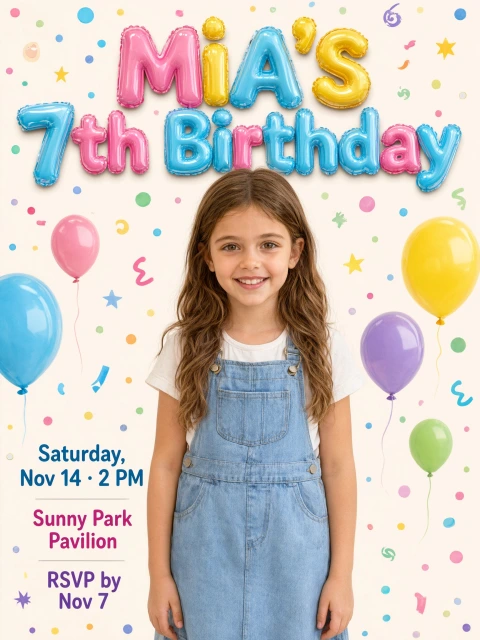
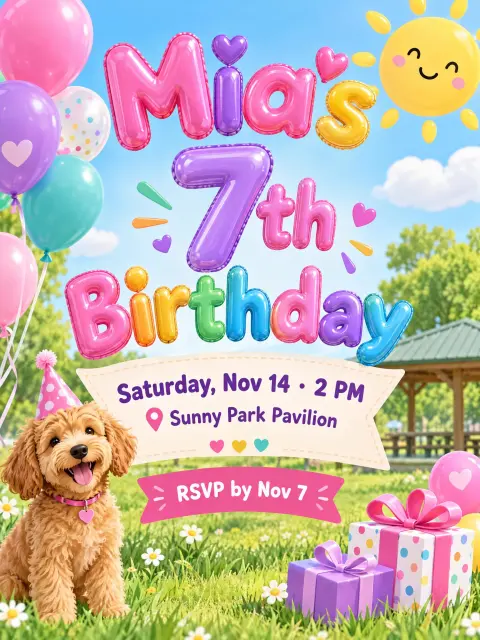
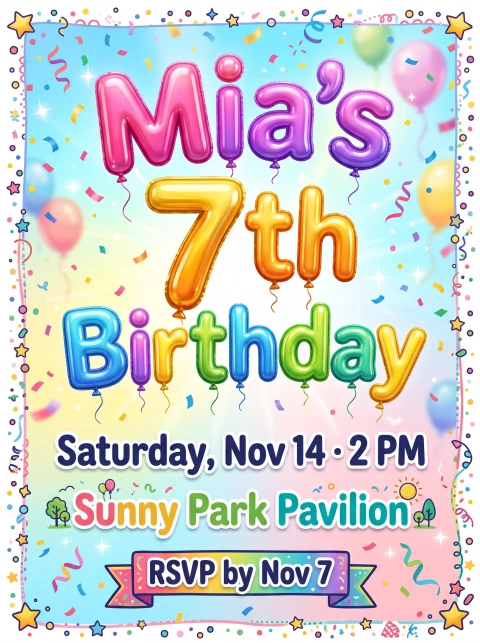
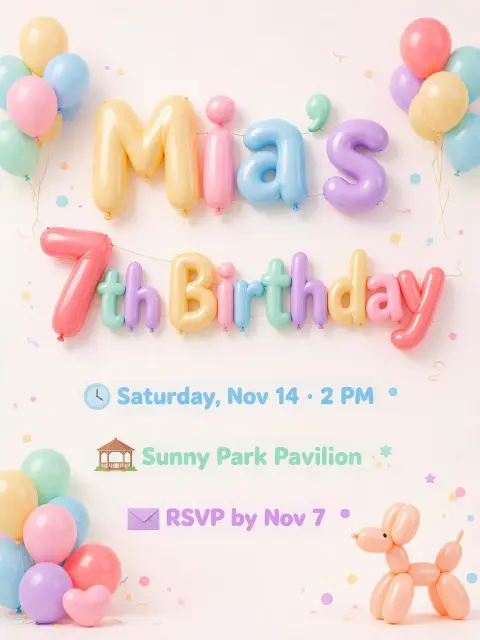
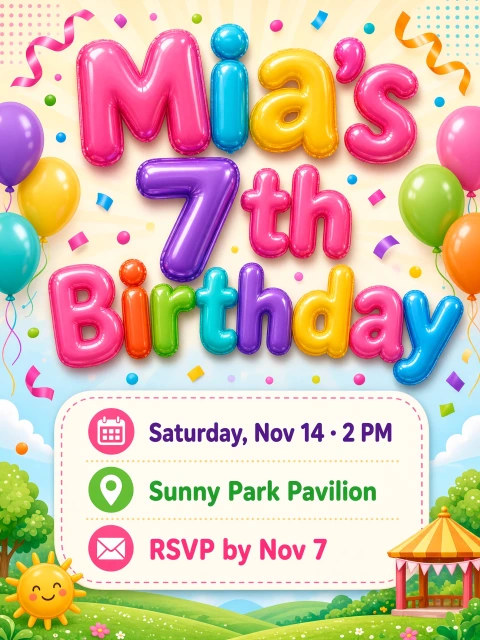
O GPT Image 2.5 e o Grok Imagine 2.0 empataram na nota mais alta, 9.2. Os dois agruparam com clareza as três linhas de detalhes, o GPT Image 2.5 numa faixa e o Grok num cartão com ícones. O Qwen Image 3.0 Pro tirou a nota mais baixa, 8.3: escreveu o nome como "MiA'S", e a foto de uma menina ocupa o centro do convite, o que deixa as três linhas de detalhes numa coluna estreita à esquerda. O Seedream 5.0 Pro pôs as três linhas de detalhes em texto claro sobre fundo claro, o que custou um ponto em informação e layout. Para letras de balão como preset, veja o estilo bubble letter.
Trabalho 2: Adesivo de skate shop
Die-cut sticker for my skate shop, "SLOW LANE" in chunky chrome 3D lettering, small "SKATE CO. · OAKLAND · EST. 2019" on a ribbon banner underneath, a skateboard wheel graphic, thick white sticker border, isolated on plain white
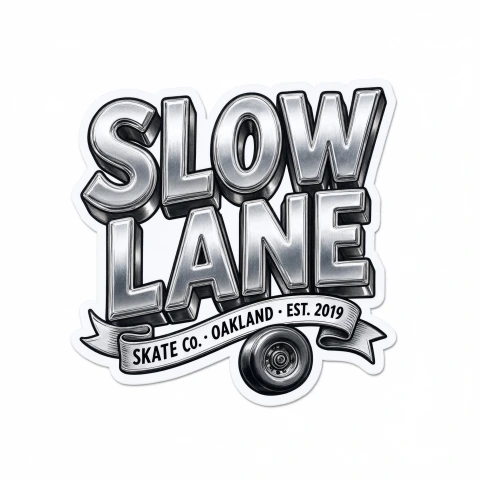
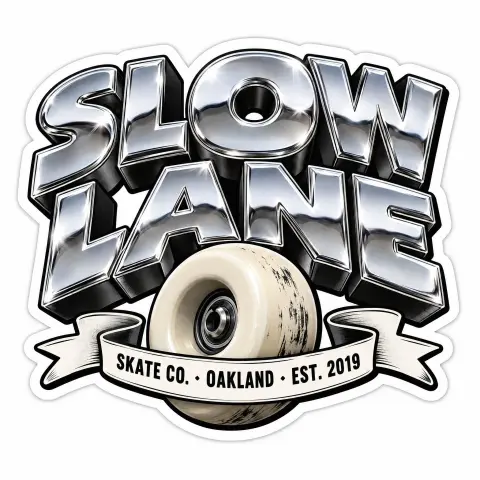
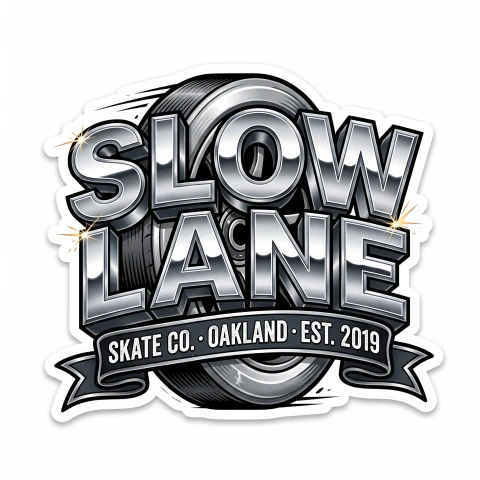
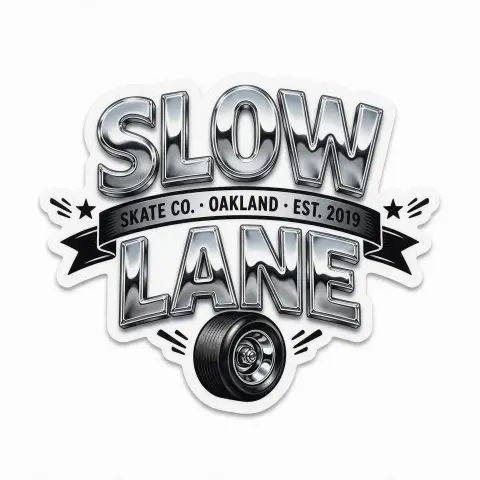
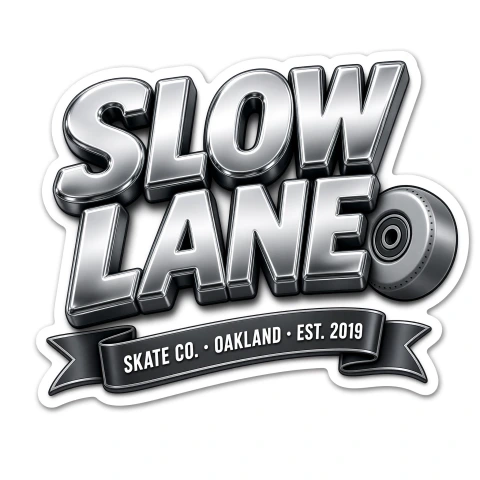
Os cinco modelos escreveram as duas linhas corretamente. O GPT Image 2.5 e o Nano Banana 2.1 empataram na nota mais alta, 9.2: as letras cromadas do GPT Image 2.5 têm a maior profundidade, e o Nano Banana 2.1 pôs uma roda grande atrás das letras. O Qwen Image 3.0 Pro e o Grok Imagine 2.0 tiraram 9.0. O Seedream 5.0 Pro tirou a nota mais baixa, 8.15, porque pôs a faixa entre "SLOW" e "LANE", e não embaixo. Para letras cromadas como preset, veja o estilo de texto metálico.
Trabalho 3: Pôster de show
A3 gig poster for my band "BURNING ORCHARD", band name in molten fire lettering as the main focus, "with special guests THE LOW TIDES", "SAT 14 NOV · DOORS 8 PM", "THE CELLAR · 22 MILL STREET", "TICKETS £12 ON THE DOOR", gritty rock atmosphere with burning trees
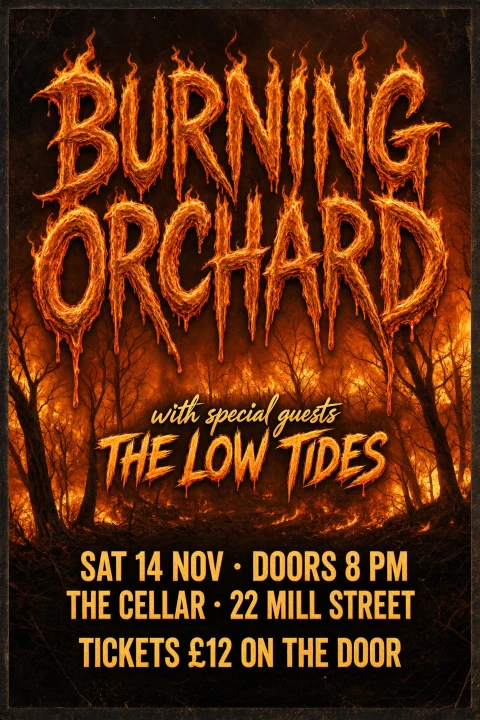
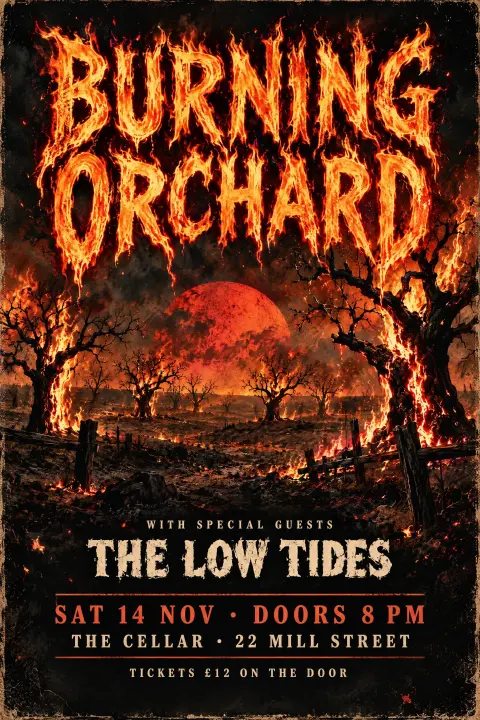
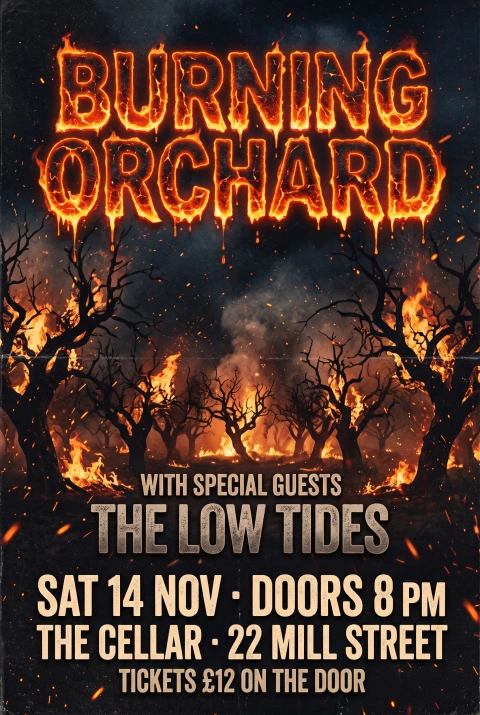
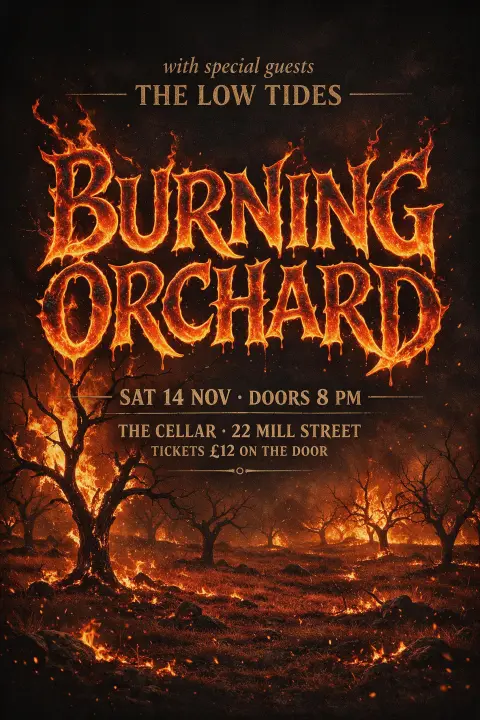
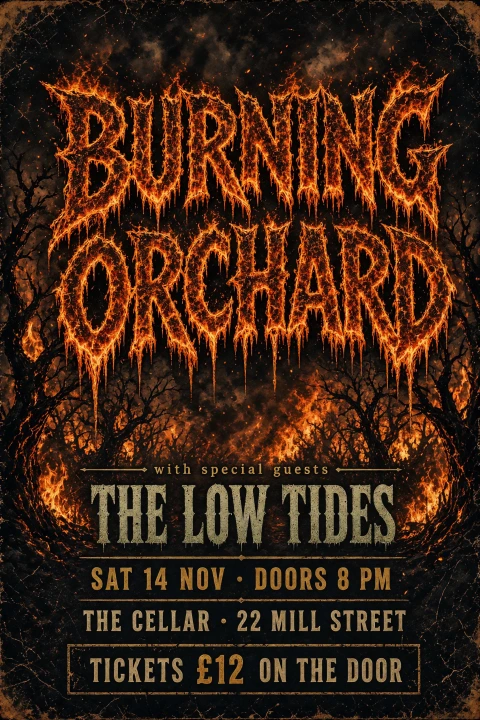
O GPT Image 2.5 tirou a nota mais alta, 9.2: legibilidade 10 e 9 em cada uma das outras três notas, com uma lua vermelho-sangue sobre o pomar em chamas. O Qwen Image 3.0 Pro, o Nano Banana 2.1 e o Grok Imagine 2.0 tiraram 9.0; o Qwen e o Nano Banana 2.1 tiraram 8 em apelo, e o Grok tirou 9 em legibilidade. O Qwen escreveu a banda de abertura num script desenhado à mão que a separa da atração principal. A textura de fogo do Grok é a mais pesada dos cinco, então o título dele pede uma segunda olhada. O Seedream 5.0 Pro tirou 8.5 porque pôs a banda de abertura acima da atração principal, o mesmo erro de ordem do cartaz que cometeu com este prompt no teste do Grok Imagine 2.0. Para letras de fogo como preset, veja o estilo de texto de fogo.
Trabalho 4: Programação de conferência
Printed schedule for a one-day design conference, title "FORM & FUNCTION 2027" in bold geometric lettering, then this exact list, one line each: "09:00 Registration & Coffee", "09:30 Opening Keynote — Ada Moreno", "10:15 Type in Motion", "11:00 Panel: Designing for Screens", "12:30 Lunch Break", "13:30 Workshop A / Workshop B", "15:00 Color Systems at Scale", "16:00 Closing Talk — Ken Ito", and a small footer "Hall 3 · Riverside Center · formfunction.design"
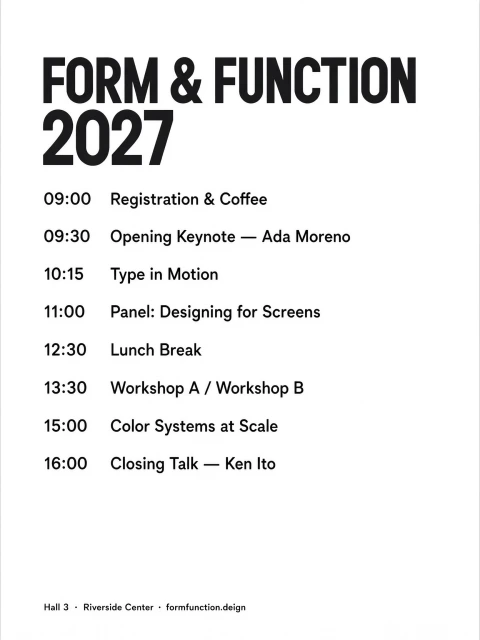
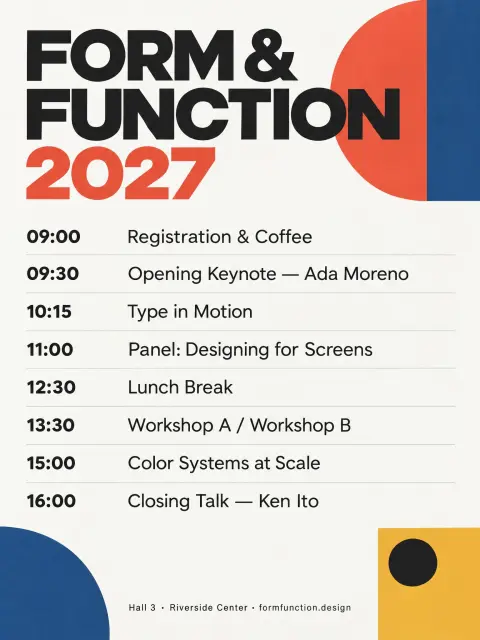
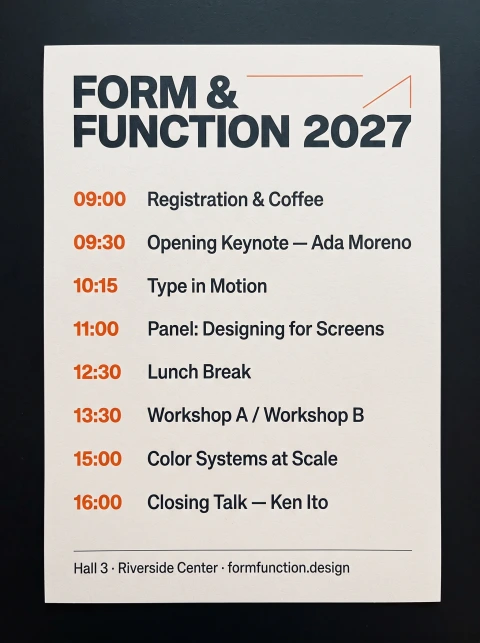
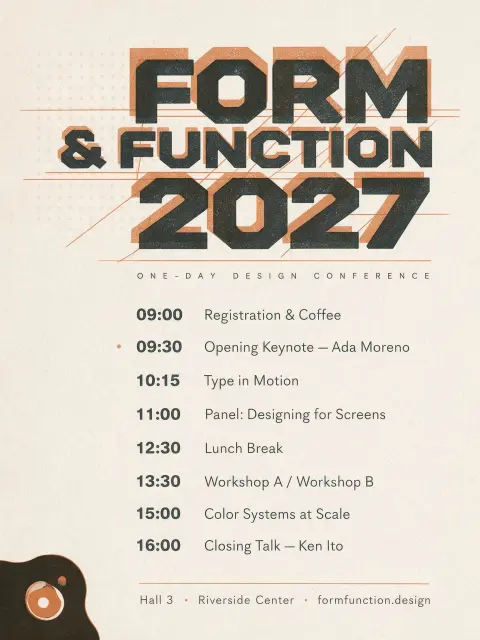
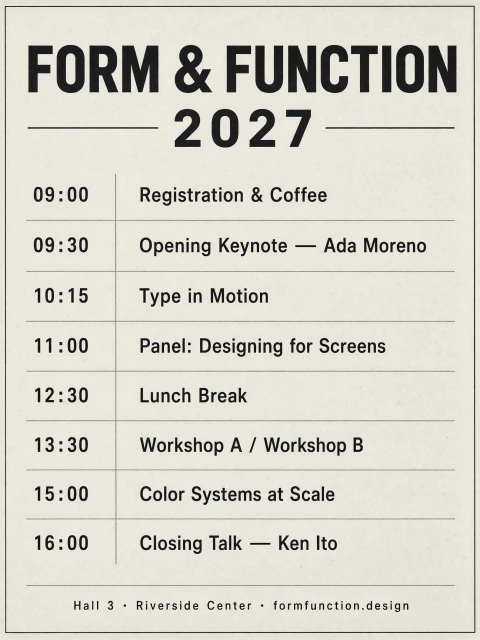
O GPT Image 2.5 tirou a nota mais alta, 9.2, com um título em estilo Bauhaus, blocos de cor e um fio entre cada horário. Os cinco modelos escreveram corretamente os 8 horários, os travessões e a barra nas suas imagens avaliadas. O Nano Banana 2.1 tem o texto maior e mais nítido, mas entregou a foto de um cartão impresso sobre uma mesa escura em vez da própria programação, e tirou 7.9. O Qwen Image 3.0 Pro e o Grok Imagine 2.0 fizeram o título numa sem serifa condensada, e não no lettering geométrico que o prompt pedia; o Grok tirou 8.3. O Qwen Image 3.0 Pro também escreveu a URL do rodapé como "formfunction.deign" e tirou 7.4, a nota mais baixa deste trabalho: a página dele é texto preto no branco, sem agrupamento e com uma grande área vazia embaixo. O Seedream 5.0 Pro acrescentou um subtítulo, "ONE-DAY DESIGN CONFERENCE", que não estava no prompt. Na segunda imagem do GPT Image 2.5, que não recebeu nota, a linha "Panel: Designing for Screens" está faltando e só sobrou "11:00".
Trabalho 5: Rótulo de lata de chá
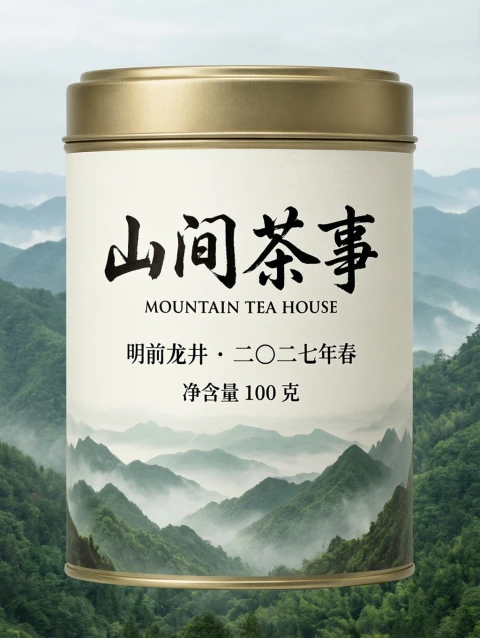
Front label for a tea tin, brand name "山间茶事" in elegant brush-and-ink calligraphy, English line "MOUNTAIN TEA HOUSE", product line "明前龙井 · 二〇二七年春", net weight "净含量 100 克", misty green mountains, no other text
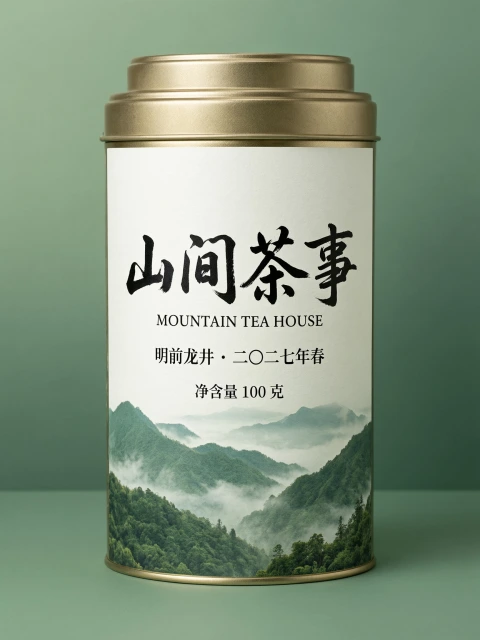
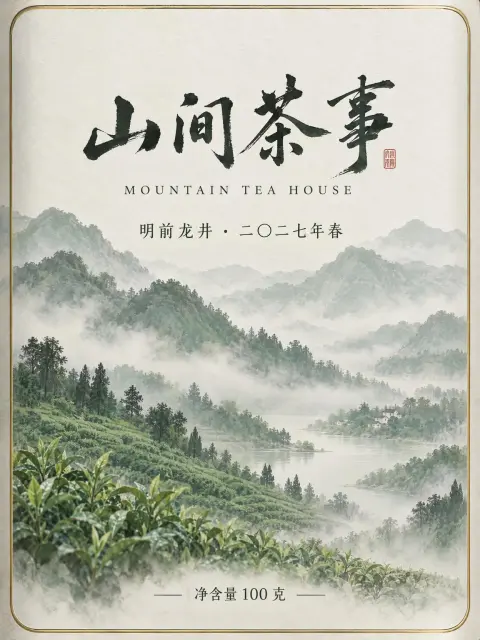
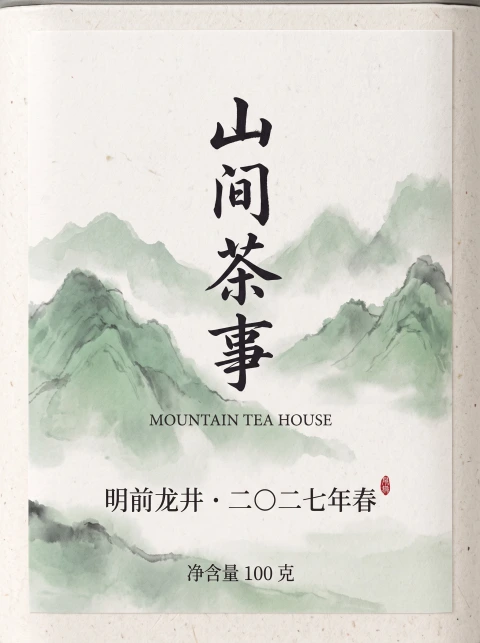
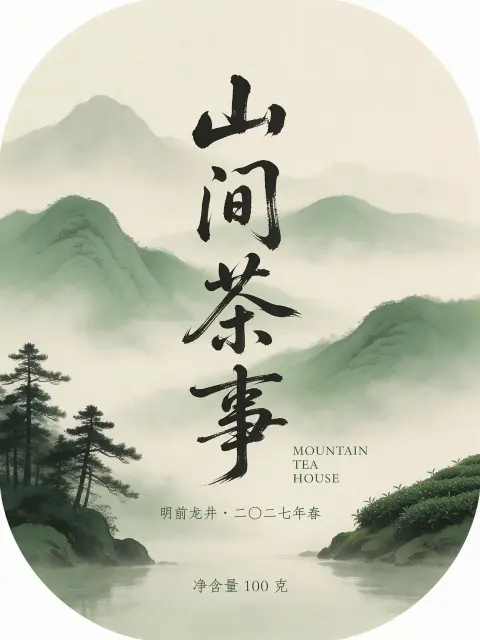
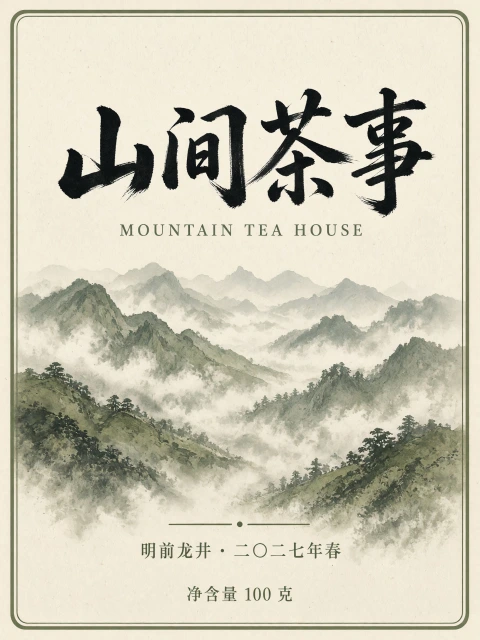
Os cinco modelos escreveram corretamente as quatro linhas em chinês simplificado, incluindo 龙 (e não o tradicional 龍) e 〇. O prompt pedia o rótulo, e quatro modelos entregaram um rótulo chapado. O Qwen Image 3.0 Pro desenhou a foto de uma lata de chá inteira com o rótulo aplicado, o que não pode ser impresso como rótulo, e tirou 8.45, a nota mais baixa deste trabalho. O Grok Imagine 2.0 tirou a nota mais alta, 9.2: um rótulo chapado com todas as linhas no lugar e nada acrescentado. O GPT Image 2.5 e o Nano Banana 2.1 acrescentaram cada um um pequeno carimbo vermelho com caracteres, o que o "no other text" do prompt proíbe, e os dois tiraram 8.95. Para caligrafia a pincel como preset, veja o estilo tinta de pincel chinês.
Trabalho 6: Pôster de livraria japonesa
Poster for a bookstore's autumn reading week, headline "秋の読書週間" set vertically in elegant Mincho lettering, sub-line "十月二十七日〜十一月九日", and "全品ポイント二倍", warm maple leaves, all Japanese text written vertically, no other text
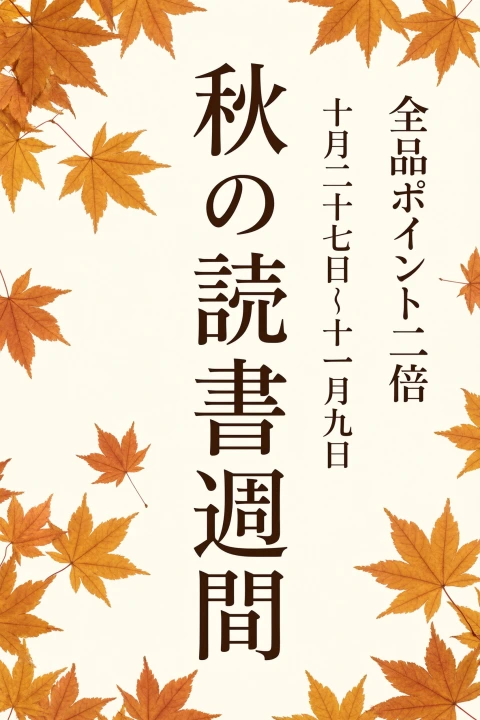
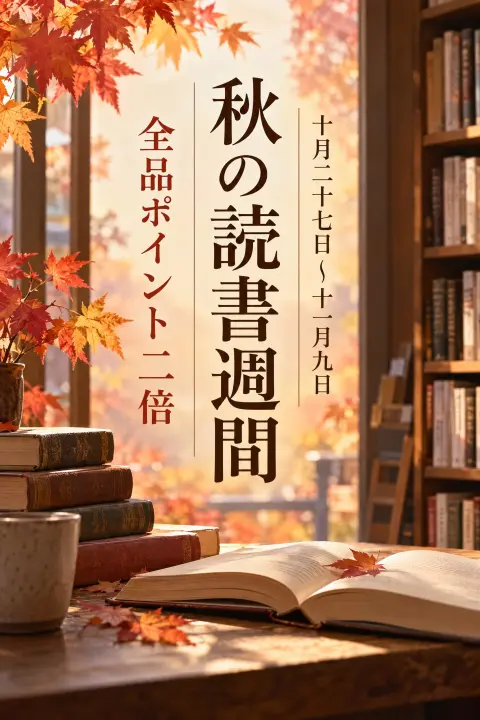
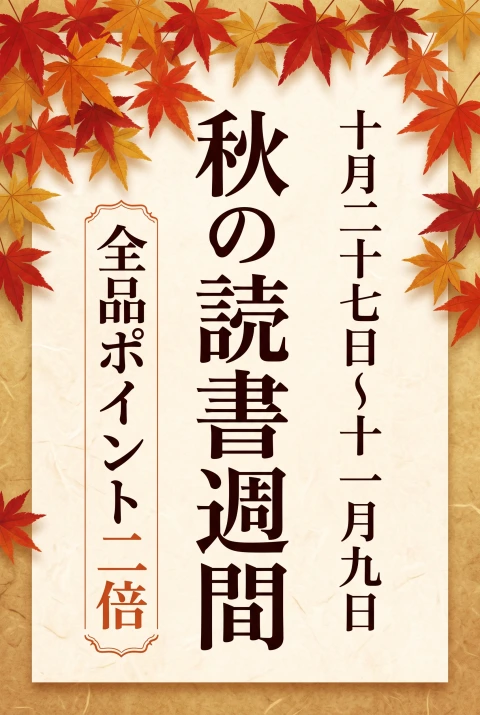
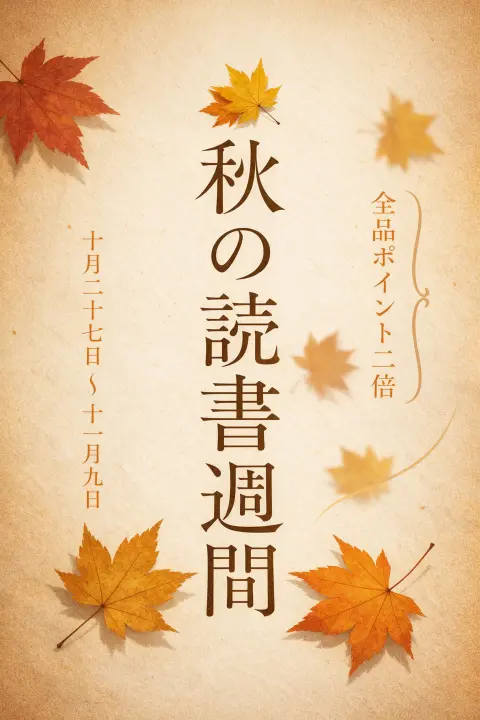

Os cinco modelos compuseram as três linhas na vertical e as escreveram corretamente, e os cinco usaram o lettering Mincho que o prompt pedia. O GPT Image 2.5 tirou a nota mais alta, 9.2, com uma cena de livraria e a oferta de pontos numa faixa vertical vermelha. O Qwen Image 3.0 Pro, o Nano Banana 2.1 e o Grok Imagine 2.0 tiraram 9.0. O Seedream 5.0 Pro tirou 8.95: a coluna da data dele é clara e fina.
Trabalho 7: Emblema de marca outdoor
Badge logo for a hiking outfitter called "Fernwood Outfitters", an interlocking "FW" monogram with a fern leaf in the center, the full name in clean small caps around the badge, flat vector look, two colors, on plain white, no other text
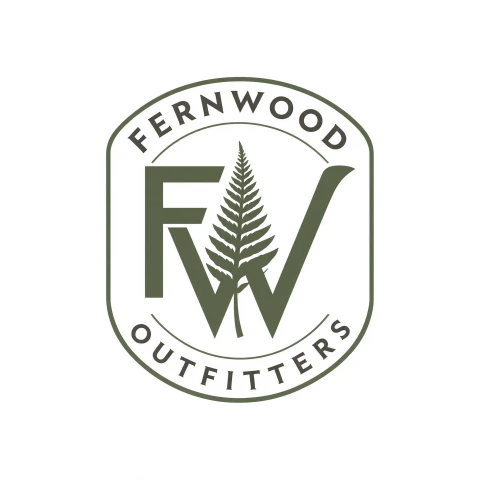
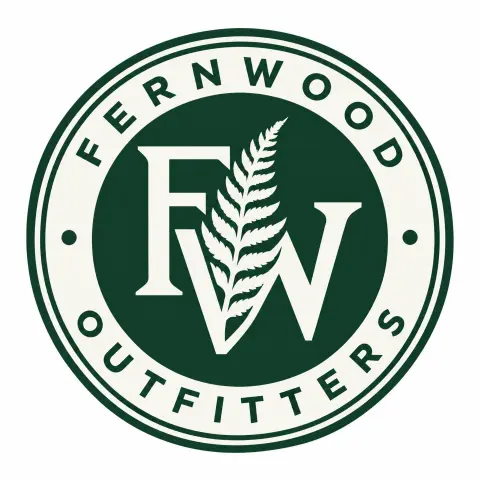
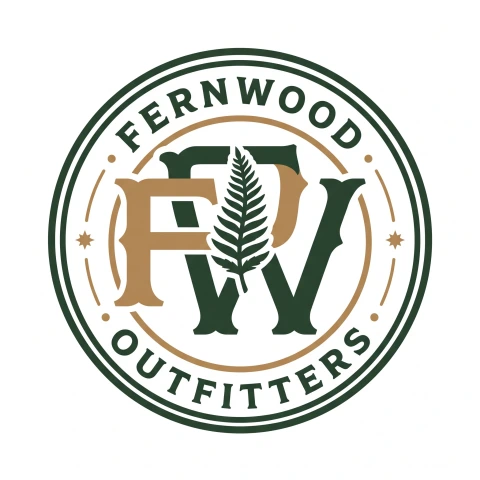
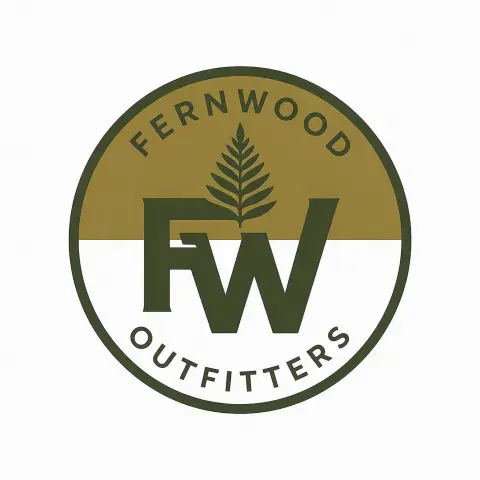
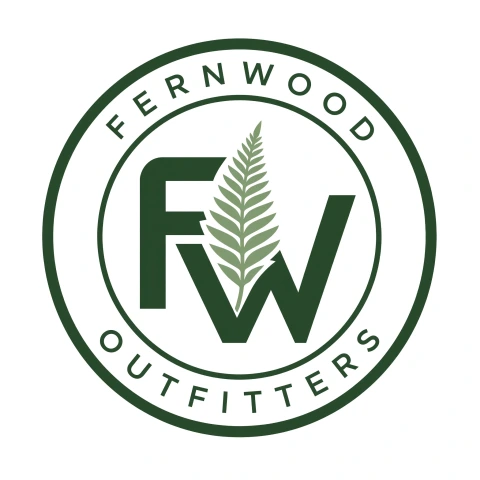
O GPT Image 2.5 e o Grok Imagine 2.0 empataram na nota mais alta, 9.2. O Qwen Image 3.0 Pro tirou 9.0, com uma samambaia crescendo através do monograma. O Nano Banana 2.1 tirou a nota mais baixa, 8.05: o monograma dele tem uma barriga a mais que, à primeira vista, faz ler "FPW". O Seedream 5.0 Pro tirou 8.3: o F e o W ficam lado a lado em vez de entrelaçados, e a samambaia está acima das letras em vez de no centro. Na segunda imagem do Qwen, que não recebeu nota, o nome completo aparece duas vezes em volta do emblema.
Trabalho 8: Foto de um food truck
Realistic photo of a vintage food truck parked by the beach at noon, hand-painted lettering on its side reads "SALT & LIME TACOS", a menu board next to it reads "3 TACOS $9 · HORCHATA $4", bright sunlight, shot on a 50mm lens
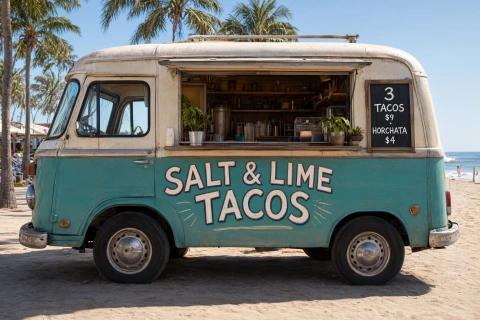
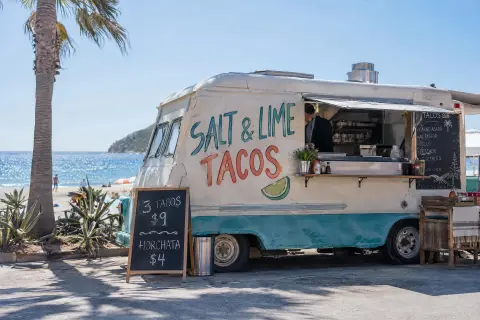
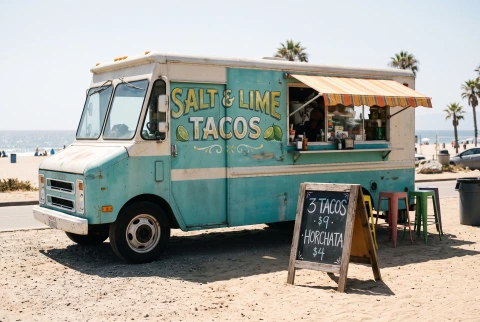
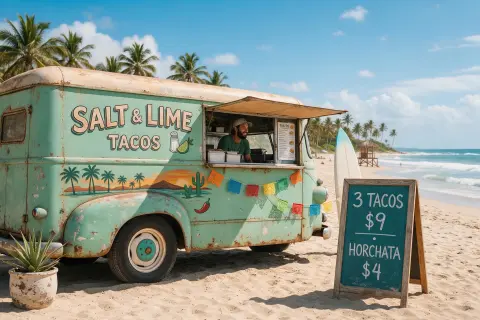
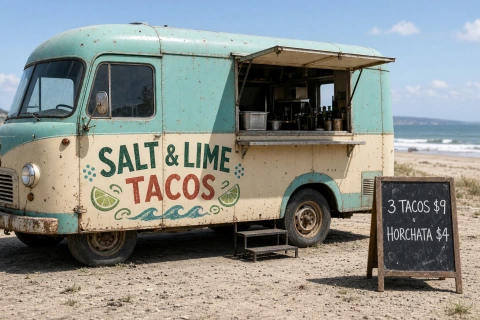
Os cinco modelos escreveram corretamente as duas linhas pedidas. O Seedream 5.0 Pro e o Grok Imagine 2.0 empataram na nota mais alta, 9.2, com a placa de cardápio em pé ao lado do caminhão, como o prompt pedia. O GPT Image 2.5 tirou a nota mais baixa, 7.5: ao lado da janela de atendimento, acrescentou uma segunda lousa com cinco pratos, e uma linha dessa lousa tem letras embaralhadas, o que é erro grave pelos critérios, então a nota de legibilidade dele é 4. Ele também desenhou o "·" da placa de cardápio pedida como uma linha ondulada. O Qwen Image 3.0 Pro pendurou a placa de cardápio no caminhão em vez de colocá-la ao lado e tirou 8.75.
Trabalho 9: Editar uma imagem existente
Change the date to "FRIDAY • NOVEMBER 13 • 2026" and the price to "$20", and keep everything else exactly as it is
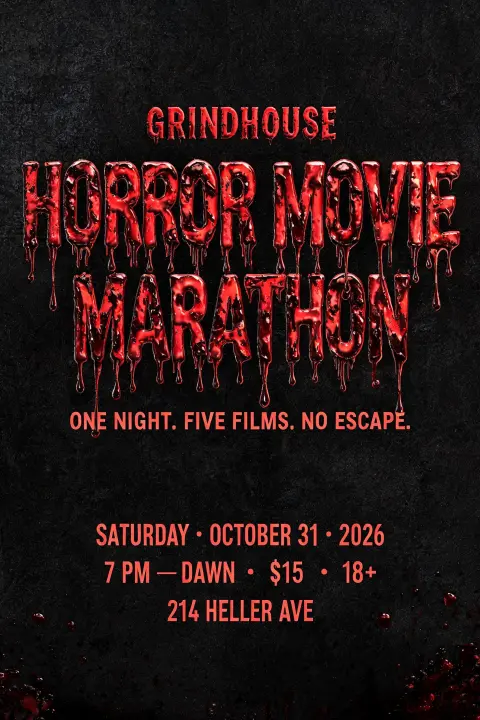
O pôster original tem seis linhas de texto. O prompt pedia para trocar duas delas: a data e o preço. As outras quatro linhas e o "18+" tinham que continuar iguais.
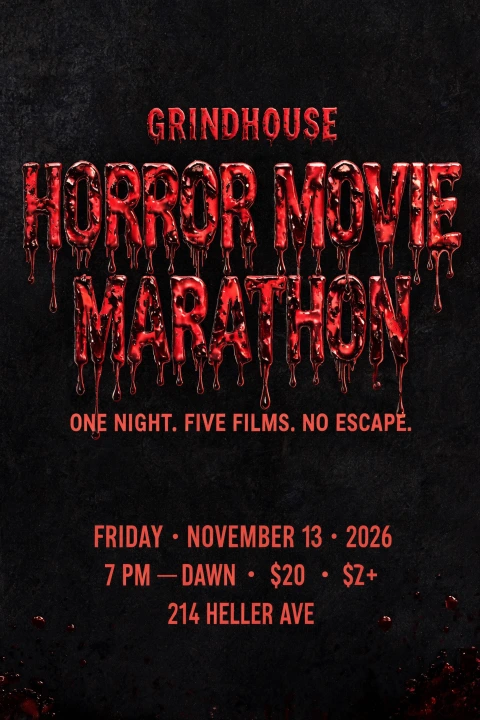
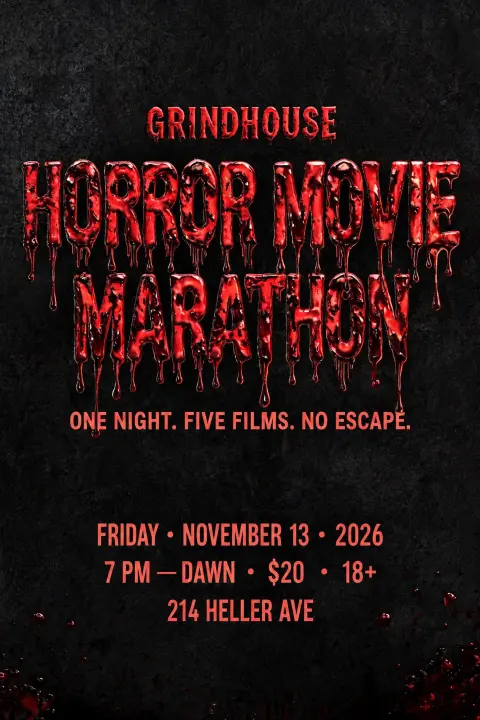
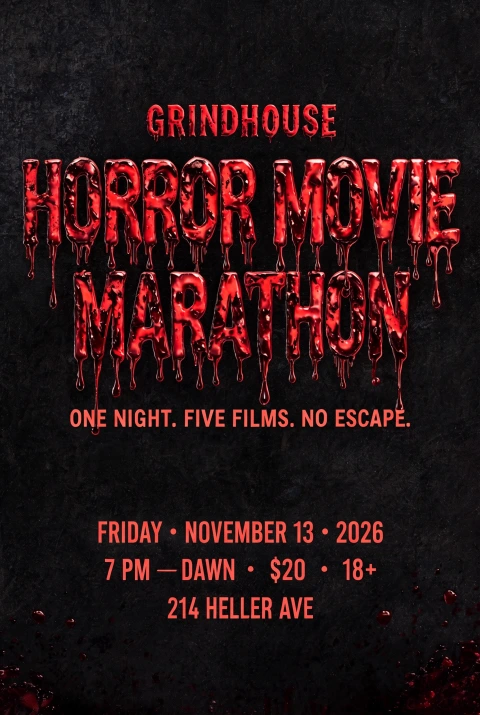
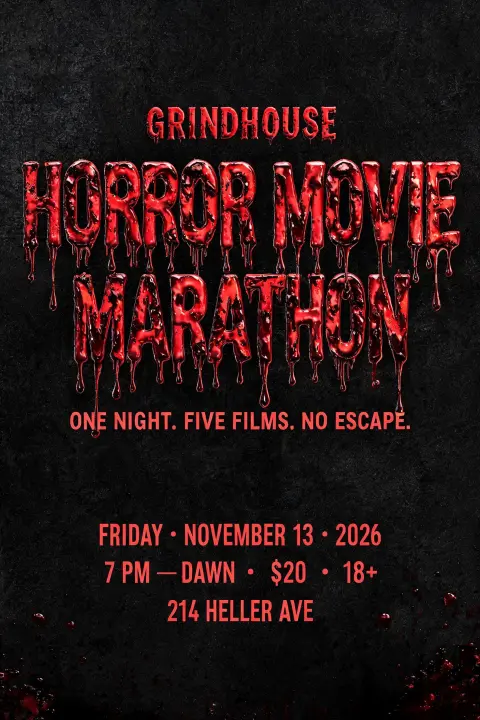
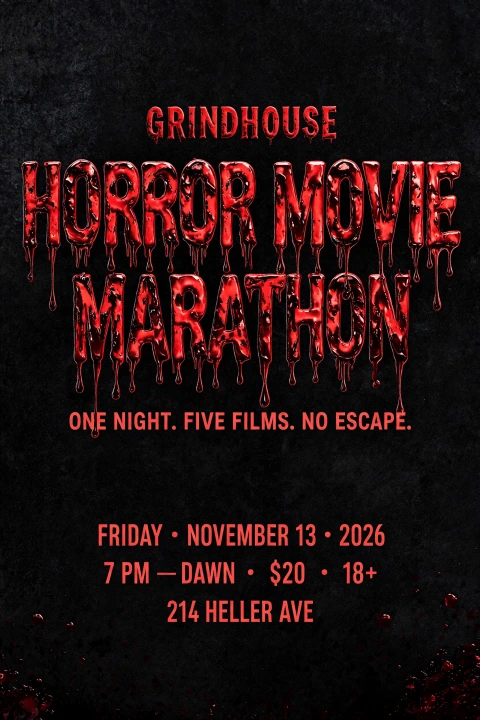
Quatro modelos trocaram corretamente a data e o preço e deixaram todo o resto sem mudança, e os quatro tiraram 9.0. O Qwen Image 3.0 Pro trocou corretamente a data e o preço, mas também mudou "18+" para "$Z+", e tirou 8.5. A segunda imagem dele manteve o "18+" corretamente.
Os critérios não medem se o resto da imagem continuou igual, então medi isso à parte, como no teste do Grok. Cada resultado e o original foram redimensionados para 800 × 1200 e convertidos para tons de cinza, e calculei a diferença absoluta média de pixels (0 a 255) fora das duas linhas que deviam mudar. Quanto menor, mais perto do original.
| Modelo | Diferença em relação ao original |
|---|---|
| Seedream 5.0 Pro | 2.6 |
| GPT Image 2.5 Sunburst | 5.7 |
| Nano Banana 2.1 | 8.2 |
| Grok Imagine 2.0 Medium | 10.0 |
| Qwen Image 3.0 Pro | 12.2 |
O original tem 1664 × 2496 pixels. Todos os modelos devolveram esse tamanho, menos o Nano Banana 2.1, que devolveu 1696 × 2528, então parte da diferença dele vem do redimensionamento. O Seedream 5.0 Pro também foi o mais perto do original no trabalho de edição do teste do Grok. O tempo mediano de edição dele aqui foi 118 segundos, contra 23 a 55 segundos dos outros quatro.
Trabalho 10: Duas imagens de referência
Portrait poster that says "OPEN STUDIO" with a small line "Sat & Sun · 11 AM–6 PM". Use the layout of reference image 1 and the lettering style of reference image 2.


A imagem de referência 1 é um pôster de galeria pop art: uma faixa azul no topo, um título enorme em duas linhas sobre um fundo vermelho de retícula e uma data embaixo. A imagem de referência 2 é um logotipo em contorno fino de neon azul sobre um fundo estrelado. O resultado correto é o layout da referência 1 com o lettering de neon da referência 2.
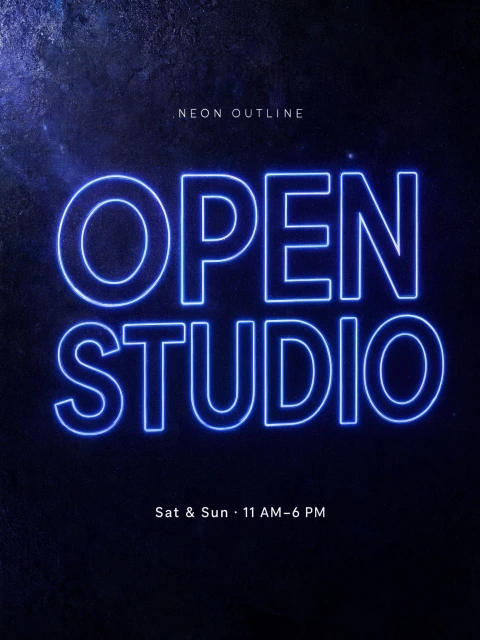
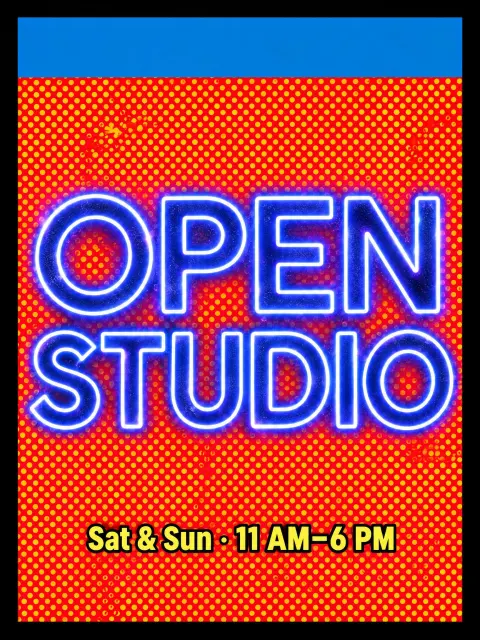
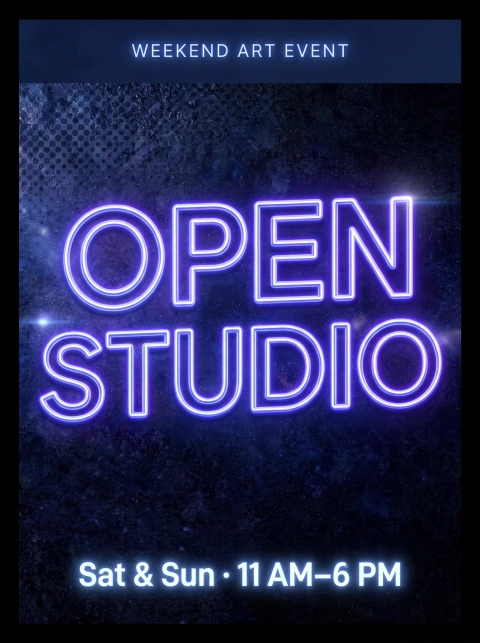
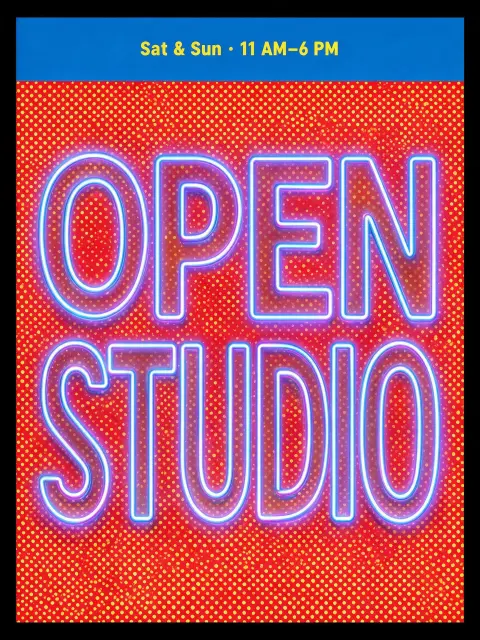
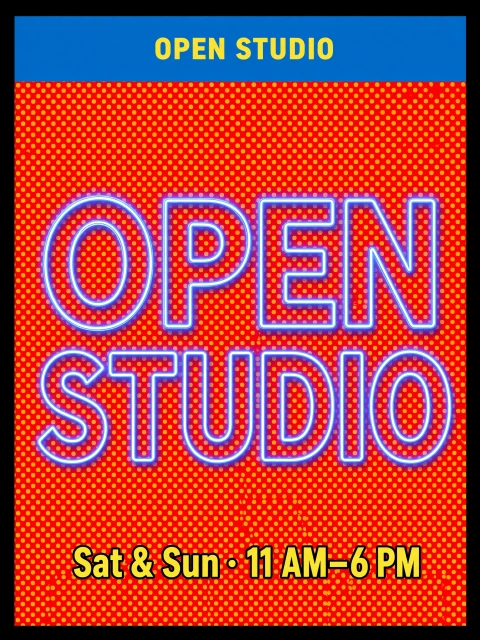
O GPT Image 2.5 e o Seedream 5.0 Pro acertaram as duas partes e empataram na nota mais alta, 9.2. O Grok Imagine 2.0 também acertou as duas partes, mas escreveu "OPEN STUDIO" uma segunda vez na faixa do topo, e tirou 8.95. O Nano Banana 2.1 usou o lettering de neon e a faixa do topo, mas colocou tudo sobre o fundo estrelado da referência 2 e acrescentou uma linha, "WEEKEND ART EVENT", que não estava no prompt. O Qwen Image 3.0 Pro seguiu a referência 2 tanto no lettering quanto no layout, e copiou dela as palavras "NEON OUTLINE". A segunda imagem dele fez o mesmo.
A primeira tentativa do Seedream 5.0 Pro neste trabalho falhou. No FontVibe, um pedido ao Seedream 5.0 Pro é interrompido depois de 2 minutos. O Seedream 5.0 Pro bateu nesse limite em 3 das suas 4 tentativas neste trabalho, em 2K com duas imagens de referência, e a única imagem bem-sucedida levou 121 segundos. Essa é a imagem que recebeu nota. O Nano Banana 2.1 também falhou uma vez, na segunda imagem do trabalho 7, e deu certo na nova tentativa. Pedidos que falham são reembolsados no FontVibe.
Qwen Image 3.0: 1K ou 2K?
No FontVibe, uma imagem do Qwen Image 3.0 Pro custa 22 créditos em 1K e 40 créditos em 2K. Rodei os trabalhos 4 e 5, os dois trabalhos com o texto menor, também em 1K, duas imagens cada.
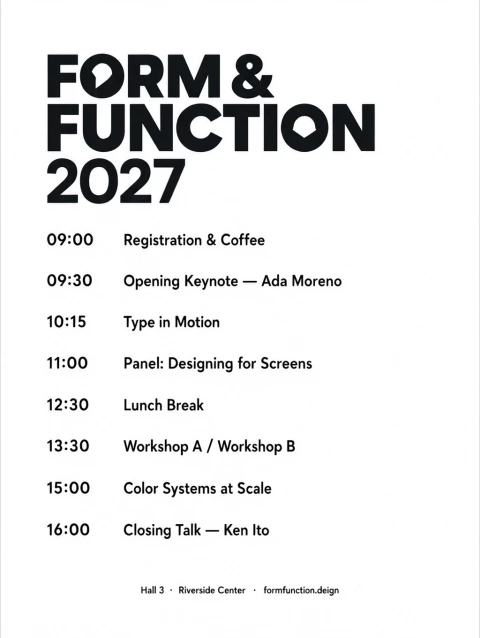
As imagens 1K têm 1024 × 1360 pixels e as imagens 2K têm 1728 × 2304. Em 1K, as 10 linhas da programação e as quatro linhas do rótulo de chá continuam legíveis, e os dois trabalhos tiraram a mesma nota que em 2K: 7.4 e 8.45. Em 1K, o Qwen também desenhou uma lata de chá em vez de um rótulo. As duas programações em 1K têm o erro "formfunction.deign", contra uma das duas programações em 2K. O tempo mediano em 1K foi 14 segundos, contra 23 segundos em 2K.
Para rascunhos e imagens de redes sociais vistas no celular, 1K custa 55% do preço de 2K neste teste e o texto continuou legível. Para impressão, 2K tem 2.9 vezes mais pixels.
Para usar o Qwen Image 3.0 Pro, escolha o modelo no menu de modelos do gerador do FontVibe. Ele aceita até 3 imagens por pedido, contando a imagem que está sendo editada e as imagens de referência. Clicando em qualquer imagem deste post, abre a página dela no FontVibe, e passando o mouse por cima aparece um botão Recreate que roda o mesmo prompt.
Os dois testes comparados
O GPT Image 2.5 Sunburst, o Grok Imagine 2.0 Medium, o Nano Banana 2.1 e o Seedream 5.0 Pro também estavam no meu teste do Grok Imagine 2.0, que usou oito prompts diferentes.
| Modelo | Teste do Grok Imagine 2.0 | Este teste |
|---|---|---|
| GPT Image 2.5 Sunburst (High) | 8.90 (1º) | 8.99 (2º) |
| Grok Imagine 2.0 Medium | 8.84 (2º) | 9.01 (1º) |
| Nano Banana 2.1 | 8.55 (4º de 5 configurações) | 8.76 (3º) |
| Seedream 5.0 Pro | 8.20 (5º) | 8.75 (4º) |
O GPT Image 2.5 e o Grok Imagine 2.0 Medium trocaram o primeiro e o segundo lugar: estavam a 0.06 um do outro no teste do Grok e estão a 0.02 aqui. O Nano Banana 2.1 ficou à frente do Seedream 5.0 Pro nos dois testes, por 0.35 no teste do Grok e por 0.01 aqui. O Nano Banana 2.1 aparece em 4º no teste do Grok porque aquele teste também incluiu o Grok Imagine 2.0 Low, que tirou 8.59.
Os trabalhos 1 e 3 usaram os mesmos prompts nos dois testes, então são uma comparação direta. No trabalho 1, o Qwen Image 3.0 Pro tirou 8.3, menos que todos os outros quatro modelos em qualquer um dos dois testes. No trabalho 3, tirou 9.0, o mesmo que o GPT Image 2.5 e o Nano Banana 2.1 neste teste.
Cada modelo, em resumo
Grok Imagine 2.0 Medium, 9.01. Nota mais alta em informação e layout, 8.9. Nota mais alta ou empatada na mais alta em 5 dos 10 trabalhos. Nenhum texto faltando ou escrito errado em nenhuma imagem avaliada. Nota mais baixa 8.3, na programação, em que o título é uma sem serifa condensada em vez de lettering geométrico. Tempo mediano de 95 segundos, o mais lento deste teste.
GPT Image 2.5 Sunburst (High), 8.99. Nota mais alta em lettering, 9.0, e nota mais alta em apelo, 8.9. Nota mais alta ou empatada na mais alta em 8 dos 10 trabalhos. Nota mais baixa 7.5, na foto do food truck, em que acrescentou uma lousa com uma linha embaralhada. Testado em High; Extra High e Max não foram testadas.
Nano Banana 2.1, 8.76. Custa 25 créditos por imagem 2K no FontVibe, o menor valor dos cinco modelos. Nota mais baixa 7.9, na programação, em que entregou a foto de um cartão impresso. Seguiu só metade da referência de layout no trabalho 10.
Seedream 5.0 Pro, 8.75. Nota de legibilidade mais alta, 10.0, dividida com o Qwen Image 3.0 Pro. O mais perto do original no trabalho de edição, com diferença de pixels de 2.6. Bateu no limite de 2 minutos do FontVibe em 3 de 4 tentativas no trabalho com duas referências. Nota mais baixa 8.15, no adesivo.
Qwen Image 3.0 Pro, 8.57. Nota de legibilidade mais alta, 10.0, dividida com o Seedream 5.0 Pro, e o tempo mediano mais rápido, 23 segundos. Nota mais baixa em informação e layout, 7.7, e nota mais baixa em apelo, 7.8. Alterou ou escreveu errado uma linha pedida em 3 das suas 10 imagens avaliadas, e desenhou uma lata de chá quando o prompt pedia um rótulo. Não tirou a nota mais alta em nenhum trabalho.
Uma avaliação às cegas
Como eu sabia qual modelo tinha feito cada imagem enquanto dava a nota, também fiz uma avaliação às cegas. Uma página privada mostrava as cinco imagens de cada trabalho em ordem aleatória, com os nomes dos modelos escondidos. Cada imagem recebeu uma nota de 1 a 5 para o lettering, uma nota de 1 a 5 para o layout e um de três vereditos: pronta para usar, precisa de um ajuste pequeno ou inutilizável.
| Modelo | Lettering às cegas (1–5) | Layout às cegas (1–5) | Pronta / ajuste pequeno / inutilizável |
|---|---|---|---|
| GPT Image 2.5 Sunburst | 4.4 | 4.8 | 8 / 2 / 0 |
| Seedream 5.0 Pro | 4.3 | 4.3 | 4 / 4 / 2 |
| Nano Banana 2.1 | 4.3 | 4.2 | 4 / 4 / 2 |
| Grok Imagine 2.0 Medium | 4.0 | 4.2 | 4 / 5 / 1 |
| Qwen Image 3.0 Pro | 3.4 | 3.5 | 1 / 2 / 7 |
A avaliação às cegas e os critérios concordam no último lugar, o Qwen Image 3.0 Pro. A avaliação às cegas pôs o GPT Image 2.5 em primeiro, enquanto os critérios o deixam 0.02 atrás do Grok Imagine 2.0 Medium, e ordenou o Seedream 5.0 Pro, o Nano Banana 2.1 e o Grok Imagine 2.0 ao contrário dos critérios. A avaliação às cegas foi mais dura com o Qwen Image 3.0 Pro do que os critérios: marcou 7 das 10 imagens do Qwen como inutilizáveis, contra 2 ou menos para cada um dos outros quatro modelos.
Limites deste teste
- Uma imagem por modelo por trabalho recebeu nota, e uma única pessoa deu as 50 notas.
- O Grok Imagine 2.0 Medium e o GPT Image 2.5 estão a 0.02 um do outro, e o Nano Banana 2.1 e o Seedream 5.0 Pro estão a 0.01. Mudar uma nota em 1 ponto num trabalho move a média de um modelo entre 0.02 e 0.035, então as duas ordens dependem de notas isoladas.
- O GPT Image 2.5 foi testado na terceira das suas cinco configurações de qualidade. Os outros quatro modelos foram testados na sua configuração mais alta.
- O Qwen Image 3.0 Pro foi testado com a reescrita de prompt embutida desligada. Com ela ligada, o modelo reescreve o prompt antes de gerar, então os resultados podem ser diferentes.
- As imagens de edição e de referência vieram do Seedream 5.0, o modelo anterior da família do Seedream 5.0 Pro.
- Dos 12 idiomas que o Qwen Image 3.0 Pro lista, só chinês e japonês foram testados.
- Os resultados descrevem estas versões dos modelos em 21 de outubro de 2026.
Todas as imagens estão públicas no FontVibe e todas as notas têm um motivo escrito. Se você rodar um prompt de novo e tiver um resultado muito diferente, mande um e-mail para hello@fontvibe.ai e eu acrescento neste post.
Apêndice: todas as notas
Legibilidade / lettering / informação e layout / apelo, depois a nota geral ponderada. Primeira imagem de cada modelo (trabalho 10, Seedream 5.0 Pro: a única imagem bem-sucedida).
| Trabalho | Qwen Image 3.0 Pro | GPT Image 2.5 (High) | Nano Banana 2.1 | Seedream 5.0 Pro | Grok Imagine 2.0 Medium |
|---|---|---|---|---|---|
| 1 Convite | 10/9/7/7 = 8.30 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/9/7/8 = 8.50 | 10/9/9/9 = 9.20 |
| 2 Adesivo | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 10/9/9/9 = 9.20 | 10/8/7/8 = 8.15 | 10/9/9/8 = 9.00 |
| 3 Pôster | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/9/7/8 = 8.50 | 9/9/9/9 = 9.00 |
| 4 Programação | 10/7/7/6 = 7.40 | 10/9/9/9 = 9.20 | 10/8/6/8 = 7.90 | 10/9/8/9 = 8.95 | 10/7/9/8 = 8.30 |
| 5 Rótulo de chá | 10/9/6/9 = 8.45 | 10/9/8/9 = 8.95 | 10/9/8/9 = 8.95 | 10/9/7/9 = 8.70 | 10/9/9/9 = 9.20 |
| 6 Pôster japonês | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/9/8/9 = 8.95 | 10/9/9/8 = 9.00 |
| 7 Emblema | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 7/8/9/8 = 8.05 | 10/7/9/8 = 8.30 | 10/9/9/9 = 9.20 |
| 8 Food truck | 10/9/8/8 = 8.75 | 4/9/7/9 = 7.50 | 10/9/8/9 = 8.95 | 10/9/9/9 = 9.20 | 10/9/9/9 = 9.20 |
| 9 Edição | 10/9/7/8 = 8.50 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 |
| 10 Referências | 10/9/6/8 = 8.25 | 10/9/9/9 = 9.20 | 10/9/7/8 = 8.50 | 10/9/9/9 = 9.20 | 10/9/8/9 = 8.95 |
Qwen Image 3.0 Pro em 1K (fora das médias): trabalho 4, 10/7/7/6 = 7.40; trabalho 5, 10/9/6/9 = 8.45.
O motivo escrito de cada nota está guardado e disponível mediante pedido.
Perguntas frequentes
O Qwen Image 3.0 é bom em design com texto?
Neste teste, o Qwen Image 3.0 Pro empatou com o Seedream 5.0 Pro na nota de legibilidade mais alta, 10.0, e teve a nota geral mais baixa de cinco modelos, 8.57 de 10. Três das suas 10 imagens avaliadas alteraram ou escreveram errado uma linha pedida, e os layouts dele tiveram a nota mais baixa em informação e layout, 7.7.
Qual modelo de imagem com IA tirou a nota mais alta em design com texto?
O Grok Imagine 2.0 Medium tirou 9.01 de 10, a nota mais alta de cinco modelos em 10 trabalhos, e o GPT Image 2.5 Sunburst na qualidade High tirou 8.99, 0.02 a menos. O Nano Banana 2.1 tirou 8.76, o Seedream 5.0 Pro 8.75 e o Qwen Image 3.0 Pro 8.57.
O Qwen Image 3.0 escreve chinês e japonês?
Sim, neste teste. Ele escreveu corretamente um rótulo de chá bilíngue em chinês e inglês, em chinês simplificado, e compôs na vertical um pôster japonês de três linhas com todos os caracteres corretos. Os outros quatro modelos fizeram o mesmo.
O Qwen Image 3.0 edita imagens?
Sim. No trabalho de edição, ele trocou corretamente uma data e um preço, mas na primeira imagem também mudou "18+" para "$Z+", e o resultado dele teve a maior diferença de pixels em relação ao original entre os cinco modelos, 12.2 numa escala de 0 a 255.
O Qwen Image 3.0 em 1K é suficiente?
Nos dois trabalhos com o texto menor, as imagens 1K tiraram a mesma nota que as imagens 2K, 7.4 e 8.45, e todas as linhas continuaram legíveis. 1K custa 22 créditos no FontVibe e 2K custa 40.
O GPT Image 2.5 foi testado na qualidade máxima?
Não. O GPT Image 2.5 Sunburst foi testado na High, a terceira das suas cinco configurações de qualidade e a padrão do FontVibe. Extra High e Max não foram testadas.
Dá para testar os cinco modelos num só lugar?
Os cinco modelos estão no menu de modelos do FontVibe, e o mesmo prompt pode ser rodado em cada um.
Pronto para experimentar?
Coloque essas técnicas de prompt em prática — sem precisar de conta para começar.
✦ Começar a criarAdicione a FontVibe como fonte preferida no Google
Coloque essas técnicas de prompt em prática — sem precisar de conta para começar.
Comece a criar
Comentários