8 款大模型当设计师:GPT-6.1 Terra 实测
我给 OpenAI、Anthropic、Google 的 8 个语言模型同样 12 道设计题,每题 3 遍,287 张图全部盲评。
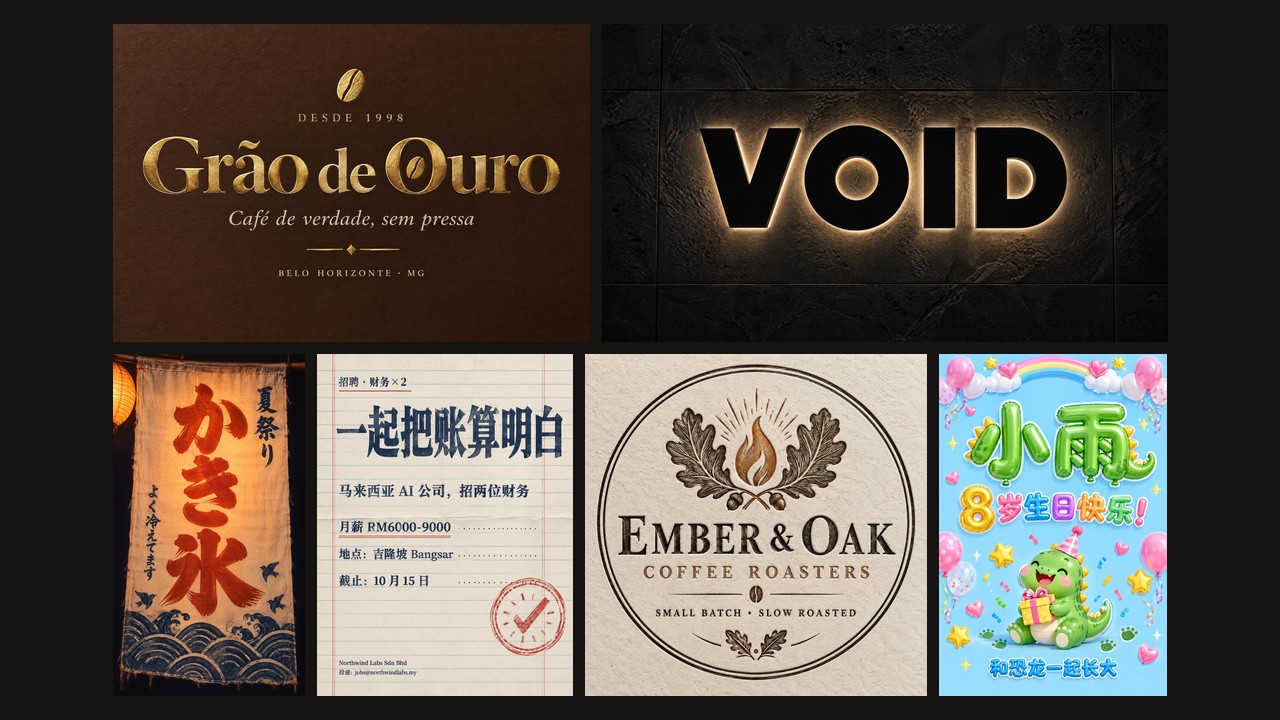
在 FontVibe 上要一张设计图时,生图之前是一个语言模型在做设计师的活:它读需求,提出三个设计方向,再写出交给生图模型渲染的指令。GPT-6.1 Terra 在 2026 年 10 月 26 日发布,所以我测了它做这份活是否比 GPT-5.6 Terra(FontVibe 目前用的模型)做得更好,同时拿它和 OpenAI、Anthropic、Google 的另外六个语言模型做了对比。
每个模型拿到同样的 12 道需求,每道跑三遍。每张设计用的生图模型都一样:GPT Image 2.5 Sunburst,2K、Medium 档,它在我的 Qwen Image 3.0 实测和 Grok Imagine 2.0 实测里都排第二。设计与设计之间唯一的变量,是哪个语言模型当设计师。287 张设计图在隐去模型名的情况下盲评打分。
结果
| # | 模型 | 完成数 | 总分(95% CI) | 可读性 | 字形与材质 | 信息与构图 | 吸引力 | 每张编造行数 | 每张成本 | 方案耗时中位数 |
|---|---|---|---|---|---|---|---|---|---|---|
| – | Claude Opus 5.5 | 18 / 36 | 7.97(7.40–8.46) | 8.7 | 8.0 | 7.4 | 7.8 | 0.22 | $0.41 | 65 秒 |
| 1 | GPT-6 Luna | 36 / 36 | 7.69(7.50–7.88) | 9.1 | 7.2 | 7.5 | 7.2 | 0.36 | $0.005 | 44 秒 |
| 2 | GPT-5.6 Terra | 35 / 36 | 7.58(7.14–7.97) | 8.7 | 7.5 | 7.0 | 7.5 | 0.46 | $0.09 | 29 秒 |
| 3 | Gemini 4 Argon | 36 / 36 | 7.56(7.21–7.89) | 8.6 | 7.9 | 6.2 | 7.7 | 1.56 | $0.11 | 40 秒 |
| 4 | Claude Sonnet 5.5 | 36 / 36 | 7.43(7.14–7.75) | 8.7 | 7.9 | 5.6 | 7.8 | 1.11 | $0.18 | 27 秒 |
| 5 | GPT-6.1 Sol | 36 / 36 | 7.35(7.03–7.71) | 9.4 | 6.6 | 7.5 | 6.4 | 0.28 | $0.09 | 62 秒 |
| 6 | Gemini 3.8 Flash | 36 / 36 | 7.33(6.94–7.69) | 8.8 | 7.7 | 5.4 | 7.7 | 2.36 | $0.04 | 32 秒 |
| 7 | GPT-6.1 Terra | 36 / 36 | 7.08(6.59–7.56) | 9.1 | 6.5 | 7.0 | 6.1 | 0.17 | $0.04 | 37 秒 |
满分 10 分,取每个模型所有完成的设计的平均分。Claude Opus 5.5 不参与排名:它只在 12 道题里的 8 道上完成了设计,而且大多是较容易的题,平均分和其他模型没法直接比(同题对比见此)。同一道题的三轮共用一份需求、由同一位评委在同一轮打分,并不独立,所以 95% 置信区间按题重抽样得出。两个模型只有在逐题差值的置信区间不跨 0 时,才算分得出高下;28 组两两比较全部列在附录。每张成本是一张设计的语言模型成本中位数(方案加生图指令),按各厂商 2026 年 10 月 30 日的公开价格计算;图片本身的费用对每个模型都一样,不计入。每道题的全部分数见附录。
有四个结果值得单独说。
换哪个语言模型当设计师有影响,但只看质量,大多数模型分不出高下。 生图模型和设置完全一样,平均分从 7.08 到 7.97。28 组两两比较里,逐题比下来能分出高下的只有 5 组:GPT-6.1 Terra 低于 GPT-5.6 Terra、GPT-6 Luna 和 Claude Opus 5.5,GPT-6.1 Sol 低于 GPT-6 Luna 和 Claude Opus 5.5。其余 23 组在这次测试里打平。
把质量、成本、速度和稳定性放在一起看,差距就拉开了。 同一质量档的模型,每张设计的成本能差 30 多倍(GPT-6 Luna $0.005,Claude Sonnet 5.5 $0.18);出方案加写生图指令的耗时能差一倍左右(GPT-5.6 Terra 和 Claude Sonnet 5.5 约 41 秒,GPT-6.1 Sol 约 87 秒);失败的原因也各不相同(详情)。综合下来,有几个模型至少在一项上吃亏,又没在别的项上补回来:GPT-6.1 Sol 和 GPT-5.6 Terra 一样贵、质量分不出高下,却慢一倍;Gemini 3.8 Flash 是 GPT-6 Luna 的 8 倍价钱,质量分不出高下,还出了 8 次厂商报错;GPT-6.1 Terra 比 GPT-6 Luna 贵,分数也明显更低。
没有全面占优的模型,各有适合的活。 Claude Opus 5.5 平均分最高,7.97,但只来自 8 道题上的 18 张设计。主测里它的方案比其他模型长得多,有 17 次被 FontVibe 按自家线上场景定的 6,600 token 上限截断,另有 1 次是写出的生图指令格式损坏。把上限翻倍重跑后,它每次都完成了;36 张设计合起来,明显高于 GPT-5.6 Terra、Claude Sonnet 5.5、Gemini 3.8 Flash 和两个 GPT-6.1 模型,与 GPT-6 Luna、Gemini 4 Argon 分不出高下(详情)。它也最慢、最贵:每张设计成本中位数 $0.41,把失败的运行算进去,每张完成的设计实际花 $0.72。它适合复杂、不赶时间、值得为质量多花钱的设计。GPT-6 Luna 质量在第一梯队、每次都跑完、成本最低,性价比最高,适合大批量。GPT-5.6 Terra 快而均衡,适合用户等着看结果的实时场景。
编造文字是可以量化的缺陷,各模型差到 14 倍。 GPT-6.1 Terra 每张设计平均只多出 0.17 行需求里没有的文字,Gemini 3.8 Flash 多出 2.36 行,加的是创立年份、标语、服务清单和虚构的数字。编造文字是设计在信息项上丢分最常见的原因,所以不管用哪个模型,链路里都值得有一道文案核对。
GPT-6.1 Terra 是这次测试的起点,单独说一句:在同一条设计链路、同一套提示词下,它比 GPT-5.6 Terra 更保守。逐题比较,它低 0.50 分(95% CI −0.81 到 −0.21),12 道题里有 9 道更低;输在字形与材质(−0.93)和吸引力(−1.38,12 道题全部更低),可读性略高(+0.47),但在误差范围内。它的设计编造最少,也最朴素,36 张里有 17 张只部分符合需求要的氛围。这说明的是它在「读需求、定方向、写生图指令」这件事上的表现,不代表它在其他任务上的能力。
成本、速度与稳定性
设计质量只是选模型的一部分。同一批测试也记录了每张设计花多少钱、要多久、多常失败。
| 模型 | 出方案耗时(中位 / 最慢 10%) | 写生图指令耗时(中位 / 最慢 10%) | 每张设计成本(中位) | 每 1,000 张完成设计的实际花费 | 首次即完成 | 模型自身失败 | 厂商报错 | 内部重试 |
|---|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 37 秒 / 45 秒 | 13 秒 / 17 秒 | $0.041 | $41 | 36 / 36 | 0 | 0 | 0 |
| GPT-5.6 Terra | 29 秒 / 38 秒 | 12 秒 / 14 秒 | $0.090 | $93 | 33 / 36 | 1 | 0 | 0 |
| GPT-6.1 Sol | 62 秒 / 79 秒 | 25 秒 / 30 秒 | $0.090 | $91 | 34 / 36 | 0 | 0 | 0 |
| GPT-6 Luna | 44 秒 / 58 秒 | 16 秒 / 23 秒 | $0.005 | $5 | 36 / 36 | 0 | 0 | 1 |
| Claude Opus 5.5 | 65 秒 / 75 秒 | 25 秒 / 35 秒 | $0.41 | $721 | 18 / 36 | 18 | 0 | 19 |
| Claude Sonnet 5.5 | 27 秒 / 32 秒 | 14 秒 / 16 秒 | $0.18 | $162 | 36 / 36 | 0 | 0 | 0 |
| Gemini 4 Argon | 40 秒 / 73 秒 | 22 秒 / 33 秒 | $0.11 | $102 | 36 / 36 | 0 | 0 | 3 |
| Gemini 3.8 Flash | 32 秒 / 49 秒 | 13 秒 / 35 秒 | $0.043 | $49 | 29 / 36 | 0 | 8 | 4 |
耗时是每一步语言模型自身的时间,按完成的运行统计。之后渲染图片的中位耗时是 20 秒,每个模型都一样。成本按各厂商 2026 年 10 月 30 日的公开价格计算,包含两步语言模型调用,不含图片本身(无论哪个模型做设计,图片费用都一样)。「每 1,000 张完成设计的实际花费」把失败的运行和重跑的花费都算进去,再除以完成的设计数。「首次即完成」统计不用重跑就出图的次数;GPT-5.6 Terra 和 GPT-6.1 Sol 各有两次被 FontVibe 的前台拦下来先提问,也算作没有首次完成,尽管那不是模型的问题。内部重试是 FontVibe 的流程在一次请求里、某次尝试失败后用同一个模型再试的次数。
成本。 GPT-6 Luna 便宜得最多:每 1,000 张完成的设计约 $5,GPT-5.6 Terra 是 $93,Claude Opus 5.5 是 $721:它失败的运行花的钱,和完成的差不多。GPT-6.1 Terra 的成本不到 GPT-5.6 Terra 的一半。Claude Opus 5.5 最贵,一部分原因是它写的方案最长:方案输出的中位数就顶到了 6,600 token 的上限。
速度。 Claude Sonnet 5.5 出方案最快,中位 27 秒,GPT-5.6 Terra 29 秒紧随其后。GPT-6.1 Sol 和 Claude Opus 5.5 都超过一分钟。Gemini 4 Argon 中位 40 秒,但最慢的 10% 要 73 秒以上,是所有模型里波动最大的。
稳定性。 GPT-6.1 Terra、GPT-6 Luna、Claude Sonnet 5.5 和 Gemini 4 Argon 36 次全部首次完成。Gemini 3.8 Flash 自身的输出从没出错,但 Google 的服务在它的 7 次运行里返回了 8 次错误(限流和超时),重跑后全部完成。Claude Opus 5.5 失败 18 次:17 次方案在输出上限处被截断,1 次生图指令格式损坏。它的 19 次内部重试大多是方案被截断后再试一次、结果又被截断。
测试方法
流程
这次测试只测一件事:当设计师。在 FontVibe 的设计模式里,一个请求要经过三步:
- 出方案。 语言模型读需求,提出三个设计方向,每个方向都有标题、要印上去的确切文字、配色、版式和所选的字形风格。
- 写生图指令。 针对第一个方向,语言模型写出给生图模型的完整指令。
- 渲染。 生图模型把它画出来。
被测模型负责第 1、2 步。第 3 步始终是 GPT Image 2.5 Sunburst,2K、Medium 档。每个请求都走 FontVibe 的生产流程,每个模型用同样的系统提示词、同样的输出格式、同样的推理强度设置(medium)。没有哪个模型有专属的提示词或设置。渲染的始终是第一个方向,方向不是我挑的。
八个模型
| 厂商 | 模型 | 为什么测它 |
|---|---|---|
| OpenAI | GPT-6.1 Terra | 2026 年 10 月 26 日新发布;正在考虑换用的模型 |
| OpenAI | GPT-5.6 Terra | FontVibe 目前第 1 步用的模型 |
| OpenAI | GPT-6.1 Sol | OpenAI 的旗舰模型 |
| OpenAI | GPT-6 Luna | OpenAI 的低价模型;FontVibe 目前第 2 步用的模型 |
| Anthropic | Claude Opus 5.5 | Anthropic 的旗舰模型 |
| Anthropic | Claude Sonnet 5.5 | Anthropic 的中档价位模型 |
| Gemini 4 Argon | Google 的旗舰模型 | |
| Gemini 3.8 Flash | Google 的低价模型 |
12 道需求,分四层
设计师可能在四个不同的地方出错,所以需求分成四层,每层三道,一层对应一种出错方式。
| 层 | 测什么 | 为什么重要 |
|---|---|---|
| 1. 日常需求 | 简短、单一用途的需求 | 大多数真实请求长这样,这一层最接近日常使用 |
| 2. 信息要对 | 必须原样出现的文字,有时还规定了主次顺序 | 语言模型是唯一把文字交给生图模型的一步;它漏掉或改掉的文字,后面无法补回 |
| 3. 设计判断 | 互相矛盾的要求、陌生的领域、同时面向两类受众 | 这是客户花钱请设计师的原因,也是模型之间最可能拉开差距的地方 |
| 4. 语言与文化 | 带文化背景的日语、德语和墨西哥西班牙语需求 | 文化线索用错,代价比错别字更大 |
需求覆盖六种语言(英语、中文、西班牙语、葡萄牙语、德语和日语),也就是 FontVibe 界面的六种语言,每一道都要求设计上有文字。12 道里有 8 道最早用在 2026 年 9 月一次针对三个 OpenAI 模型的内部测试里。招聘海报里的公司,以及需求里的所有人名和地址都是虚构的。每道题的完整需求印在下面对应的小节里。
轮次与失败
每个模型每道需求跑三遍:每个模型 36 张设计,共 288 张。设计失败时,按原因决定怎么处理:
- 模型自己的输出失败(在生产 token 上限处被截断,或方案为空、格式损坏):记为失败,不重跑。这样失败的有 19 张:Claude Opus 5.5 18 张(17 次方案在上限处被截断,1 次生图指令格式损坏),GPT-5.6 Terra 1 张(方案为空)。
- 厂商服务失败(限流、服务器错误、超时):重跑。共发生 8 次,全部是 Gemini 3.8 Flash。
- FontVibe 自己的前台先提了问题。 请求到达设计师之前,另一个固定的模型会检查有没有缺失的信息。夜店那道需求,它有时没有把需求传下去,而是反问「几乎看不见,还是 50 米外能读到?」。这不是被测模型造成的,所以这 4 次重跑了,打分的是重跑出的设计。每一次尝试都列在开放数据集里。
全部 287 张设计(主测 269 张,加上后文 Opus 重跑的 18 张)都在 2026 年 10 月 30 日用官方账号在 FontVibe 生产站生成,在 FontVibe 上公开。
评分
每张设计都按 FontVibe 的评测打分标准打分,标准在统计结果之前写定。它沿用了我 7 款 AI 设计工具横评和两次生图模型测试的评分细则。评委扮演写需求的客户,按这个顺序判断:是不是我要的东西;能不能不改就直接用;是不是我想要的感觉;细节做得好不好;第一眼会不会让我说「哇」。
| 打分项 | 权重 | 看什么 |
|---|---|---|
| 可读性 | 20% | 先查让主文字在实际尺寸下读不出或读错的硬伤。有任何硬伤给 1 到 4 分;没有硬伤给 7 到 10 分。 |
| 字形与材质 | 35% | 字形和材质有没有做出需求要的效果和氛围,做得好不好。 |
| 信息与构图 | 25% | 是不是对的交付物,每一段文字能不能原样使用:完整、和客户写的一致、没有客户没说过也无法担保的内容。然后看层级、顺序和平衡。 |
| 吸引力 | 20% | 只看第一印象和视觉上的专业程度。文字错误只在信息与构图里扣一次,这里不再扣。 |
总分由公式算出,不靠主观判断:0.20 × 可读性 + 0.35 × 字形与材质 + 0.25 × 信息与构图 + 0.20 × 吸引力。
有一条规则决定了很多分数,所以在这里完整写出来。每一行文字都要问:客户用之前得不得改它,客户有没有说过它? 复述需求里已有的内容(咖啡烘焙坊写「COFFEE ROASTERS」)和寻常的祝福语(「Happy birthday」)可以接受。客户从没给过的事实、数字、承诺和标语,每出现一处扣一次分,因为客户要么得把它删掉,要么会在没注意到的情况下发布不实的内容。原样印出来的占位符,比如 {{fecha}},以及改动客户的写法,比如把「7 de la noche」改成「7:00 p. m.」,也要扣分。
谁来打分。 分数来自运行在 Claude Opus 5.5 上的 AI 评委,每三道需求一位评委,每位评委在给一道需求的任何一张图打分前,先看完这道需求的全部原图。图片用随机 ID 编号,评委不知道哪张设计出自哪个模型。八个被测模型之一 Claude Opus 5.5 与评委是同一个模型。看它的分数时要记住这一点:评委会不会偏向 Opus 自己的设计,这次没有验证。由人做的盲选是这次测试里唯一的人工核对。
逐题结果
每个网格展示每个模型第一张完成的设计,所以没有一张是人工挑的。说明里写的是这张图的分数,以及该模型这道题三次运行的平均分。
第 1 层:日常需求
第 1 题:咖啡烘焙坊字标
A logo-style title for my new coffee roastery called EMBER & OAK
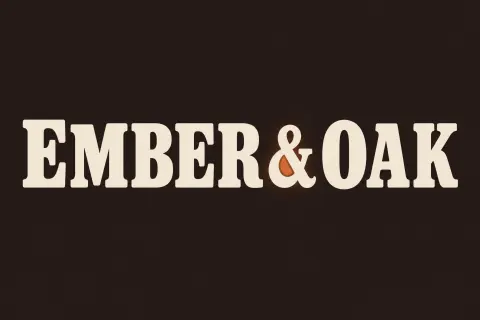
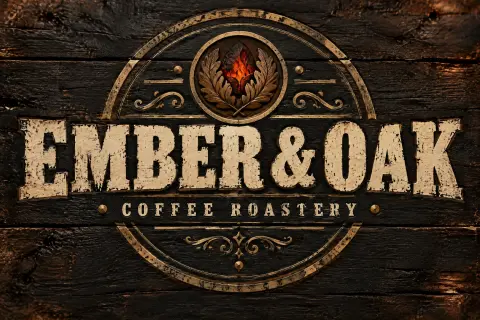
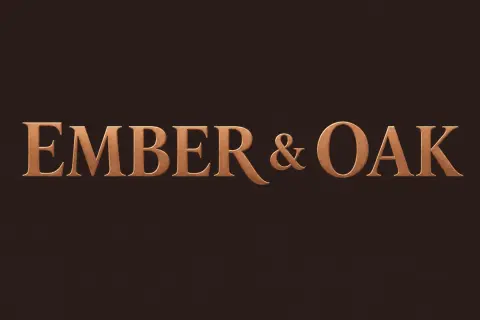
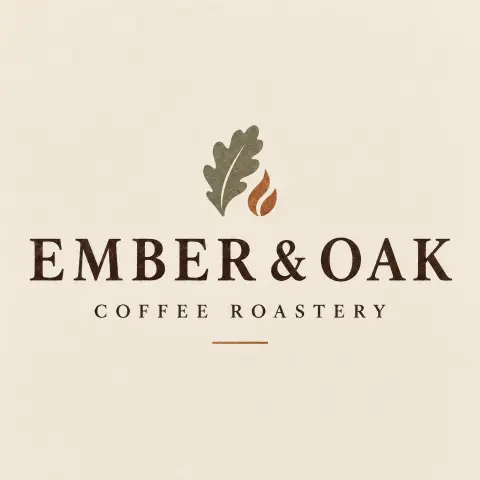
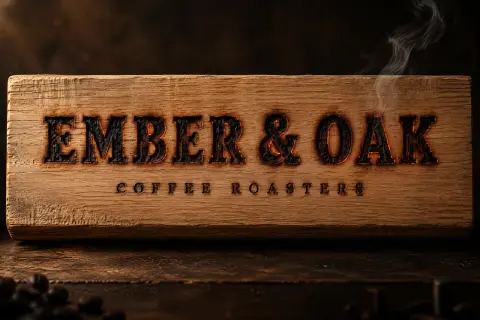
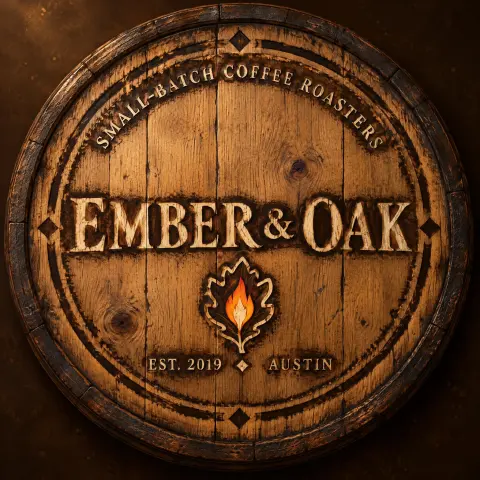
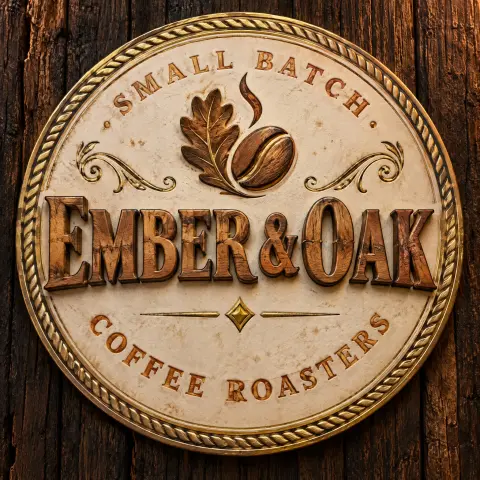
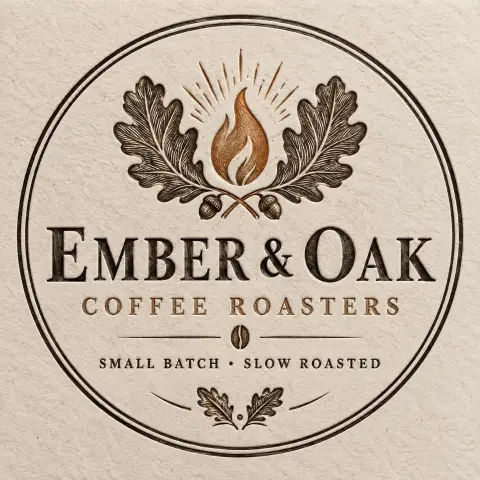
Claude Opus 5.5 平均 8.38 分,最高:它把店名烙在木头上,每个字母的边缘都有焦痕。GPT-5.6 Terra(8.13)和 GPT-6 Luna(8.05)紧随其后。GPT-6.1 Terra(6.62)和 GPT-6.1 Sol(6.43)用干净但普通的字体排了店名,评委判定只部分符合需求里的「ember and oak」(余烬与橡木)。Claude Sonnet 5.5 的设计编了一个创立年份和一个城市,「EST. 2019」和「AUSTIN」,客户都没给过。
第 2 题:恐龙生日海报
给我做一张生日海报,寿星叫小雨,今年 8 岁,喜欢恐龙
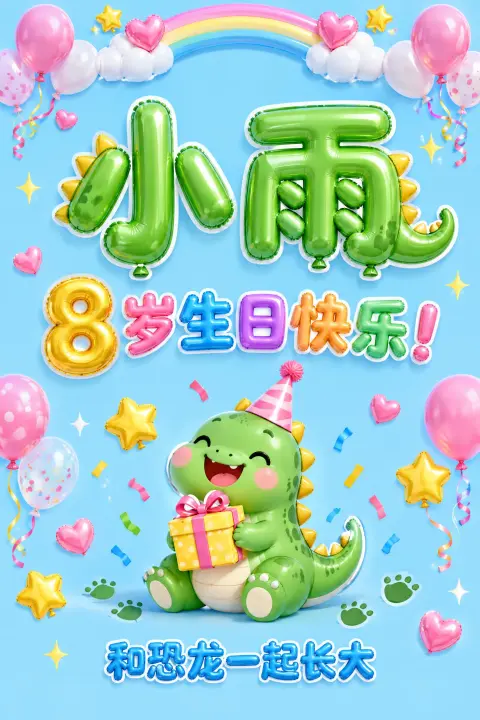
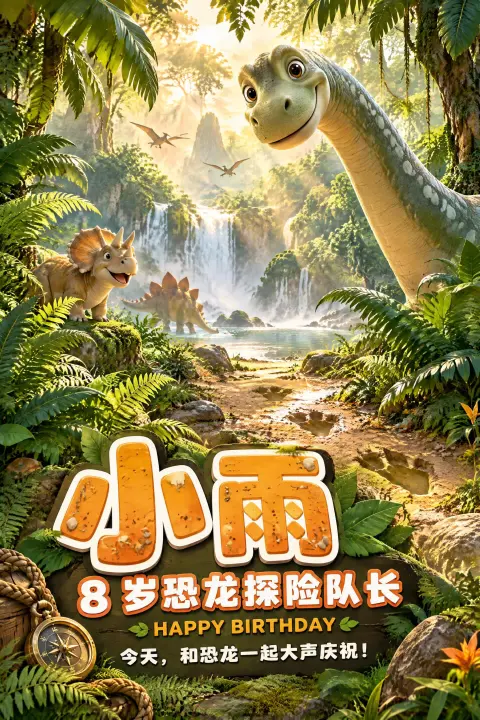
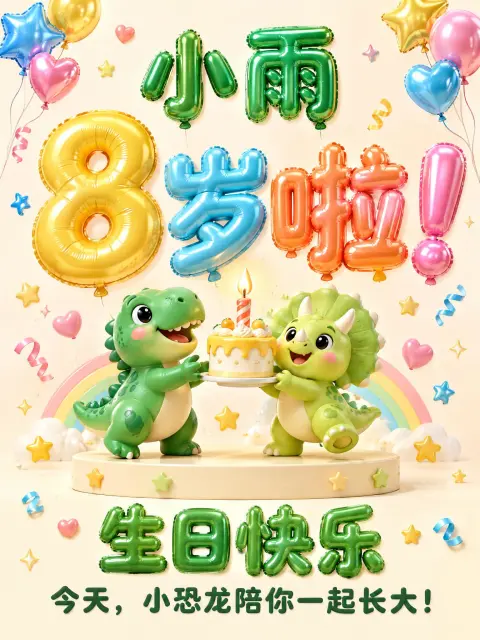
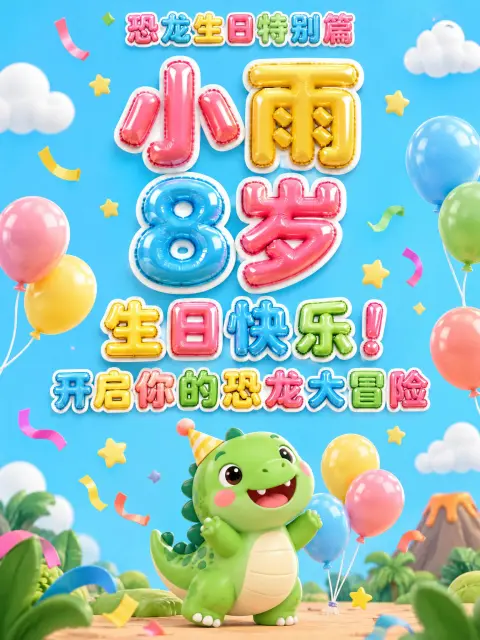
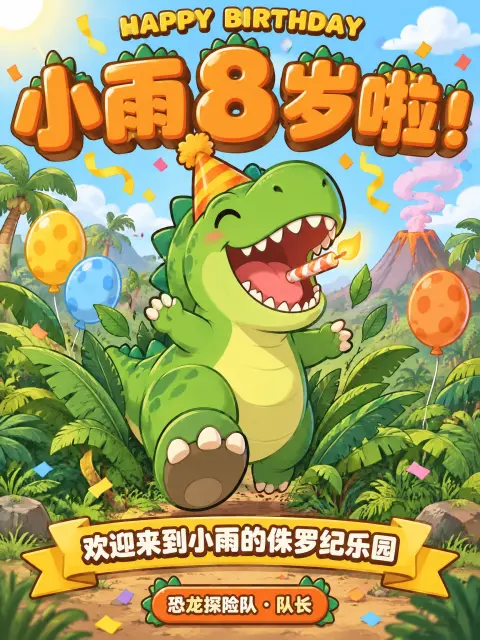
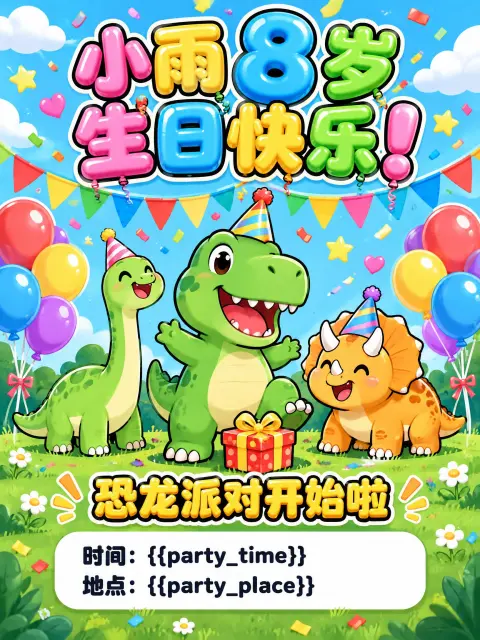
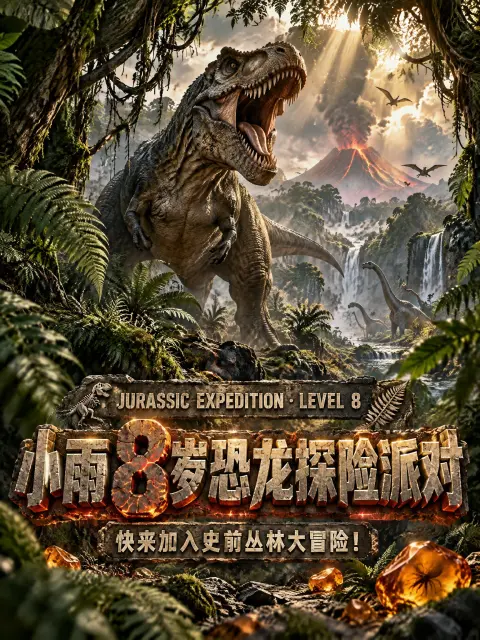
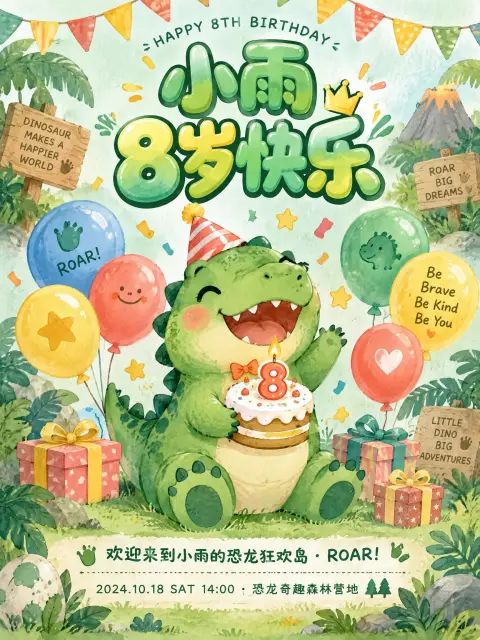
这道题 OpenAI 的模型表现最好。GPT-6.1 Sol 8.73 分;GPT-6.1 Terra 8.43 分,是它分数最高的一道题,小雨名字里的「雨」字长出了一条恐龙尾巴。Gemini 4 Argon 最后,6.48 分:照片级写实的丛林,加上客户从没提过的「Jurassic Expedition · Level 8」派对,评委判定只部分符合八岁孩子的生日。想做 GPT-6.1 Sol 那样的气球字,可以看泡泡字生成器。Gemini 3.8 Flash 的第一张设计给一场并不存在的派对编了日期、时间和地点,而且那个日期已经过去了。
第 3 题:毕业派对海报
Un cartel para la fiesta de graduación de secundaria, dice PROMOCIÓN 2026(一张高中毕业派对海报,上面写着 PROMOCIÓN 2026。)
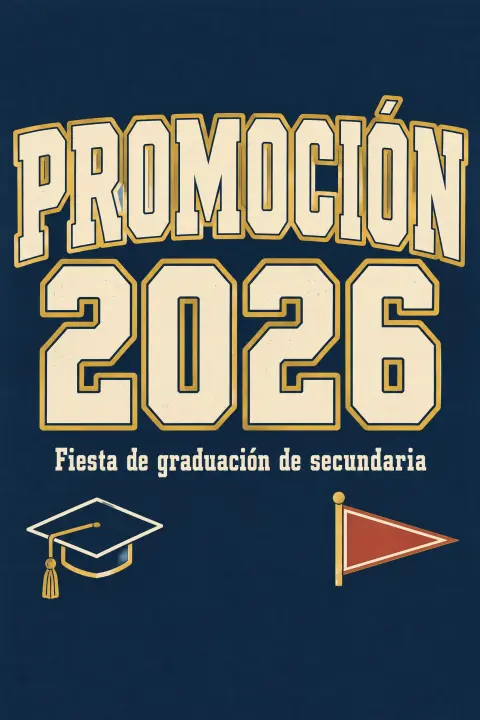
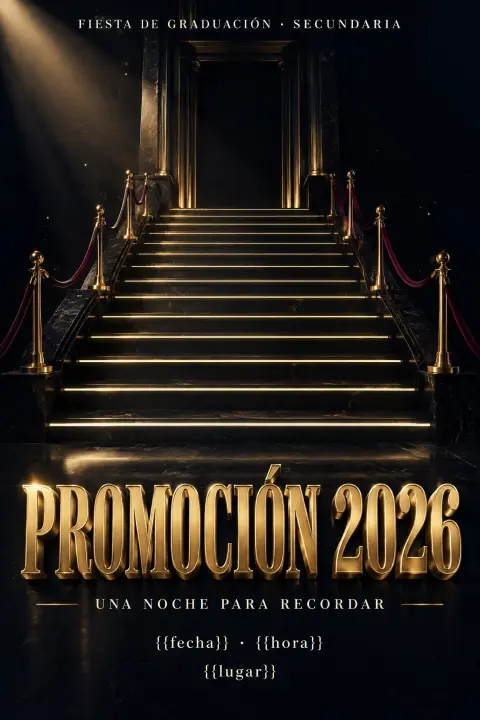
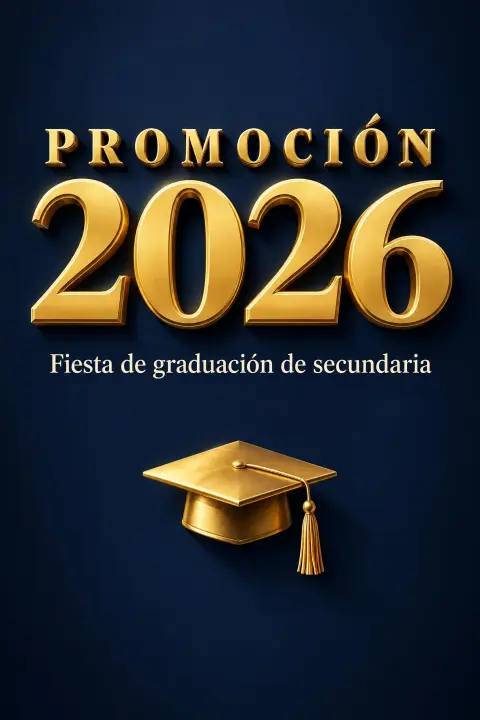
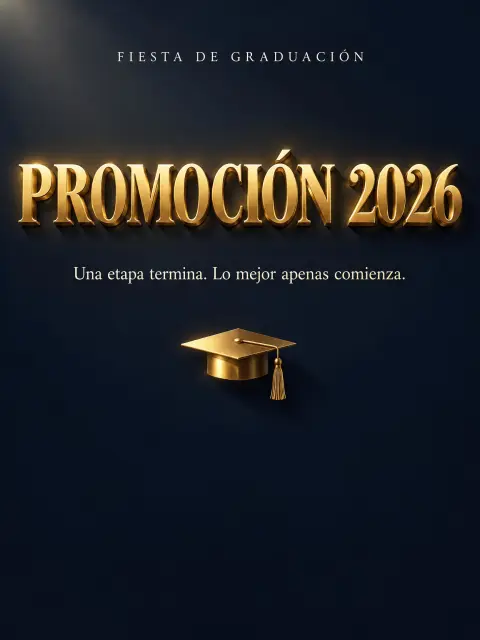
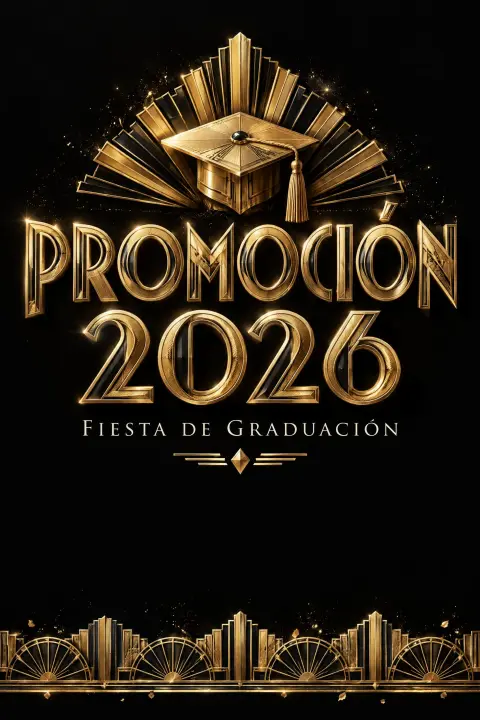
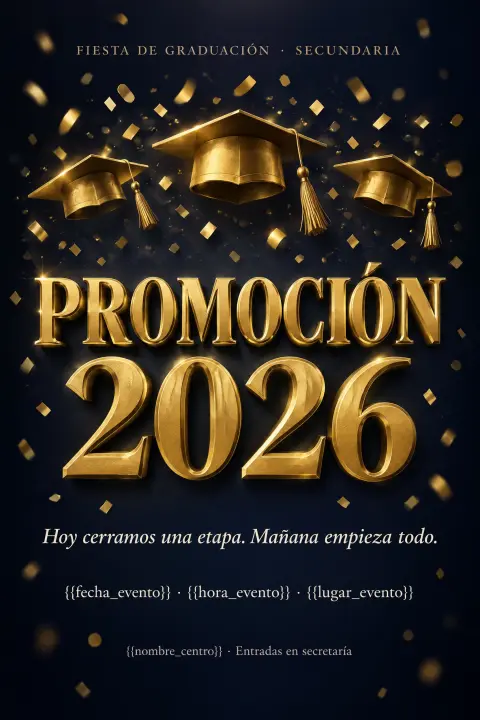
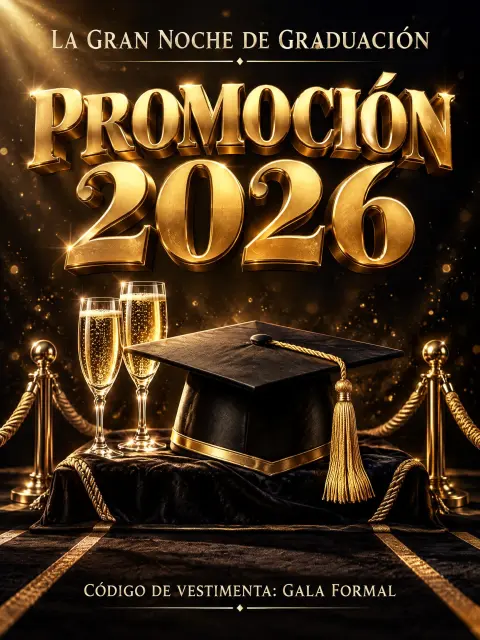
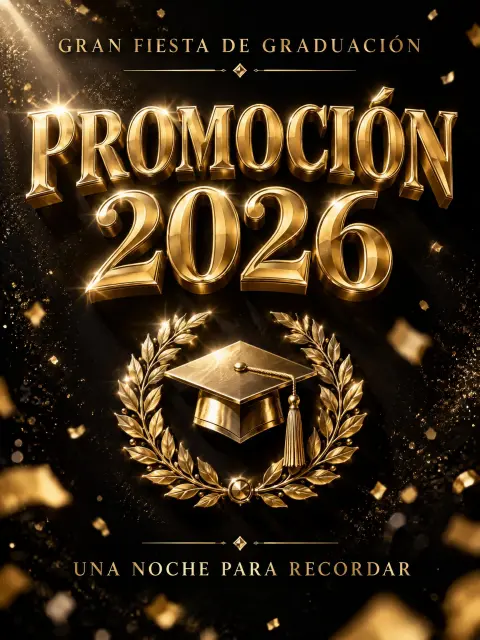
每个模型都把 PROMOCIÓN 的重音符号写上了。Gemini 4 Argon(8.40)和 Gemini 3.8 Flash(8.28)用金色字和月桂枝拿到最高分,不过 Argon 有一张设计加了正装着装要求,这道题还有两张设计在学校派对上画了香槟杯。这道需求没有日期和地点,很多设计在底部留了一块本该放这些信息的空白,或者在那里印出了 {{fecha}} 之类的占位符。
第 2 层:信息要对
第 4 题:YouTube 缩略图
YouTube thumbnail text for a video about losing 30 pounds, title THE SHIFT
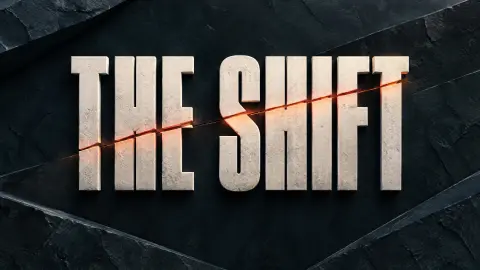
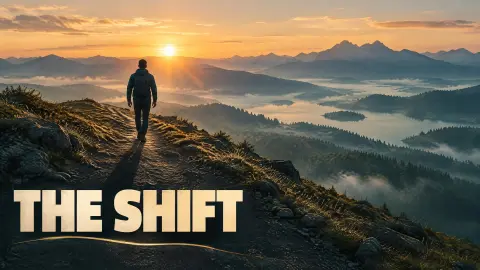
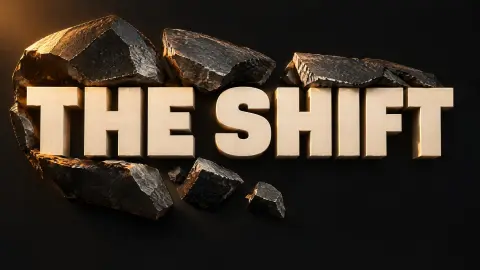
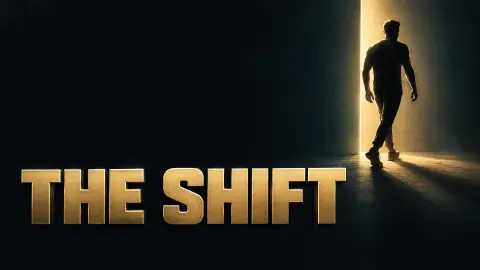
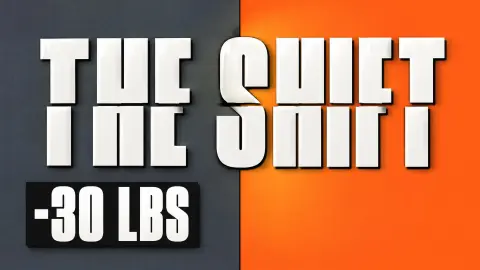
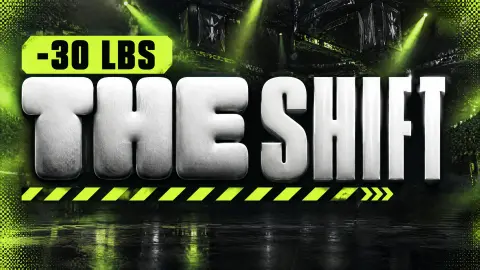
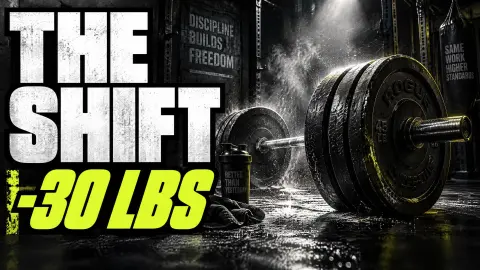
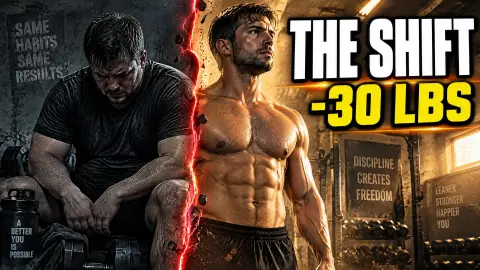
Claude Sonnet 5.5 8.20 分,最高:用黏土质感的「THE」对比镜面质感的「SHIFT」,表现前后的变化。GPT-6 Luna 7.97 分。Claude Opus 5.5 最后,6.53 分:它的第一张设计把每个字母的两半错开,看起来像印刷错误。Gemini 4 Argon 和 Gemini 3.8 Flash 在背景里铺满了客户没写过的健身标语。
第 5 题:含七项信息的招聘海报
招聘海报:标题「一起把账算明白」,副标题「马来西亚 AI 公司,招两位财务」,要写上公司名 Northwind Labs Sdn Bhd、月薪 RM6000-9000、地点吉隆坡 Bangsar、投递邮箱 jobs@northwindlabs.my、截止 10 月 15 日。标题最大,邮箱最小。
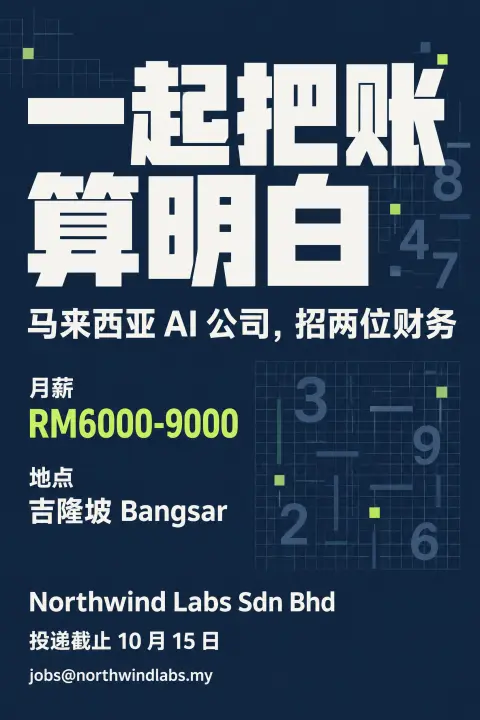
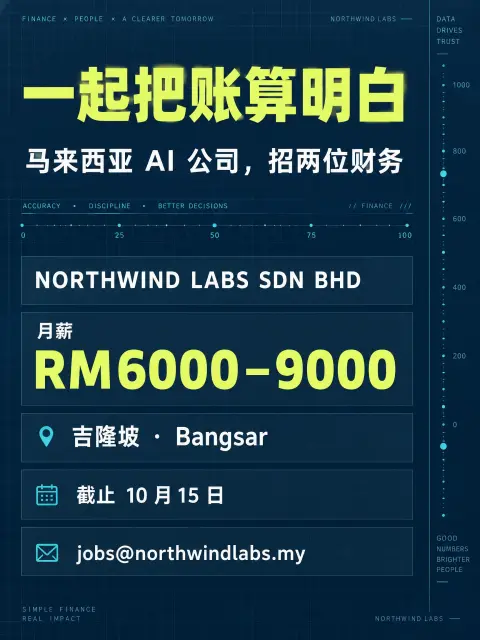
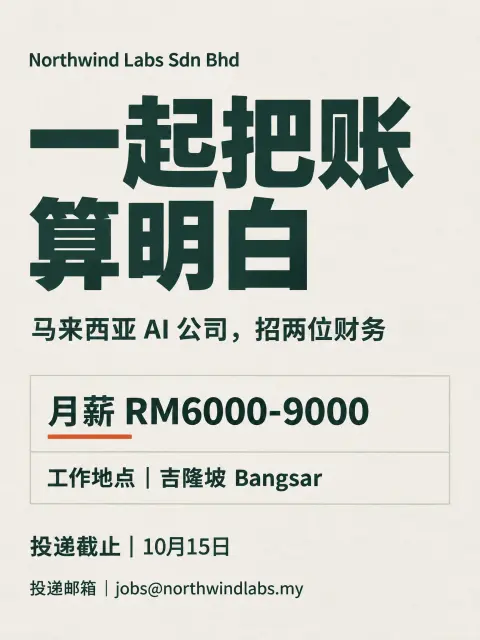
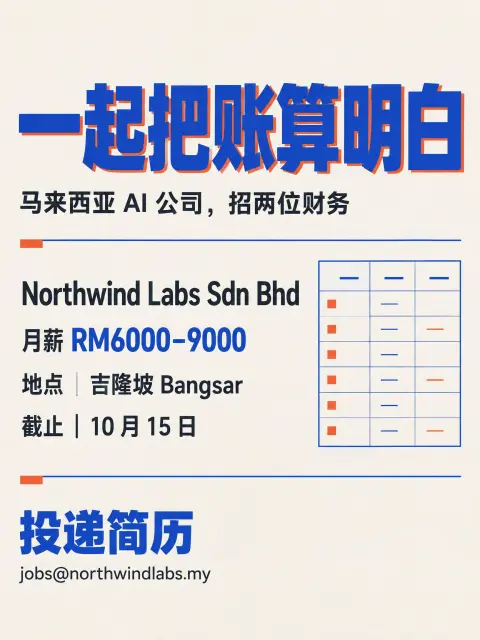
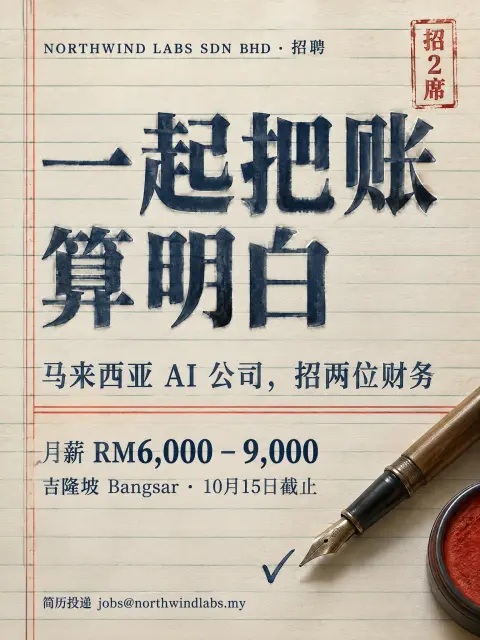
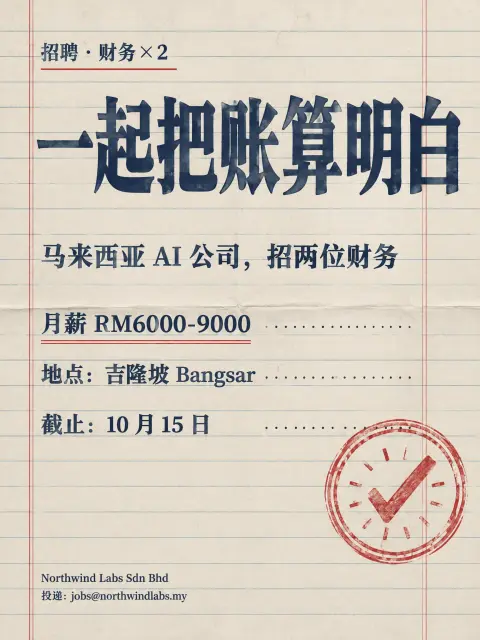
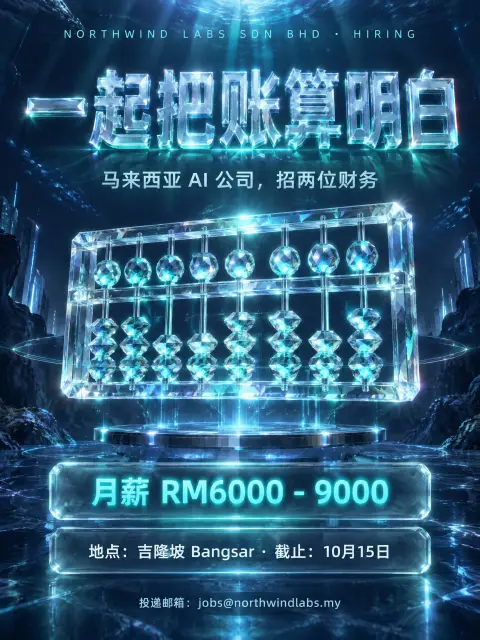
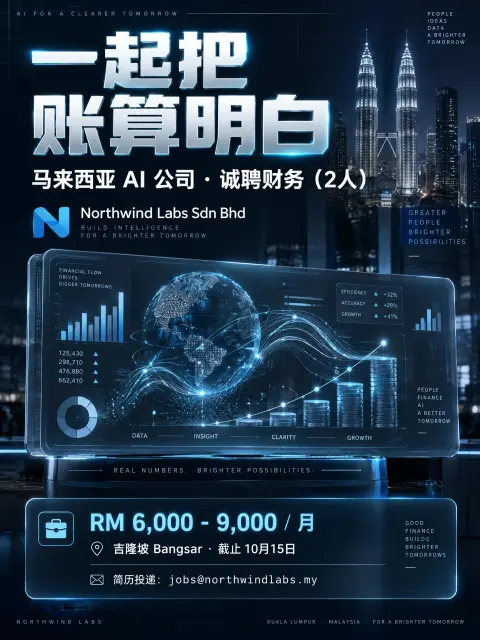
这道题最能拉开模型之间的差距。Claude Sonnet 5.5 7.92 分,用账本纸配红色印章,七项信息和字号顺序全部保留。Gemini 3.8 Flash 最低,6.12 分:它的第一张设计在海报上塞满了英文标语、一个 logo 和几块虚构数字的仪表盘,还改了客户的副标题。Claude Opus 5.5 三次运行全部卡在生产 token 上限;上限翻倍后,它做出了这道题最好的设计,8.95 分,标题同样是纸上墨迹的效果,配一枚印章和一支钢笔。
第 6 题:咖啡杯套
Uma capa para o copo de café para viagem da minha cafeteria em Belo Horizonte, a Grão de Ouro. Tem que ter o slogan "Café de verdade, sem pressa" e "Desde 1998".(给我咖啡馆的外带杯做一个杯套,要有店名、标语和「始于 1998」。)
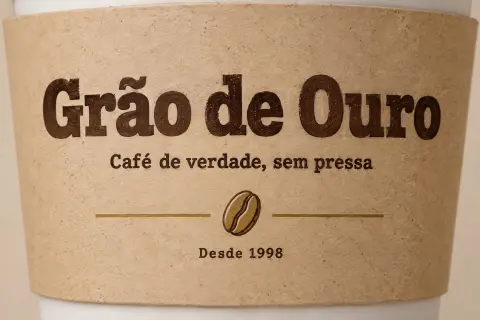
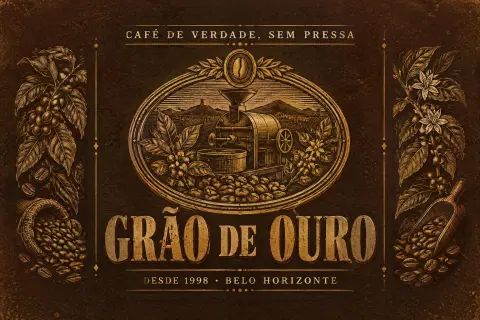
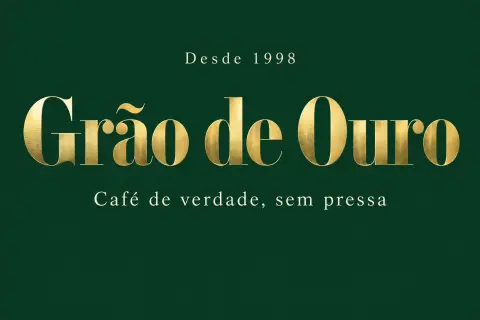
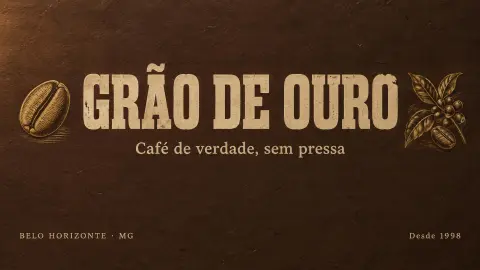
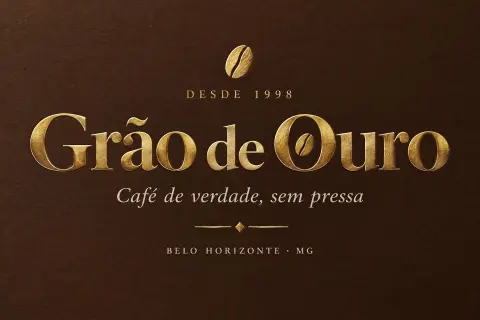
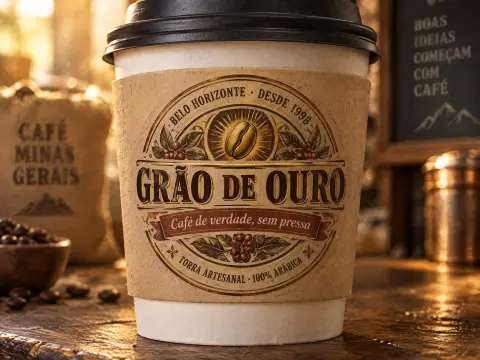
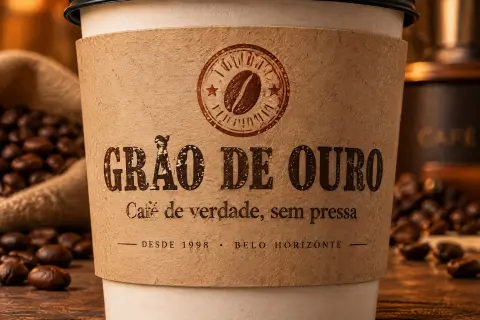
Claude Opus 5.5 完成的两次平均 8.97 分,用烫金衬线字,O 画成一颗咖啡豆。GPT-5.6 Terra(8.30)和 Claude Sonnet 5.5(8.38)次之。Gemini 3.8 Flash 的第一张设计把 GRÃO 的波浪符画错了,店名读起来更像「GRÁO」。Gemini 4 Argon 加了「100% ARÁBICA」这类咖啡馆从没说过的宣称。只想要烫金字,可以试试金色文字生成器。
第 3 层:设计判断
第 7 题:要求互相矛盾的夜店字标
I want an extremely minimal, quiet, almost invisible wordmark for my nightclub — but it also has to scream across a dark street from 50 metres away and feel expensive. The name is VOID.
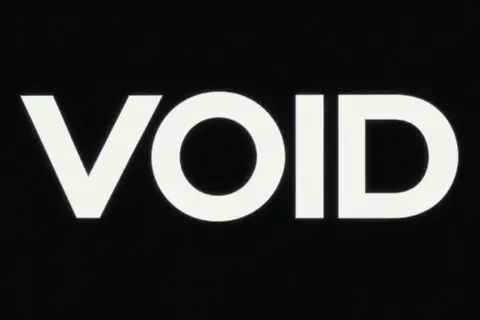
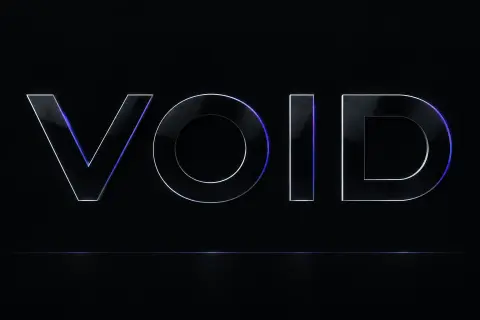
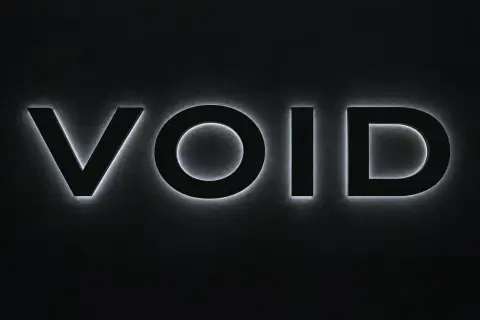
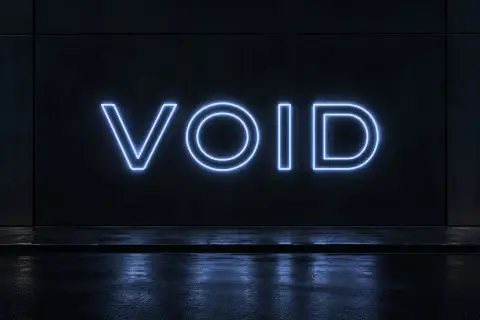
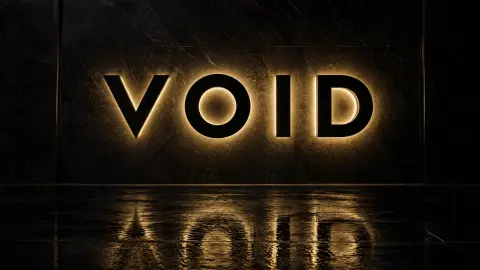
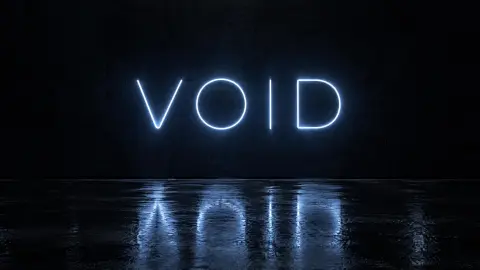
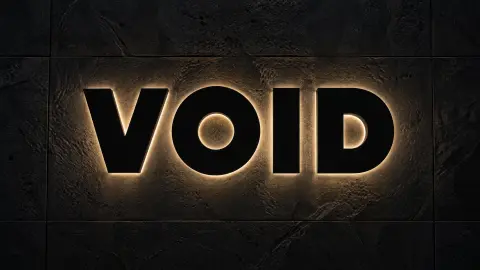
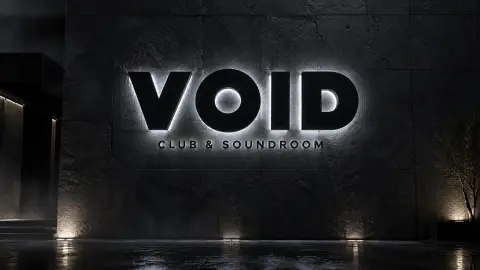
最好的几张设计用背光化解了矛盾:黑墙上的黑字,近看几乎消失,入夜后发光。Gemini 4 Argon(8.13)、Gemini 3.8 Flash(8.05)和 Claude Opus 5.5(7.88)做得最好。GPT-6.1 Terra 最后,5.48 分:它的第一张设计是黑底上平面的白色粗体字,够醒目,但既不安静也不显贵。GPT-5.6 Terra 5.90 分。想做发光招牌,店面招牌生成器从发光的店招起步。
第 8 题:科学期刊封面
Cover art for a peer-reviewed paper on cryo-EM structural determination of amyloid fibrils. Title: CONFORMATIONAL POLYMORPHISM. It has to look like it belongs on the cover of Nature, not like a startup pitch deck.
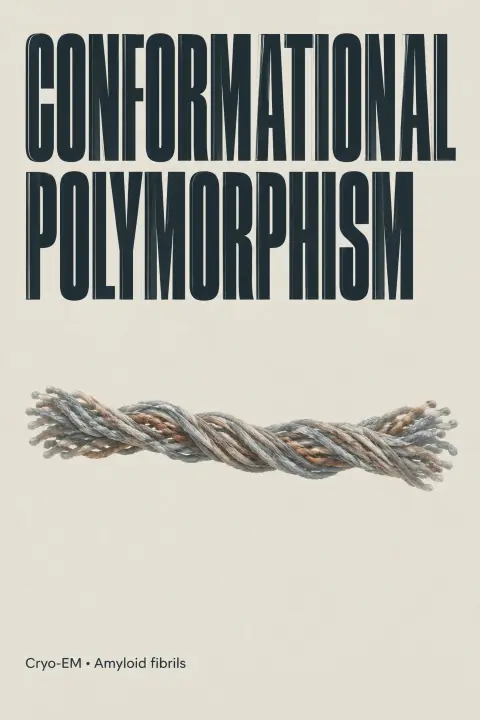
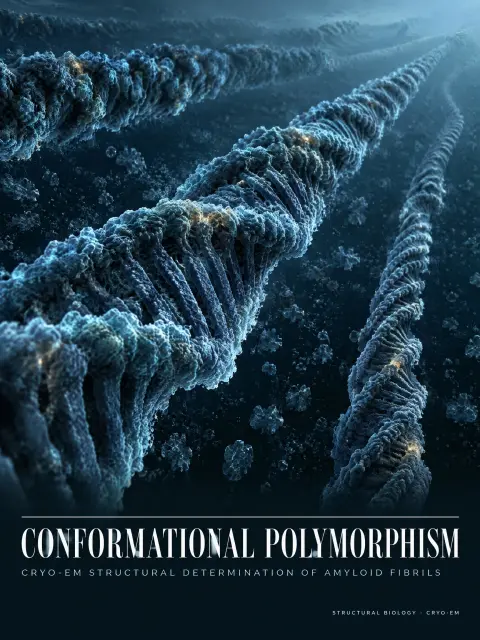
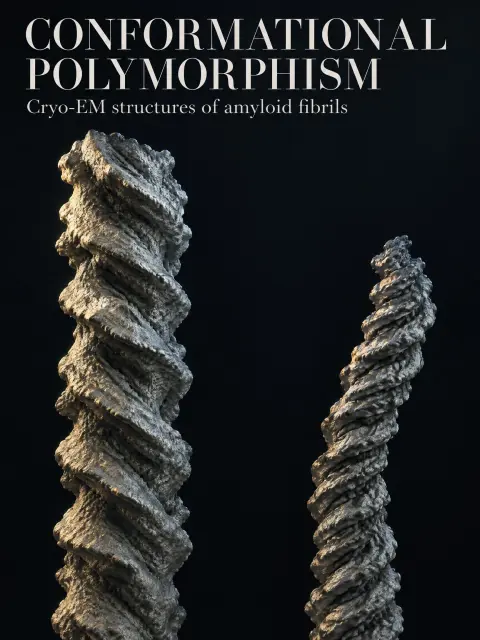
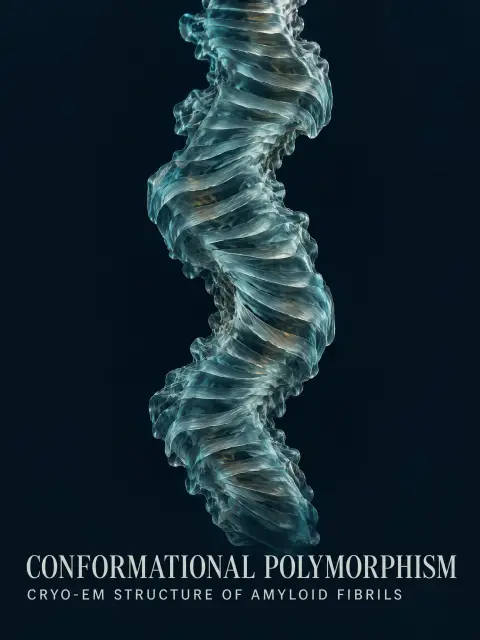
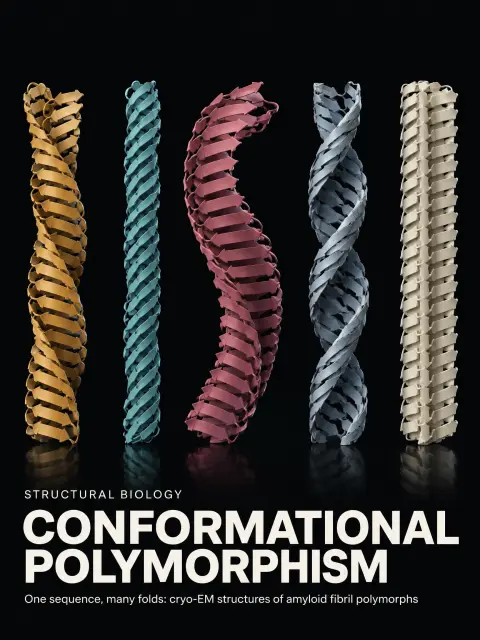
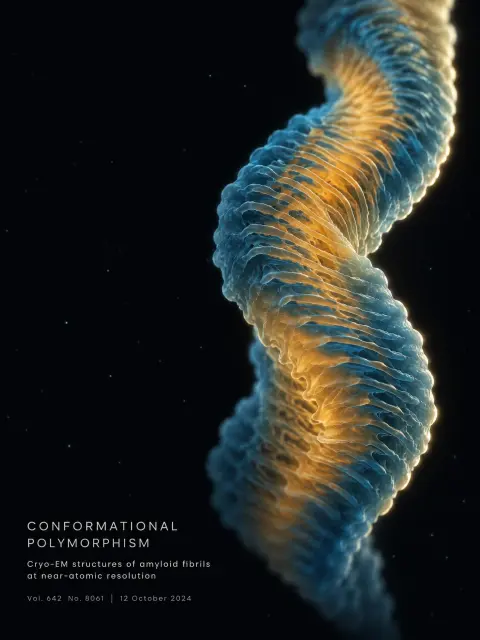
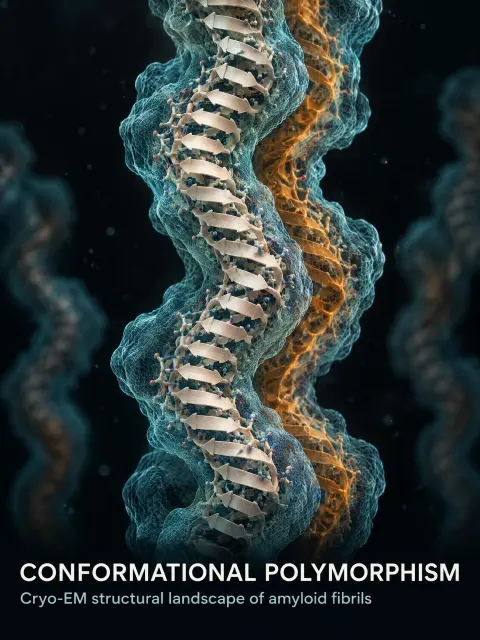
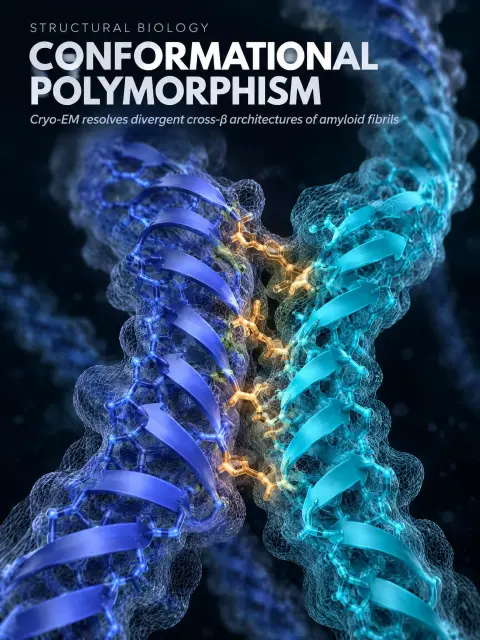
GPT-6.1 Sol(7.65)、GPT-5.6 Terra(7.47)和 GPT-6 Luna(7.43)用克制的衬线标题和玻璃质感的纤维拿到最高分。有几张设计把纤维画成了梯子状的双螺旋,看起来像 DNA,这在一张讲淀粉样蛋白的封面上是科学错误。Claude Sonnet 5.5 编了卷号、期号和日期。Claude Opus 5.5 三次运行全部卡在生产上限。
第 9 题:面向两代人的纹身店招牌
A shop sign for my tattoo studio called INKWELL. It should still feel welcoming to my grandmother's generation.
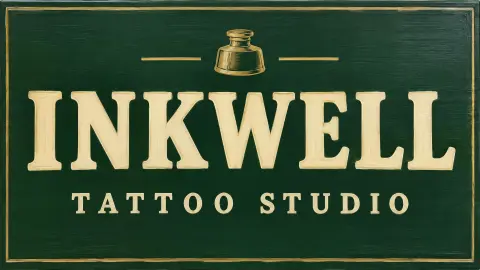
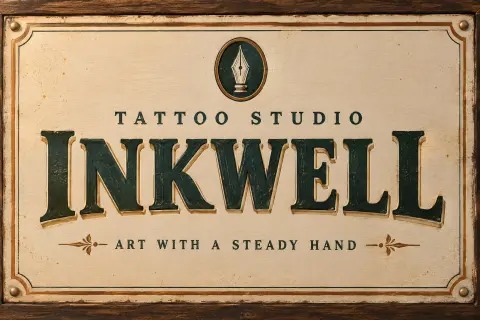
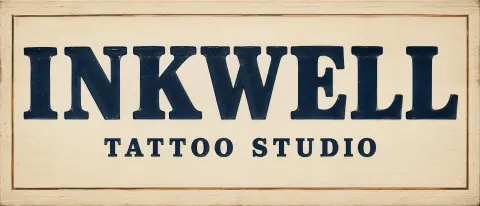
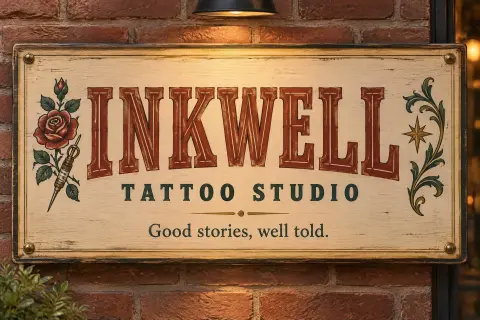
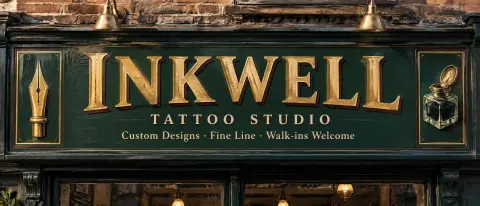
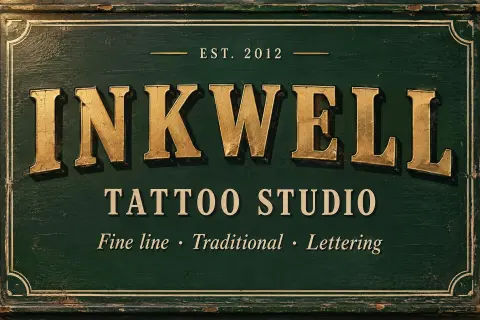
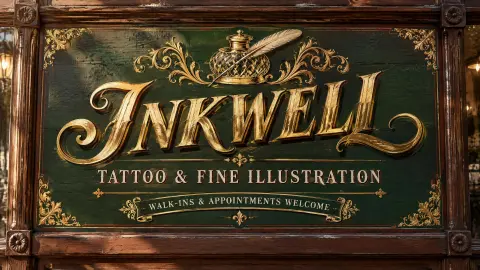
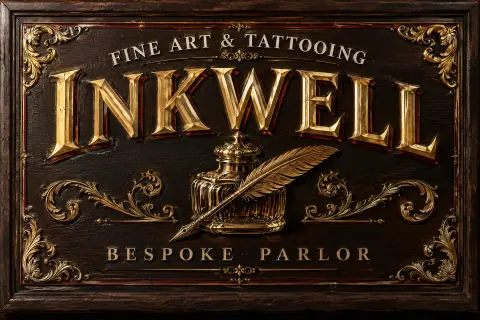
这道题到处是编造的文字:宣传语、服务清单、「Walk-ins welcome」,还有两个虚构的创立年份。Claude Opus 5.5 8.25 分,最高;GPT-6 Luna 7.95 分。Gemini 4 Argon 最后,6.37 分:它的第一张设计用了一个装饰性的大写 I,读起来像 J,店名看着像「JNKWELL」。只印店名和「Tattoo Studio」的设计准确,但往往朴素。
第 4 层:语言与文化
第 10 题:日本刨冰摊招牌
夏祭りの屋台の看板を作ってください。「かき氷」と書いて、昭和レトロな駄菓子屋の雰囲気で。提灯の灯りみたいな温かさがほしい。(夏日祭典摊位的招牌,写「かき氷」,要有昭和复古零食铺的氛围和灯笼光的暖意。)
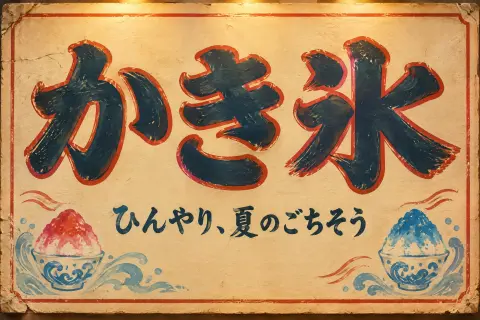
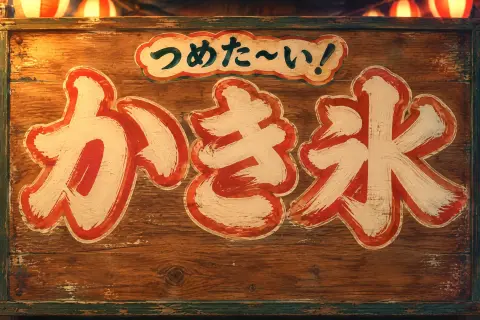
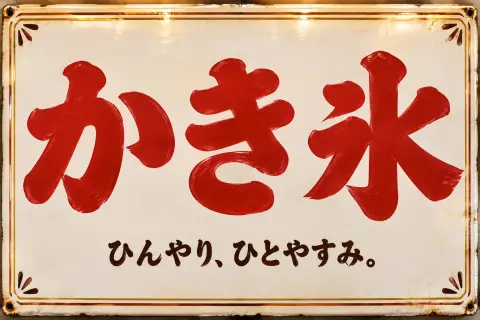
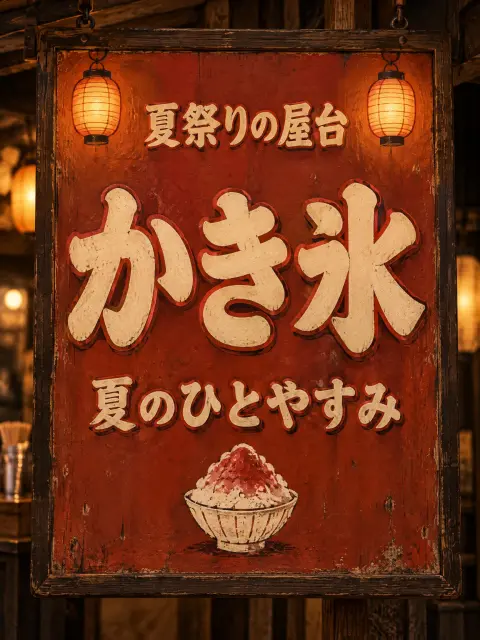
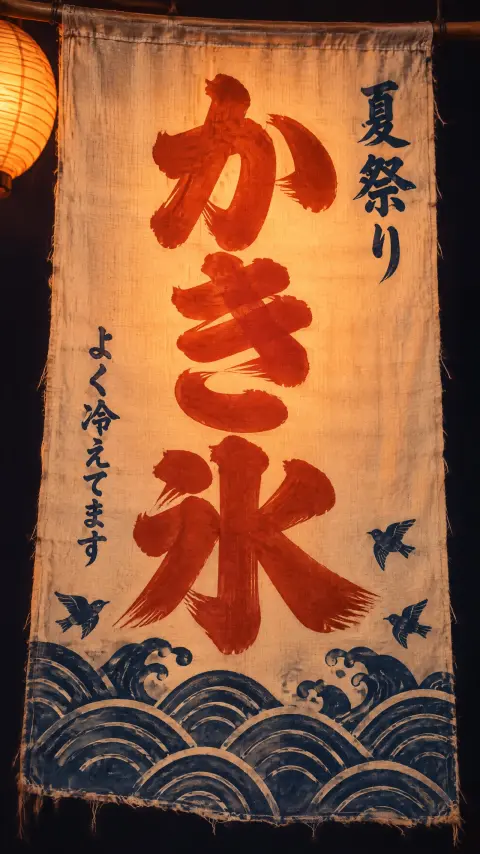
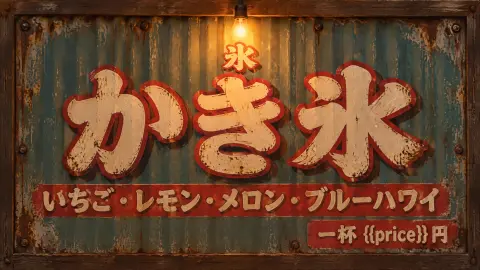
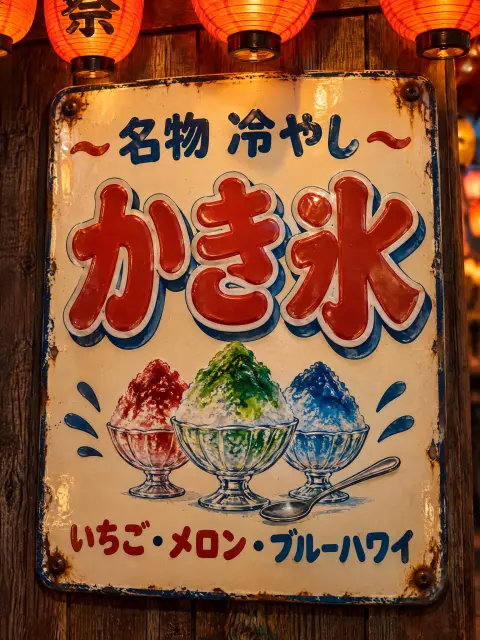
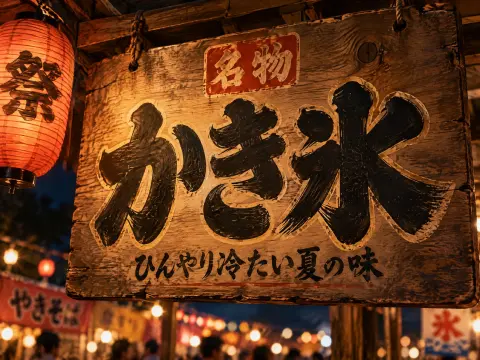
每个模型都把かき氷写对了。Claude Opus 5.5(8.55)、Gemini 4 Argon(8.38)和 GPT-5.6 Terra(8.27)用染布幡和搪瓷招牌拿到最高分。大多数设计加了一句短语,比如「ひんやり」(冰冰凉凉),或一串糖浆口味,这些都算扣分项。两张设计印出了 {{price}},一张编了一个价格。
第 11 题:德国面包店开业招牌
Ein Schild für die Neueröffnung unserer Bäckerei „Großmanns Backstube" in Leipzig. Öffnungszeiten: Mo–Sa 6:30–18 Uhr, So 7–12 Uhr. Gemütlich, aber nicht kitschig.(我们面包店的开业招牌,写上店名和营业时间。温馨,但不要俗气。)
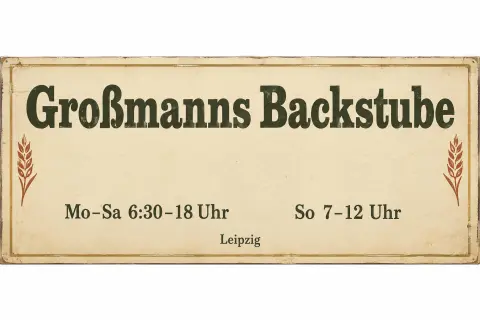
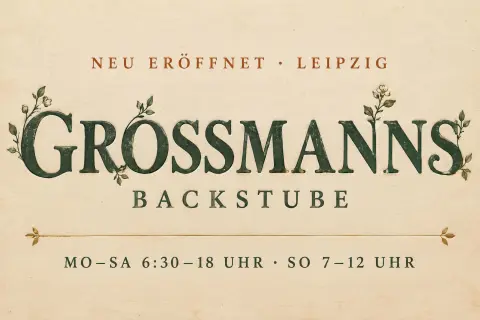
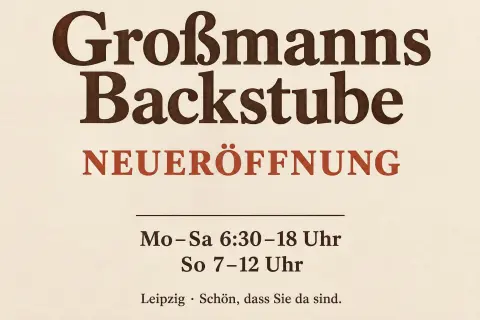
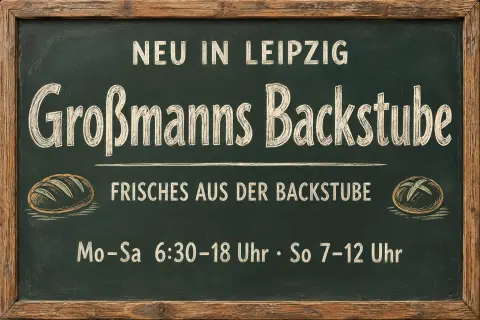
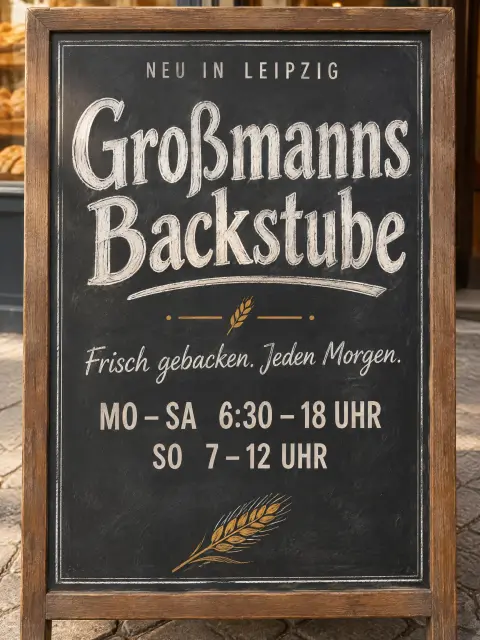
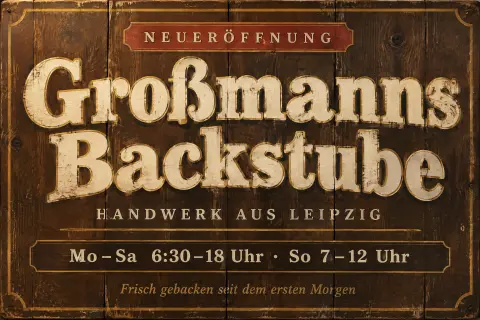
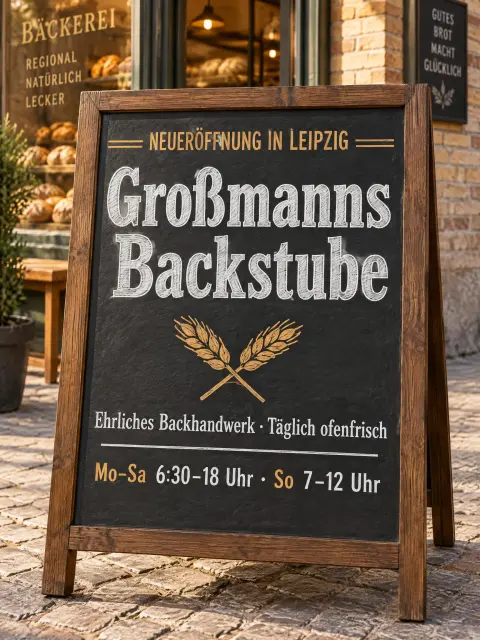
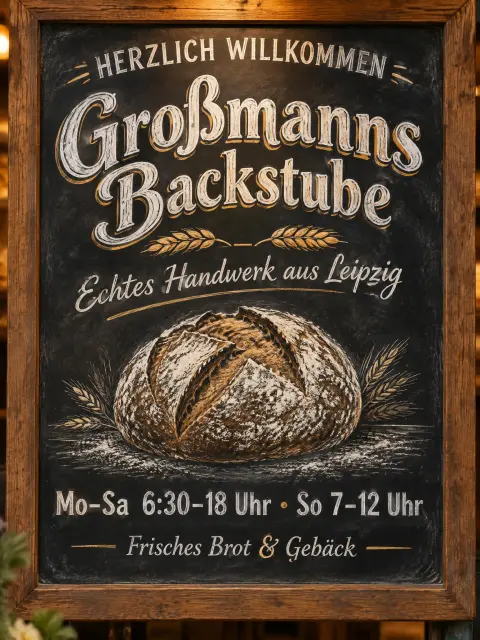
每个模型都把 Großmanns 的 ß 写对了。Claude Sonnet 5.5 8.03 分,最高,用的是木板上带描边的做旧字。GPT-6.1 Terra(6.32)和 GPT-6.1 Sol(6.62)用平面的数码字体排版,没有温度。Claude Sonnet 5.5 的三张设计都加了面包店没写过的标语,比如「Frisch gebacken seit dem ersten Morgen」(从第一个早晨起就新鲜出炉),Gemini 3.8 Flash 也一样。Claude Opus 5.5 三次运行全部卡在生产上限。
第 12 题:亡灵节请柬
Invitación para la reunión familiar de Día de Muertos en casa de la abuela Rosa. Domingo 1 de noviembre de 2026, 7 de la noche, Calle Hidalgo 45, Oaxaca. Algo cálido y respetuoso, no de disfraz.(邀请家人到 Rosa 奶奶家参加亡灵节聚会的请柬,写上日期、时间和地址。温暖、庄重,不要变装派对那种。)
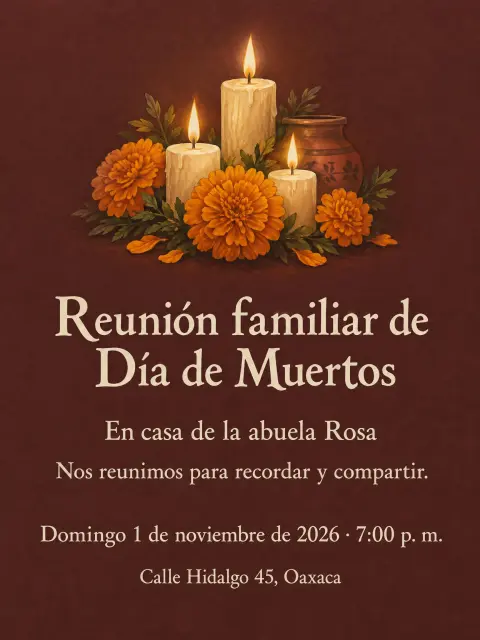
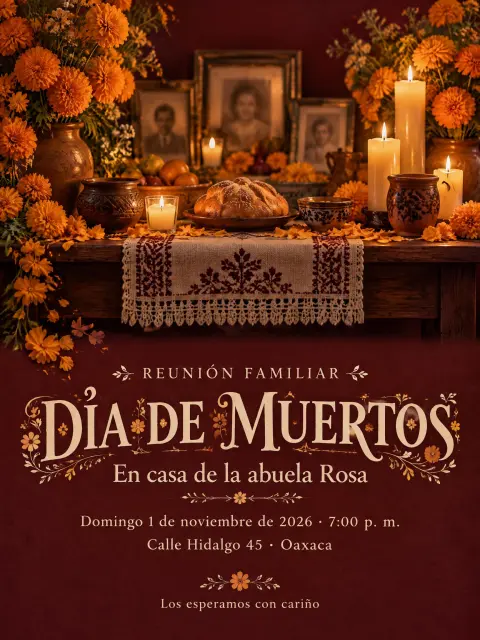
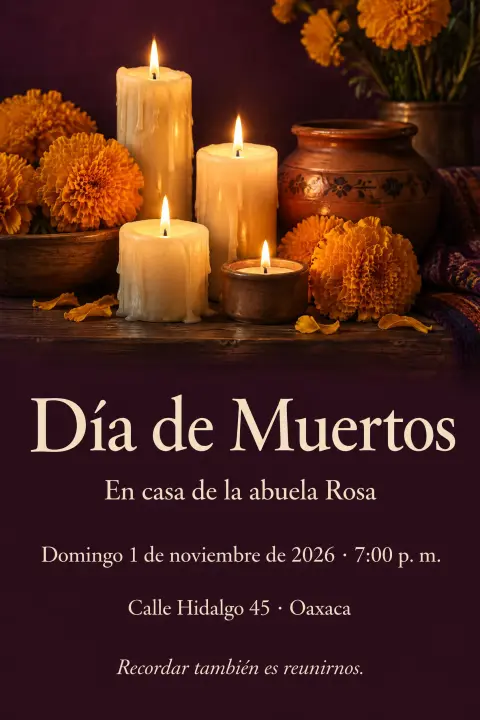
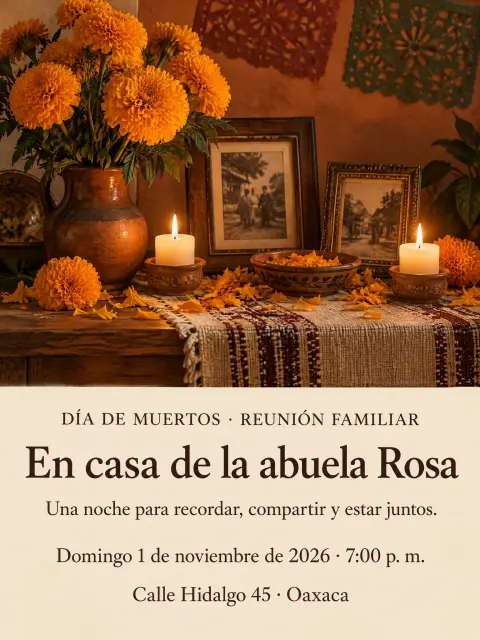
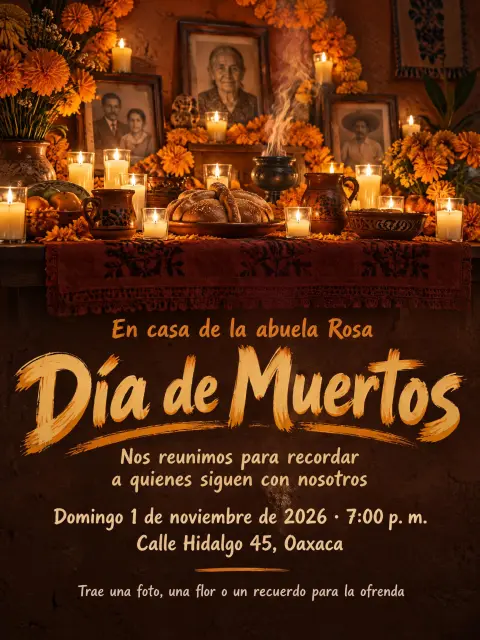
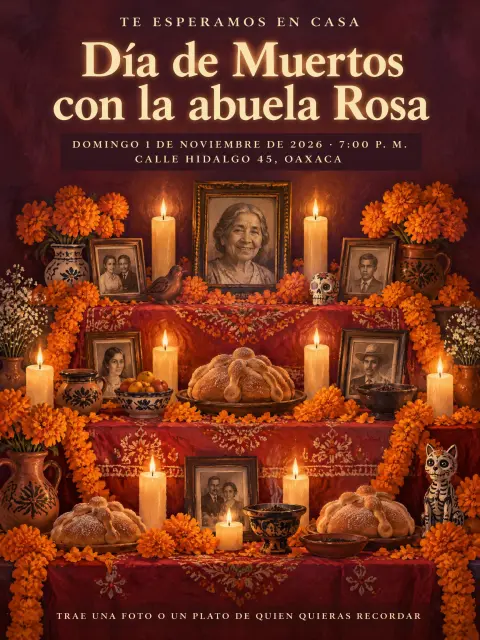
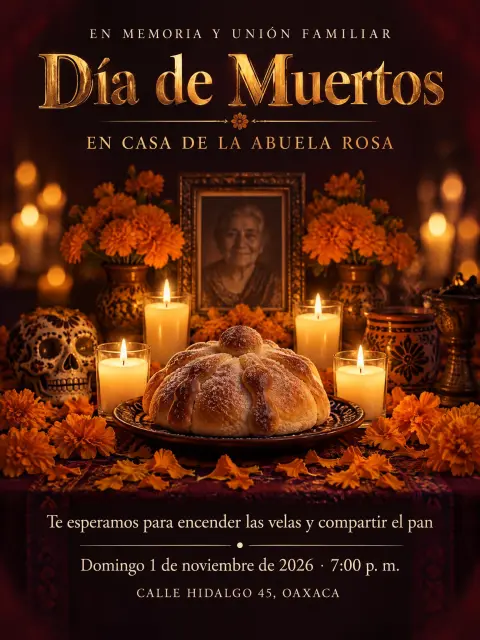
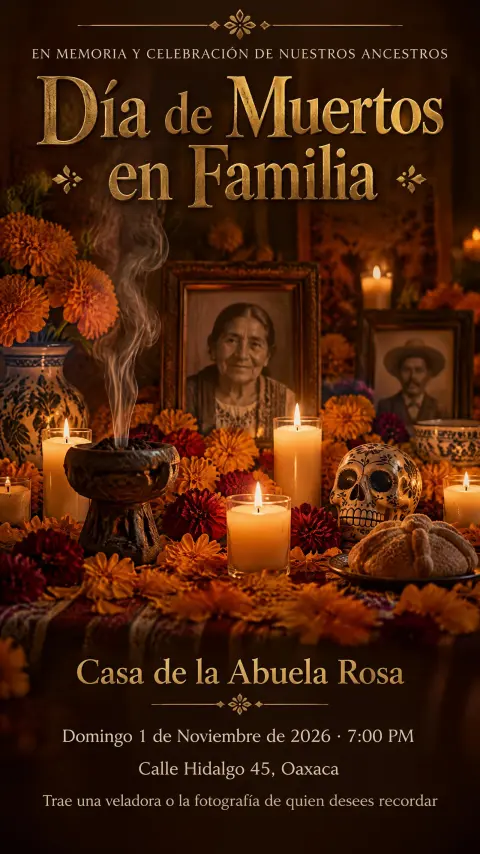
没有一张设计把聚会做成万圣节变装派对,每张都保留了日期和地址。几乎所有设计都把「7 de la noche」改成了「7:00 p. m.」。GPT-5.6 Terra 8.22 分,最高。有几张设计出现了一个更隐蔽的问题:祭坛正中放了一张老妇人的肖像,紧挨着「abuela Rosa」,读起来就像 Rosa 本人已经去世。Claude Opus 5.5 三次运行全部卡在生产上限。
加大预算后的 Claude Opus 5.5
FontVibe 把一份设计方案限制在 6,600 个输出 token 以内,思考部分也算在内。Claude Opus 5.5 写的方案比其他任何模型都长。36 次运行里,它的方案有 19 次触到这个上限:17 次被截断而失败,2 次仍然完成。另有 1 次失败原因不同:方案没到上限,但第二步写出的生图指令格式损坏。其他模型里只有 GPT-6 Luna 的方案触到过 1 次上限,也完成了。
为了看 Opus 不被截断时的表现,我只把它失败的 18 次重跑了一遍,两个输出上限都翻倍,其他一概不变。18 次全部完成。其中 13 次方案用了超过 6,600 个 token(中位数 7,286,最长 8,890),方案耗时中位数 76 秒。这 18 张设计平均 8.10 分,Opus 全部 36 张设计合计 8.04 分(95% CI 7.70–8.30)。在全部 12 道题上和其他模型逐题比较,这 36 张明显高于 GPT-5.6 Terra(+0.46)、Claude Sonnet 5.5(+0.60)、GPT-6.1 Sol(+0.68)、Gemini 3.8 Flash(+0.71)和 GPT-6.1 Terra(+0.96),与 GPT-6 Luna(+0.35,95% CI −0.06 到 +0.71)、Gemini 4 Argon(+0.48,−0.05 到 +0.98)分不出高下。
这些重跑不计入主排名,因为其他模型都没有拿到更大的预算。6,600 token 是 FontVibe 按自己的线上场景定的上限,不是模型的能力上限;重跑说明 Opus 在预算够时每次都能完成,质量也站得住,代价是更高的成本和更长的等待。它在主表里的平均分来自 8 道题上的 18 张设计,而它失败的大多是第 2 到第 4 层、要安排更多文字的需求,所以这个平均分偏向较容易的需求,这也是它在主表里不参与排名的原因。
一次非客户的盲选
FontVibe 的创始人看了每道题里每个模型的一张设计,顺序随机、隐去模型名,挑出他会用的那张。他的 12 次选择:Gemini 3.8 Flash 4 次,Claude Sonnet 5.5 3 次,GPT-5.6 Terra 2 次,Gemini 4 Argon 2 次,Claude Opus 5.5 1 次。他一次也没选 GPT-6 Luna,两个 GPT-6.1 模型也都没选。
在每道题他看到的 8 张设计里,有 2 道他选的正是评委打分最高的那张;和每道题全部设计里的最高分相比,一次也没有重合。差异有一个明确的来源:他选的 12 张里有 8 张带着需求从没给过的文字。在字形与材质和吸引力上,他选的设计几乎每次都得 7 到 9 分,说明评委也认为这些设计视觉表现好;它们的分丢在信息上。
他这样解读这个差距:这些需求没有一道是他自己的,所以他凭第一印象挑。真正需要这张设计的客户会先看感觉,再看细节,并把错误或编造的文字当成硬伤。这就是排名以评分细则的分数为准、这次盲选只作参考的原因。它也说明了凭第一印象挑图的风险:第一眼抓住你的设计,往往就是加了你没写过的文字的那张。
各模型一句话
- Claude Opus 5.5:字形与材质、吸引力最好,编造行数少(每张 0.22 行)。方案最长、思考最久,需要比 FontVibe 线上更宽的输出上限;速度最慢,价格也远高于其他模型。适合复杂、不赶时间的设计。
- GPT-6 Luna:性价比最高:质量在第一梯队,每次都跑完,可读性高,编造行数少,而且价格最低,差距很大。字形做得好,但不至于让人记住。
- GPT-5.6 Terra:又快又均衡。第 4 层和大多数日常需求表现强,第 3 层最弱,常常用朴素的字体应付难题。
- Gemini 4 Argon:材质是这次测试里最丰富的之一,每张编造 1.56 行。
- Claude Sonnet 5.5:出方案最快,字形强,原样印出占位符的次数最多(5 张)。
- GPT-6.1 Sol:设计最好读,编造行数少,但字形朴素;出方案和写指令都慢,合计约 87 秒。
- Gemini 3.8 Flash:视觉表现强,编造文字最多(每张 2.36 行),也是唯一出现厂商服务错误的模型(8 次)。
- GPT-6.1 Terra:文字最干净,设计最朴素。
这次测试的局限
- 评委运行在 Claude Opus 5.5 上,它同时也是被测模型之一。图片是匿名的,但评委和一位参赛者用的是同一个模型,评委会不会偏向它的设计没有验证。
- 每道题只由一位评委打一轮分,没有重打,也没有第二位评委。
- Claude Opus 5.5 的主分数来自 8 道题上的 18 张设计,大多是较容易的需求。
- 所有设计都由同一个生图模型渲染。换一个生图模型,设计师的指令起多大作用可能会变。
- 每个模型每道需求跑三遍,每次只渲染三个方向里的第一个。只有 12 道题,模型之间的大多数差距小到分不出来;28 组比较没有做多重比较校正。
- 评分标准针对的是带文字的设计。没有测不带文字的图。
- 所有模型都用 FontVibe 的生产提示词和上限。换成别的应用的提示词或上限,占优的可能是别的模型。
- 结果描述的是这些模型版本在 2026 年 10 月 30 日的表现。
每张设计都在 FontVibe 上公开,每个分数都有书面理由。需求、全部方案、生图指令、分数和理由都在开放数据集 AI Design Benchmark(CC BY 4.0)里,附带每一次尝试的记录和能复算本文所有表格的脚本。FontVibe 的生产提示词不公开,研究需要可以发邮件到 hello@fontvibe.ai 索取。
附录:全部分数
每个模型每道题在完成的运行上的平均总分(完成次数少于 3 次时,括号里注明次数)。
| 题目 | GPT-6.1 Terra | GPT-5.6 Terra | GPT-6.1 Sol | GPT-6 Luna | Claude Opus 5.5 | Claude Sonnet 5.5 | Gemini 4 Argon | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|---|---|
| 1. 咖啡烘焙坊字标 | 6.62 | 8.13 | 6.43 | 8.05 | 8.38 | 7.50 | 7.53 | 7.92 |
| 2. 恐龙生日海报 | 8.43 | 8.33 | 8.73 | 8.17 | 8.20 | 7.03 | 6.48 | 7.33 |
| 3. 毕业派对海报 | 6.37 | 7.03 | 7.07 | 7.28 | 7.50(1) | 7.13 | 8.40 | 8.28 |
| 4. YouTube 缩略图 | 7.18 | 7.12 | 7.27 | 7.97 | 6.53 | 8.20 | 7.88 | 7.75 |
| 5. 招聘海报 | 7.20 | 6.98 | 7.30 | 7.43 | 失败 | 7.92 | 7.50 | 6.12 |
| 6. 咖啡杯套 | 7.83 | 8.30 | 7.58 | 7.93 | 8.97(2) | 8.38 | 7.27 | 7.25 |
| 7. 夜店字标 | 5.48 | 5.90 | 6.67 | 7.25 | 7.88 | 7.28 | 8.13 | 8.05 |
| 8. 期刊封面 | 6.22 | 7.47 | 7.65 | 7.43 | 失败 | 6.63 | 7.28 | 6.68 |
| 9. 纹身店招牌 | 7.53 | 7.80(2) | 7.33 | 7.95 | 8.25(2) | 6.78 | 6.37 | 6.38 |
| 10. 刨冰摊招牌 | 8.20 | 8.27 | 7.78 | 7.45 | 8.55(1) | 6.98 | 8.38 | 7.80 |
| 11. 面包店开业招牌 | 6.32 | 7.43 | 6.62 | 7.25 | 失败 | 8.03 | 7.78 | 7.02 |
| 12. 亡灵节请柬 | 7.57 | 8.22 | 7.80 | 8.08 | 失败 | 7.32 | 7.68 | 7.40 |
全部两两比较
每一组只在两个模型都有完成设计的题上比较:逐题分数差的平均(前一个模型减后一个),附 95% 置信区间。区间包含 0,就是这次测试里分不出高下。
| 模型 | 对比模型 | 题数 | 差值(95% CI) | 明显更高的一方 |
|---|---|---|---|---|
| Claude Opus 5.5 | GPT-6 Luna | 8 | +0.28(−0.27 到 +0.73) | 打平 |
| Claude Opus 5.5 | GPT-5.6 Terra | 8 | +0.42(0.00 到 +0.96) | 打平 |
| Claude Opus 5.5 | Gemini 4 Argon | 8 | +0.48(−0.33 到 +1.29) | 打平 |
| Claude Opus 5.5 | Claude Sonnet 5.5 | 8 | +0.62(−0.11 到 +1.18) | 打平 |
| Claude Opus 5.5 | GPT-6.1 Sol | 8 | +0.68(+0.10 到 +1.27) | Claude Opus 5.5 |
| Claude Opus 5.5 | Gemini 3.8 Flash | 8 | +0.44(−0.27 到 +1.15) | 打平 |
| Claude Opus 5.5 | GPT-6.1 Terra | 8 | +0.83(+0.20 到 +1.47) | Claude Opus 5.5 |
| GPT-6 Luna | GPT-5.6 Terra | 12 | +0.11(−0.19 到 +0.43) | 打平 |
| GPT-6 Luna | Gemini 4 Argon | 12 | +0.13(−0.35 到 +0.62) | 打平 |
| GPT-6 Luna | Claude Sonnet 5.5 | 12 | +0.25(−0.10 到 +0.60) | 打平 |
| GPT-6 Luna | GPT-6.1 Sol | 12 | +0.33(+0.03 到 +0.66) | GPT-6 Luna |
| GPT-6 Luna | Gemini 3.8 Flash | 12 | +0.36(−0.08 到 +0.77) | 打平 |
| GPT-6 Luna | GPT-6.1 Terra | 12 | +0.61(+0.21 到 +0.98) | GPT-6 Luna |
| GPT-5.6 Terra | Gemini 4 Argon | 12 | +0.02(−0.63 到 +0.64) | 打平 |
| GPT-5.6 Terra | Claude Sonnet 5.5 | 12 | +0.15(−0.39 到 +0.68) | 打平 |
| GPT-5.6 Terra | GPT-6.1 Sol | 12 | +0.23(−0.12 到 +0.63) | 打平 |
| GPT-5.6 Terra | Gemini 3.8 Flash | 12 | +0.25(−0.38 到 +0.78) | 打平 |
| GPT-5.6 Terra | GPT-6.1 Terra | 12 | +0.50(+0.21 到 +0.81) | GPT-5.6 Terra |
| Gemini 4 Argon | Claude Sonnet 5.5 | 12 | +0.13(−0.28 到 +0.55) | 打平 |
| Gemini 4 Argon | GPT-6.1 Sol | 12 | +0.21(−0.42 到 +0.76) | 打平 |
| Gemini 4 Argon | Gemini 3.8 Flash | 12 | +0.23(−0.08 到 +0.53) | 打平 |
| Gemini 4 Argon | GPT-6.1 Terra | 12 | +0.48(−0.25 到 +1.16) | 打平 |
| Claude Sonnet 5.5 | GPT-6.1 Sol | 12 | +0.08(−0.47 到 +0.60) | 打平 |
| Claude Sonnet 5.5 | Gemini 3.8 Flash | 12 | +0.10(−0.35 到 +0.61) | 打平 |
| Claude Sonnet 5.5 | GPT-6.1 Terra | 12 | +0.35(−0.24 到 +0.91) | 打平 |
| GPT-6.1 Sol | Gemini 3.8 Flash | 12 | +0.02(−0.55 到 +0.57) | 打平 |
| GPT-6.1 Sol | GPT-6.1 Terra | 12 | +0.27(−0.02 到 +0.60) | 打平 |
| Gemini 3.8 Flash | GPT-6.1 Terra | 12 | +0.25(−0.40 到 +0.96) | 打平 |
评分标准
评委指令摘要:你是写这份需求、要用这张设计的客户。按这个顺序判断:是不是你要的东西;每一段文字能不能原样使用;有没有你想要的感觉,无论是明说的还是可以合理推断的;字形、材质、纹理、线条和颜色做得好不好;第一眼能不能打动人。四个分数各管各的问题,一个问题只在它所属的那一项里扣一次。
常见问题
GPT-6.1 Terra 做设计比 GPT-5.6 Terra 强吗?
这次测试里不是。逐题比较,GPT-6.1 Terra 比 GPT-5.6 Terra 低 0.50 分(满分 10),95% 置信区间 −0.81 到 −0.21,12 道题里有 9 道更低。它的文字更干净,但字形更平、吸引力更低。两个模型用的是同一套提示词和设置;这个结果只说明它在「读需求、定方向、写生图指令」这件事上的表现,不代表它在其他任务上的能力。
哪个语言模型最适合当设计师?
只看设计质量,这次测试里八个模型大多分不出高下,只有 GPT-6.1 Terra 和 GPT-6.1 Sol 明显落后。Claude Opus 5.5 平均分最高,但并不明显高于 GPT-6 Luna 和 Gemini 4 Argon,而且贵得多、慢得多。GPT-6 Luna 在质量第一梯队、每次都跑完、每张只要 $0.005,性价比远超其他。要实时出方案,GPT-5.6 Terra 又快又均衡。
AI 设计师会编造文字吗?
会。Gemini 3.8 Flash 每张设计平均多加 2.36 行需求里从没给过的文字,比如创立年份、标语和虚假的统计数字。GPT-6.1 Terra 加得最少,每张 0.17 行。编造文字是设计在信息项上丢分最常见的原因。
AI 设计师做一张设计要花多少钱?
按各厂商 2026 年 10 月 30 日的公开价格,一张设计里语言模型部分的成本中位数是:GPT-6 Luna $0.005,GPT-6.1 Terra 或 Gemini 3.8 Flash $0.04,GPT-5.6 Terra 或 GPT-6.1 Sol $0.09,Gemini 4 Argon $0.11,Claude Sonnet 5.5 $0.18,Claude Opus 5.5 $0.41。不含生图费用。
我能自己试试这些 AI 设计师吗?
FontVibe 的设计模式用的就是这次测试的同一套流程。你描述需求,它提出几个设计方向,再把你选的那个渲染出来。
评论