Qwen-Image 3.0 实测:五大生图模型横评
10 道海报、日程表、茶叶标签、Logo 设计题,千问 Qwen-Image 3.0 对比 GPT、Nano Banana、Seedream、Grok。
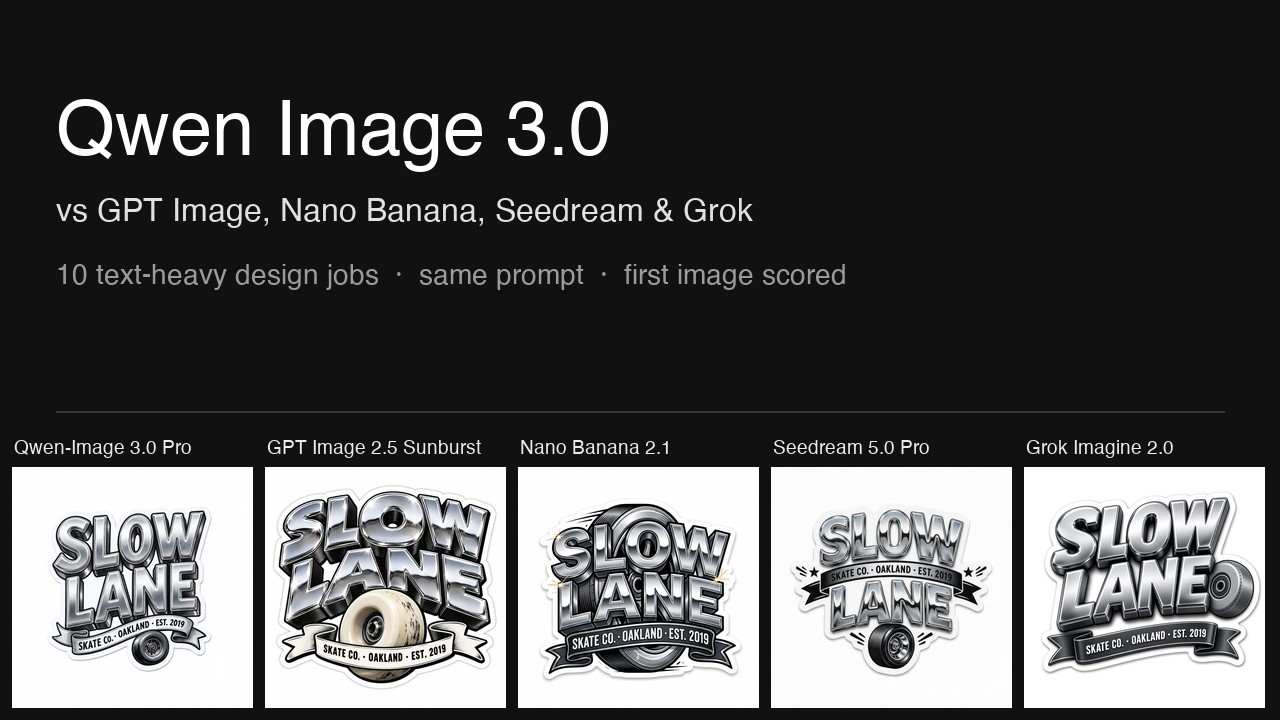
Qwen-Image 3.0 Pro 是阿里巴巴的生图模型(也就是「千问」的生图模型)。官方宣传它能精准渲染小到 10 像素的文字、原生支持 12 种语言、擅长高密度信息版式。我拿它和另外四个生图模型做了一次对比:10 道带字的设计题,包括请柬、贴纸、海报、会议日程表、中英文茶叶罐标签、竖排日文海报、Logo、实景照片、改图和双参考图。每个模型拿到的提示词一字不差,每组只取第一张图打分。
参测的 5 个模型,分辨率统一 2K:
- Qwen-Image 3.0 Pro(阿里巴巴)。 只有 1K 和 2K 两档分辨率,没有质量档。它自带的提示词改写功能是关着的,和另外四家一样拿到原样的提示词。
- GPT Image 2.5 Sunburst(OpenAI),High 档。 GPT Image 2.5 有 Low、Medium、High、Extra High、Max 五个质量档。这次测的是 High,也就是 FontVibe 上的默认档;Extra High 和 Max 没有测。
- Nano Banana 2.1(Google)。 没有质量档可选。
- Seedream 5.0 Pro(字节跳动)。 没有质量档可选。
- Grok Imagine 2.0(xAI),Medium 档。 Medium 是 Grok Imagine 2.0 的最高档。我的 Grok Imagine 2.0 实测比过它的 Low 和 Medium 两档,Medium 分数更高。
结果
| 模型(档位) | 可读性 | 字形与质感 | 信息与构图 | 吸引力 | 总分 | 出图耗时中位数 | FontVibe 积分 |
|---|---|---|---|---|---|---|---|
| Grok Imagine 2.0(Medium) | 9.9 | 8.8 | 8.9 | 8.6 | 9.01 | 95 秒 | 40 |
| GPT Image 2.5 Sunburst(High) | 9.4 | 9.0 | 8.7 | 8.9 | 8.99 | 41 秒 | 40 |
| Nano Banana 2.1 | 9.7 | 8.8 | 8.3 | 8.3 | 8.76 | 28 秒 | 25 |
| Seedream 5.0 Pro | 10.0 | 8.7 | 8.0 | 8.5 | 8.75 | 73 秒 | 40 |
| Qwen-Image 3.0 Pro | 10.0 | 8.8 | 7.7 | 7.8 | 8.57 | 23 秒 | 40 |
满分 10 分,取 10 道题第一张图的平均分。耗时是第 1–8 题和第 10 题新出的图(每题两张)在 2K 下的中位数:每个模型 18 张,Seedream 5.0 Pro 因为第 10 题里的失败只有 17 张。积分是在 FontVibe 上出一张 2K 图的价格。每张图的具体分数见文末附录。另做的一轮隐去模型名的盲评里,最后一名同样是 Qwen-Image 3.0 Pro,第一名是 GPT Image 2.5。
Grok Imagine 2.0 Medium 总分最高,9.01 分。GPT Image 2.5 Sunburst 8.99 分,低 0.02。Nano Banana 2.1 8.76 分,Seedream 5.0 Pro 8.75 分,两者差 0.01。Qwen-Image 3.0 Pro 总分最低,8.57 分,比 Seedream 5.0 Pro 低 0.18。五个模型的平均分最多相差 0.44 分。某一题改动 1 分,平均分就会变动 0.02 到 0.035,所以第一、二名的先后,以及第三、四名的先后,都取决于单个分数。
Qwen-Image 3.0 Pro 和 Seedream 5.0 Pro 的可读性并列最高,10.0 分:两家参评的每张图,主标题都一眼能读出来。Qwen-Image 3.0 Pro 的「信息与构图」7.7 分、吸引力 7.8 分,两项都是五家最低。它有 3 张参评图把提示词要求的文字改了或写错了;第 5 题要的是标签,它却画了一个茶叶罐;日程表的版式也是同题里最朴素的。它没有一道题拿到最高分。
需要说明:GPT Image 2.5 测的是 High 档,是它五个档位里的第三档;另外四家测的都是各自的最高档。GPT Image 2.5 开到 Extra High 或 Max 会得多少分,这次测试回答不了。
文字准确度
50 张参评图里,47 张把要求的每一行字都写对了。没写对的 3 张都是 Qwen-Image 3.0 Pro:
- 第 1 题:「Mia's」被写成了「MiA'S」,名字中间冒出了大写字母。
- 第 4 题:页脚网址「formfunction.design」被写成了「formfunction.deign」。
- 第 9 题:改图时要求「18+」保持不变,结果被改成了「$Z+」。
其他模型参评图里的小问题:
- GPT Image 2.5,第 8 题:自己加了一块列着五种菜品的黑板(提示词没要求),黑板上有一行是看不懂的乱码;提示词要的那块菜单牌上,中间点「·」被画成了一条波浪线。
- Nano Banana 2.1,第 8 题:菜单牌上的「·」位置错了。
- 提示词没要求的文字:Seedream 5.0 Pro 第 4 题加了「ONE-DAY DESIGN CONFERENCE」;Nano Banana 2.1 第 10 题加了「WEEKEND ART EVENT」;Grok Imagine 2.0 第 10 题把「OPEN STUDIO」重复写了一遍;Qwen-Image 3.0 Pro 第 10 题从参考图里照抄了「NEON OUTLINE」。
- 第 5 题要求「不要其他文字」,GPT Image 2.5 和 Nano Banana 2.1 都在茶叶罐标签上加了一枚带字的红色小印章。
千问官方的三条宣传,逐条核对
宣传一:小到 10 像素的文字也能精准渲染。 部分属实。第 4 题要求 10 行日程文字,Qwen-Image 3.0 Pro 那张图 10 行字全部清晰可读,可读性 10 分。但页脚网址少了一个字母(「formfunction.deign」),而且同样的错在它 4 张日程表里出现了 3 张(1K 两张都错、2K 第一张错)。另外四家的 8 张日程表,网址全部写对。
宣传二:12 种语言原生渲染。 测到的两种语言属实。第 5 题里,Qwen-Image 3.0 Pro 把四行中英文全部写对,用的是简体,「二〇二七年春」里的「〇」也对。第 6 题里,它把三行日文全部竖排、全部写对。另外 10 种语言这次没有测。
宣传三:擅长高密度信息版式。 这次测试不支持这一条。Qwen-Image 3.0 Pro 第 4 题的日程表只得了 7.4 分,是这道题的最低分:白底黑字、没有分组,页面下方空了一大块。它的「信息与构图」平均 7.7 分,五家最低。
测试方法
10 道题如下。第 1 题和第 3 题与我的 Grok Imagine 2.0 实测、更早的 7 款 AI 设计工具横评用的是同一批提示词,另外 8 题是新写的。
- 儿童生日请柬(3:4):亮面气球字,外加三行信息
- 滑板店贴纸(1:1):厚重的镀铬立体字,一条飘带副标题,白底
- 乐队演出海报(2:3):熔岩火焰字,外加四行信息
- 会议日程表(3:4):8 个时段,含长破折号、斜杠和网址
- 茶叶罐标签(3:4):中文毛笔书法加一行英文
- 日文书店海报(2:3):所有文字竖排
- 户外品牌徽章(1:1):「FW」组合字母加小号大写的全称
- 海边餐车实景照片(3:2):车身手绘字和一块菜单牌
- 修改现有图片(2:3):改一个日期和一个价格,其他保持不变
- 双参考图出新图(3:4):版式参考图 1,字效参考图 2
这次只测带文字的设计图,人像、风景等不带字的图没有测。每道题的完整提示词附在下面各题小节里。测试规则:
- 每个模型拿到的提示词一字不差,走 FontVibe 的 DIY 模式,提示词原样发给模型,不改写、不套风格预设。
- 画幅比例用参数锁定,每个模型都一样。
- 每个模型每题出两张,只有第一张参与打分和展示;第二张只用来核对拼写是否稳定。第一张出图失败的,重试一次,以第一张成功的图打分。
- 所有图都在 2026 年 10 月 21 日生成,在 FontVibe 上公开可查。
评分标准
评分用的是 FontVibe 内部给生成作品打分的标准,2026 年 10 月在这次测试之前定稿,和 Grok Imagine 2.0 实测用的是同一套。每张图打四个分,每项 1–10 分,每次扣分我都先写下理由再给分。
| 打分项 | 权重 | 看什么 |
|---|---|---|
| 可读性 | 20% | 先查硬伤:乱码字、文字被裁掉、文字被其他元素挡住、字形残缺。没有硬伤给 7–10 分,看主标题读起来有多轻松;有任何一项硬伤给 1–4 分。 |
| 字形与质感 | 35% | 提示词要求的字效(气球、镀铬、火焰、毛笔、霓虹)有没有做出来,做得精不精。 |
| 信息与构图 | 25% | 先看交付的是不是提示词要的东西、信息是否完整准确:提示词里的每一行都在,拼写和标点与原文一致,也没有多出提示词没要求的东西。每缺、改、多一行或一个符号,至少扣 1 分。再看最重要的信息是不是最先被读到、各行顺序对不对。 |
| 吸引力 | 20% | 看起来像不像专业设计师做的。 |
总分由公式算出,不靠主观判断:0.20 × 可读性 + 0.35 × 字形与质感 + 0.25 × 信息与构图 + 0.20 × 吸引力。
有四处具体口径要说明:可读性按标准只看主标题,次要信息太小或太淡、不好读的,记在「信息与构图」里;整行统一改成全大写(比如「WITH SPECIAL GUESTS」)不算改动,单词中间随机冒出大写字母(比如「MiA'S」)算改了原文;招牌、黑板这类观众会去读的东西上出现乱码,算硬伤,和 Grok 实测同一口径,而背景里在原图分辨率下本来就看不清的小标签不算;提示词要的是设计稿(比如标签、印刷用的日程表),图里却画成了一件被拍摄的实物,「信息与构图」扣 3 分,因为这样的结果没法直接拿去印。
打分时我知道每张图出自哪个模型。为了检验这有没有带来偏差,我另做了一轮隐去模型名的盲评。
第 9、10 题要用到现成的图。这三张图都取自 FontVibe 的公开作品库,都不是这次参测的 5 个模型生成的,而是 Seedream 5.0 出的,它是 Seedream 5.0 Pro 的上一代、同一个模型家族。
逐题结果
第 1 题:儿童生日请柬
Birthday party invitation for my daughter, "Mia's 7th Birthday" in glossy balloon letters, "Saturday, Nov 14 · 2 PM", "Sunny Park Pavilion", "RSVP by Nov 7", bright and playful, portrait card
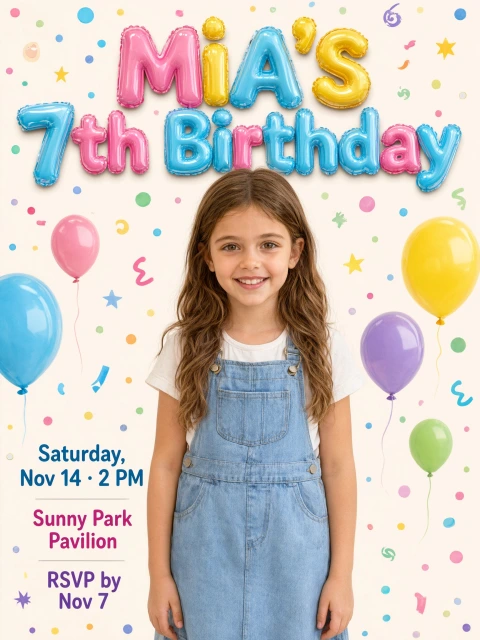
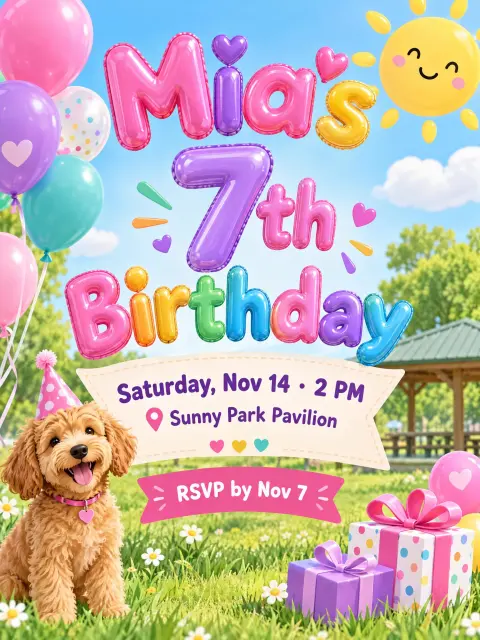
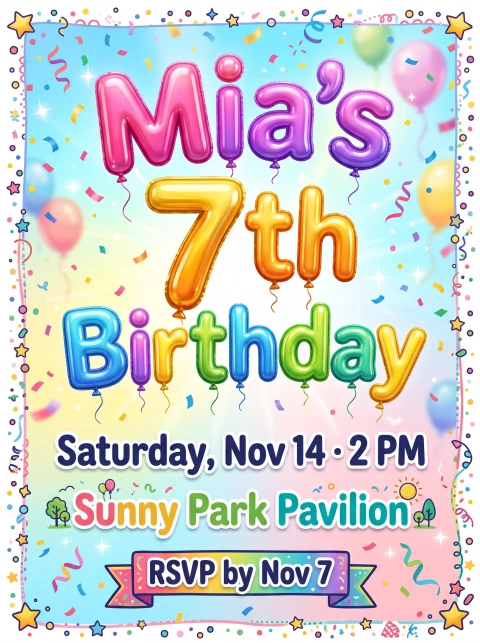
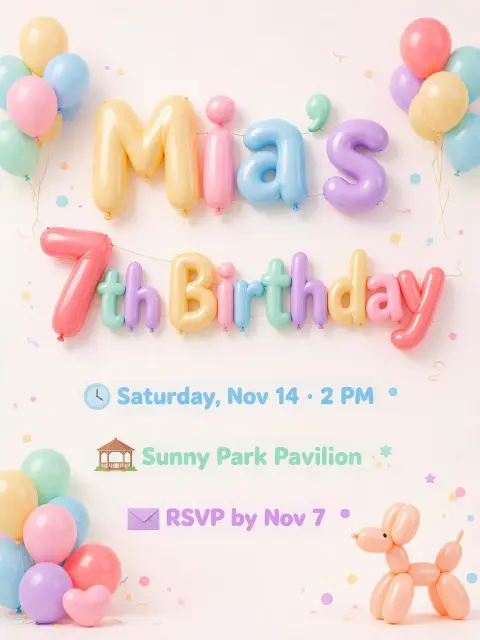
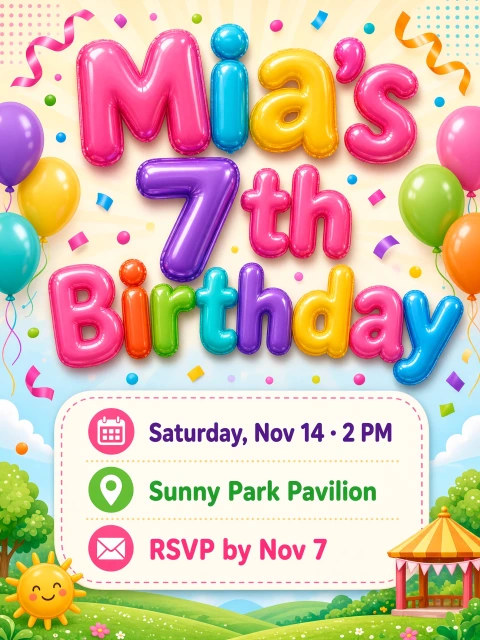
GPT Image 2.5 和 Grok Imagine 2.0 并列最高,9.2 分。两家都把三行信息分组得很清楚:GPT Image 2.5 用一条飘带,Grok 用带图标的卡片。Qwen-Image 3.0 Pro 得分最低,8.3 分:名字被写成了「MiA'S」,而且画面正中放了一张小女孩的照片,三行信息被挤到左侧窄窄的一栏里。Seedream 5.0 Pro 的三行信息是浅色字压在浅色底上,在「信息与构图」扣了 1 分。想直接用气球字效果,可以看泡泡字风格。
第 2 题:滑板店贴纸
Die-cut sticker for my skate shop, "SLOW LANE" in chunky chrome 3D lettering, small "SKATE CO. · OAKLAND · EST. 2019" on a ribbon banner underneath, a skateboard wheel graphic, thick white sticker border, isolated on plain white
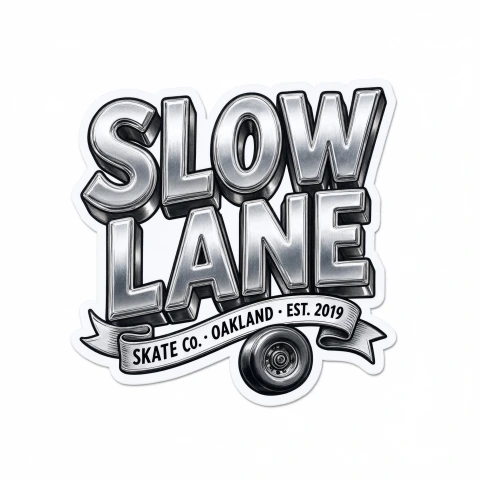
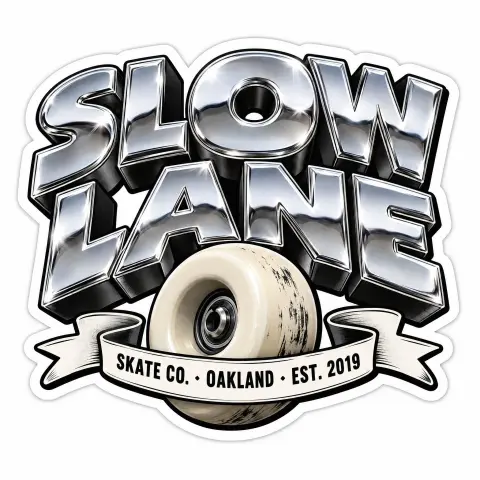
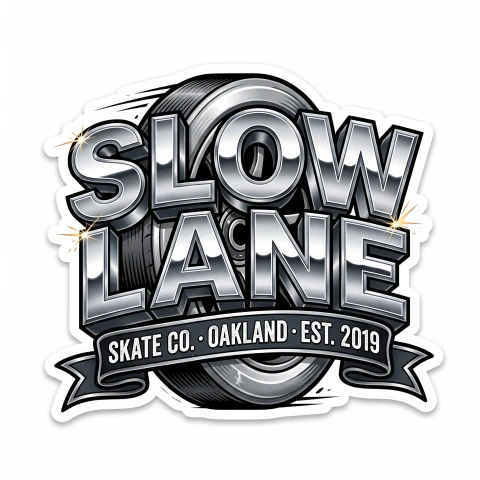
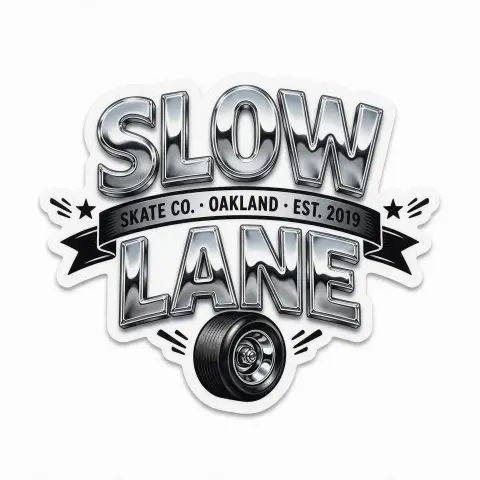
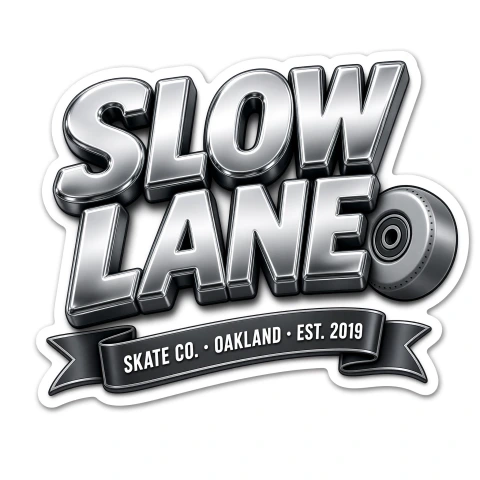
五个模型两行字都写对了。GPT Image 2.5 和 Nano Banana 2.1 并列最高,9.2 分:GPT Image 2.5 的镀铬字最有体积感,Nano Banana 2.1 在字后面垫了一个大轮子。Qwen-Image 3.0 Pro 和 Grok Imagine 2.0 都是 9.0 分。Seedream 5.0 Pro 得分最低,8.15 分,因为它把飘带插在了「SLOW」和「LANE」中间,而提示词要求放在下方。想直接用镀铬字效果,可以看金属字风格。
第 3 题:乐队演出海报
A3 gig poster for my band "BURNING ORCHARD", band name in molten fire lettering as the main focus, "with special guests THE LOW TIDES", "SAT 14 NOV · DOORS 8 PM", "THE CELLAR · 22 MILL STREET", "TICKETS £12 ON THE DOOR", gritty rock atmosphere with burning trees
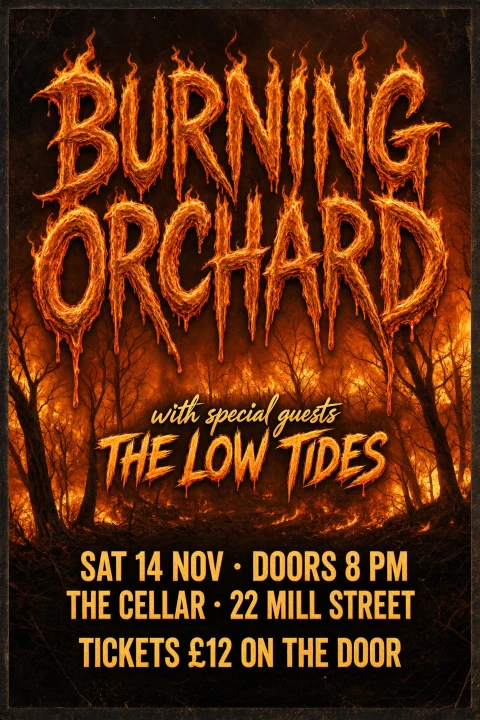
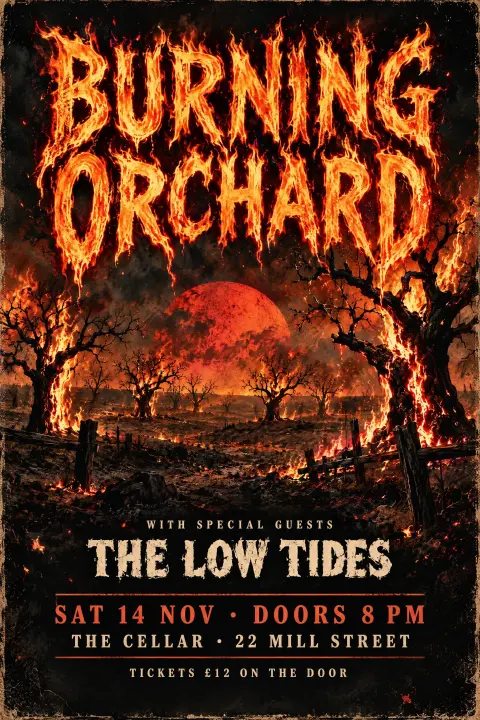
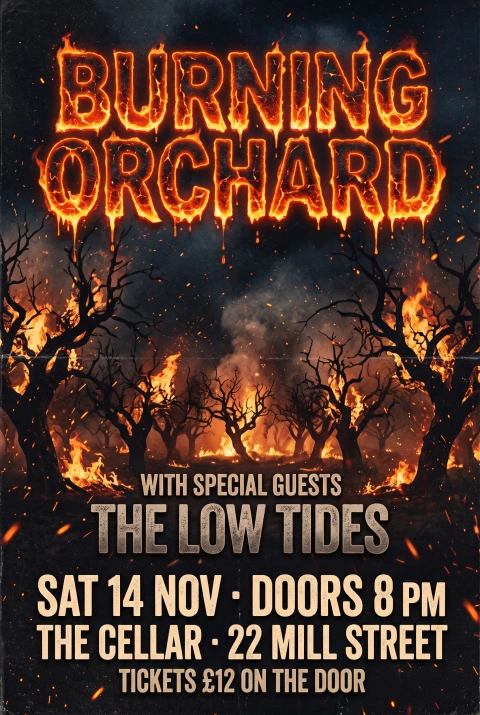
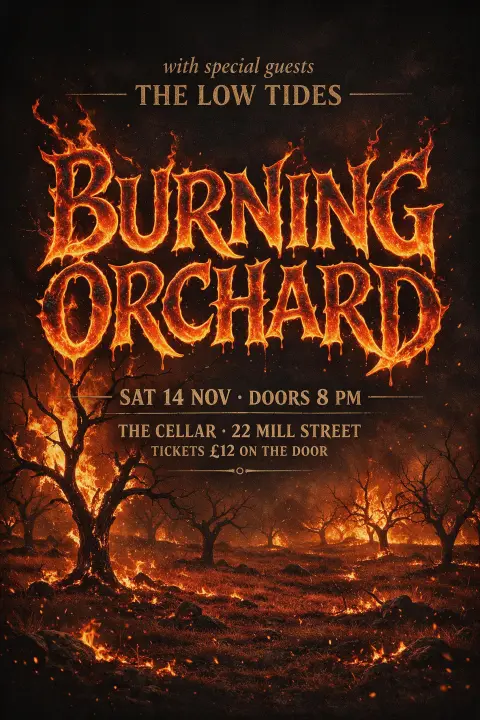
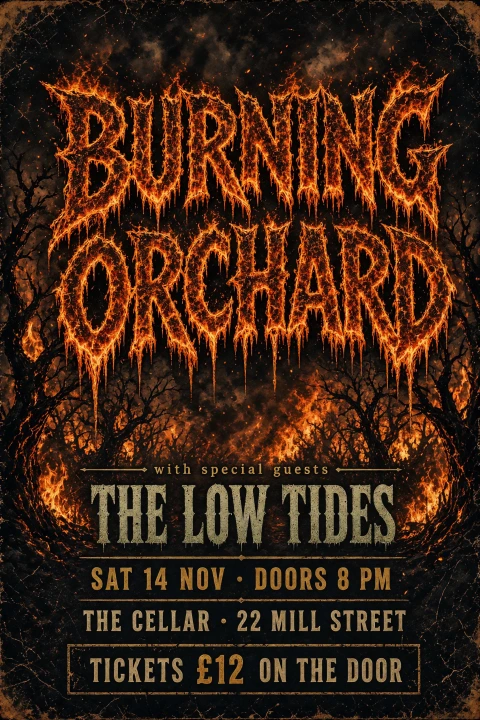
GPT Image 2.5 得分最高,9.2 分:可读性 10,另外三项都是 9,燃烧的果园上方还有一轮血红的月亮。Qwen-Image 3.0 Pro、Nano Banana 2.1 和 Grok Imagine 2.0 都是 9.0 分:Qwen 和 Nano Banana 2.1 的吸引力是 8,Grok 的可读性是 9。Qwen 用手写体排暖场乐队,和主乐队拉开了层级。Grok 的火焰纹理是五家里最重的,标题要多看一眼。Seedream 5.0 Pro 得 8.5 分,因为它把暖场乐队放到了主乐队上方,和它在 Grok Imagine 2.0 实测里用同一提示词犯的是同一个主次颠倒的错。想直接用火焰字效果,可以看火焰字风格。
第 4 题:会议日程表
Printed schedule for a one-day design conference, title "FORM & FUNCTION 2027" in bold geometric lettering, then this exact list, one line each: "09:00 Registration & Coffee", "09:30 Opening Keynote — Ada Moreno", "10:15 Type in Motion", "11:00 Panel: Designing for Screens", "12:30 Lunch Break", "13:30 Workshop A / Workshop B", "15:00 Color Systems at Scale", "16:00 Closing Talk — Ken Ito", and a small footer "Hall 3 · Riverside Center · formfunction.design"
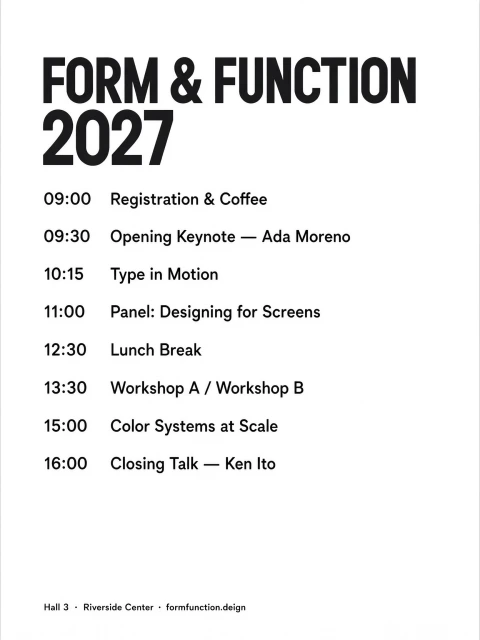
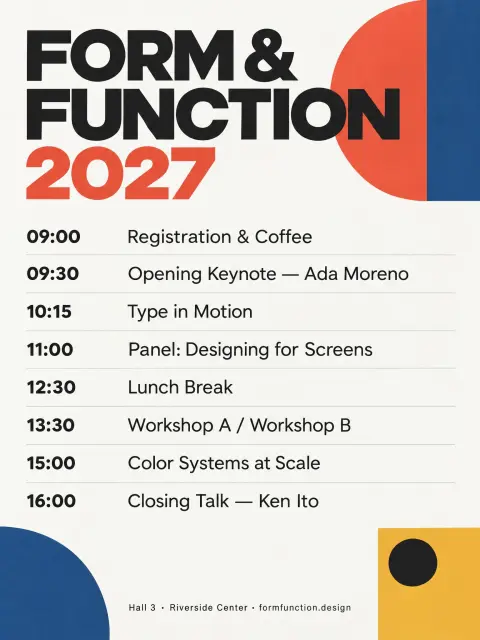
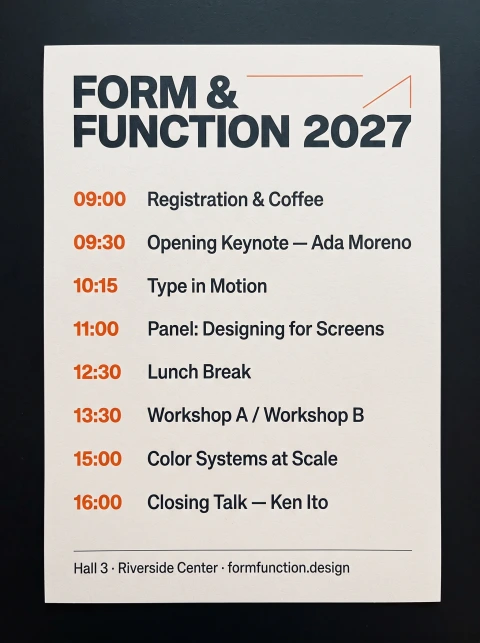
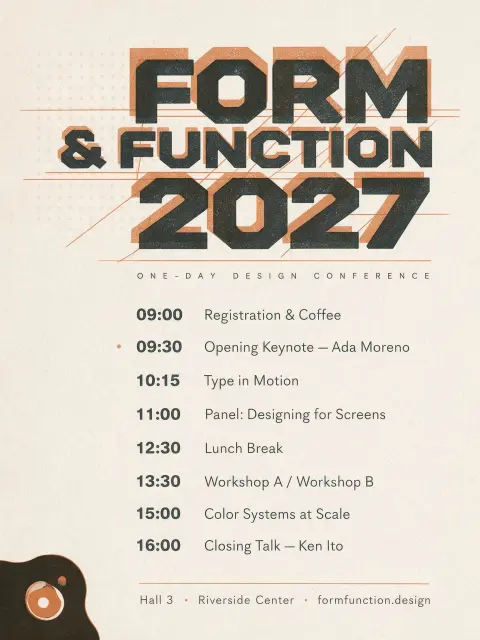
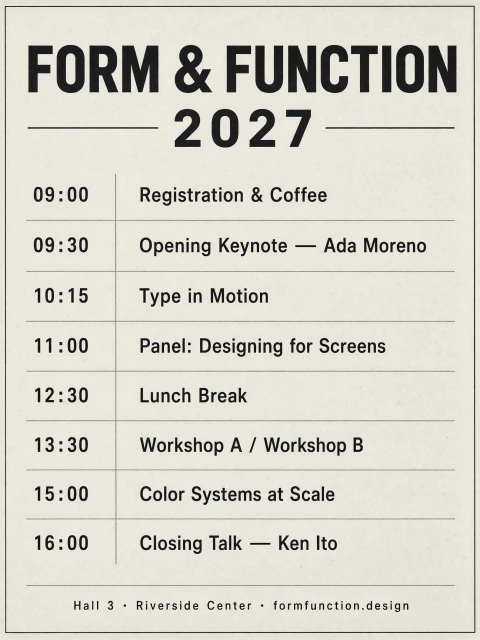
GPT Image 2.5 得分最高,9.2 分:包豪斯风格的标题和色块,每个时段之间都有分隔线。五个模型的参评图里,8 个时段、长破折号和斜杠全部写对。Nano Banana 2.1 的字最大最清楚,但它交的是一张「印好的卡片放在深色桌面上」的照片,而不是日程表本身,得 7.9 分。Qwen-Image 3.0 Pro 和 Grok Imagine 2.0 的标题都是窄体黑体,不是提示词要的几何字,Grok 得 8.3 分。Qwen-Image 3.0 Pro 还把页脚网址写成了「formfunction.deign」,得 7.4 分,是这道题的最低分:整页白底黑字,没有分组,下方空了一大块。Seedream 5.0 Pro 自己加了一行提示词里没有的副标题「ONE-DAY DESIGN CONFERENCE」。另外,GPT Image 2.5 没参评的第二张图里,「Panel: Designing for Screens」这一整行漏掉了,只剩下「11:00」。
第 5 题:茶叶罐标签
Front label for a tea tin, brand name "山间茶事" in elegant brush-and-ink calligraphy, English line "MOUNTAIN TEA HOUSE", product line "明前龙井 · 二〇二七年春", net weight "净含量 100 克", misty green mountains, no other text
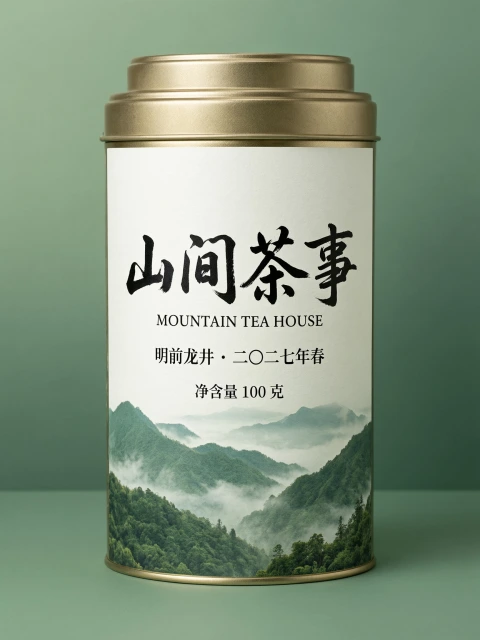
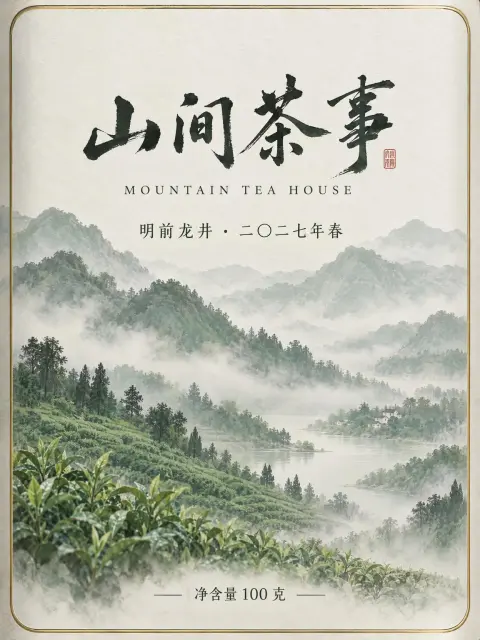
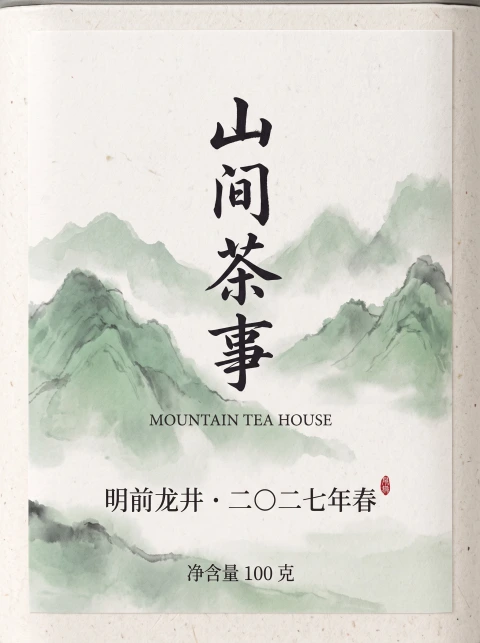
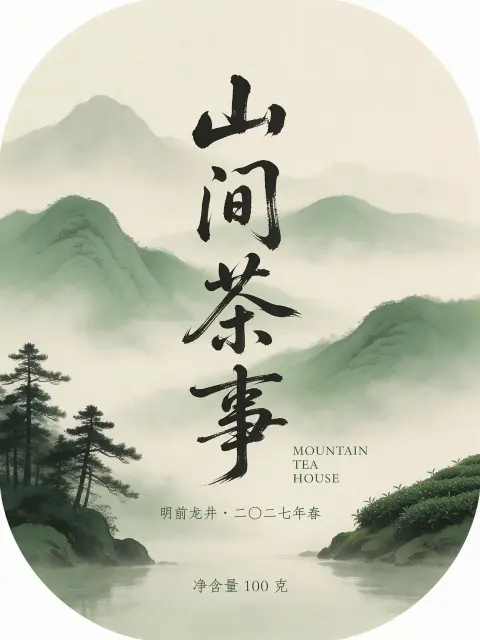
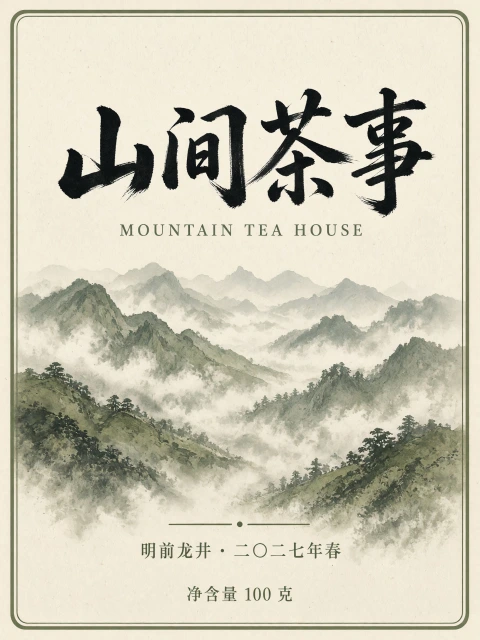
五个模型都把四行字用简体写对了,包括「龙」(不是繁体的「龍」)和「〇」。提示词要的是标签,四个模型交的都是平面标签;Qwen-Image 3.0 Pro 却画了一整个贴着标签的茶叶罐照片,没法当标签拿去印,得 8.45 分,是本题最低。Grok Imagine 2.0 得分最高,9.2 分:平面标签,该有的四行都在,也没有多加任何东西。GPT Image 2.5 和 Nano Banana 2.1 都加了一枚带字的红色小印章,违反了提示词里的「no other text」,两家都是 8.95 分。想直接用毛笔字效果,可以看中国水墨毛笔风格。
第 6 题:日文书店海报
Poster for a bookstore's autumn reading week, headline "秋の読書週間" set vertically in elegant Mincho lettering, sub-line "十月二十七日〜十一月九日", and "全品ポイント二倍", warm maple leaves, all Japanese text written vertically, no other text
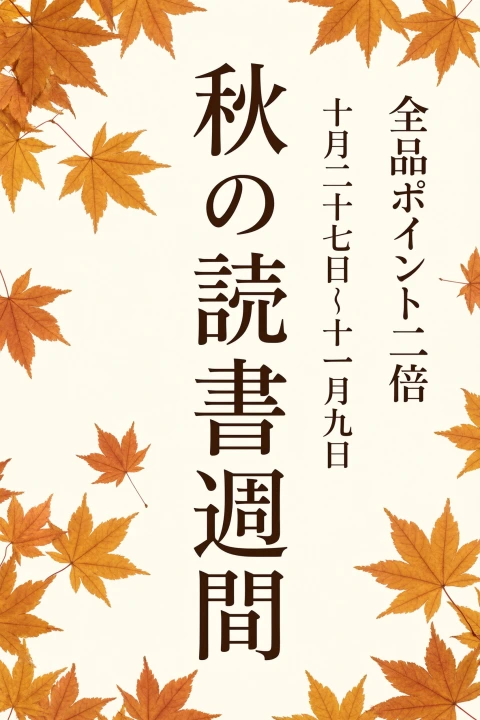
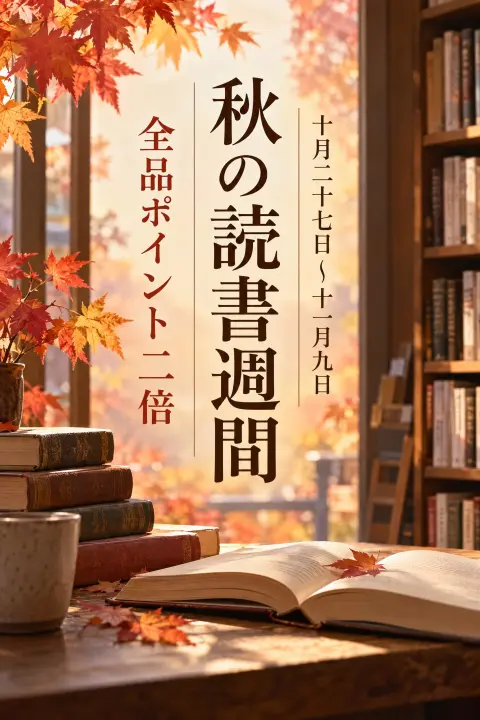
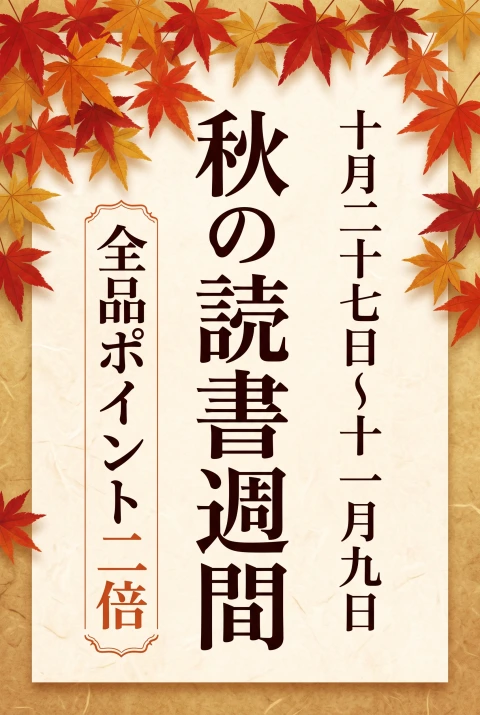
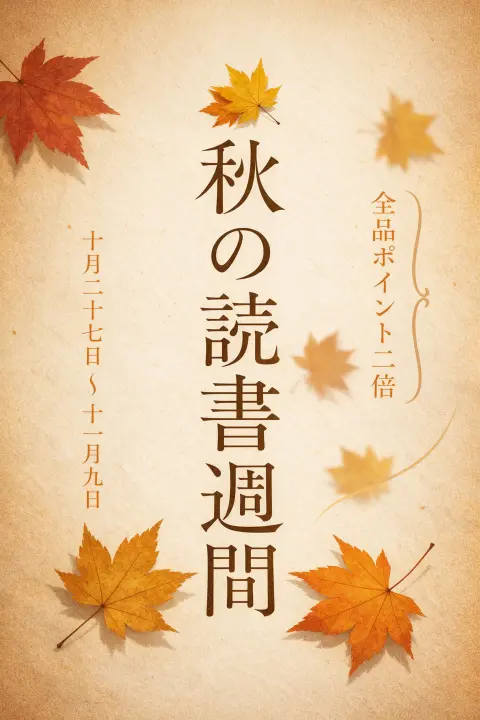

五个模型都把三行字全部竖排,而且全部写对,用的也都是提示词要求的明朝体。GPT Image 2.5 得分最高,9.2 分:书店实景,积分活动放在一条红色竖条上。Qwen-Image 3.0 Pro、Nano Banana 2.1 和 Grok Imagine 2.0 都是 9.0 分。Seedream 5.0 Pro 得 8.95 分:日期那一列颜色浅、笔画细。
第 7 题:户外品牌徽章
Badge logo for a hiking outfitter called "Fernwood Outfitters", an interlocking "FW" monogram with a fern leaf in the center, the full name in clean small caps around the badge, flat vector look, two colors, on plain white, no other text
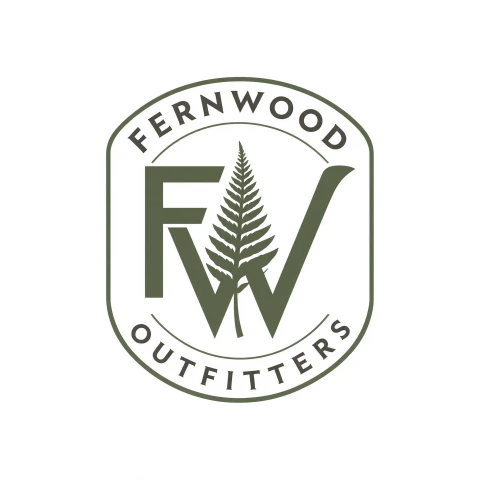
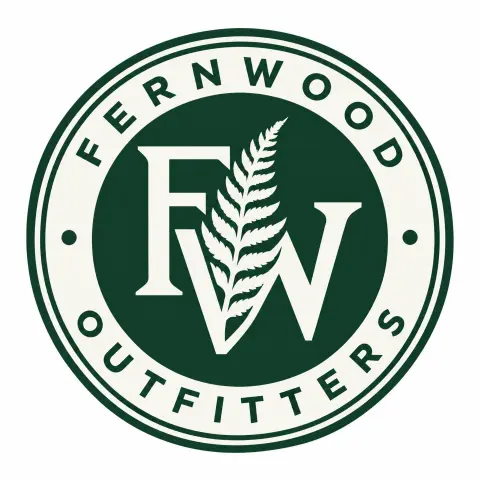
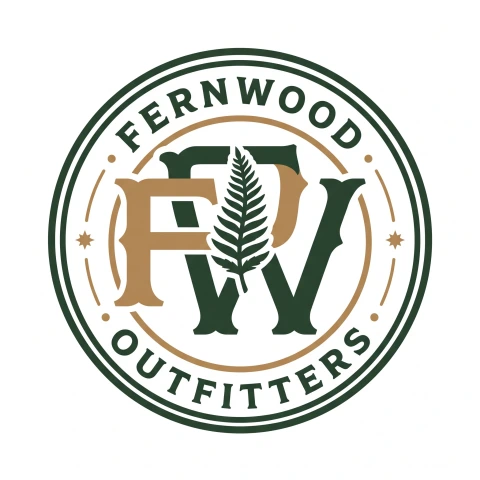
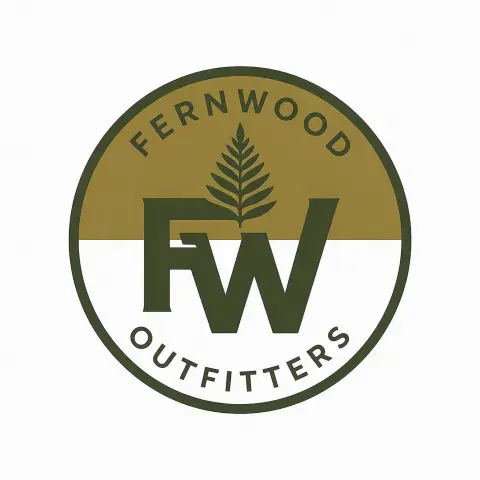
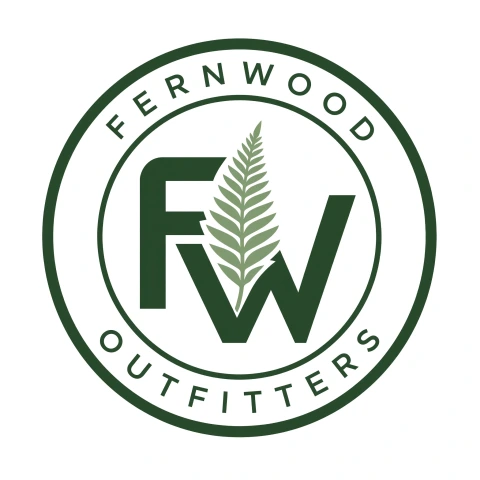
GPT Image 2.5 和 Grok Imagine 2.0 并列最高,9.2 分。Qwen-Image 3.0 Pro 得 9.0 分,蕨叶从组合字母中间穿过。Nano Banana 2.1 得分最低,8.05 分:它的组合字母多出一个字碗,乍看像「FPW」。Seedream 5.0 Pro 得 8.3 分:F 和 W 只是并排、没有交叉,蕨叶在字母上方而不是中间。另外,Qwen 没参评的第二张图里,品牌全称在徽章上下各写了一遍。
第 8 题:海边餐车实景照片
Realistic photo of a vintage food truck parked by the beach at noon, hand-painted lettering on its side reads "SALT & LIME TACOS", a menu board next to it reads "3 TACOS $9 · HORCHATA $4", bright sunlight, shot on a 50mm lens
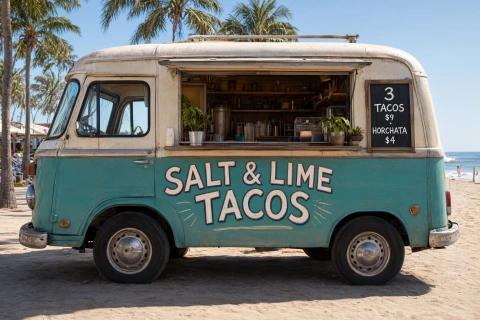
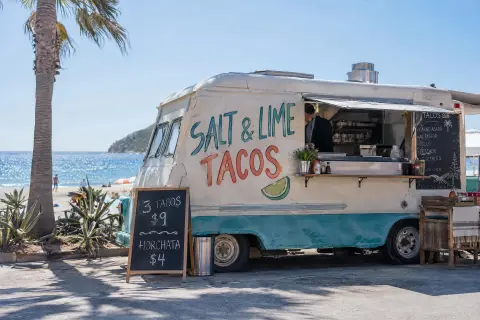
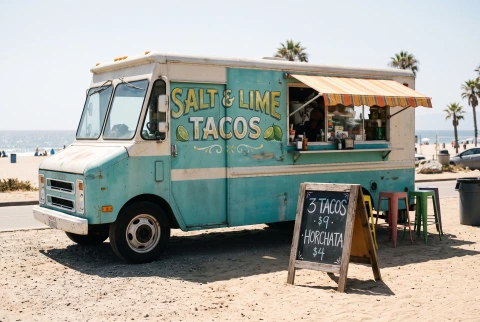
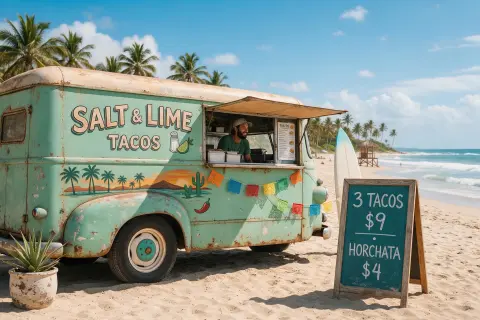
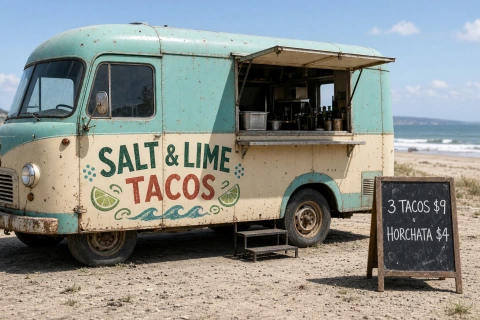
五个模型都把要求的两行字写对了。Seedream 5.0 Pro 和 Grok Imagine 2.0 并列最高,9.2 分,菜单牌按提示词要求立在车旁边。GPT Image 2.5 得分最低,7.5 分:它在出餐窗口旁另加了一块列着五种菜品的黑板,黑板上有一行是乱码,按评分标准算硬伤,可读性 4 分;提示词要的那块菜单牌上,「·」也被画成了一条波浪线。Qwen-Image 3.0 Pro 把菜单牌挂在了车身上,而不是放在车旁边,得 8.75 分。
第 9 题:修改现有图片
Change the date to "FRIDAY • NOVEMBER 13 • 2026" and the price to "$20", and keep everything else exactly as it is
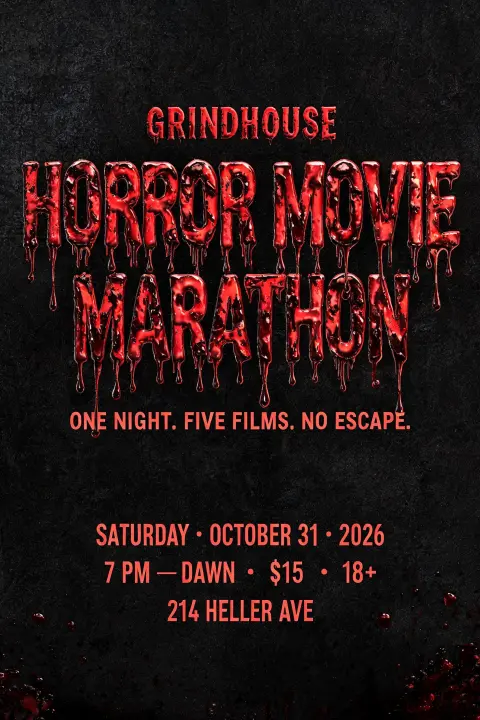
原图有六行字。提示词要求改其中两处:日期和价格。其余四行和「18+」都要保持不变。
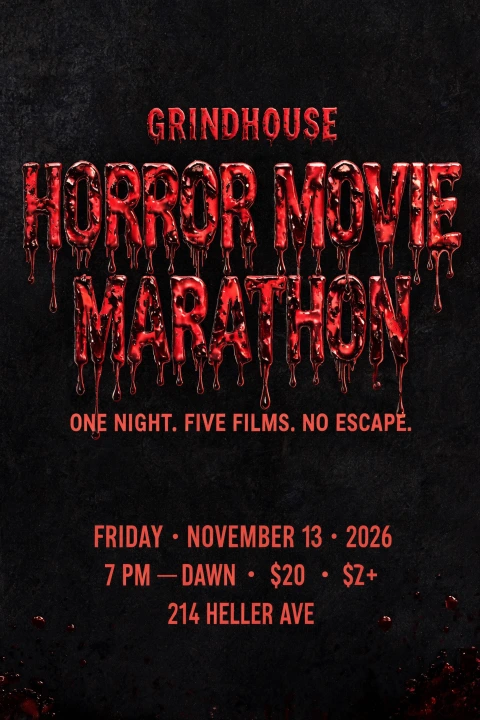
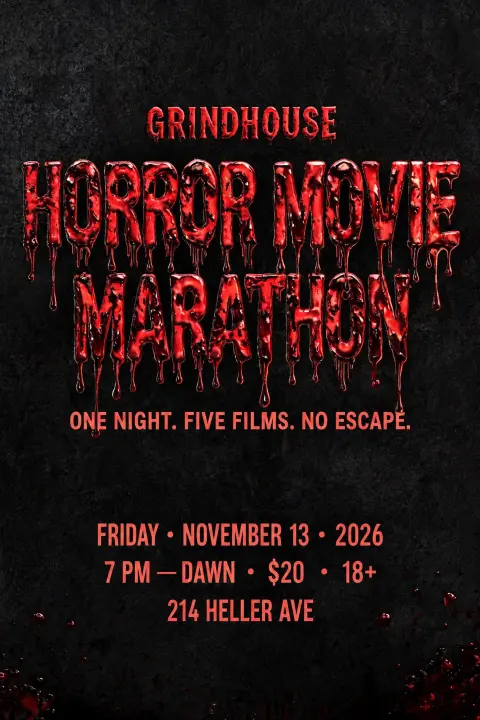
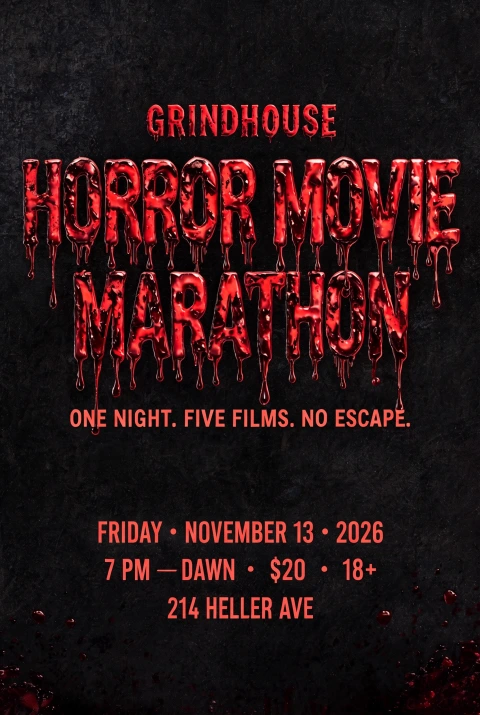
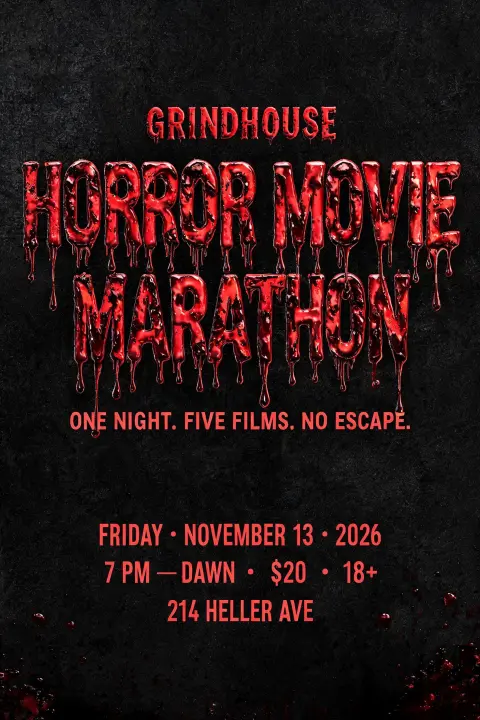
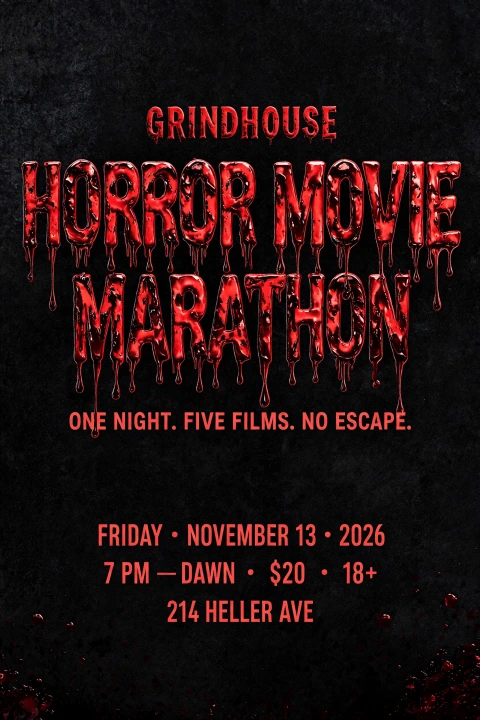
有四个模型日期和价格都改对了,其余部分也没动,都得 9.0 分。Qwen-Image 3.0 Pro 日期和价格改对了,但顺手把「18+」改成了「$Z+」,得 8.5 分。它的第二张图「18+」是对的。
评分标准不衡量图片其余部分有没有保持原样,所以和 Grok 实测一样,我单独量了一下:把每张结果图和原图都缩放到 800 × 1200、转成灰度,计算两行改动区域以外的平均像素差(0–255)。数值越低,说明越接近原图。
| 模型 | 与原图的差异 |
|---|---|
| Seedream 5.0 Pro | 2.6 |
| GPT Image 2.5 Sunburst | 5.7 |
| Nano Banana 2.1 | 8.2 |
| Grok Imagine 2.0 Medium | 10.0 |
| Qwen-Image 3.0 Pro | 12.2 |
原图尺寸是 1664 × 2496 像素。除了 Nano Banana 2.1 返回的是 1696 × 2528,其余模型返回的尺寸都和原图一样,所以 Nano Banana 2.1 的差异里有一部分来自缩放。Seedream 5.0 Pro 在 Grok 实测的改图题里也是最接近原图的。不过它这次改图的耗时中位数是 118 秒,另外四家在 23 到 55 秒之间。
第 10 题:双参考图出新图
Portrait poster that says "OPEN STUDIO" with a small line "Sat & Sun · 11 AM–6 PM". Use the layout of reference image 1 and the lettering style of reference image 2.


参考图 1 是一张波普风格的画廊海报:顶部一条蓝色色带,红色网点底上压着两行超大标题,底部一行日期。参考图 2 是星空背景上的蓝色细线霓虹空心字。正确的结果应该是参考图 1 的版式加参考图 2 的霓虹字。
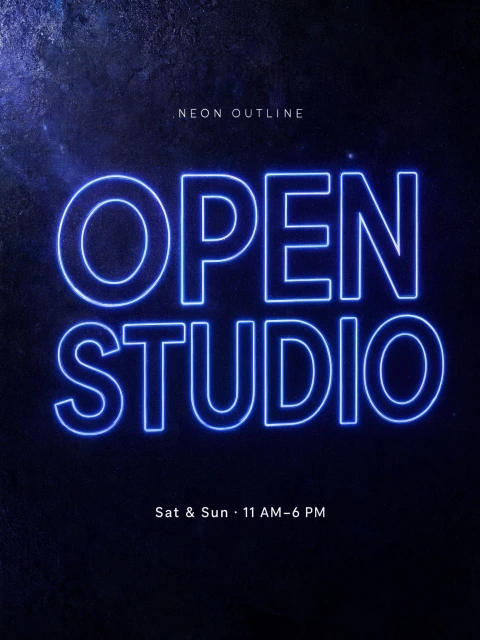
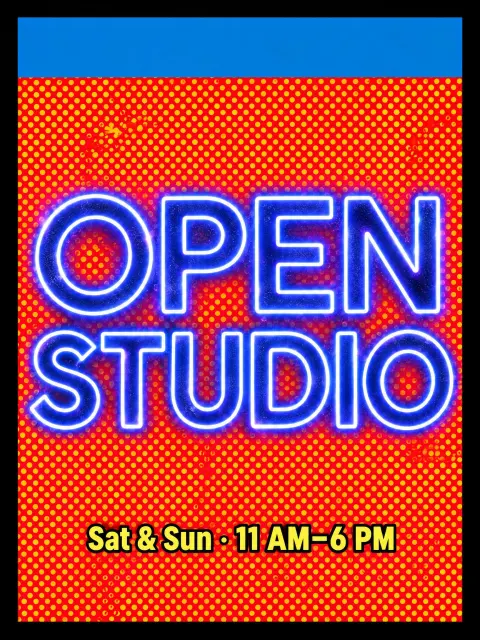
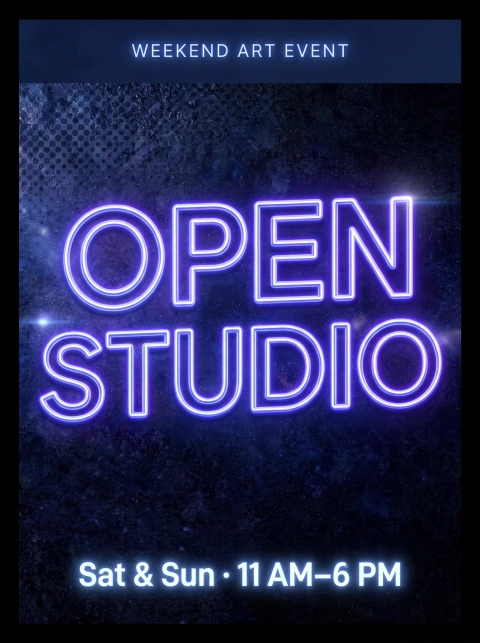
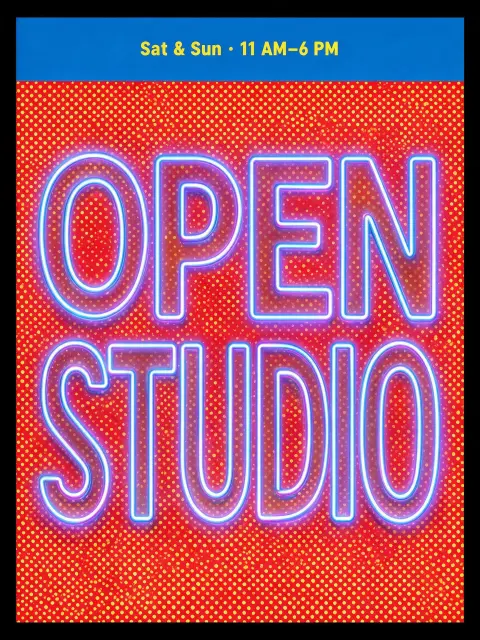
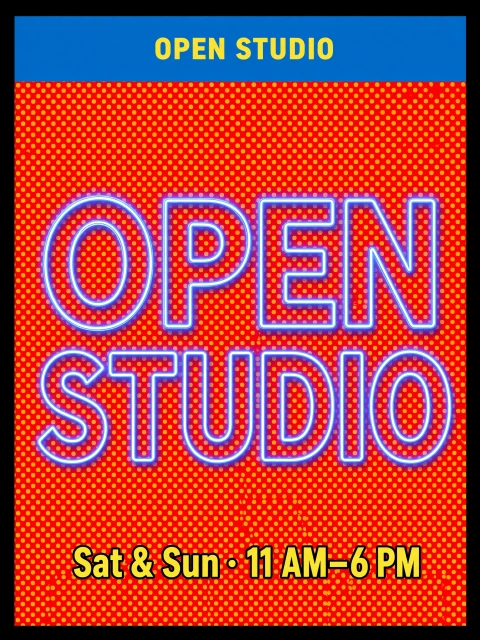
GPT Image 2.5 和 Seedream 5.0 Pro 两部分都做对了,并列最高,9.2 分。Grok Imagine 2.0 两部分也都做对了,但在顶部色带里又写了一遍「OPEN STUDIO」,得 8.95 分。Nano Banana 2.1 用了霓虹字和顶部色带,背景却用了参考图 2 的星空,还加了一行提示词里没有的「WEEKEND ART EVENT」。Qwen-Image 3.0 Pro 的字效和版式都照着参考图 2 做,还把参考图 2 上的「NEON OUTLINE」几个字也抄了过来;它的第二张图也是这样。
Seedream 5.0 Pro 这道题的第一次出图失败了。在 FontVibe 上,Seedream 5.0 Pro 的请求超过 2 分钟会被中止。它在 2K、带两张参考图的条件下尝试了 4 次,3 次撞到这个上限;唯一成功的那张用了 121 秒,参与打分的就是这张。Nano Banana 2.1 也失败过一次,是第 7 题的第二张图,重试后成功。失败的请求在 FontVibe 上会退还积分。
Qwen-Image 3.0:选 1K 还是 2K?
在 FontVibe 上,Qwen-Image 3.0 Pro 出一张 1K 图 22 积分,2K 图 40 积分。我把字最小的两道题(第 4、5 题)又用 1K 各出了两张。
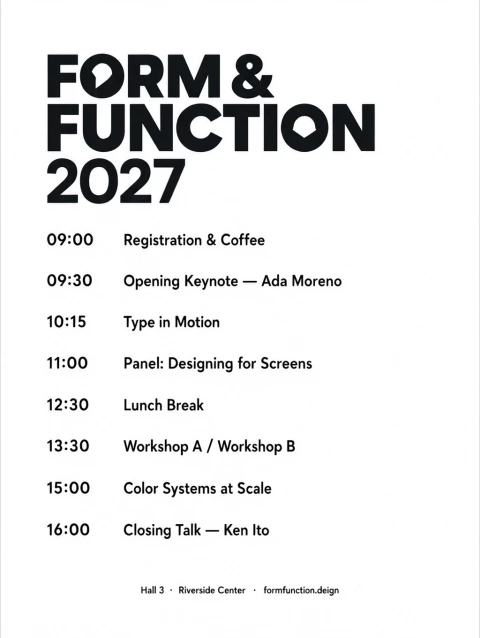
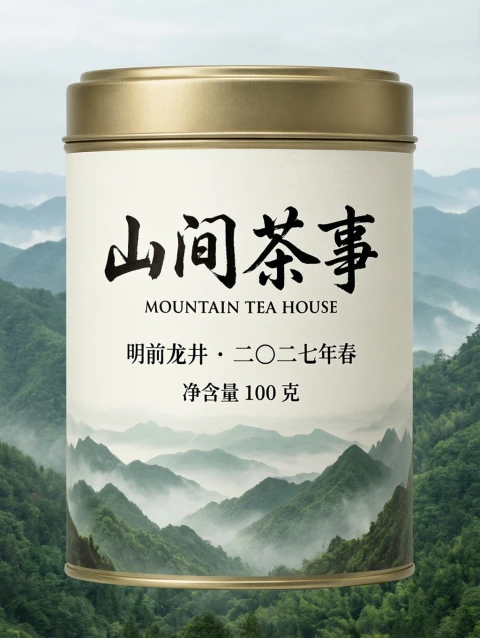
1K 图是 1024 × 1360 像素,2K 图是 1728 × 2304 像素。在 1K 下,日程表的 10 行字和茶叶罐的 4 行字依然全部可读,两道题的得分也和 2K 相同:7.4 分和 8.45 分。1K 下它同样画成了茶叶罐,而不是标签。两张 1K 日程表都有「formfunction.deign」这个错,2K 的两张里有一张有。1K 出图耗时中位数 14 秒,2K 是 23 秒。
如果是草稿、或者在手机上看的社交媒体图,这次测试里 1K 的价格是 2K 的 55%,字也照样可读;如果要印刷,2K 的像素数是 1K 的 2.9 倍。
想试 Qwen-Image 3.0 Pro,在 FontVibe 生成器的模型菜单里选它即可。它一次最多接收 3 张图,被修改的原图和参考图都算在内。点本文任意一张图,会打开它在 FontVibe 上的作品页;鼠标移到图上,会出现「做同款」按钮,用同一条提示词再出一张。
两次测试的对比
GPT Image 2.5 Sunburst、Grok Imagine 2.0 Medium、Nano Banana 2.1 和 Seedream 5.0 Pro 也参加了我的 Grok Imagine 2.0 实测,那次有 8 道题的提示词和这次不同。
| 模型 | Grok Imagine 2.0 实测 | 本次测试 |
|---|---|---|
| GPT Image 2.5 Sunburst(High) | 8.90(第 1) | 8.99(第 2) |
| Grok Imagine 2.0 Medium | 8.84(第 2) | 9.01(第 1) |
| Nano Banana 2.1 | 8.55(5 组中第 4) | 8.76(第 3) |
| Seedream 5.0 Pro | 8.20(第 5) | 8.75(第 4) |
GPT Image 2.5 和 Grok Imagine 2.0 Medium 的第一、二名互换了:上次两家差 0.06,这次差 0.02。Nano Banana 2.1 两次都排在 Seedream 5.0 Pro 前面,上次领先 0.35,这次只领先 0.01。Nano Banana 2.1 在 Grok 实测里排第 4,是因为那次还有 Grok Imagine 2.0 Low(8.59 分)。
第 1 题和第 3 题在两次测试里用的是同一条提示词,可以直接对比。第 1 题,Qwen-Image 3.0 Pro 得 8.3 分,低于另外四个模型在两次测试里的任何一次得分。第 3 题,它得 9.0 分,和本次的 GPT Image 2.5、Nano Banana 2.1 持平。
各模型一句话
Grok Imagine 2.0 Medium,9.01 分。 「信息与构图」最高,8.9 分。10 道题里有 5 道是最高分或并列最高。参评图里没有漏字或错字。最低一题 8.3 分(日程表,标题用的是窄体黑体而不是几何字)。出图耗时中位数 95 秒,五家最慢。
GPT Image 2.5 Sunburst(High),8.99 分。 「字形与质感」最高,9.0 分;吸引力最高,8.9 分。10 道题里有 8 道是最高分或并列最高。最低一题 7.5 分(餐车照片,自己加了一块带乱码的黑板)。测的是 High 档,Extra High 和 Max 没有测。
Nano Banana 2.1,8.76 分。 在 FontVibe 上出一张 2K 图 25 积分,五家最便宜。最低一题 7.9 分(日程表,交的是印好卡片的照片)。第 10 题的版式参考只学了一半。
Seedream 5.0 Pro,8.75 分。 可读性 10.0 分,与 Qwen-Image 3.0 Pro 并列最高。改图题最接近原图,像素差 2.6。双参考图那道题尝试 4 次,3 次撞到 FontVibe 的 2 分钟上限。最低一题 8.15 分(贴纸)。
Qwen-Image 3.0 Pro,8.57 分。 可读性 10.0 分,与 Seedream 5.0 Pro 并列最高;出图耗时中位数最短,23 秒。「信息与构图」7.7 分、吸引力 7.8 分,都是五家最低。10 张参评图里有 3 张把要求的文字改了或写错了,要标签时画了茶叶罐。没有一道题拿到最高分。
盲评
因为打分时我知道每张图出自哪个模型,所以另做了一轮盲评:一个私密页面把每道题的 5 张图随机排序、隐去模型名,每张图打字效分(1–5)、版式分(1–5),再判一个结论:能直接用、小改可用、不能用。
| 模型 | 盲评字效(1–5) | 盲评版式(1–5) | 能直接用 / 小改可用 / 不能用 |
|---|---|---|---|
| GPT Image 2.5 Sunburst | 4.4 | 4.8 | 8 / 2 / 0 |
| Seedream 5.0 Pro | 4.3 | 4.3 | 4 / 4 / 2 |
| Nano Banana 2.1 | 4.3 | 4.2 | 4 / 4 / 2 |
| Grok Imagine 2.0 Medium | 4.0 | 4.2 | 4 / 5 / 1 |
| Qwen-Image 3.0 Pro | 3.4 | 3.5 | 1 / 2 / 7 |
盲评和评分标准在最后一名上一致,都是 Qwen-Image 3.0 Pro。盲评把 GPT Image 2.5 排在第一,评分标准则是它比 Grok Imagine 2.0 Medium 低 0.02;Seedream 5.0 Pro、Nano Banana 2.1、Grok Imagine 2.0 这三家,盲评的顺序和评分标准正好相反。盲评对 Qwen-Image 3.0 Pro 比评分标准更严:它 10 张图里有 7 张被判为不能用,另外四家每家最多 2 张。
这次测试的局限
- 每个模型每题只评了一张图,50 张图都由同一个人打分。
- Grok Imagine 2.0 Medium 和 GPT Image 2.5 只差 0.02,Nano Banana 2.1 和 Seedream 5.0 Pro 只差 0.01。某一题改动 1 分,平均分就会变动 0.02 到 0.035,所以这两组的先后都取决于单个分数。
- GPT Image 2.5 测的是五档里的第三档,另外四个模型测的都是各自的最高档。
- Qwen-Image 3.0 Pro 测试时关掉了它自带的提示词改写。打开后模型会先改写提示词再出图,结果可能不同。
- 改图和参考图用的原图都来自 Seedream 5.0,它是 Seedream 5.0 Pro 的上一代。
- Qwen-Image 3.0 Pro 宣称支持的 12 种语言里,这次只测了中文和日文。
- 结果反映的是这些模型在 2026 年 10 月 21 日的版本。
所有图都在 FontVibe 上公开,每个分数都有书面理由。如果你用同样的提示词重跑、得到很不一样的结果,欢迎发邮件到 hello@fontvibe.ai,我会补进这篇文章。
附录:全部分数
可读性 / 字形与质感 / 信息与构图 / 吸引力,然后是加权总分。取每个模型的第一张图(第 10 题 Seedream 5.0 Pro 取唯一成功的那张)。
| 题目 | Qwen-Image 3.0 Pro | GPT Image 2.5(High) | Nano Banana 2.1 | Seedream 5.0 Pro | Grok Imagine 2.0 Medium |
|---|---|---|---|---|---|
| 1 请柬 | 10/9/7/7 = 8.30 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/9/7/8 = 8.50 | 10/9/9/9 = 9.20 |
| 2 贴纸 | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 10/9/9/9 = 9.20 | 10/8/7/8 = 8.15 | 10/9/9/8 = 9.00 |
| 3 海报 | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/9/7/8 = 8.50 | 9/9/9/9 = 9.00 |
| 4 日程表 | 10/7/7/6 = 7.40 | 10/9/9/9 = 9.20 | 10/8/6/8 = 7.90 | 10/9/8/9 = 8.95 | 10/7/9/8 = 8.30 |
| 5 茶叶罐标签 | 10/9/6/9 = 8.45 | 10/9/8/9 = 8.95 | 10/9/8/9 = 8.95 | 10/9/7/9 = 8.70 | 10/9/9/9 = 9.20 |
| 6 日文海报 | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 10/9/9/8 = 9.00 | 10/9/8/9 = 8.95 | 10/9/9/8 = 9.00 |
| 7 徽章 Logo | 10/9/9/8 = 9.00 | 10/9/9/9 = 9.20 | 7/8/9/8 = 8.05 | 10/7/9/8 = 8.30 | 10/9/9/9 = 9.20 |
| 8 餐车照片 | 10/9/8/8 = 8.75 | 4/9/7/9 = 7.50 | 10/9/8/9 = 8.95 | 10/9/9/9 = 9.20 | 10/9/9/9 = 9.20 |
| 9 改图 | 10/9/7/8 = 8.50 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 | 10/9/9/8 = 9.00 |
| 10 双参考图 | 10/9/6/8 = 8.25 | 10/9/9/9 = 9.20 | 10/9/7/8 = 8.50 | 10/9/9/9 = 9.20 | 10/9/8/9 = 8.95 |
Qwen-Image 3.0 Pro 1K(不计入平均分):第 4 题 10/7/7/6 = 7.40;第 5 题 10/9/6/9 = 8.45。
每个分数的书面理由都已存档,需要可以索取。
常见问题
Qwen-Image 3.0 做带字的设计图效果怎么样?
在这次测试里,Qwen-Image 3.0 Pro 的可读性与 Seedream 5.0 Pro 并列最高,10.0 分;但总分是五个模型中最低的,8.57 分(满分 10)。它 10 张参评图里有 3 张把要求的文字改了或写错了,「信息与构图」7.7 分,五家最低。
做带字的设计图,哪个生图模型分数最高?
Grok Imagine 2.0 Medium 得 9.01 分(满分 10),是 5 个模型 10 道题里最高的;GPT Image 2.5 Sunburst 在 High 档下得 8.99 分,低 0.02。Nano Banana 2.1 8.76 分,Seedream 5.0 Pro 8.75 分,Qwen-Image 3.0 Pro 8.57 分。
Qwen-Image 3.0 能写中文和日文吗?
在这次测试里可以。它用简体中文把一张中英文茶叶罐标签写对了,也把一张三行的日文海报全部竖排、每个字都写对了。另外四个模型也都做到了。
Qwen-Image 3.0 能改图吗?
能。改图题里它把日期和价格都改对了,但第一张图顺手把「18+」改成了「$Z+」;而且它的结果和原图的像素差是五家最大的,12.2(0–255 刻度)。
Qwen-Image 3.0 用 1K 够不够?
在字最小的两道题里,1K 图和 2K 图得分相同,分别是 7.4 分和 8.45 分,每一行字都依然可读。在 FontVibe 上 1K 是 22 积分,2K 是 40 积分。
GPT Image 2.5 测的是最高档吗?
不是。GPT Image 2.5 Sunburst 测的是 High 档,是五个质量档里的第三档,也是 FontVibe 的默认档;Extra High 和 Max 没有测。
能在一个地方试这五个模型吗?
五个模型都在 FontVibe 的模型菜单里,同一条提示词可以分别在每个模型上跑。
评论