AI 生图写字哪个最准:7 款模型实测
逐字核对:四款 120 张只错 1 张,千问 3.0 Pro 30 张错 11 张;补测 GPT Image 2.6,和四款打平。
写字最准的 AI 生图模型不是某一款。我们测了 150 张图,五款里有四款写字几乎不出错,而且彼此分不出高下:GPT Image 2.5 Sunburst、Grok Imagine 2.0、Seedream 5.0 Pro 和 Nano Banana 2.1。四款合计 120 张里 119 张零错,最长的一题是 189 个英文单词的长信。第五款 Qwen Image 3.0 Pro(千问)在 26 个和 34 个英文单词的两题没出错,72 个英文单词时 3 张错 1 张,117 个英文单词起每张都有错,30 张里共 11 张有错字,其中 4 张出在短题上(门票和面包店橱窗字)。
既然四款准确度打平,就按设计和价格挑。设计分上,Grok Imagine 2.0、GPT Image 2.5 Sunburst 和 Nano Banana 2.1 在误差范围内打平;Nano Banana 2.1 是 FontVibe 上五款里最便宜的。Seedream 5.0 Pro 设计分低于 Grok Imagine 2.0 和 GPT Image 2.5 Sunburst、和 Nano Banana 2.1 打平,而且每张演出海报都自己加了一行字。
这次主要测的是英文。中文只测了一句 30 字(含全角标点)的短句,五款 15 张全对:能说明照抄一句短中文五款都没问题,说明不了更长的中文谁更准。
每款模型用同样的 10 道题,每题跑 3 次,一张不挑。150 张图的每一个必需字符我们都核对过。逐张结果和每张图的链接见附录。
2026 年 11 月 10 日更新: 我们补测了 OpenAI 的 GPT Image 2.6。它分 GPT Image 2.6 Sunburst 和 GPT Image 2.6 Flare 两个型号,题目、档位都和上面的 GPT Image 2.5 Sunburst 相同,多出 60 张图。两个型号都没有比 GPT Image 2.5 Sunburst 测出更准。详见GPT Image 2.6 Sunburst、Flare 对比 GPT Image 2.5 Sunburst。上面五款模型的结果没有变。
结果
| 模型(档位) | 零错图 | 必需行写对 | 错字符 | 3 张全部零错的最长一题 | 设计分(满分 10) | FontVibe 每张积分 |
|---|---|---|---|---|---|---|
| GPT Image 2.5 Sunburst(Medium,比默认的 High 低一档) | 29 / 30 | 233 / 234 | 7,410 个里错 16 个(0.2%) | 189 个英文单词,即本次最长 | 7.91 | 32 |
| Grok Imagine 2.0(Medium,它两档里较高的一档) | 30 / 30 | 234 / 234 | 0 | 189 个英文单词,即本次最长 | 8.01 | 40 |
| Seedream 5.0 Pro | 30 / 30 | 234 / 234 | 0 | 189 个英文单词,即本次最长 | 7.25 | 40 |
| Nano Banana 2.1 | 30 / 30 | 234 / 234 | 0 | 189 个英文单词,即本次最长 | 7.69 | 25 |
| Qwen Image 3.0 Pro | 19 / 30 | 211 / 234 | 7,410 个里错 255 个(3.4%) | 34 个英文单词(72 个英文单词时 3 张对 2 张) | 5.82 | 40 |
| GPT Image 2.6 Sunburst(Medium,比默认的 High 低一档;11 月 10 日补测) | 29 / 30 | 233 / 234 | 7,410 个里错 16 个(0.2%) | 189 个英文单词,即本次最长 | 与 GPT Image 2.5 Sunburst 打平,另一轮打分 | 内测:仅 FontVibe 测试账号(11 月 10 日) |
| GPT Image 2.6 Flare(Medium,比默认的 High 低一档;11 月 10 日补测) | 30 / 30 | 234 / 234 | 0 | 189 个英文单词,即本次最长 | 与 GPT Image 2.5 Sunburst 打平,另一轮打分 | 内测:仅 FontVibe 测试账号(11 月 10 日) |
GPT Image 2.6 两行是主测试之后补的。准确度各列用的是同样的题目、同样的核对;设计分来自另一轮打分,说明见GPT Image 2.6 Sunburst、Flare 对比 GPT Image 2.5 Sunburst。
一张图的每条必需文字都和原文一字不差,才算零错。「错字符」的分母 7,410 是每款 30 张图里必需文字的字符总数:字母、数字、重音字母和 & # @ % / $ £ + 这几个符号,不算空格和标点。GPT Image 2.5 Sunburst 的 16 个全部出在同一处:一张门票整行没印订单号。「最长一题」按第 1–5 题的文字量阶梯算,长度按英文单词计。大小写、标点替换(比如「·」印成「-」)和换行不算错。所有图都是 2K。积分是在 FontVibe 上按这个档位出一张图的价格。
「分不出高下」是什么意思。 每款模型每题出 3 张,共 30 张。GPT Image 2.5 Sunburst 30 张错 1 张,另外三款一张没错。30 张里差 1 张,在这个样本量下单靠运气就能出现:我们把四款模型逐题配对、重抽样 10,000 次,任意两款之间的差距区间都包含零。所以我们写「打平」,不排名次。用同样的方法比,四款都明显比 Qwen Image 3.0 Pro 准。
30 张全对不等于这款模型永远不会错,意思是在这些文字量下错误少到 30 次里没碰上一次。
GPT Image 2.5 Sunburst 测的是 Medium,不是 FontVibe 对这款模型的默认档 High。它那 1 张出错的图和它的设计分说的都是 Medium。High 或更高档可能更准。
GPT Image 2.6 Sunburst、Flare 对比 GPT Image 2.5 Sunburst:新版写字更准吗?
OpenAI 在 2026 年 11 月 4 日发布了 GPT Image 2.6,分两个型号。OpenAI 的图像生成指南里,GPT Image 2.6 Sunburst 的定位是做精细的视觉作品,GPT Image 2.6 Flare 的定位是快速迭代。Sunburst 和 Flare 是 OpenAI 官方的名字(API 里叫 gpt-image-2.6-sunburst 和 gpt-image-2.6-flare),GPT Image 2.5 也分这两个型号(GPT Image 2.5 Sunburst 和 GPT Image 2.5 Flare)。Flare 更快:这次测试里,2K、Medium 档 GPT Image 2.6 Flare 每张约 12 秒,GPT Image 2.6 Sunburst 约 29 秒,是各自 30 张的平均,从发出请求算到拿到成图(含排队和轮询结果的时间)。GPT Image 2.6 是 11 月 10 日接入 FontVibe 的,比主测试晚一天,所以主测试里 OpenAI 用的是 GPT Image 2.5 Sunburst。主测试没有测 GPT Image 2.5 Flare,所以这里两个 GPT Image 2.6 型号(包括 Flare)都是和 GPT Image 2.5 Sunburst 比。
我们让两个 GPT Image 2.6 型号都跑了同样的 10 道题,每题 3 张,2K、Medium 档,也就是主测试里 GPT Image 2.5 Sunburst 用的档位,每个必需字符都按同样的方法核对。和 GPT Image 2.5 Sunburst 一样,FontVibe 对两个 GPT Image 2.6 型号的默认档都是 High,比这次测的高一档。
| 模型(2K,Medium) | 零错图 | 必需行写对 | 错字符 | 3 张全部零错的最长一题 |
|---|---|---|---|---|
| GPT Image 2.5 Sunburst(主测试) | 29 / 30 | 233 / 234 | 7,410 个里错 16 个(0.2%) | 189 个英文单词 |
| GPT Image 2.6 Sunburst | 29 / 30 | 233 / 234 | 7,410 个里错 16 个(0.2%) | 189 个英文单词 |
| GPT Image 2.6 Flare | 30 / 30 | 234 / 234 | 0 | 189 个英文单词 |
没有测出更准。 GPT Image 2.6 Sunburst 犯的错和 GPT Image 2.5 Sunburst 一模一样:3 张门票里有 1 张整行没印「Order #NLF-48213-QX」。它 30 张图里其余的必需行全对。GPT Image 2.6 Flare 30 张一个错都没有,包括 189 个英文单词的长信、价目表和中日文卡片。我们把两个 GPT Image 2.6 型号分别和 GPT Image 2.5 Sunburst 逐题配对,用和上面相同的 10,000 次重抽样比较,零错图和错字符两项差值的 95% 区间都包含零。所以 GPT Image 2.6 Sunburst、GPT Image 2.6 Flare 和 GPT Image 2.5 Sunburst 三者打平。两个 GPT Image 2.6 型号也和 Grok Imagine 2.0、Seedream 5.0 Pro、Nano Banana 2.1 打平:GPT Image 2.6 Sunburst 的结果和 GPT Image 2.5 Sunburst 逐题相同,GPT Image 2.6 Flare 和那三款一样 30 张全对。用同样的方法比,两个 GPT Image 2.6 型号都比 Qwen Image 3.0 Pro 准。两个 GPT Image 2.6 型号都没有自己加题目里没要的字。
Medium 档输出 token 更多,准确度一样。 OpenAI 的接口每出一张图都会返回 usage 用量,里面有这张图用了多少输出图像 token。我们把 GPT Image 2.6 接入 FontVibe 时实测,2K、Medium 档每张图 GPT Image 2.6(Sunburst 和 Flare 相同)用 1,690 个输出 token,GPT Image 2.5 Sunburst 用 512 个,约 3.3 倍;同一档位每张图的数都一样。High 及以上各档,GPT Image 2.6 和 GPT Image 2.5 Sunburst 的输出 token 数相同(2K、High 档每张约 2,125 个)。在这套题上,多出来的 token 没有改变准确度:GPT Image 2.5 Sunburst 的 Medium 档 30 张本来就只错 1 张,这次测试留给它进步的空间很小。比 189 个英文单词更长、更密的文字,也许能把 GPT Image 2.6 和 GPT Image 2.5 Sunburst 分开。
设计分。 GPT Image 2.6 的图由同一位 AI 评审、用同一套评分打分,同样看不到模型名,但是单独一轮,主测试那一轮的分保持已发布的样子不动。为了看评审的尺子有没有变,这一轮也放进了主测试里那 30 张 GPT Image 2.5 Sunburst。这一轮里,GPT Image 2.6 Sunburst 平均 8.03,GPT Image 2.6 Flare 7.58,GPT Image 2.5 Sunburst 7.63。和 GPT Image 2.5 Sunburst 逐题配对比较,两个 GPT Image 2.6 型号的差值区间都包含零(Sunburst +0.40,95% 区间 −0.10 到 +0.91;Flare −0.05,区间 −0.54 到 +0.43),所以两个 GPT Image 2.6 型号的设计分也和 GPT Image 2.5 Sunburst 打平。同样那 30 张 GPT Image 2.5 Sunburst 的图,主测试那一轮是 7.91,这一轮是 7.63,所以两轮的分数不能直接比。结果表里因此写「打平」,不写分数。
能不能用。 截至 2026 年 11 月 10 日,GPT Image 2.6 在 FontVibe 上还是内测:只有 FontVibe 自己的测试账号能选,其他所有用户的模型菜单里都还没有它。上面这些图都是公开的,可以像其他作品一样点开;在 GPT Image 2.6 开放之前,作品页上的 Recreate 按钮会改用 GPT Image 2,这是 OpenAI 更早的一款模型,没有参加本次测试。等它对所有人开放,我们会更新这篇。
写多长的英文开始出错
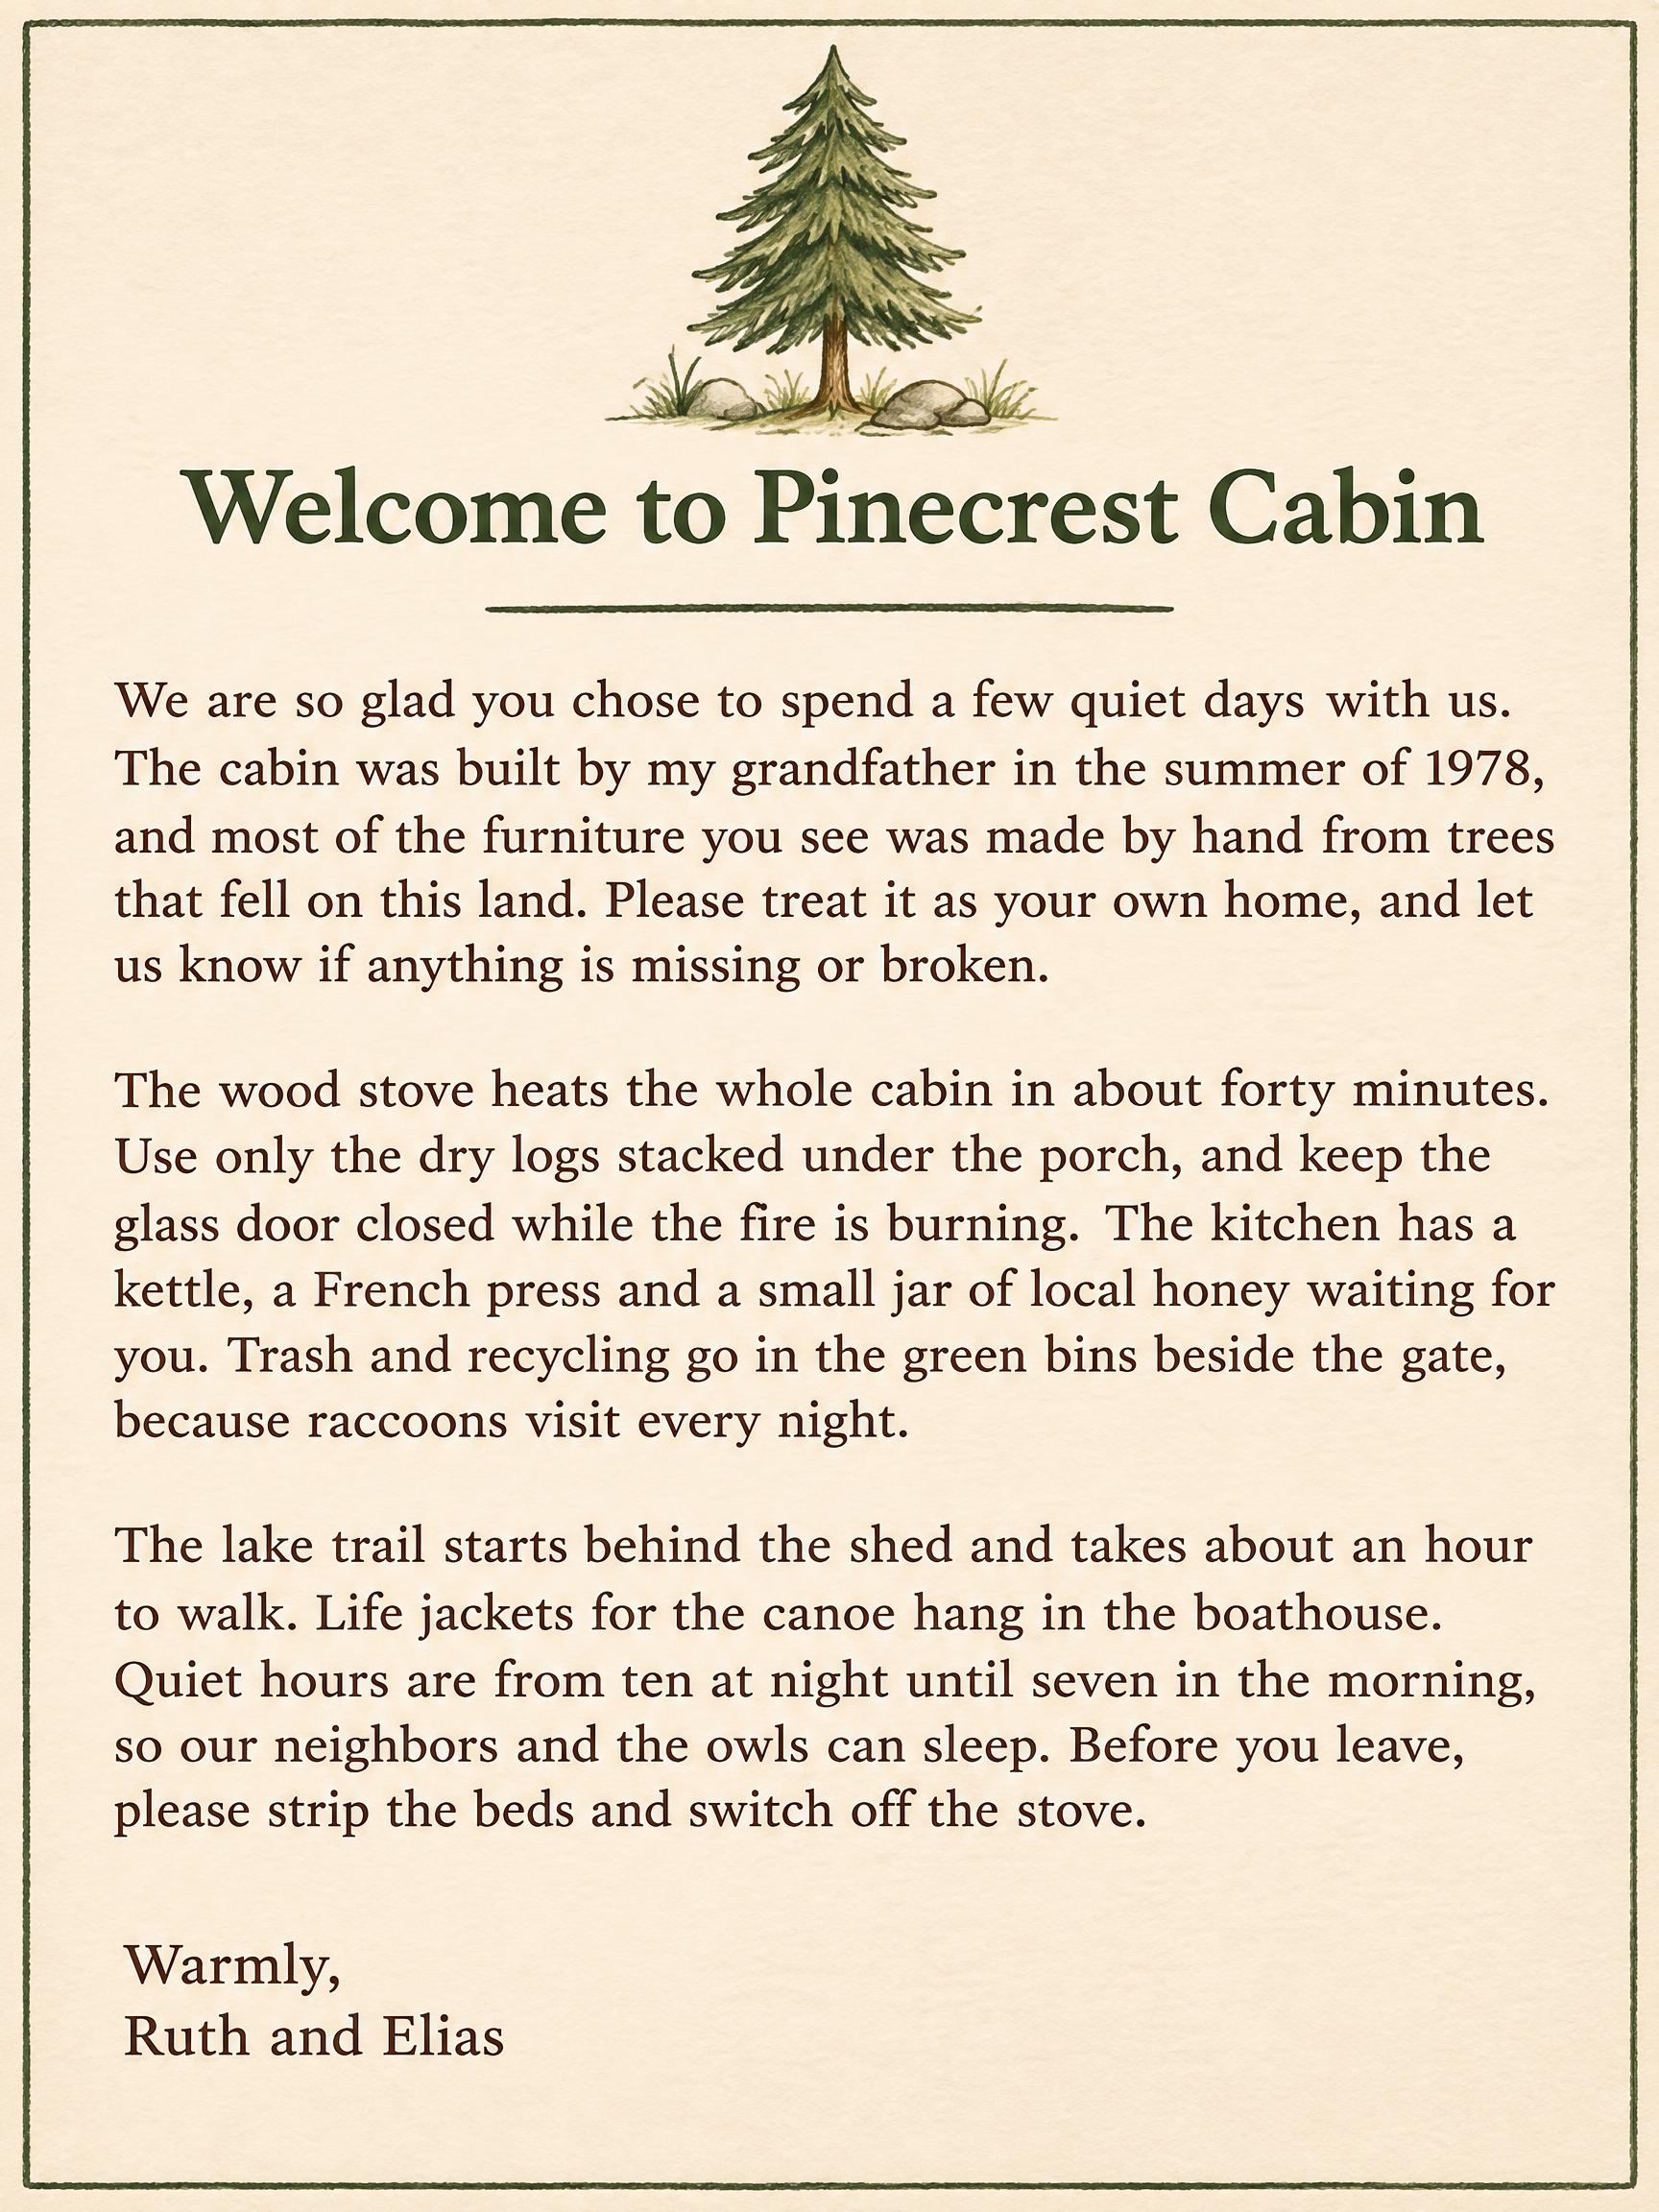
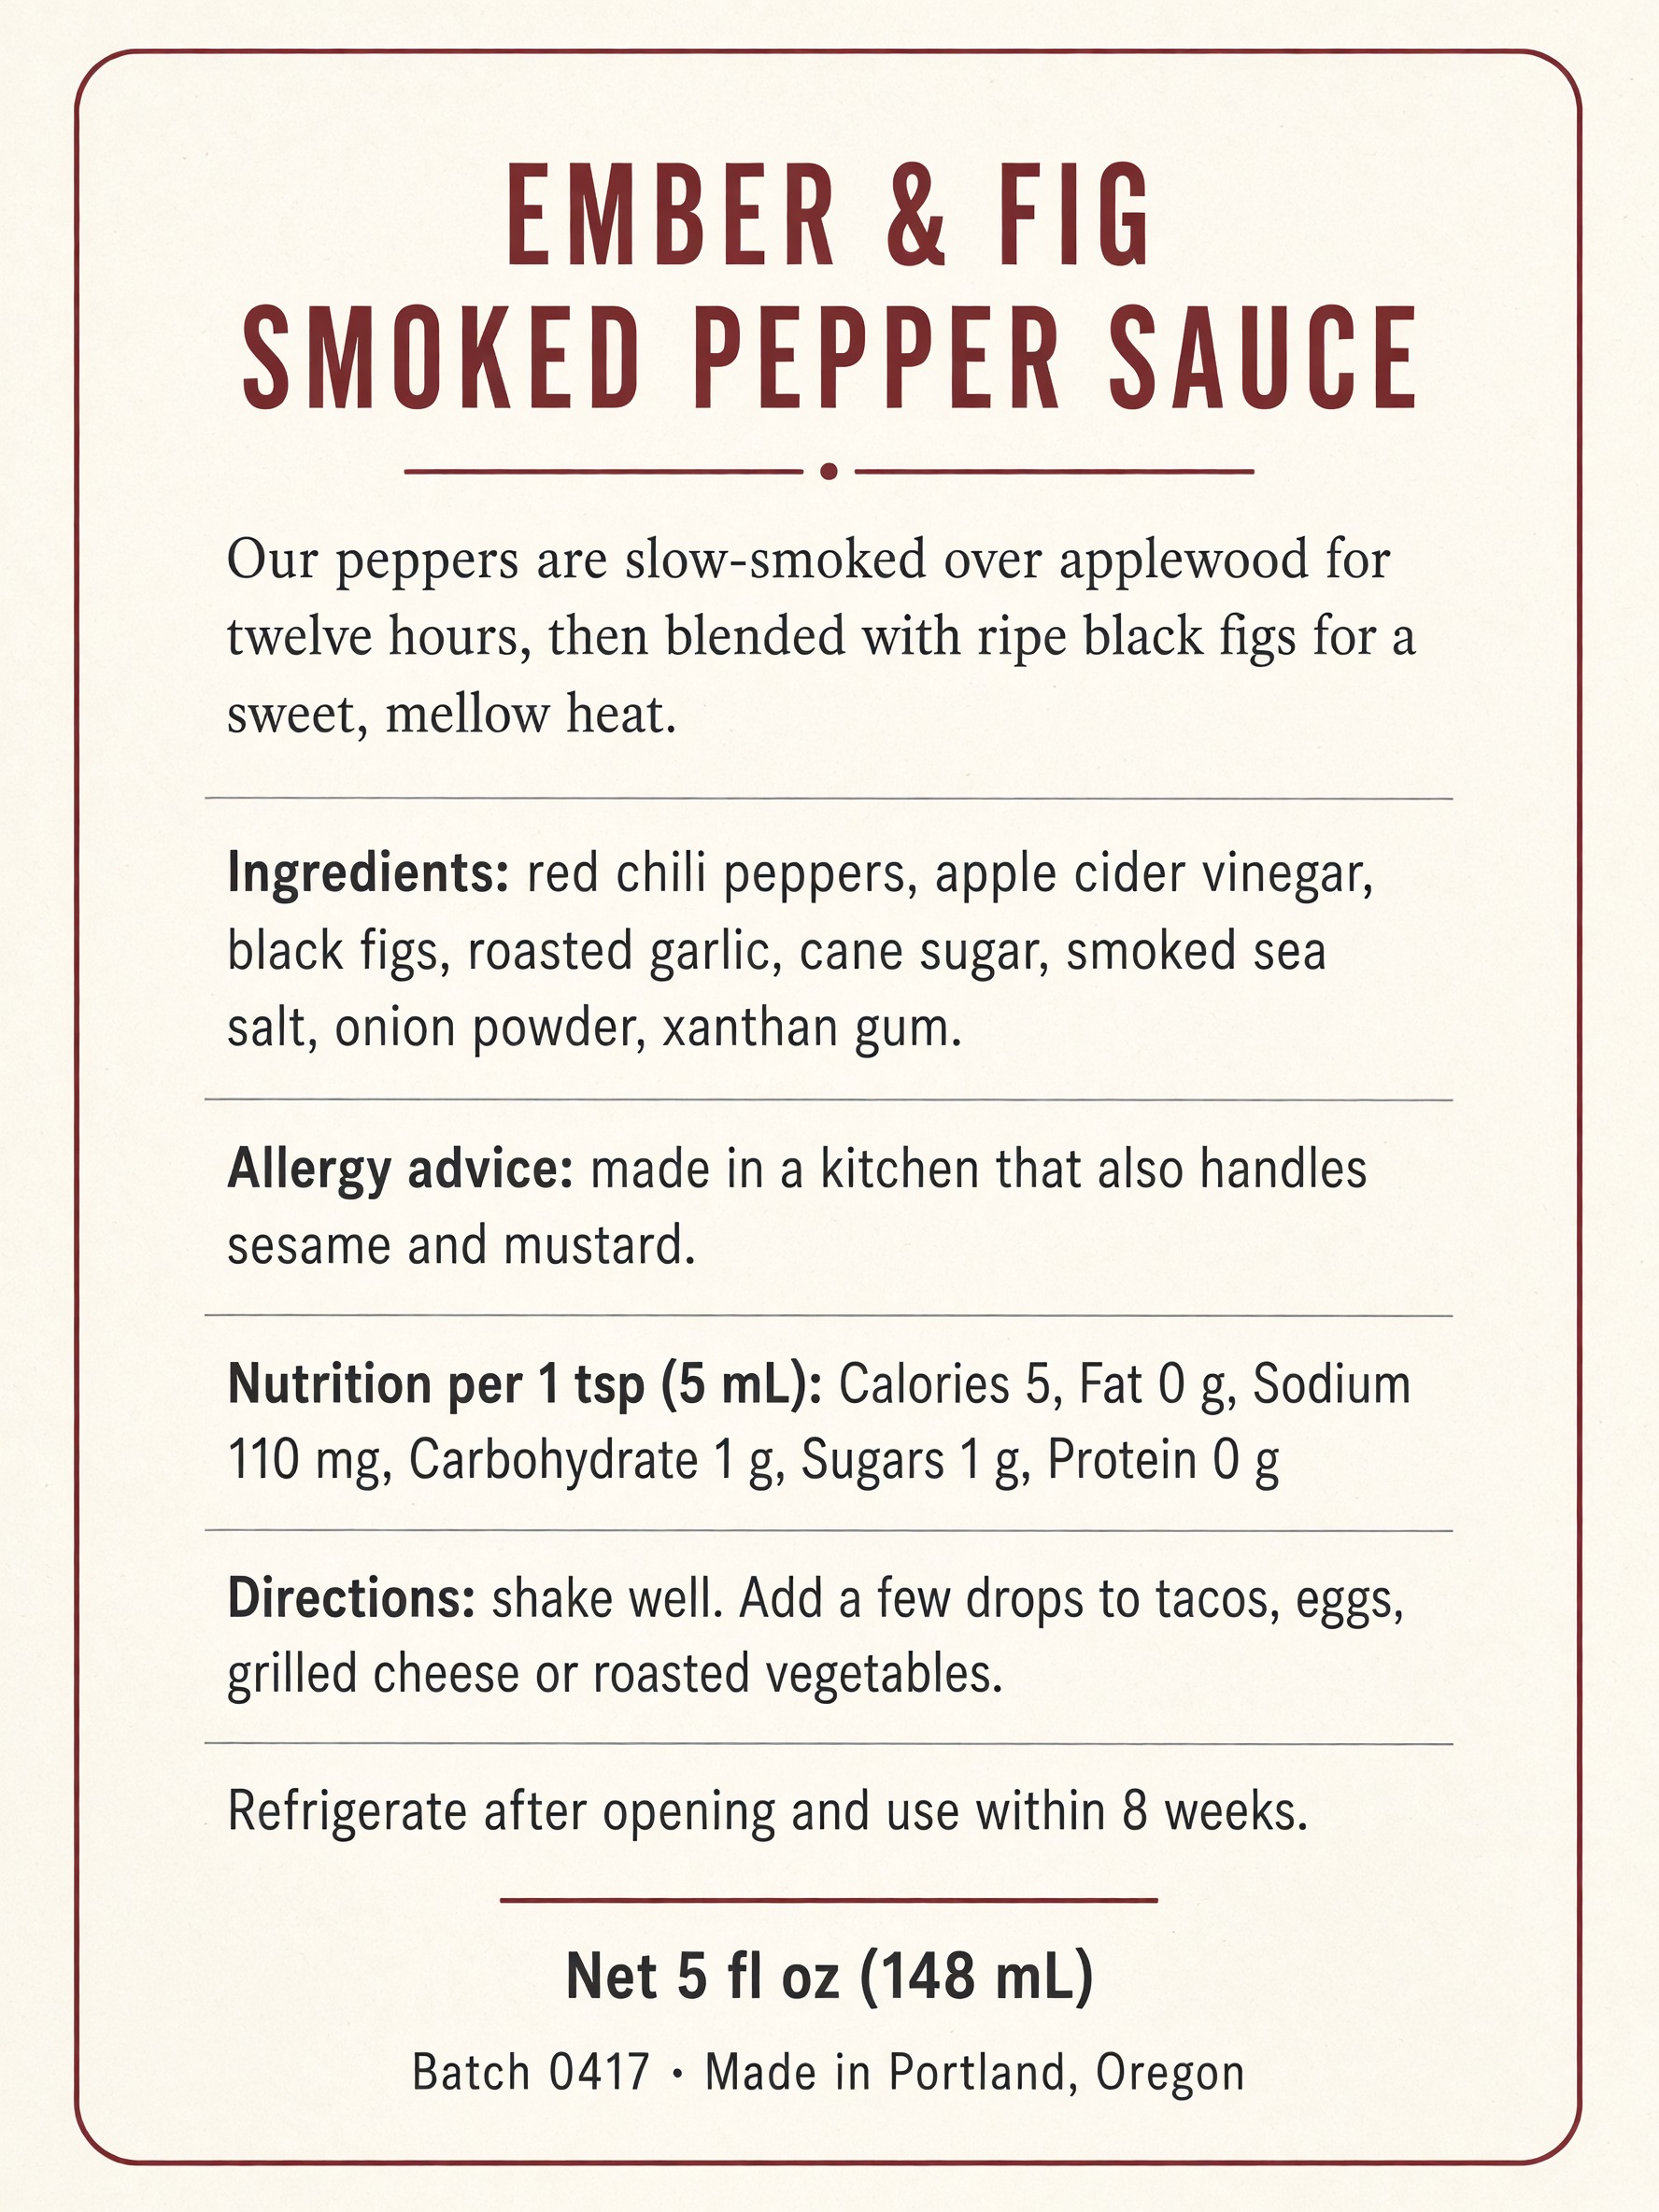
第 1–5 题是一道阶梯:五种不同版式的照抄文字题,一题比一题字多,从 26 个英文单词的演出海报到 189 个英文单词的欢迎信。这部分只测一个问题:写到多长,模型开始写错字?
| 必需文字英文单词数 | 题 | GPT Image 2.5 Sunburst | Grok Imagine 2.0 | Seedream 5.0 Pro | Nano Banana 2.1 | Qwen Image 3.0 Pro |
|---|---|---|---|---|---|---|
| 26 | 演出海报 | 3 / 3 | 3 / 3 | 3 / 3 | 3 / 3 | 3 / 3 |
| 34 | 咖啡店菜单 | 3 / 3 | 3 / 3 | 3 / 3 | 3 / 3 | 3 / 3 |
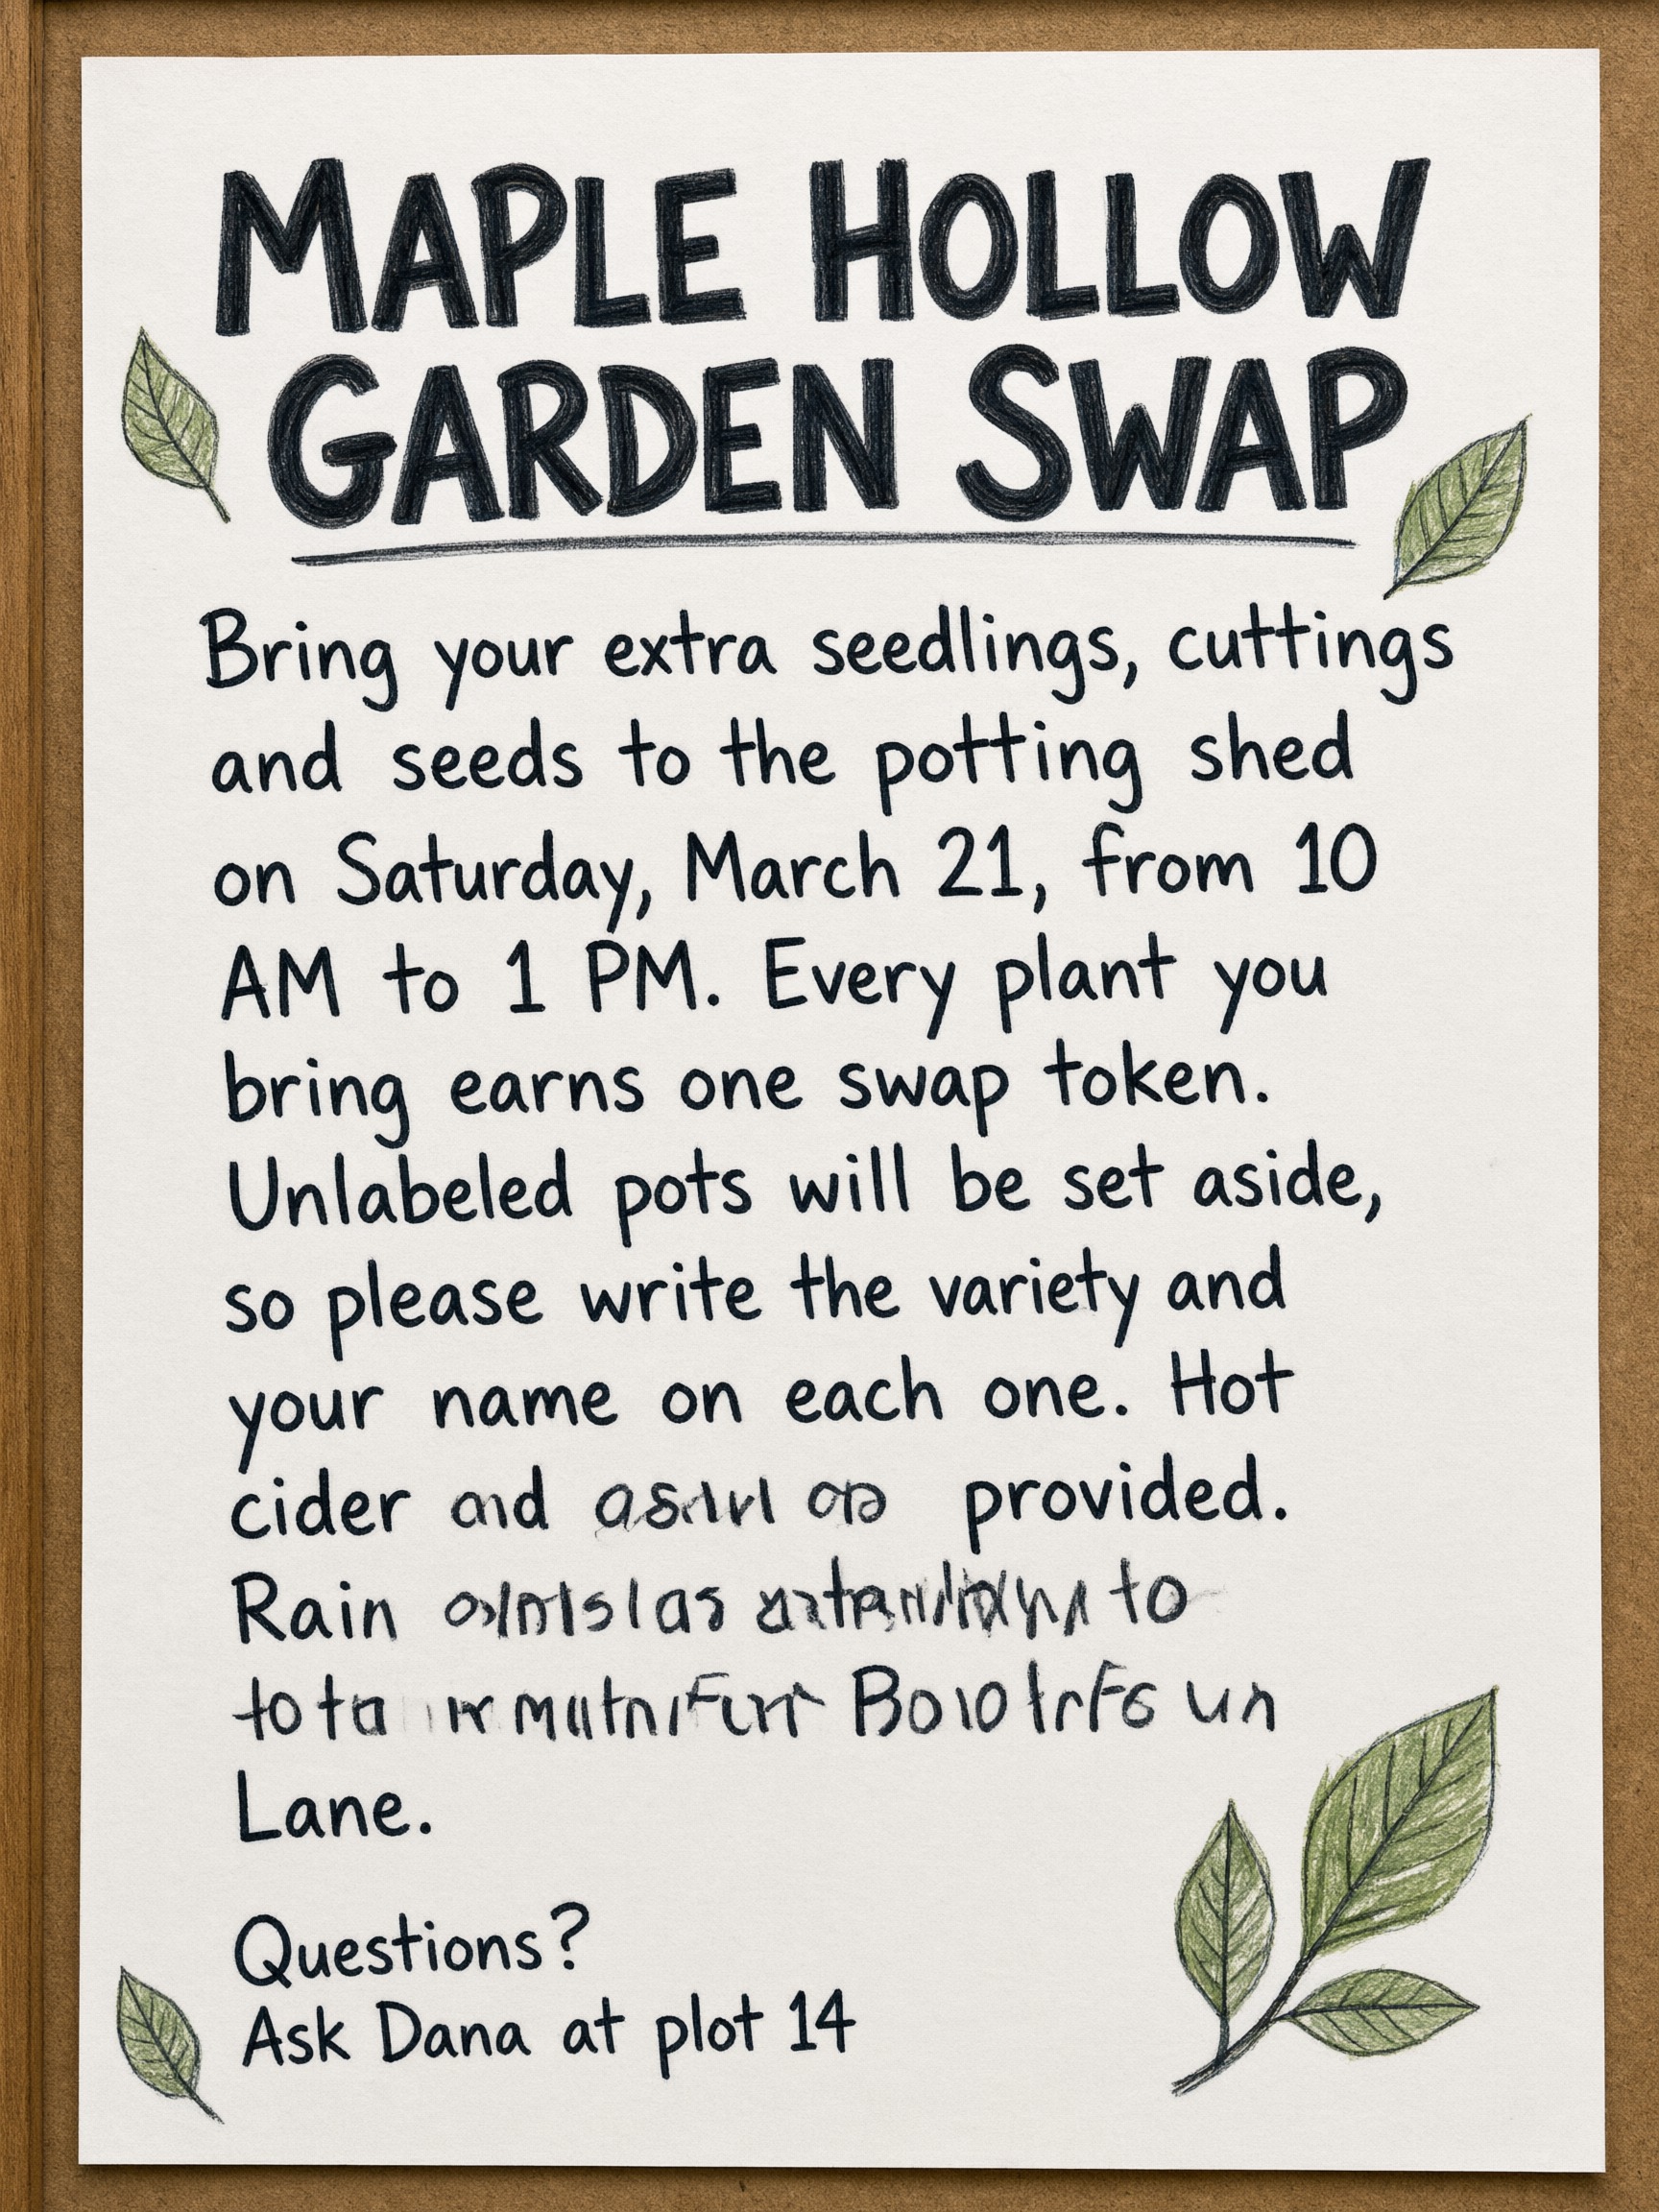
| 72 | 社区花园告示 | 3 / 3 | 3 / 3 | 3 / 3 | 3 / 3 | 2 / 3 |
| 117 | 辣酱瓶背标 | 3 / 3 | 3 / 3 | 3 / 3 | 3 / 3 | 0 / 3 |
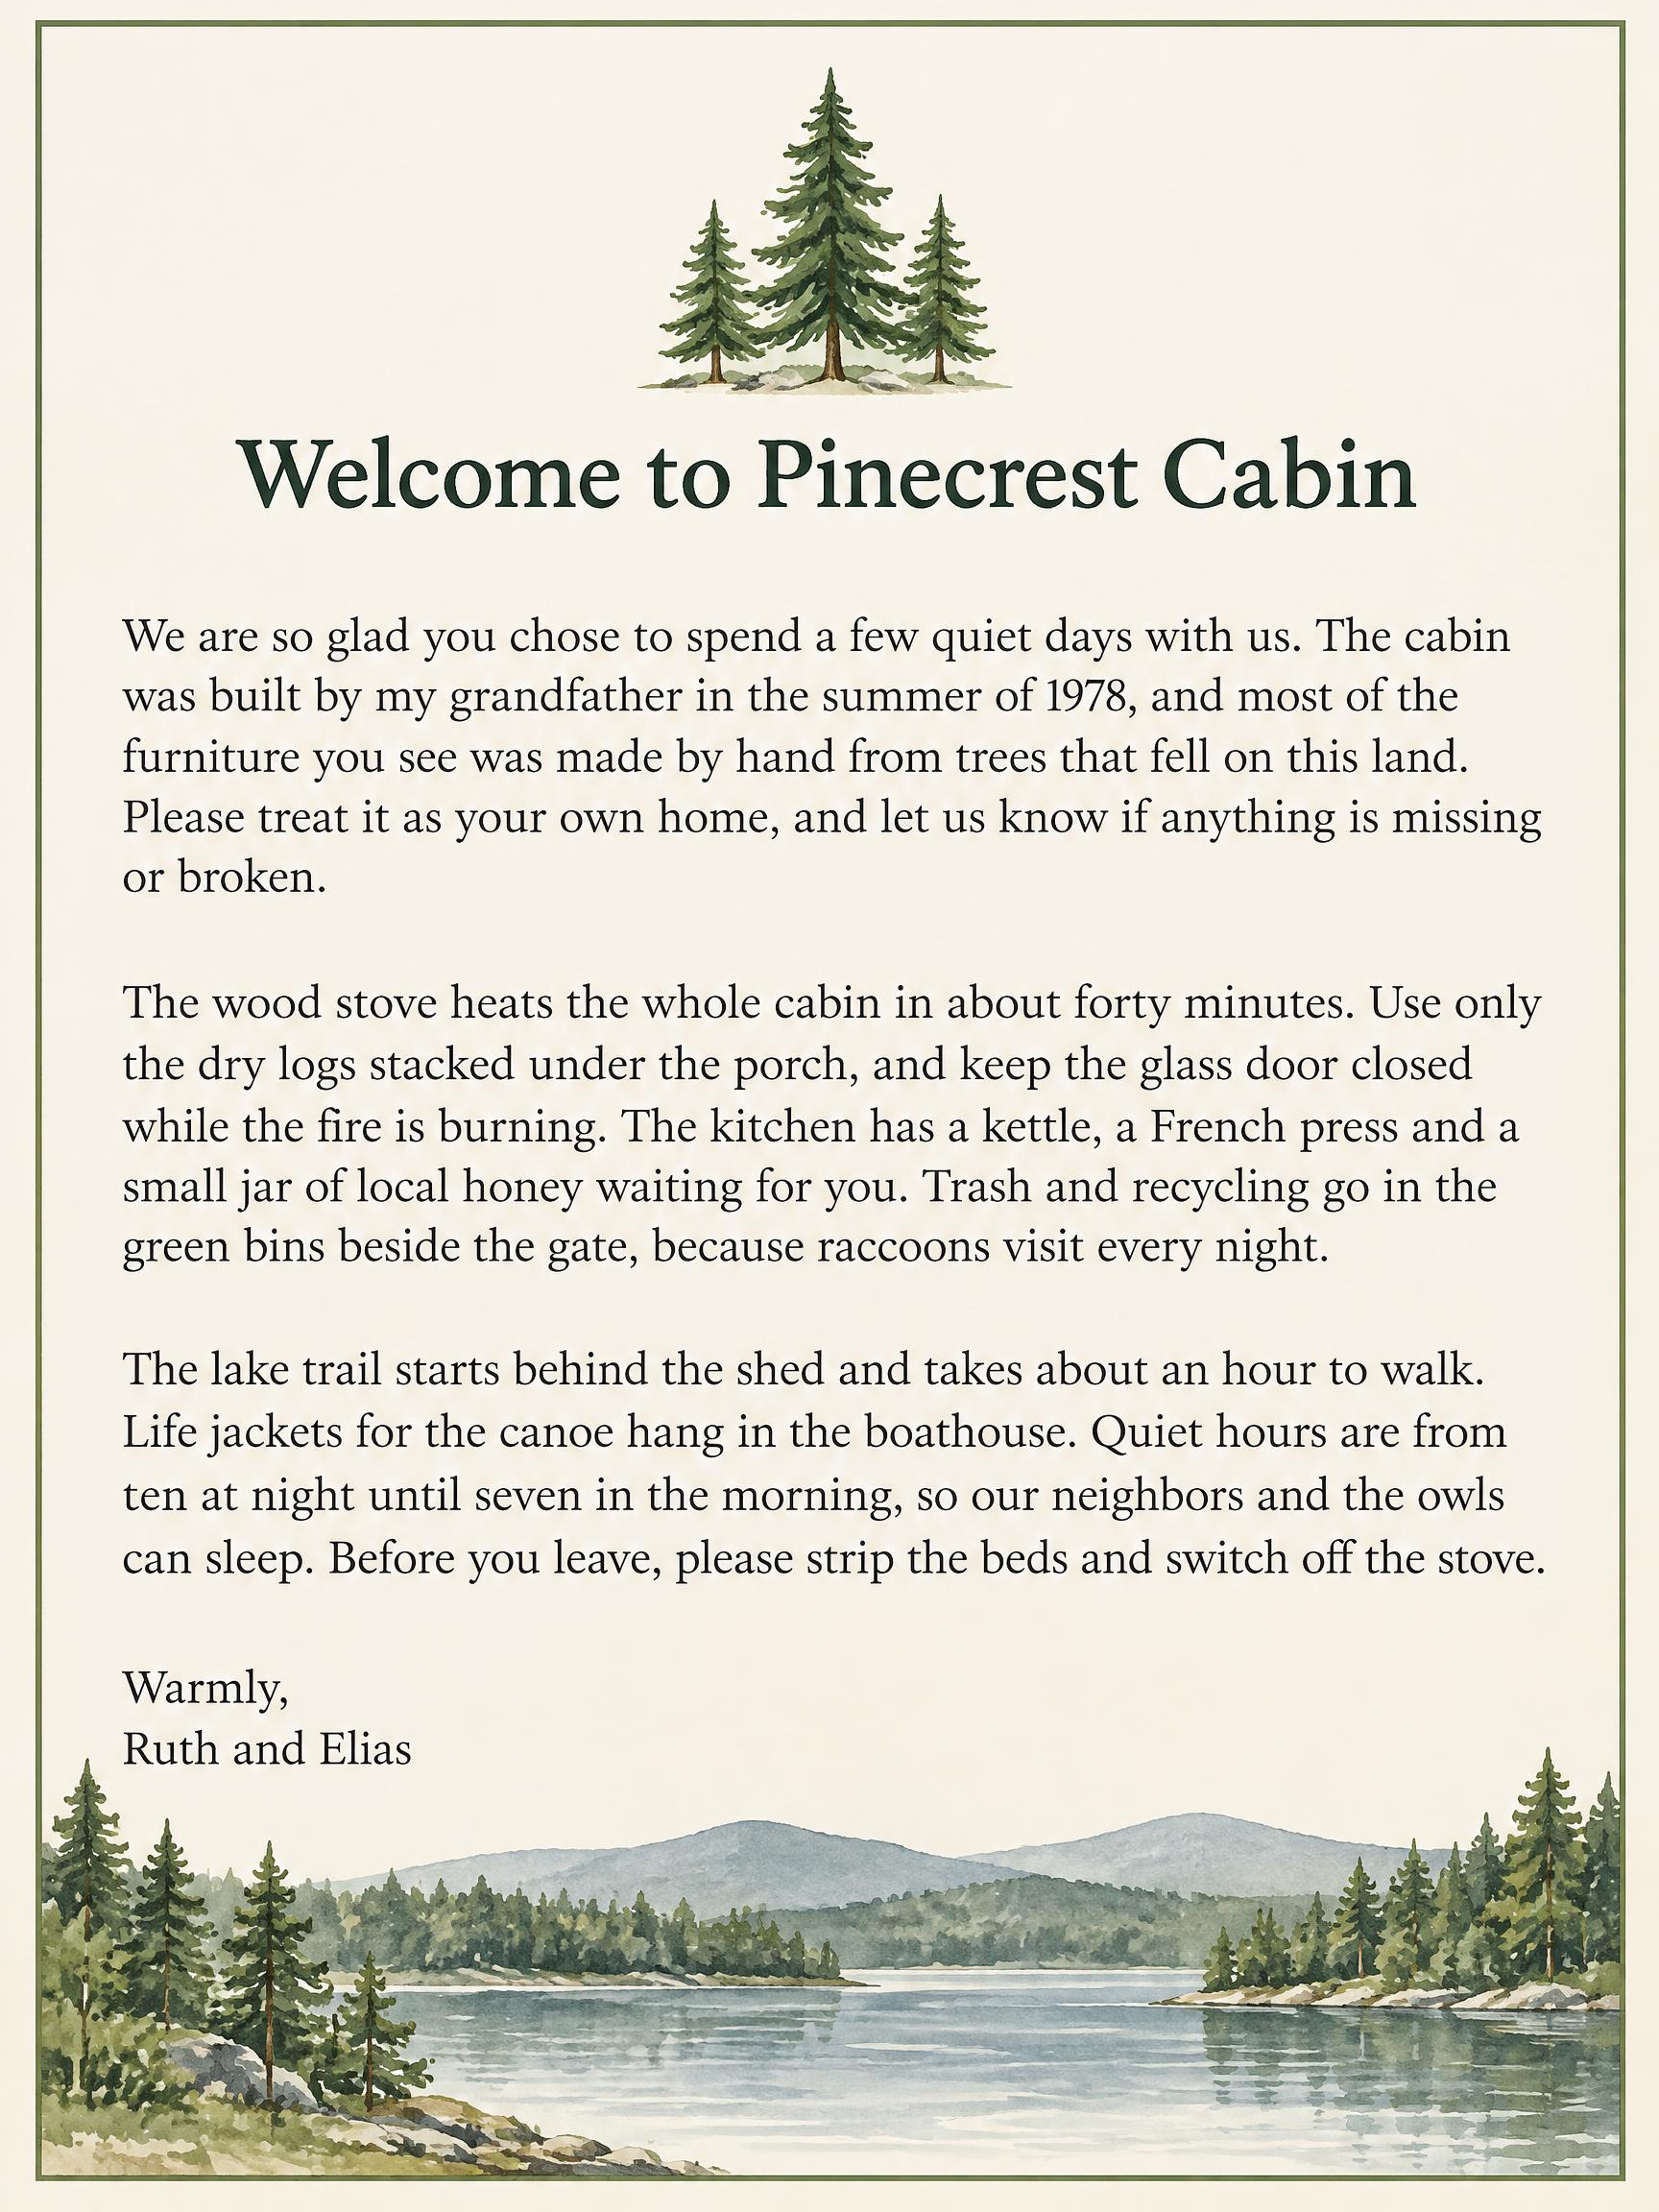
| 189 | 木屋欢迎信 | 3 / 3 | 3 / 3 | 3 / 3 | 3 / 3 | 0 / 3 |
每格是 3 张里零错的张数。
四款一路守到了顶。 GPT Image 2.5 Sunburst、Grok Imagine 2.0、Seedream 5.0 Pro 和 Nano Banana 2.1 写这封 189 个英文单词、三段 11 句的信,12 张图没有一个错字符。它们的上限在 189 个英文单词以上。本轮没测更长的文本,所以说不出上限在哪。
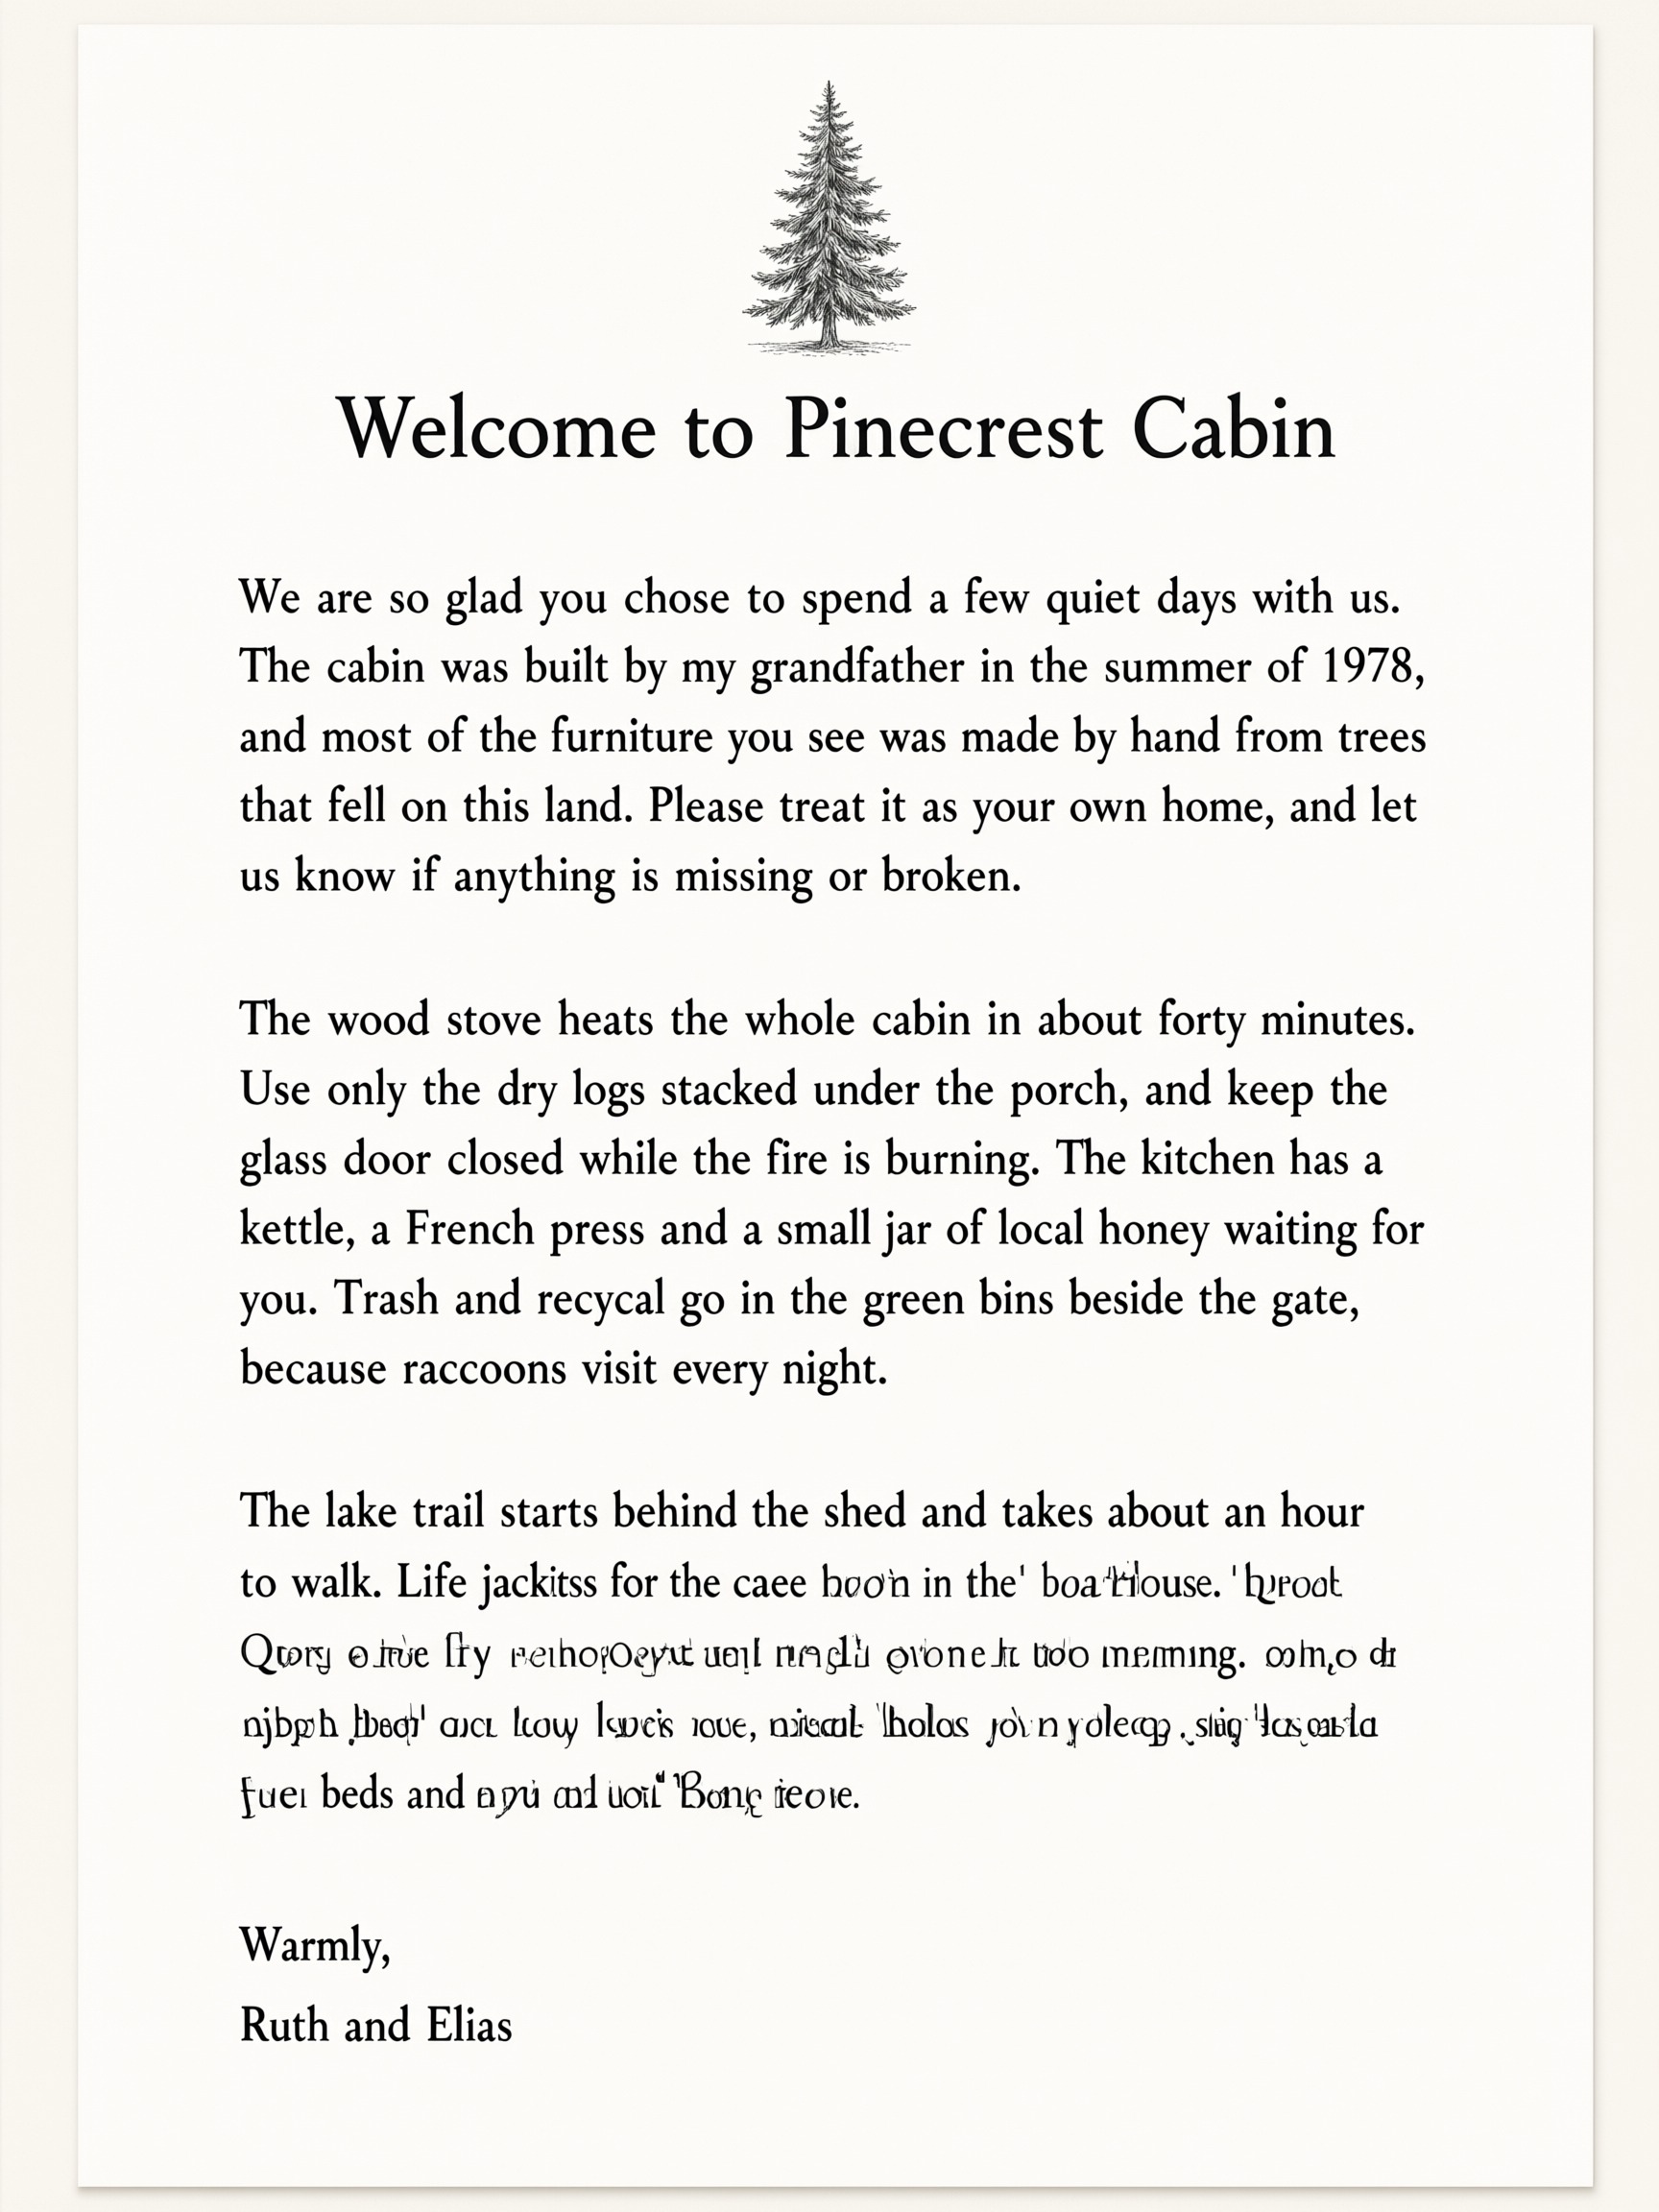
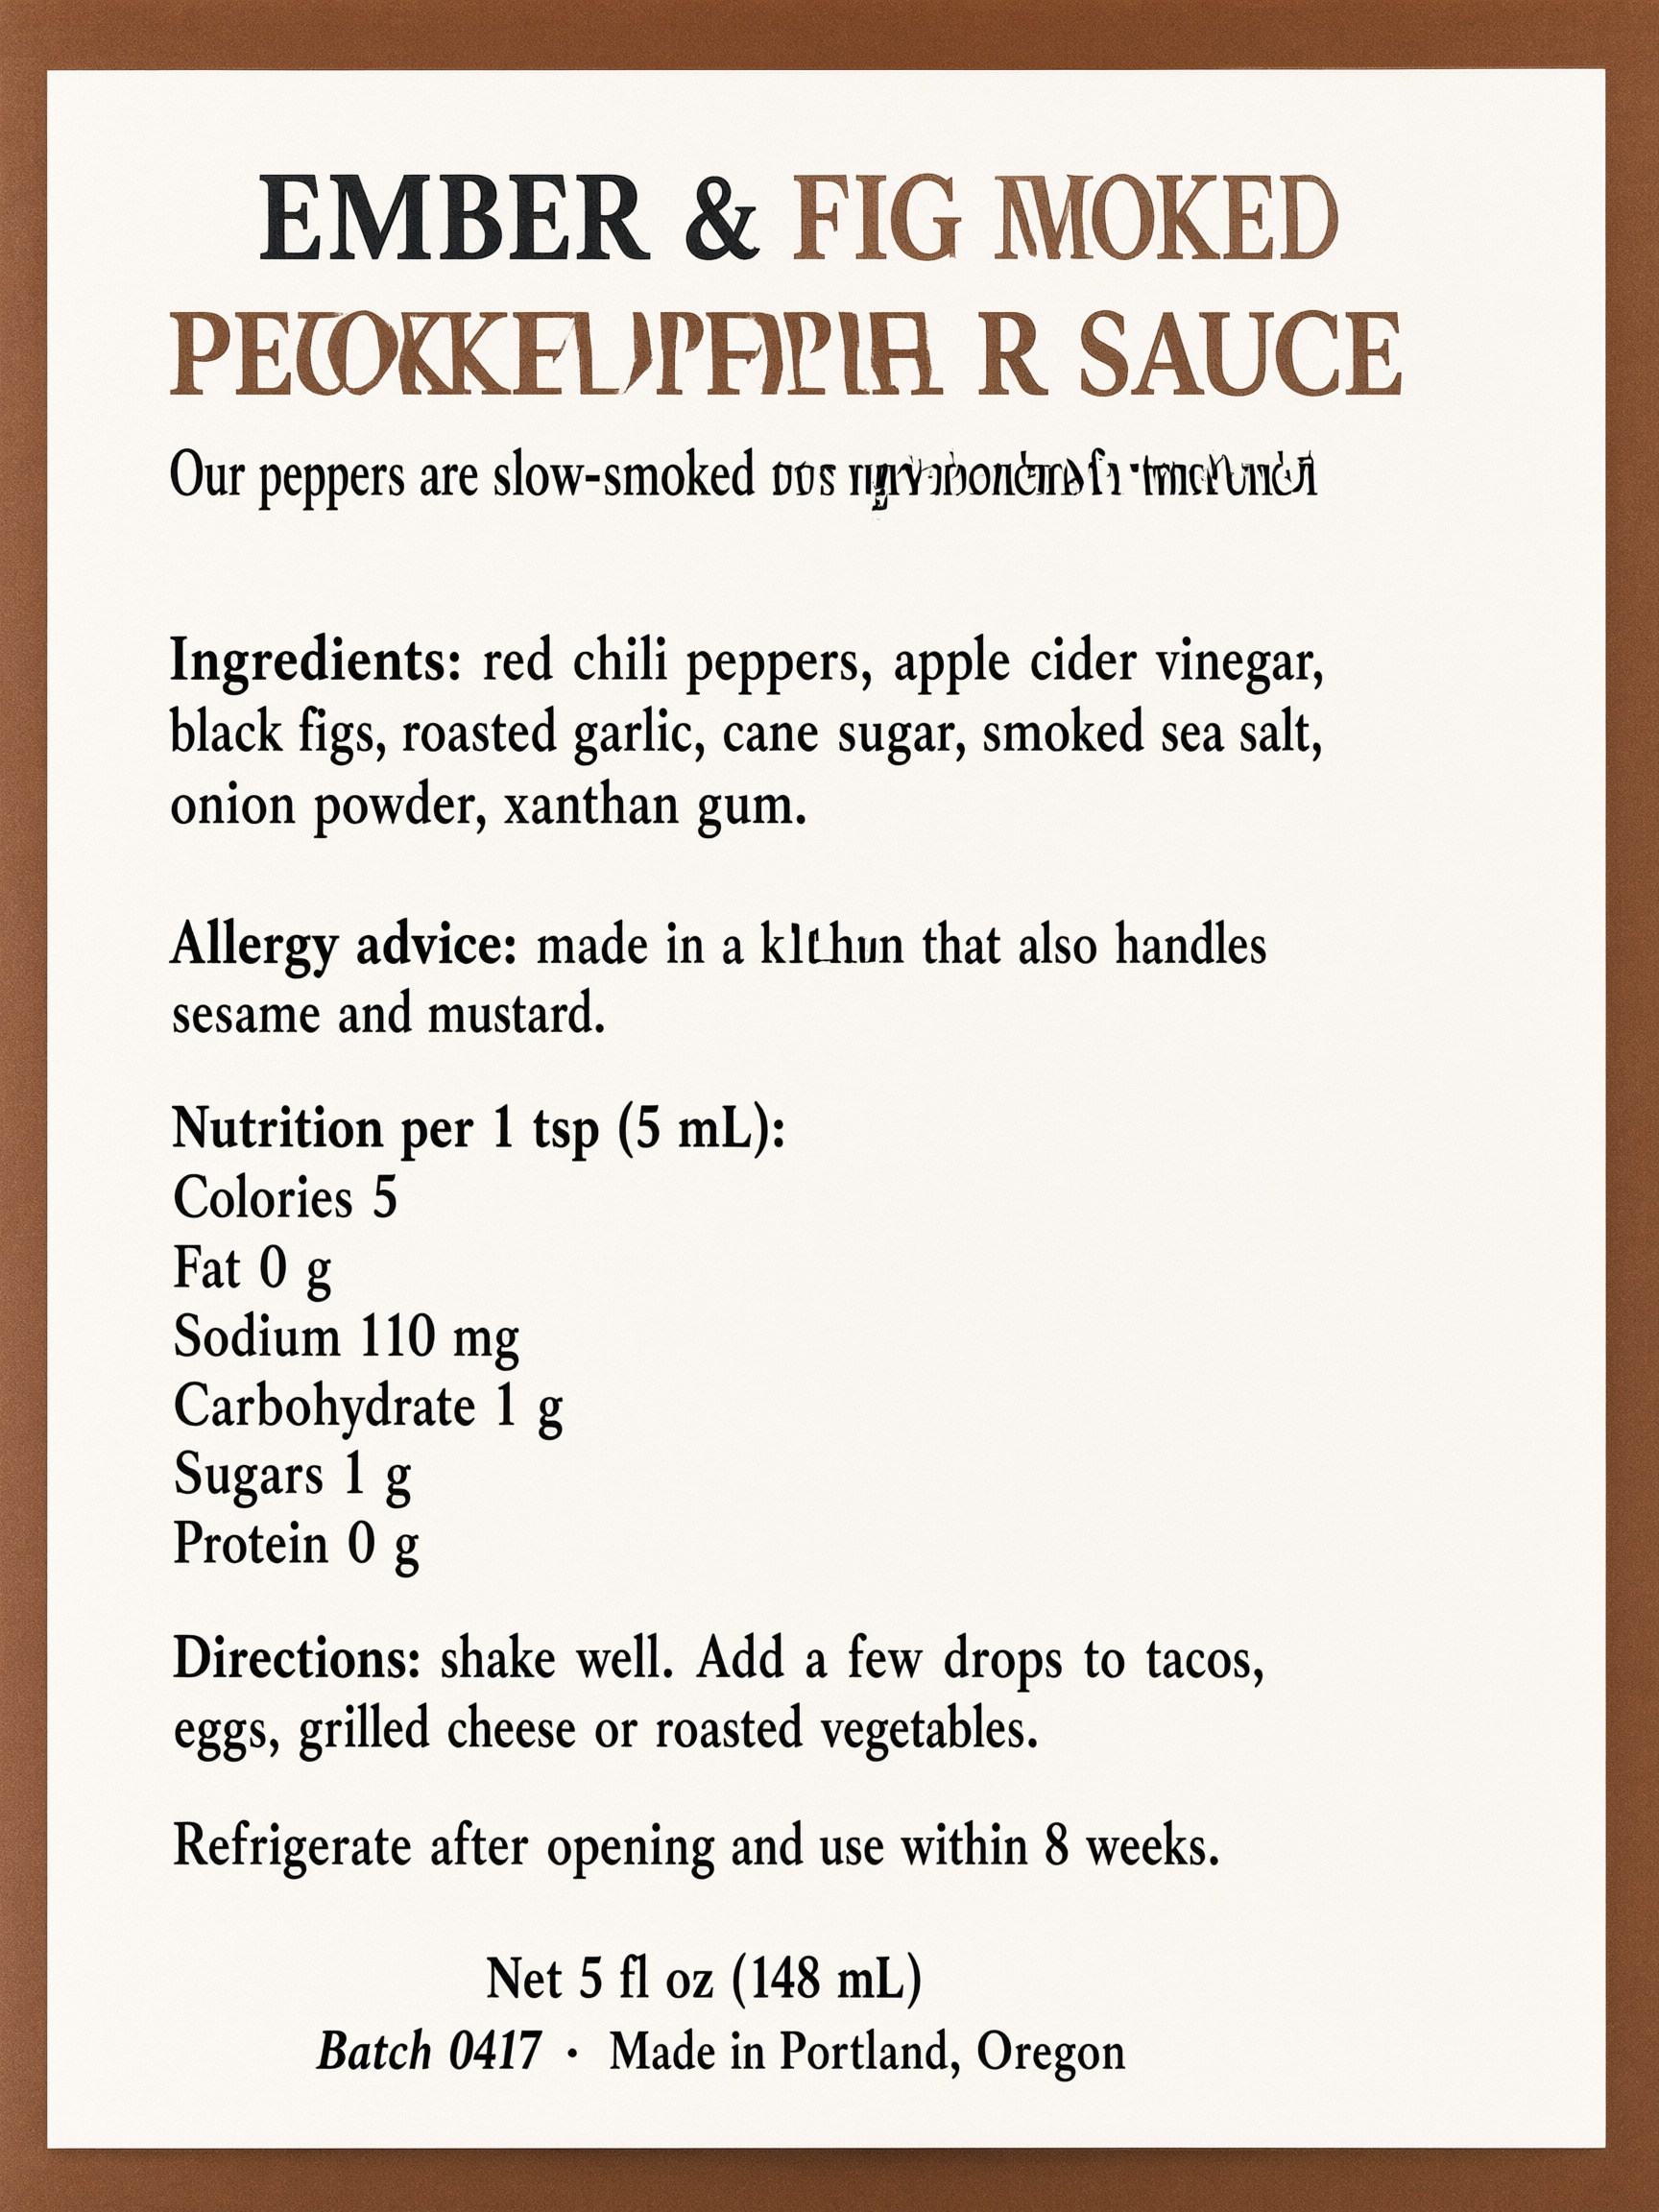
Qwen Image 3.0 Pro 从 72 个英文单词开始出错,117 个英文单词起每张都错。 72 个英文单词时,3 张告示里有 1 张有两句话部分成了乱码。到 117 和 189 个英文单词,6 张全部有错。有的只错一个字母,比如 sesame 成了 seame、mL 成了 nL;但有两张整句化掉了:
不是提示词被截断造成的
第 4、5 题是全部题目里最长的两条提示词,878 和 1,206 个字符。阿里的 Qwen-Image API 参考写着早先的 Qwen-Image 模型最多接收 800 或 1,300 token,超出部分会被截掉;Qwen Image 3.0 API 参考建议最长 4,500 token。我们的提示词都在这些上限以内,但我们还是查了截断能不能解释这些错。如果提示词结尾被丢掉,图上最后几行就会没有。实际上没有缺:6 张图最后几行都在(背标上的批号、信末的署名),错都在文字中段。
在 DIY 模式下,FontVibe 会把你的提示词原样发给模型,不做删减、不改写:DIY 输入框最多 4,500 个字符,千问自带的提示词改写也是关掉的。如果你在 FontVibe 上用 Qwen Image 3.0 Pro 写一大段文字,也会遇到这里这类错误。
数字、生造词、重音字母和中日文
第 6–10 题各考一类模型没法靠词形猜对的文字。
门票:日期、订单号、网址、电话、邮箱
门票要求 9 行,包括「Order #NLF-48213-QX」「northshorelightfest.com/entry」「+1 (604) 555-0183」和一个邮箱地址。
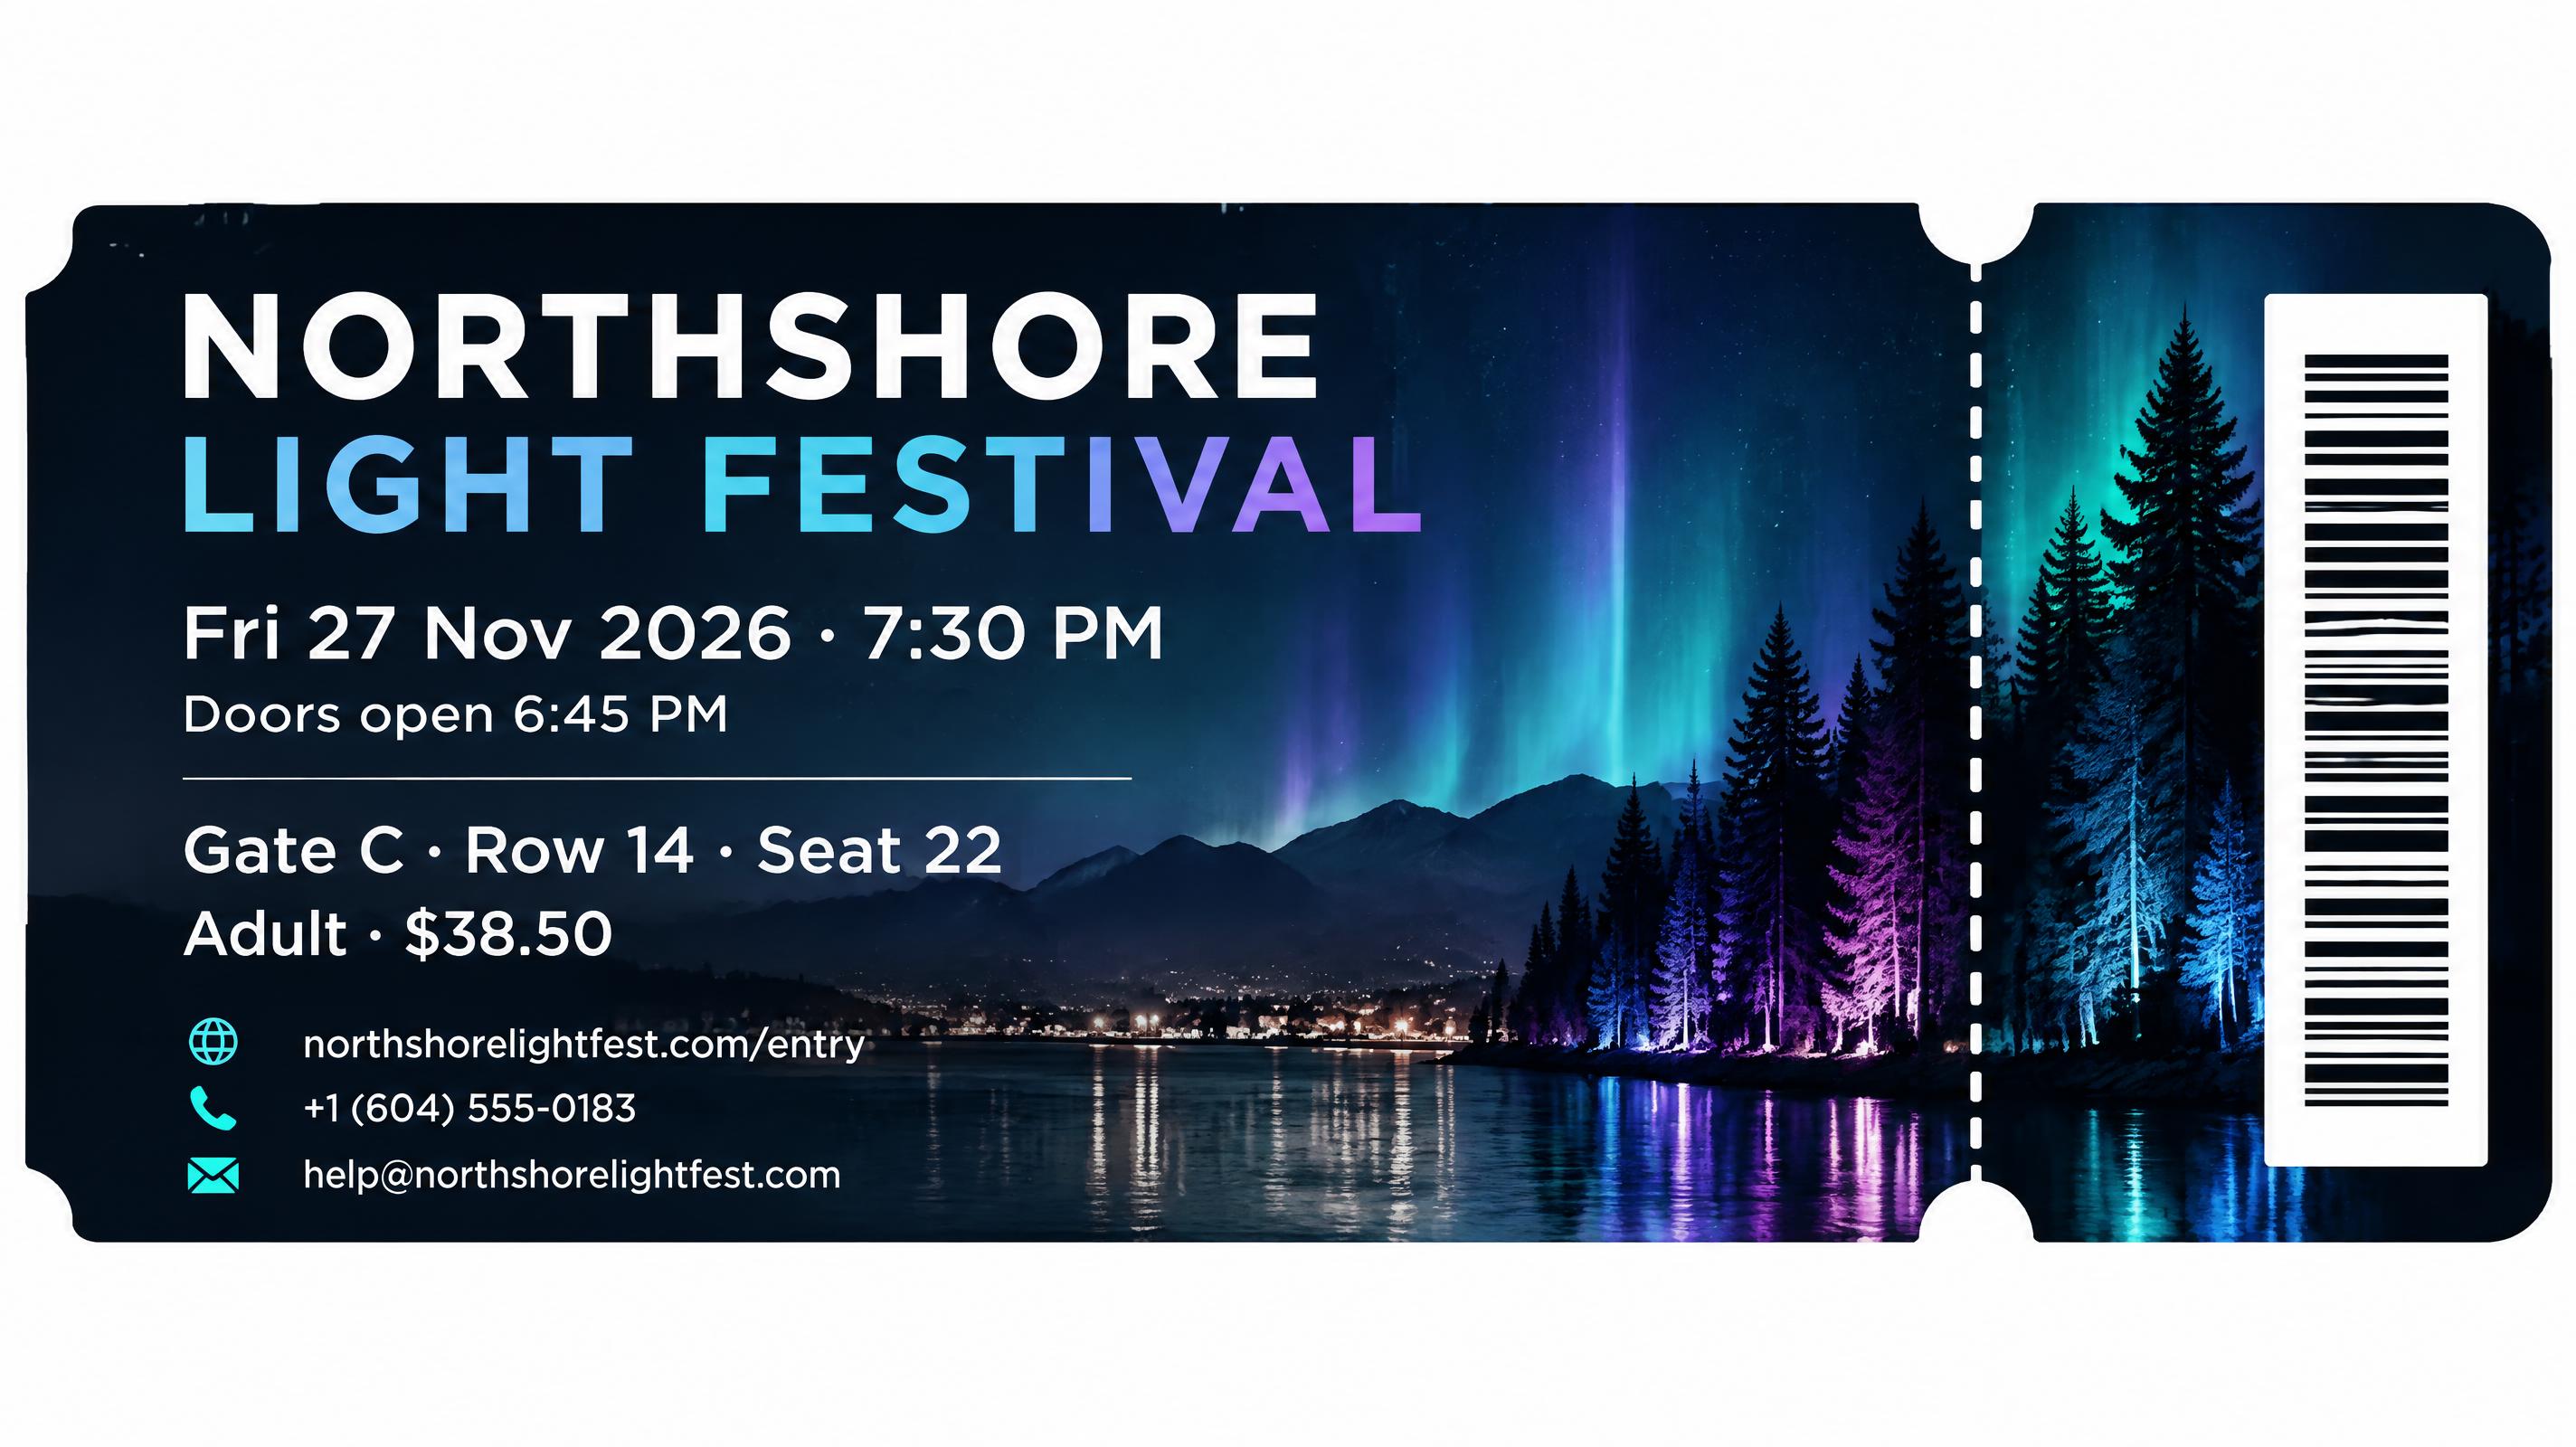
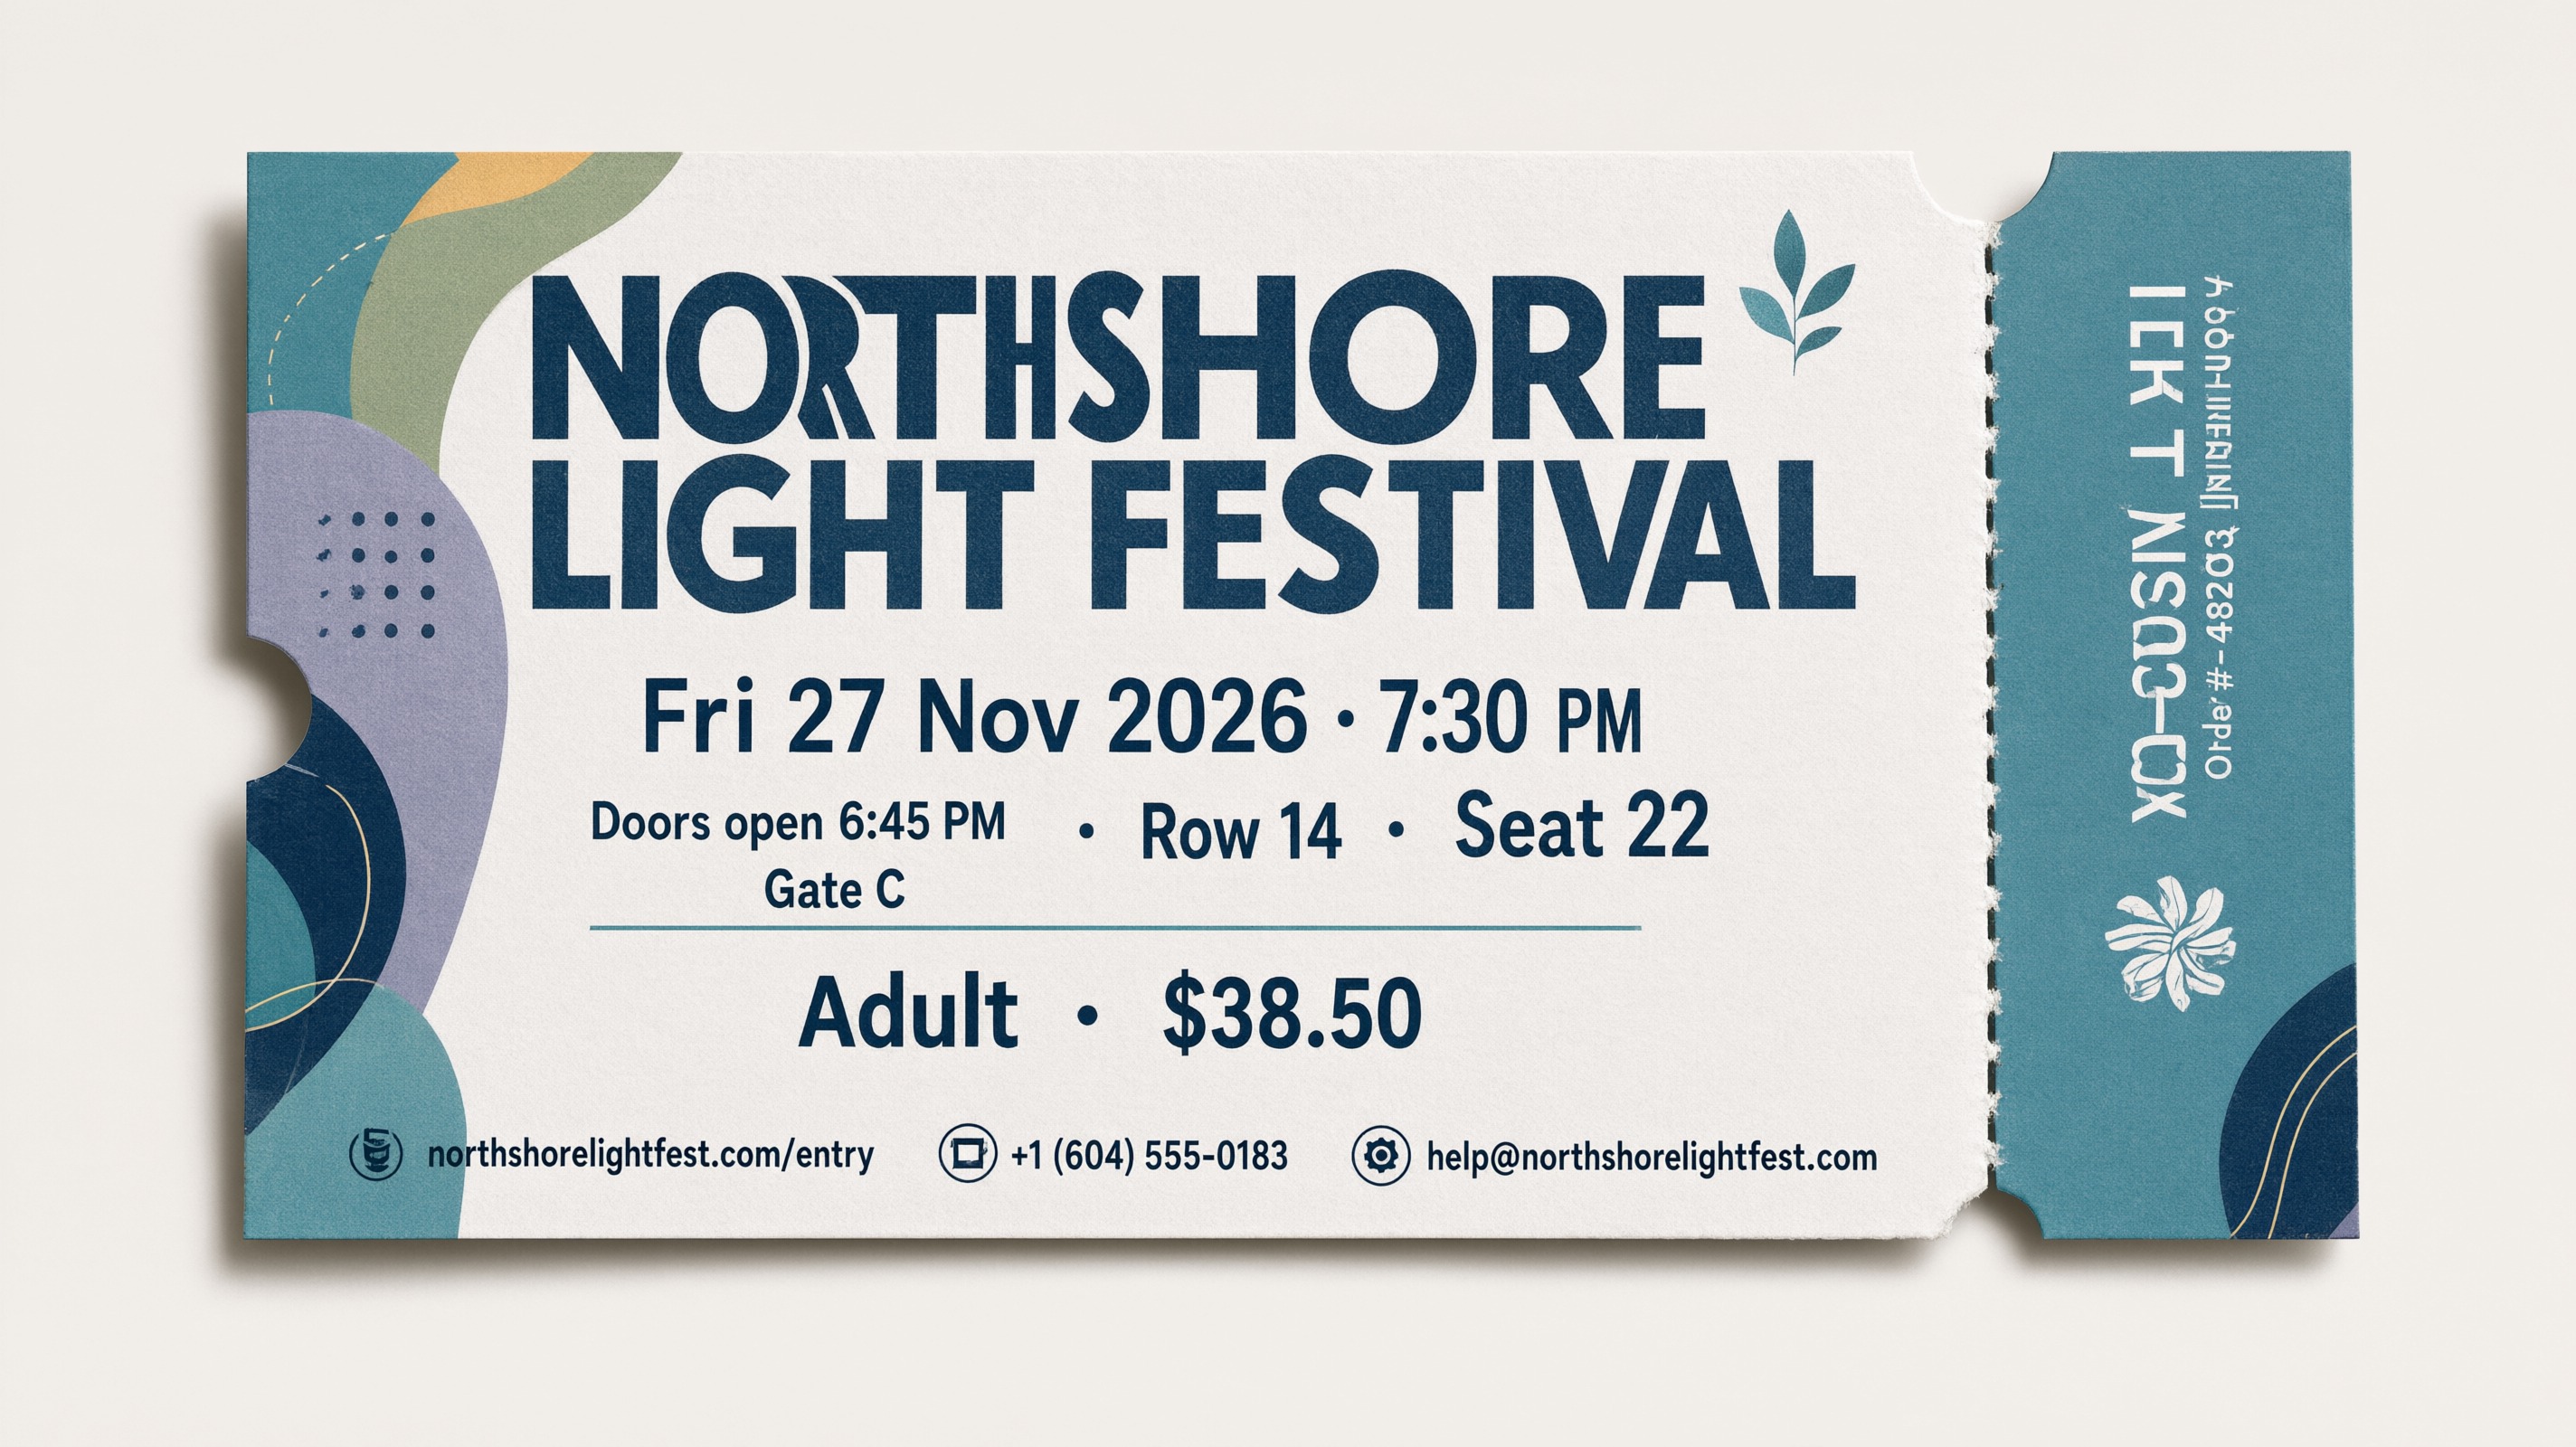
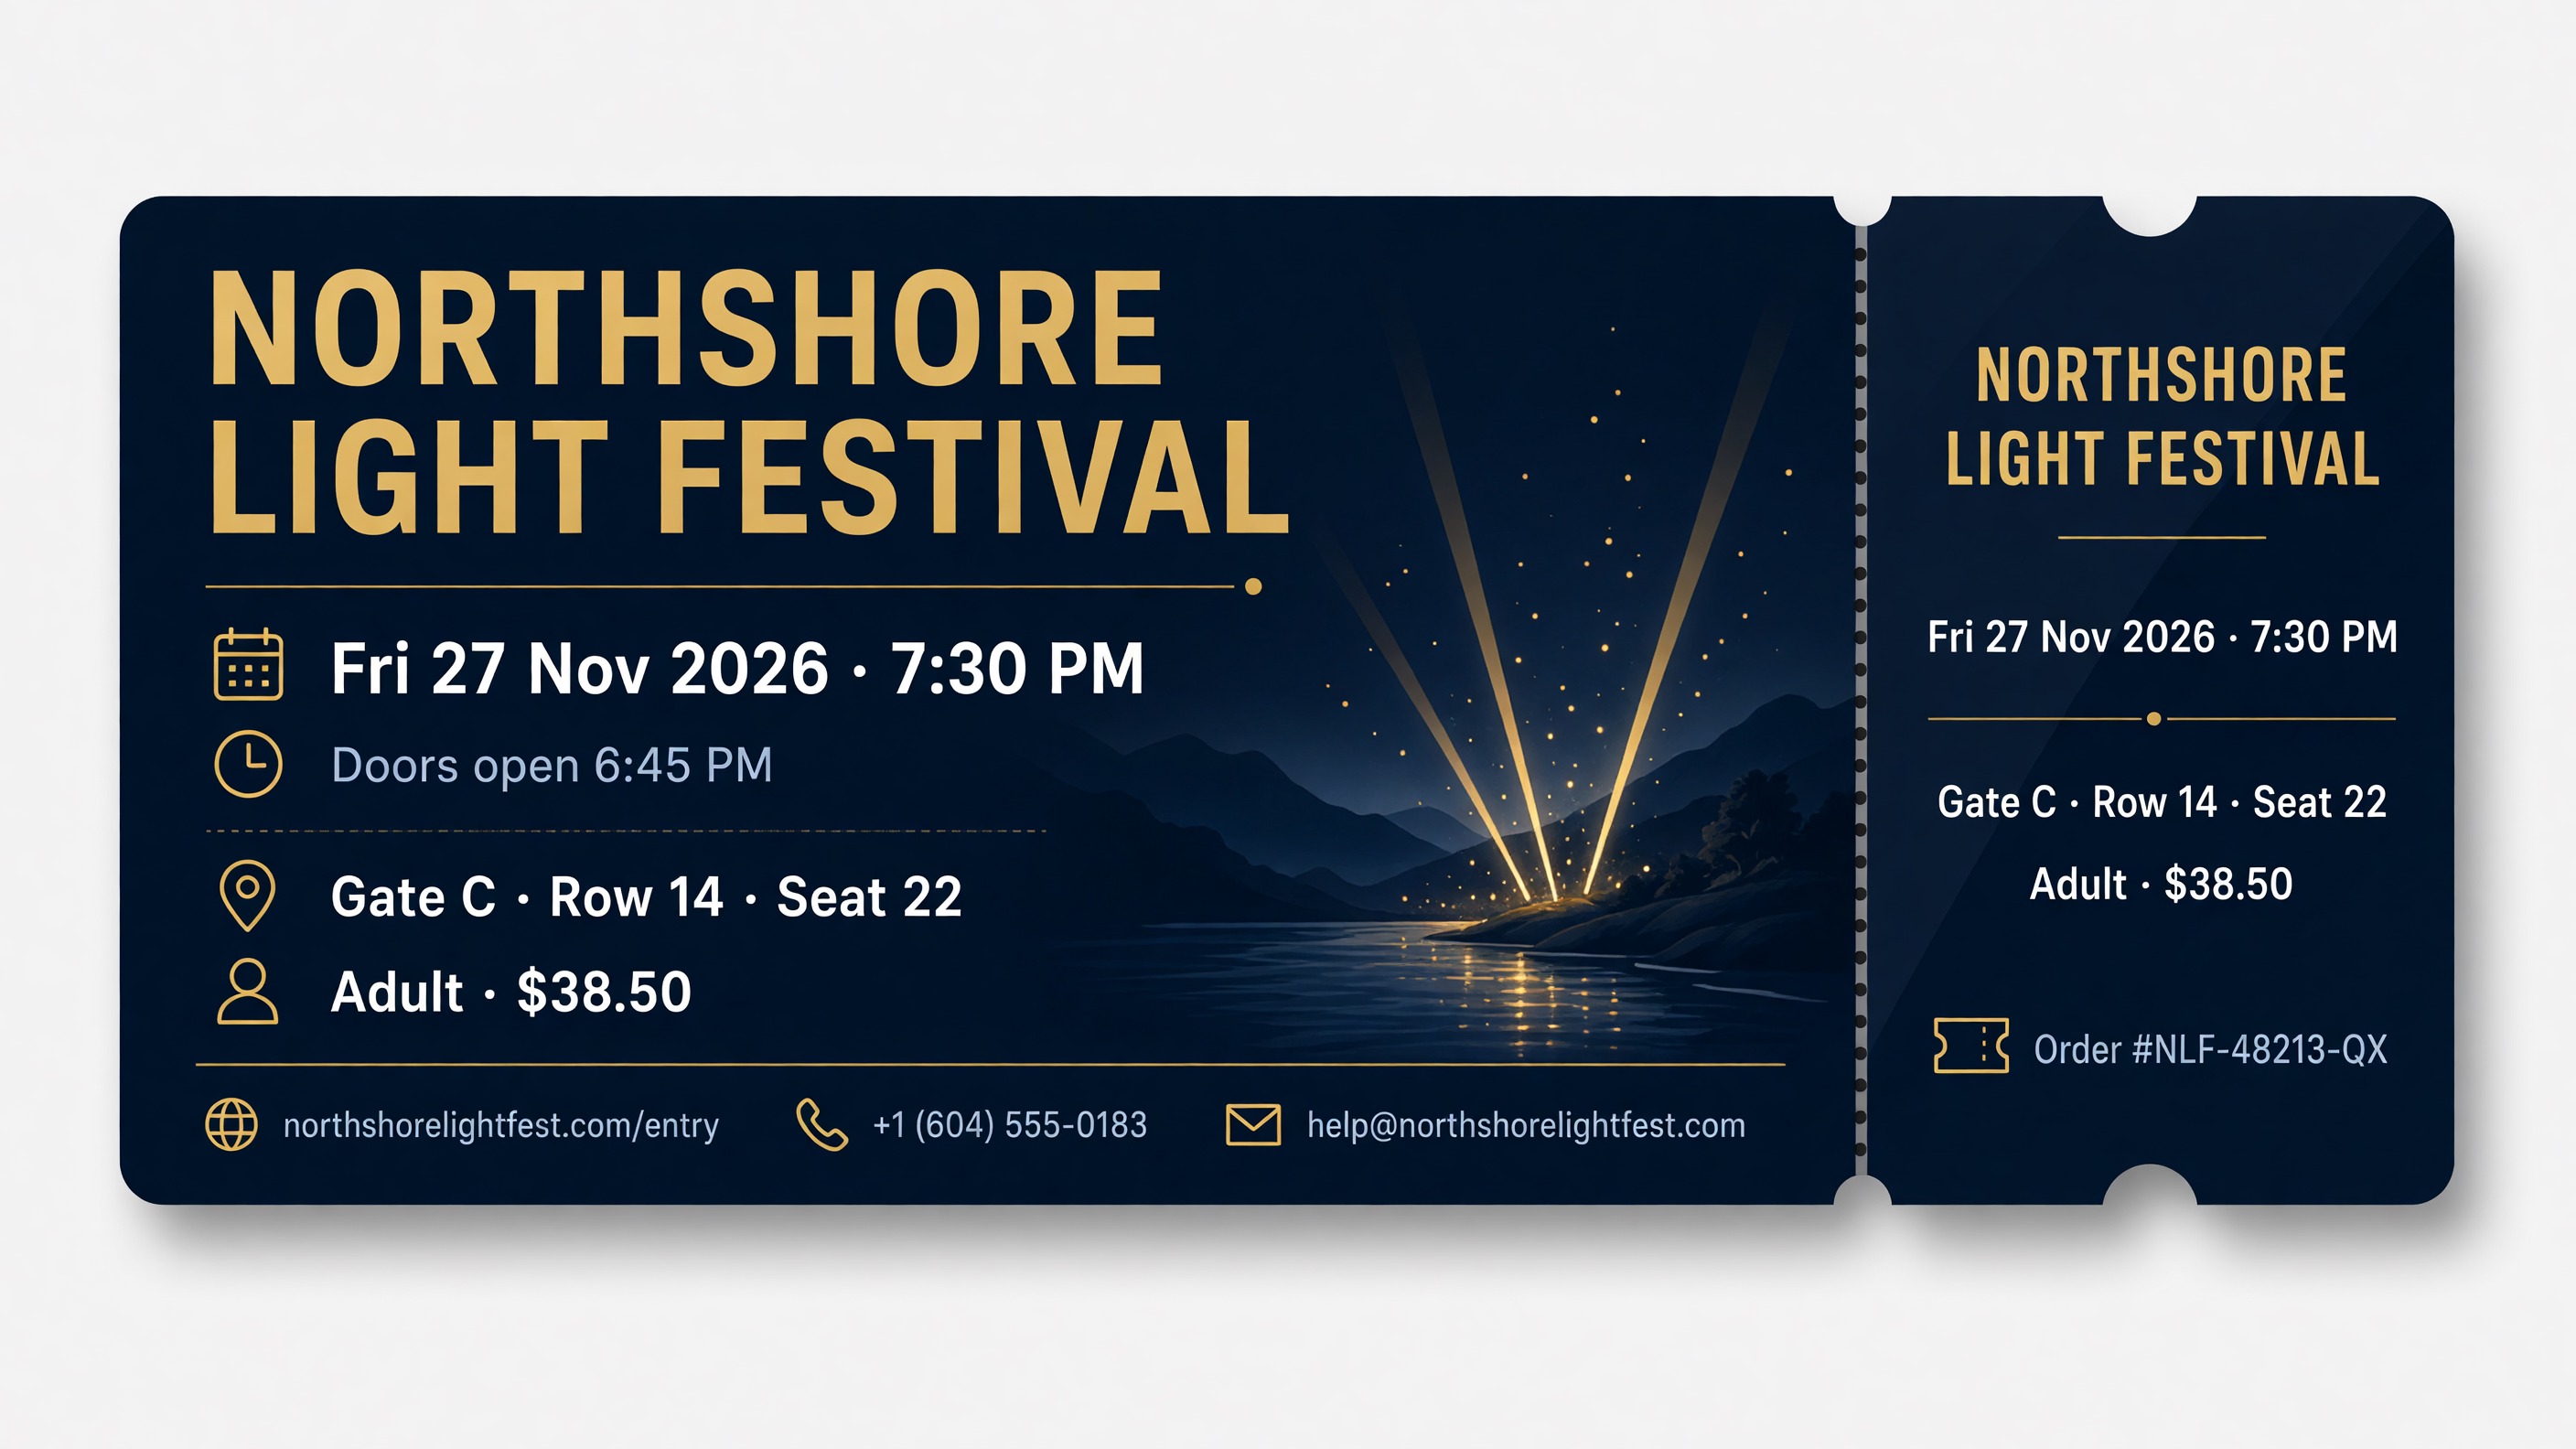
Grok Imagine 2.0、Seedream 5.0 Pro 和 Nano Banana 2.1 的 3 张门票 9 行全对。15 张门票的网址和邮箱全对。出错的都是订单号:字母数字混排、没有规律,GPT Image 2.5 Sunburst 和 Qwen Image 3.0 Pro 都栽在这一行。千问另一张门票 9 行全对,但存根上多了两行认不出的笔画。
价目表:表格里 26 组数字
单车店价目表有 7 行,每行是服务、时长、价格,价格没有规律($18.75、$29.65、$64.25),时长有「2 hr 15 min」这种写法。写错一个字母还能靠词形蒙对,写错一位数字就没有任何东西帮它纠正。
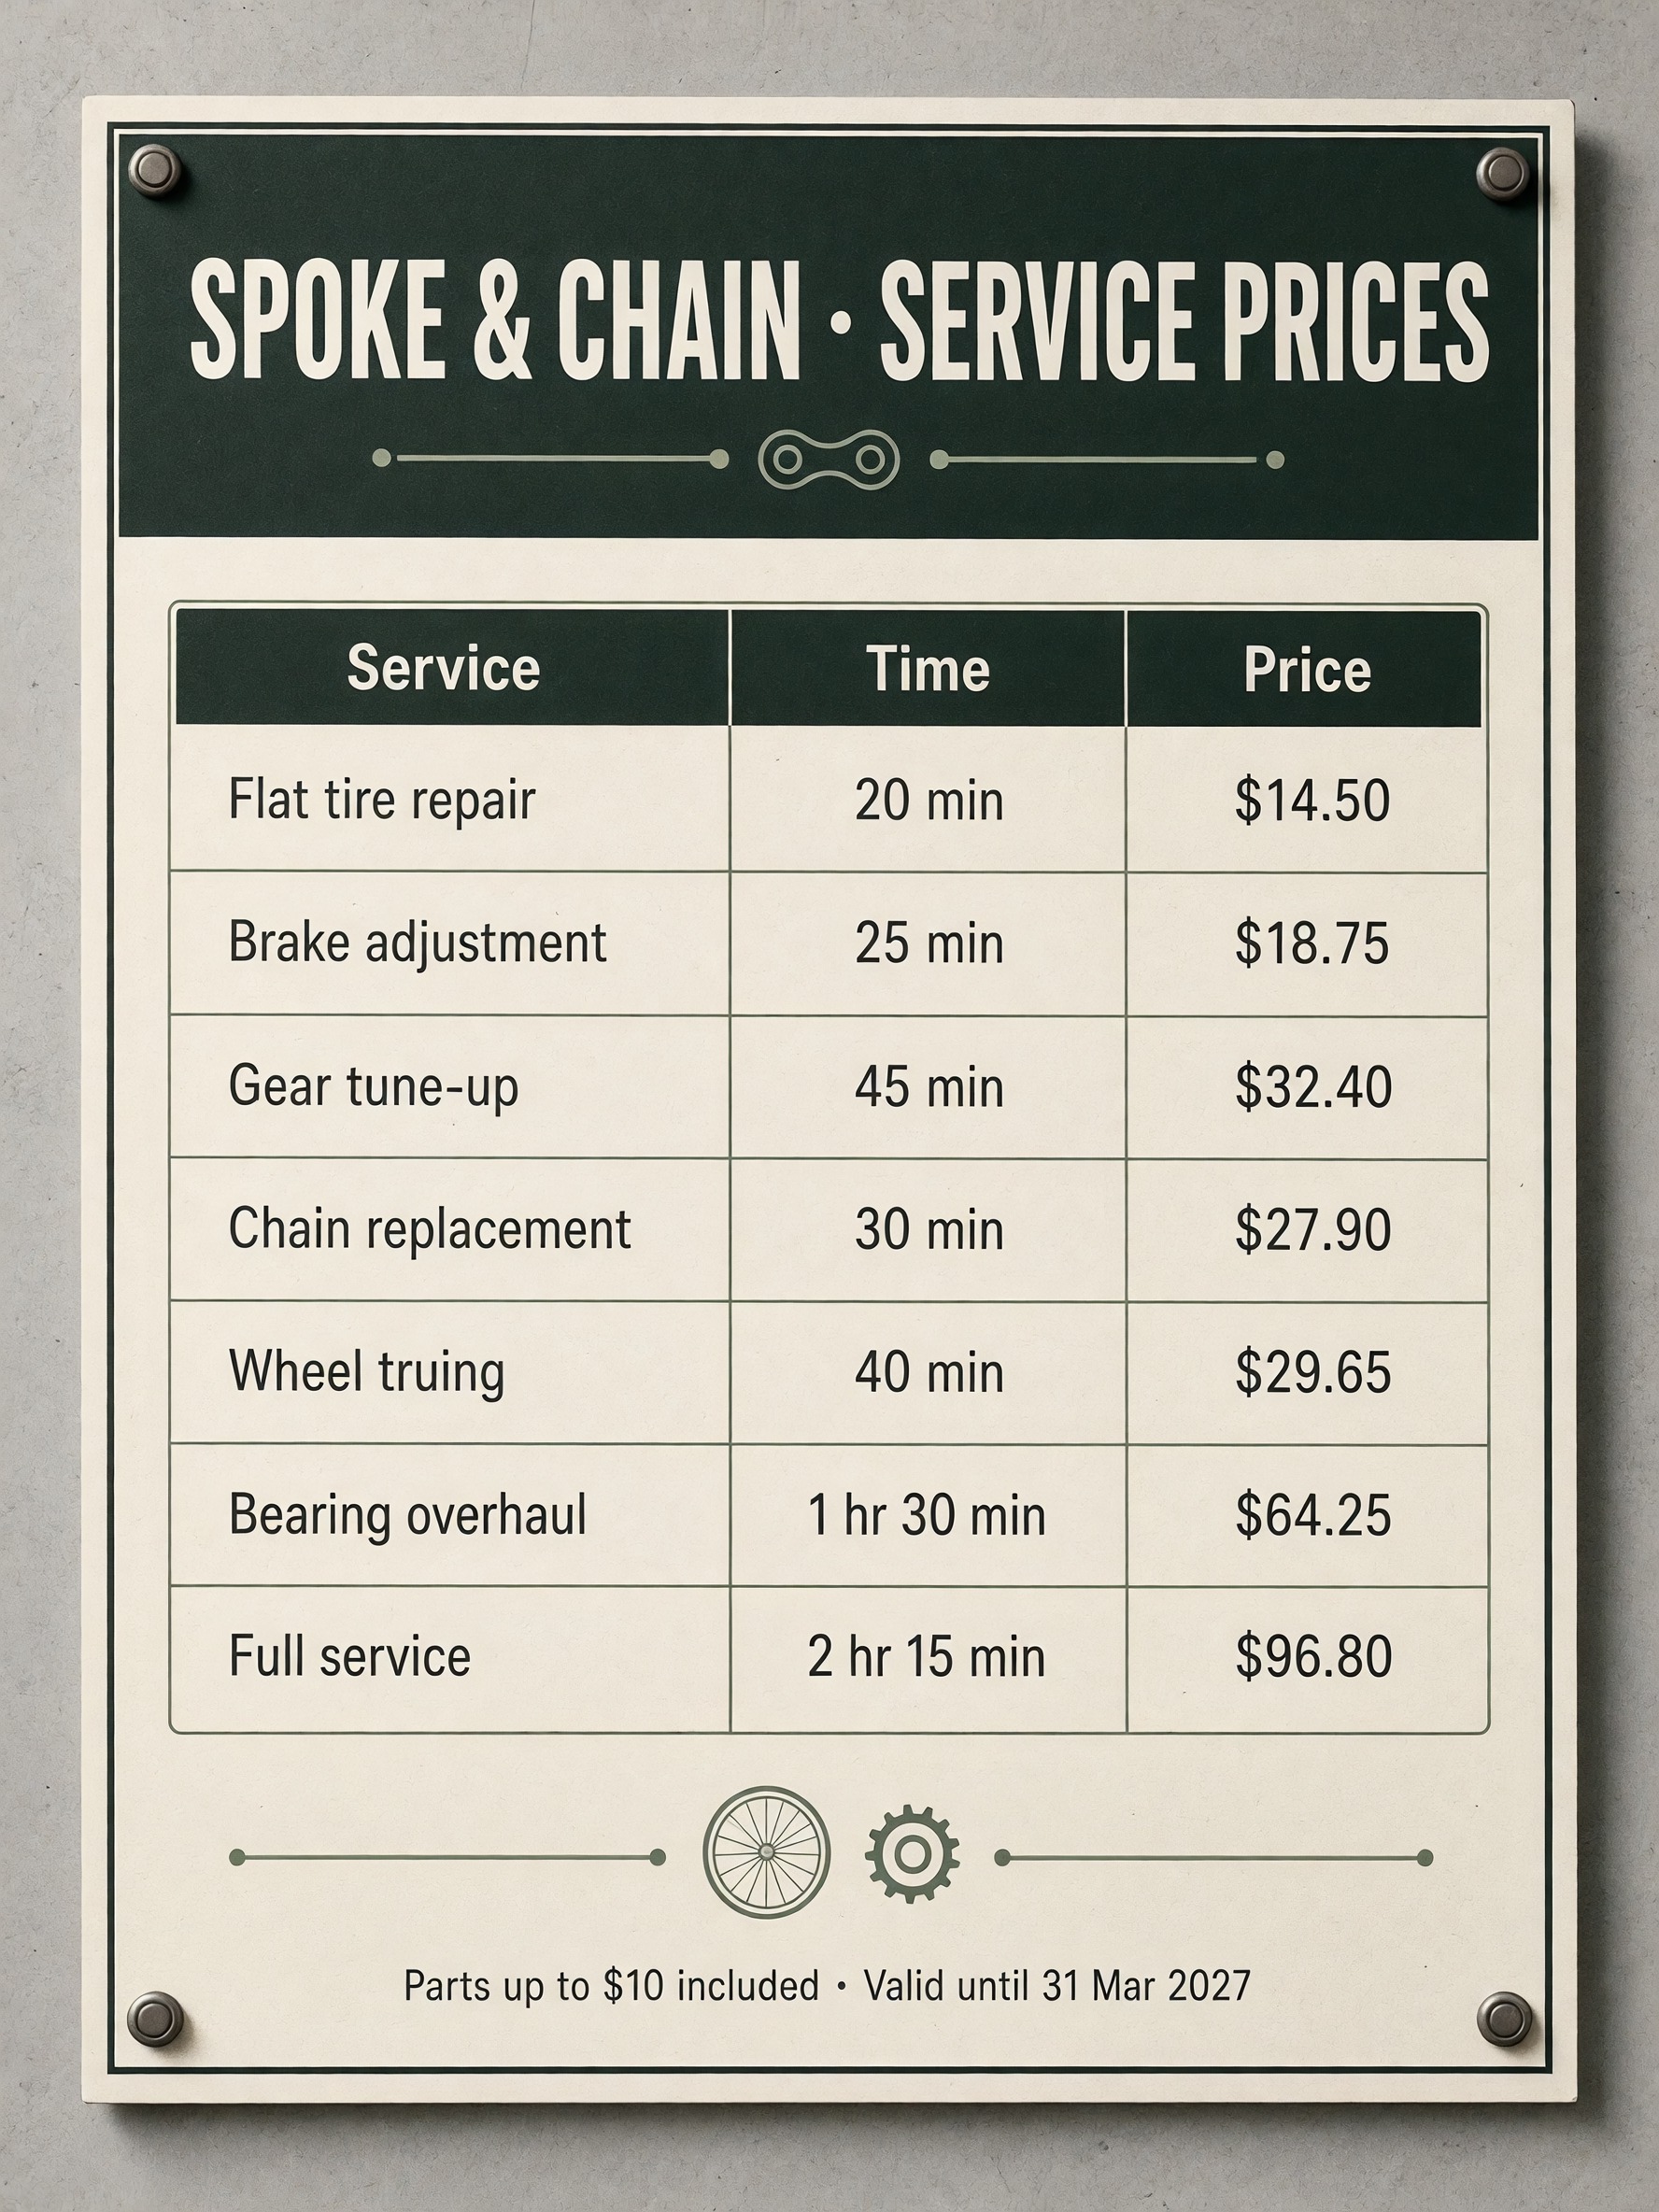
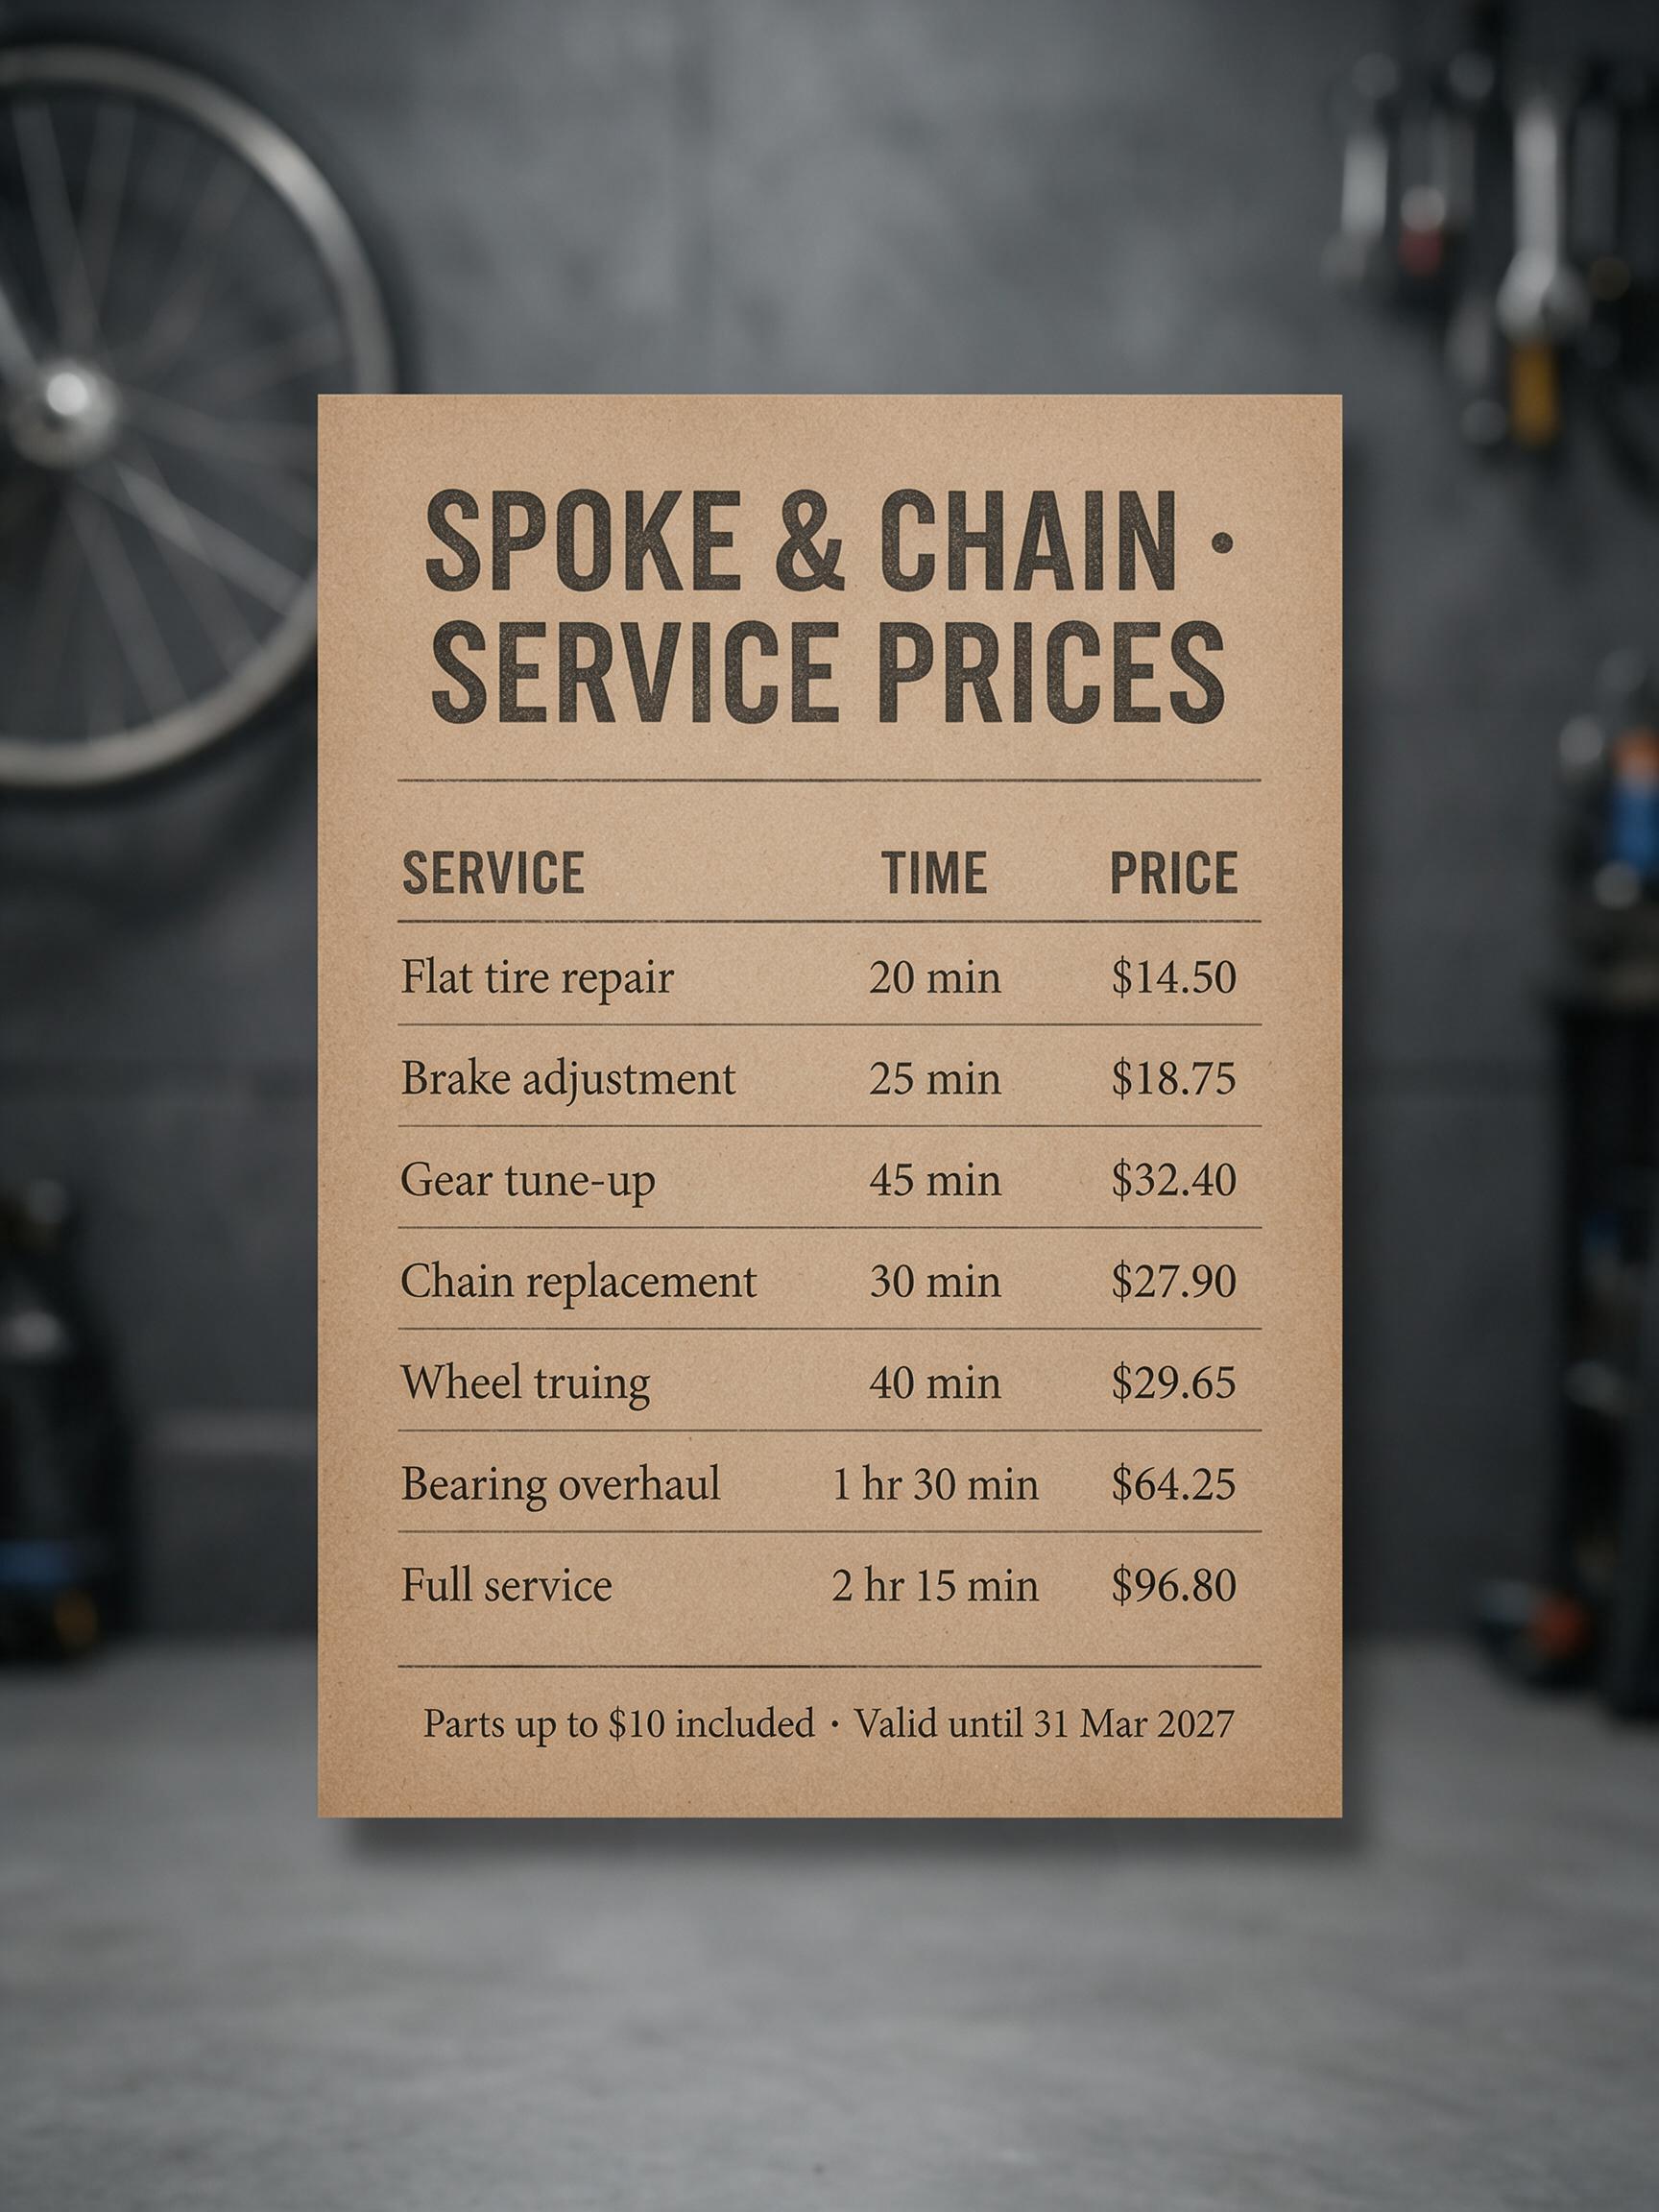
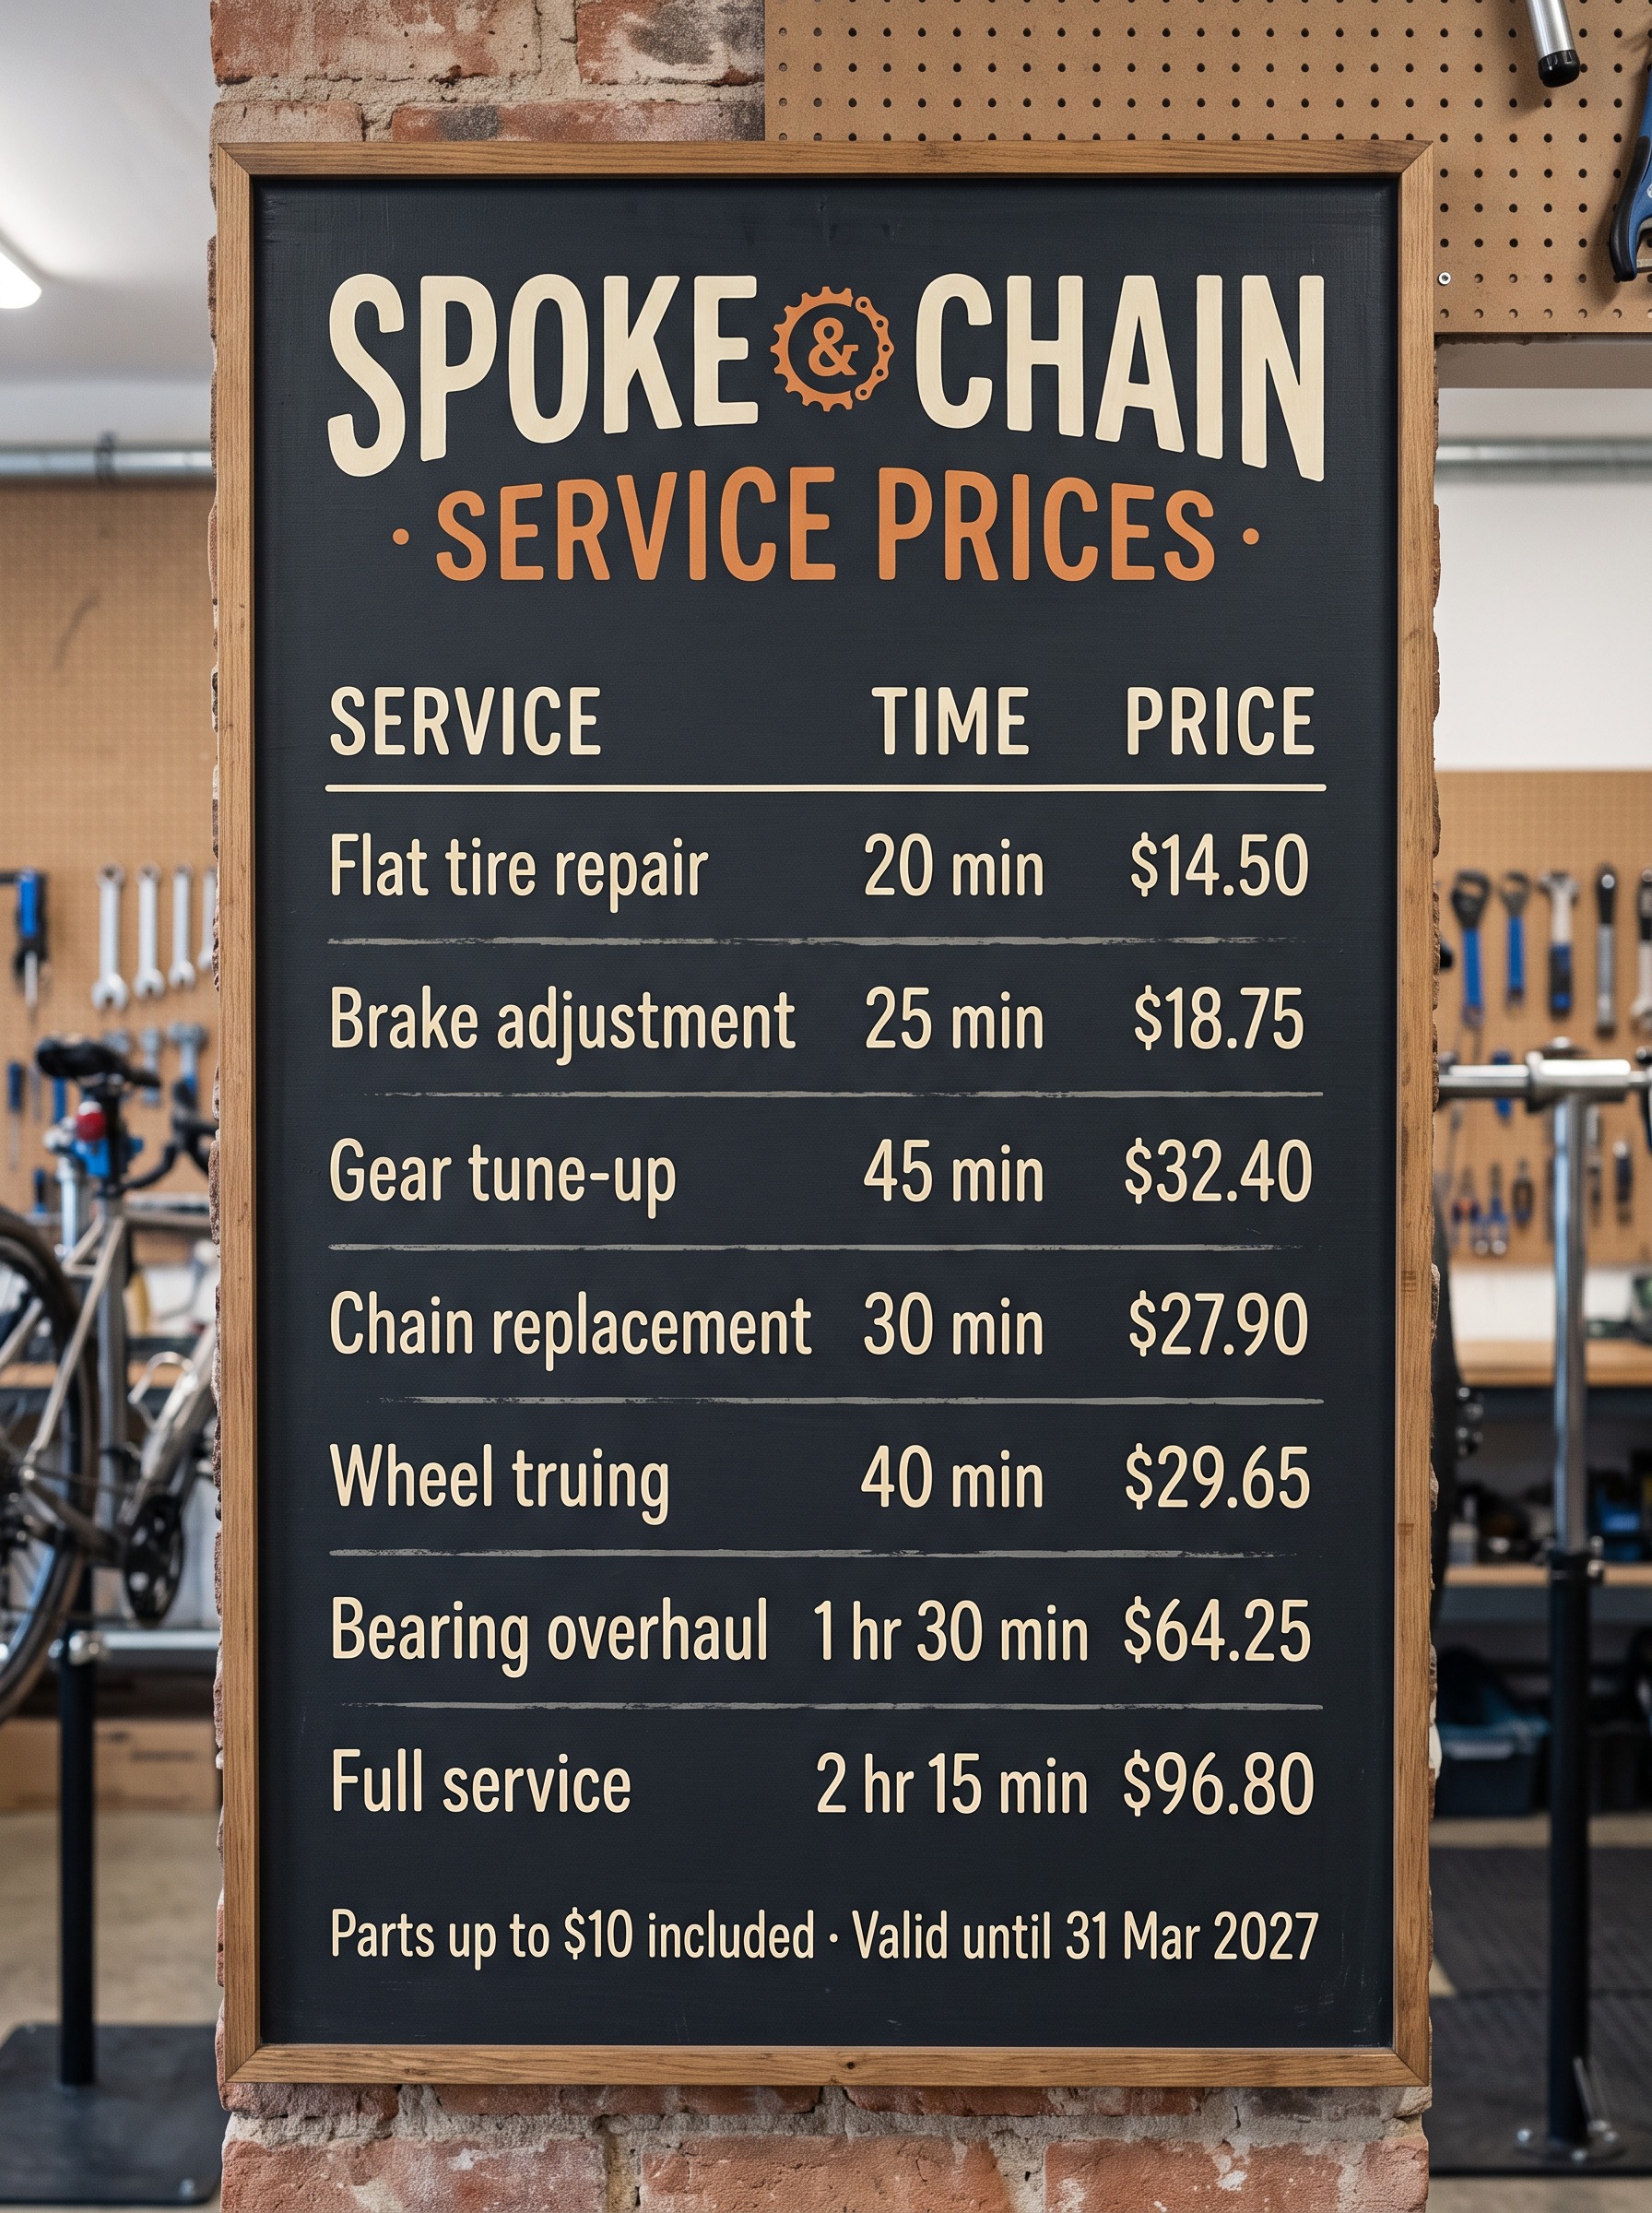
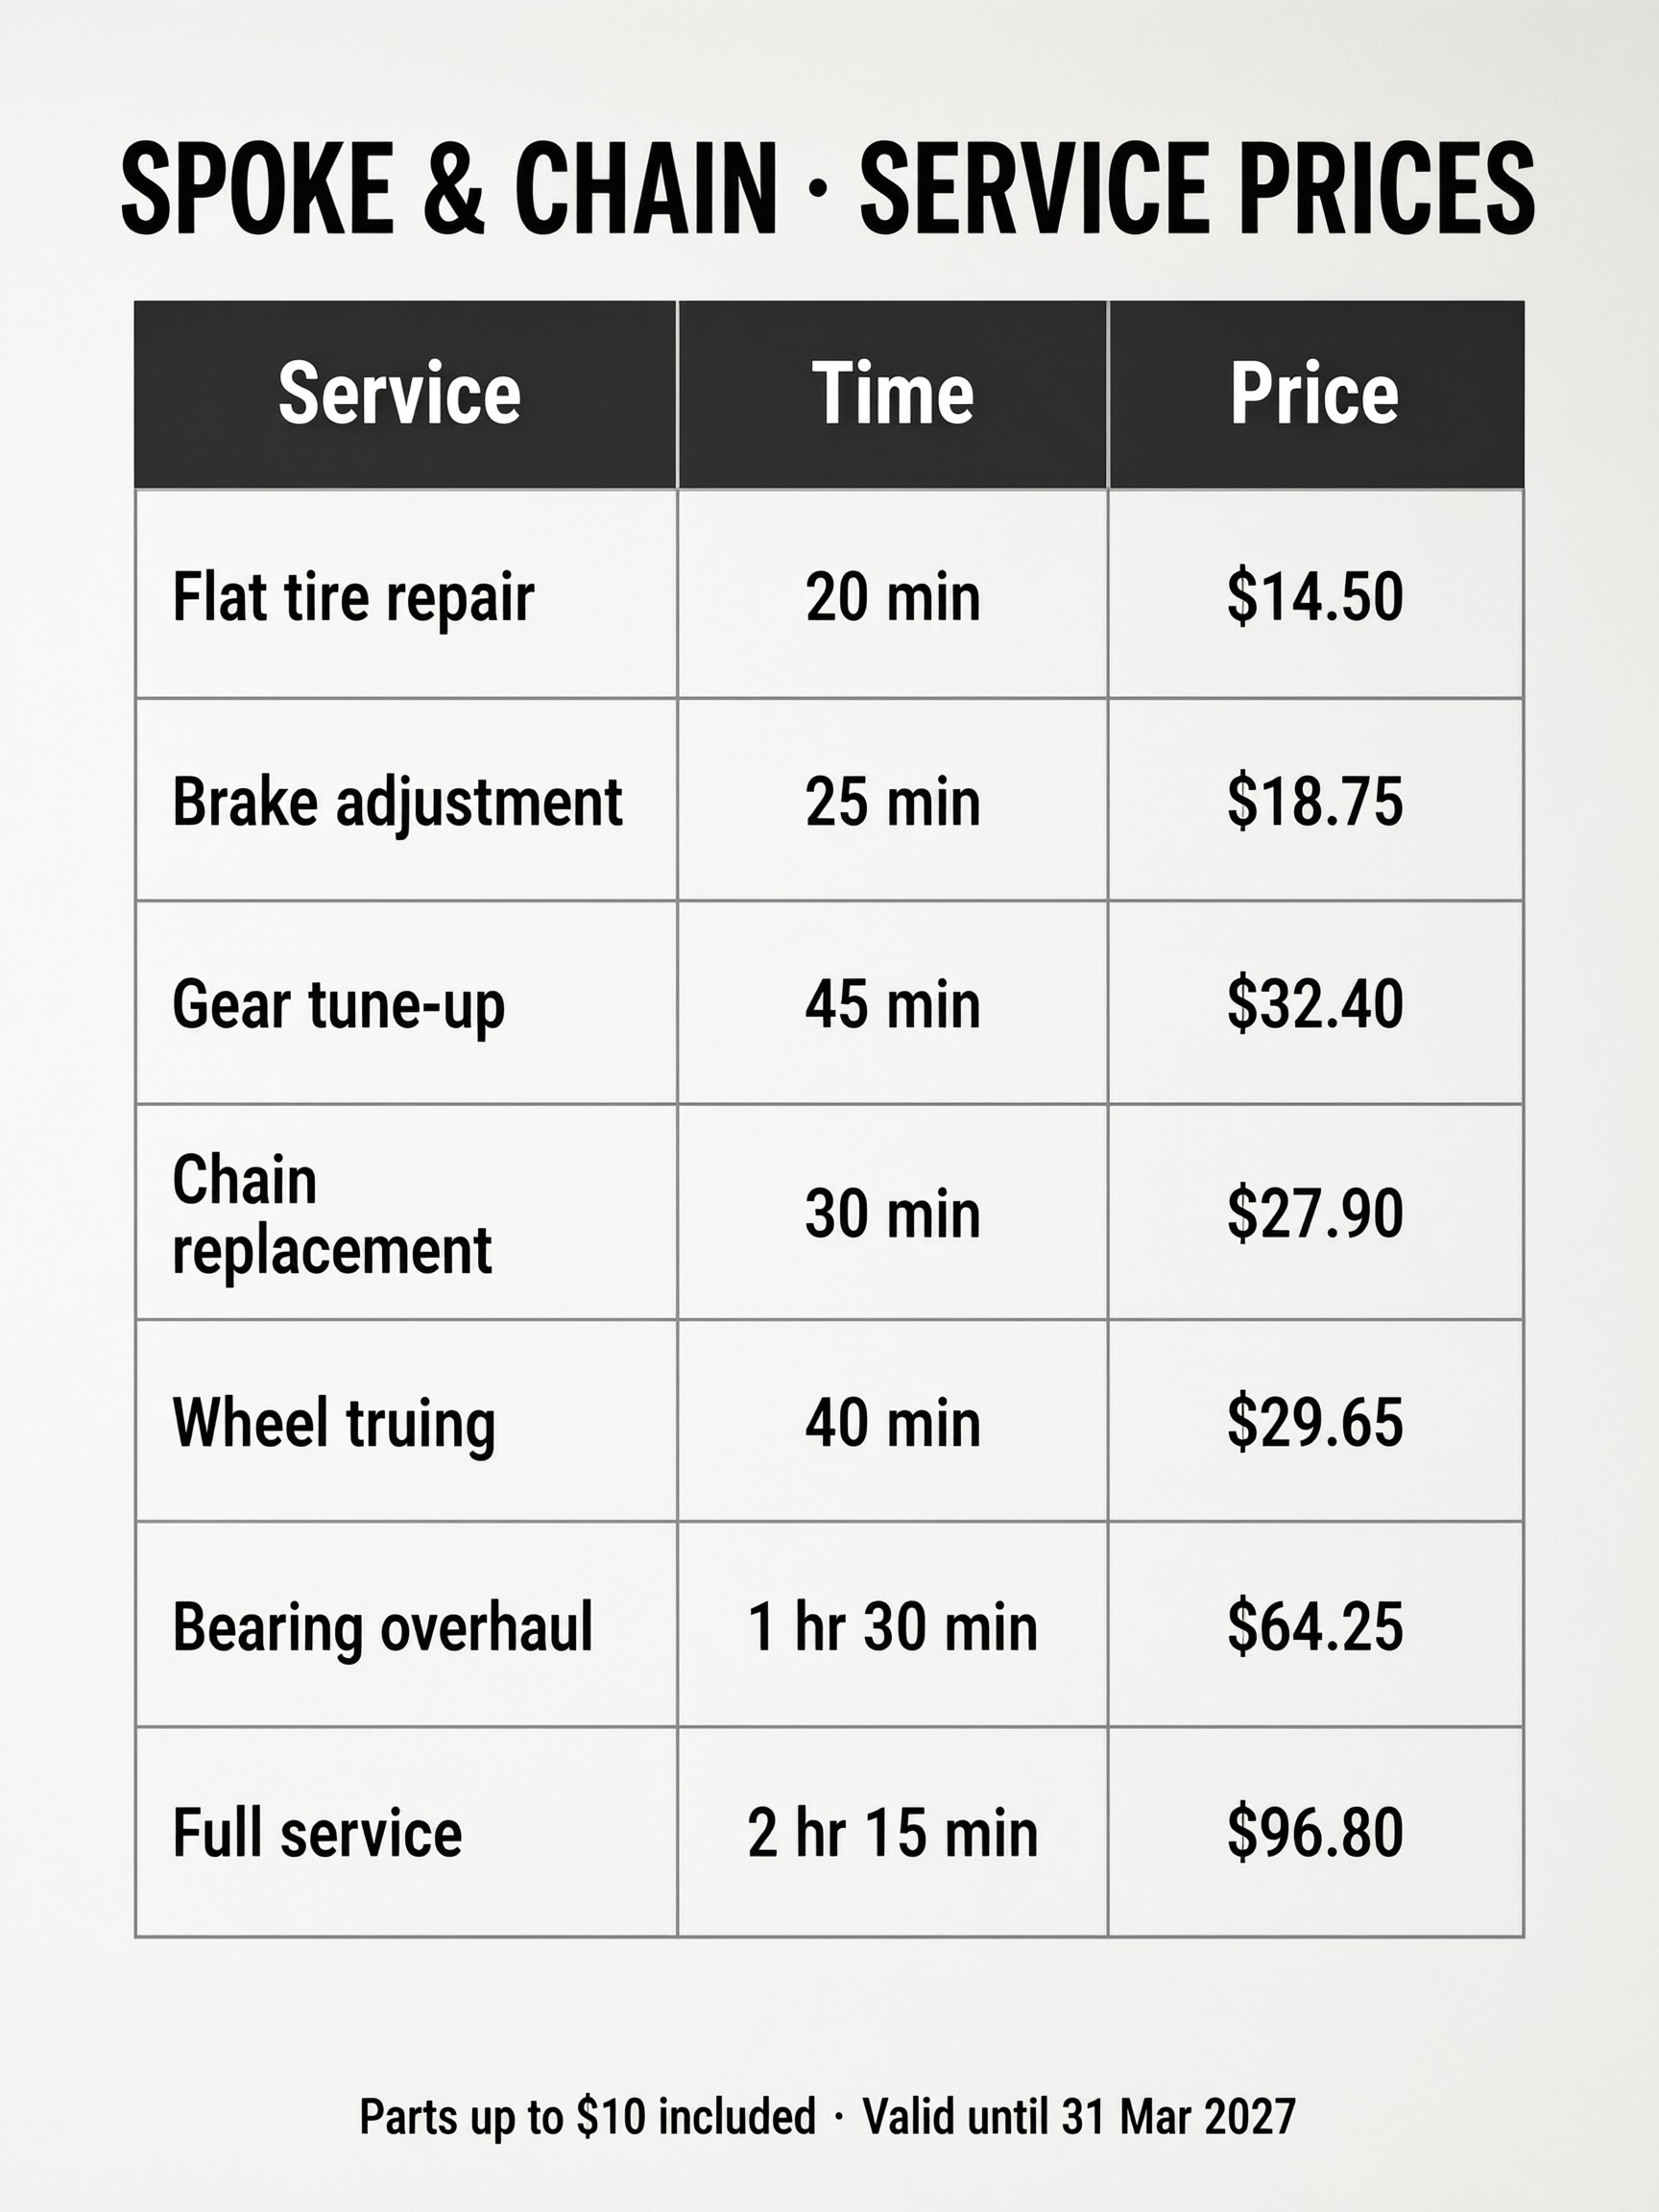
五款模型 15 张全部每行都对,小数点也都对。我们原以为这题能拉开差距,结果没有:这张 60 个英文单词的表格五款都写对了。想直接套用菜单、价目板的效果,可以看粉笔字风格。
生造词
手工皂店货架牌用的是编出来的名字:「BRIMWHISTLE APOTHECARY」「Zarnoveth Clay」「Quillabrine Mint」「Sorvelic Oat Crumble」和「Thornvale」,模型没法把它们往认识的真词上纠正。
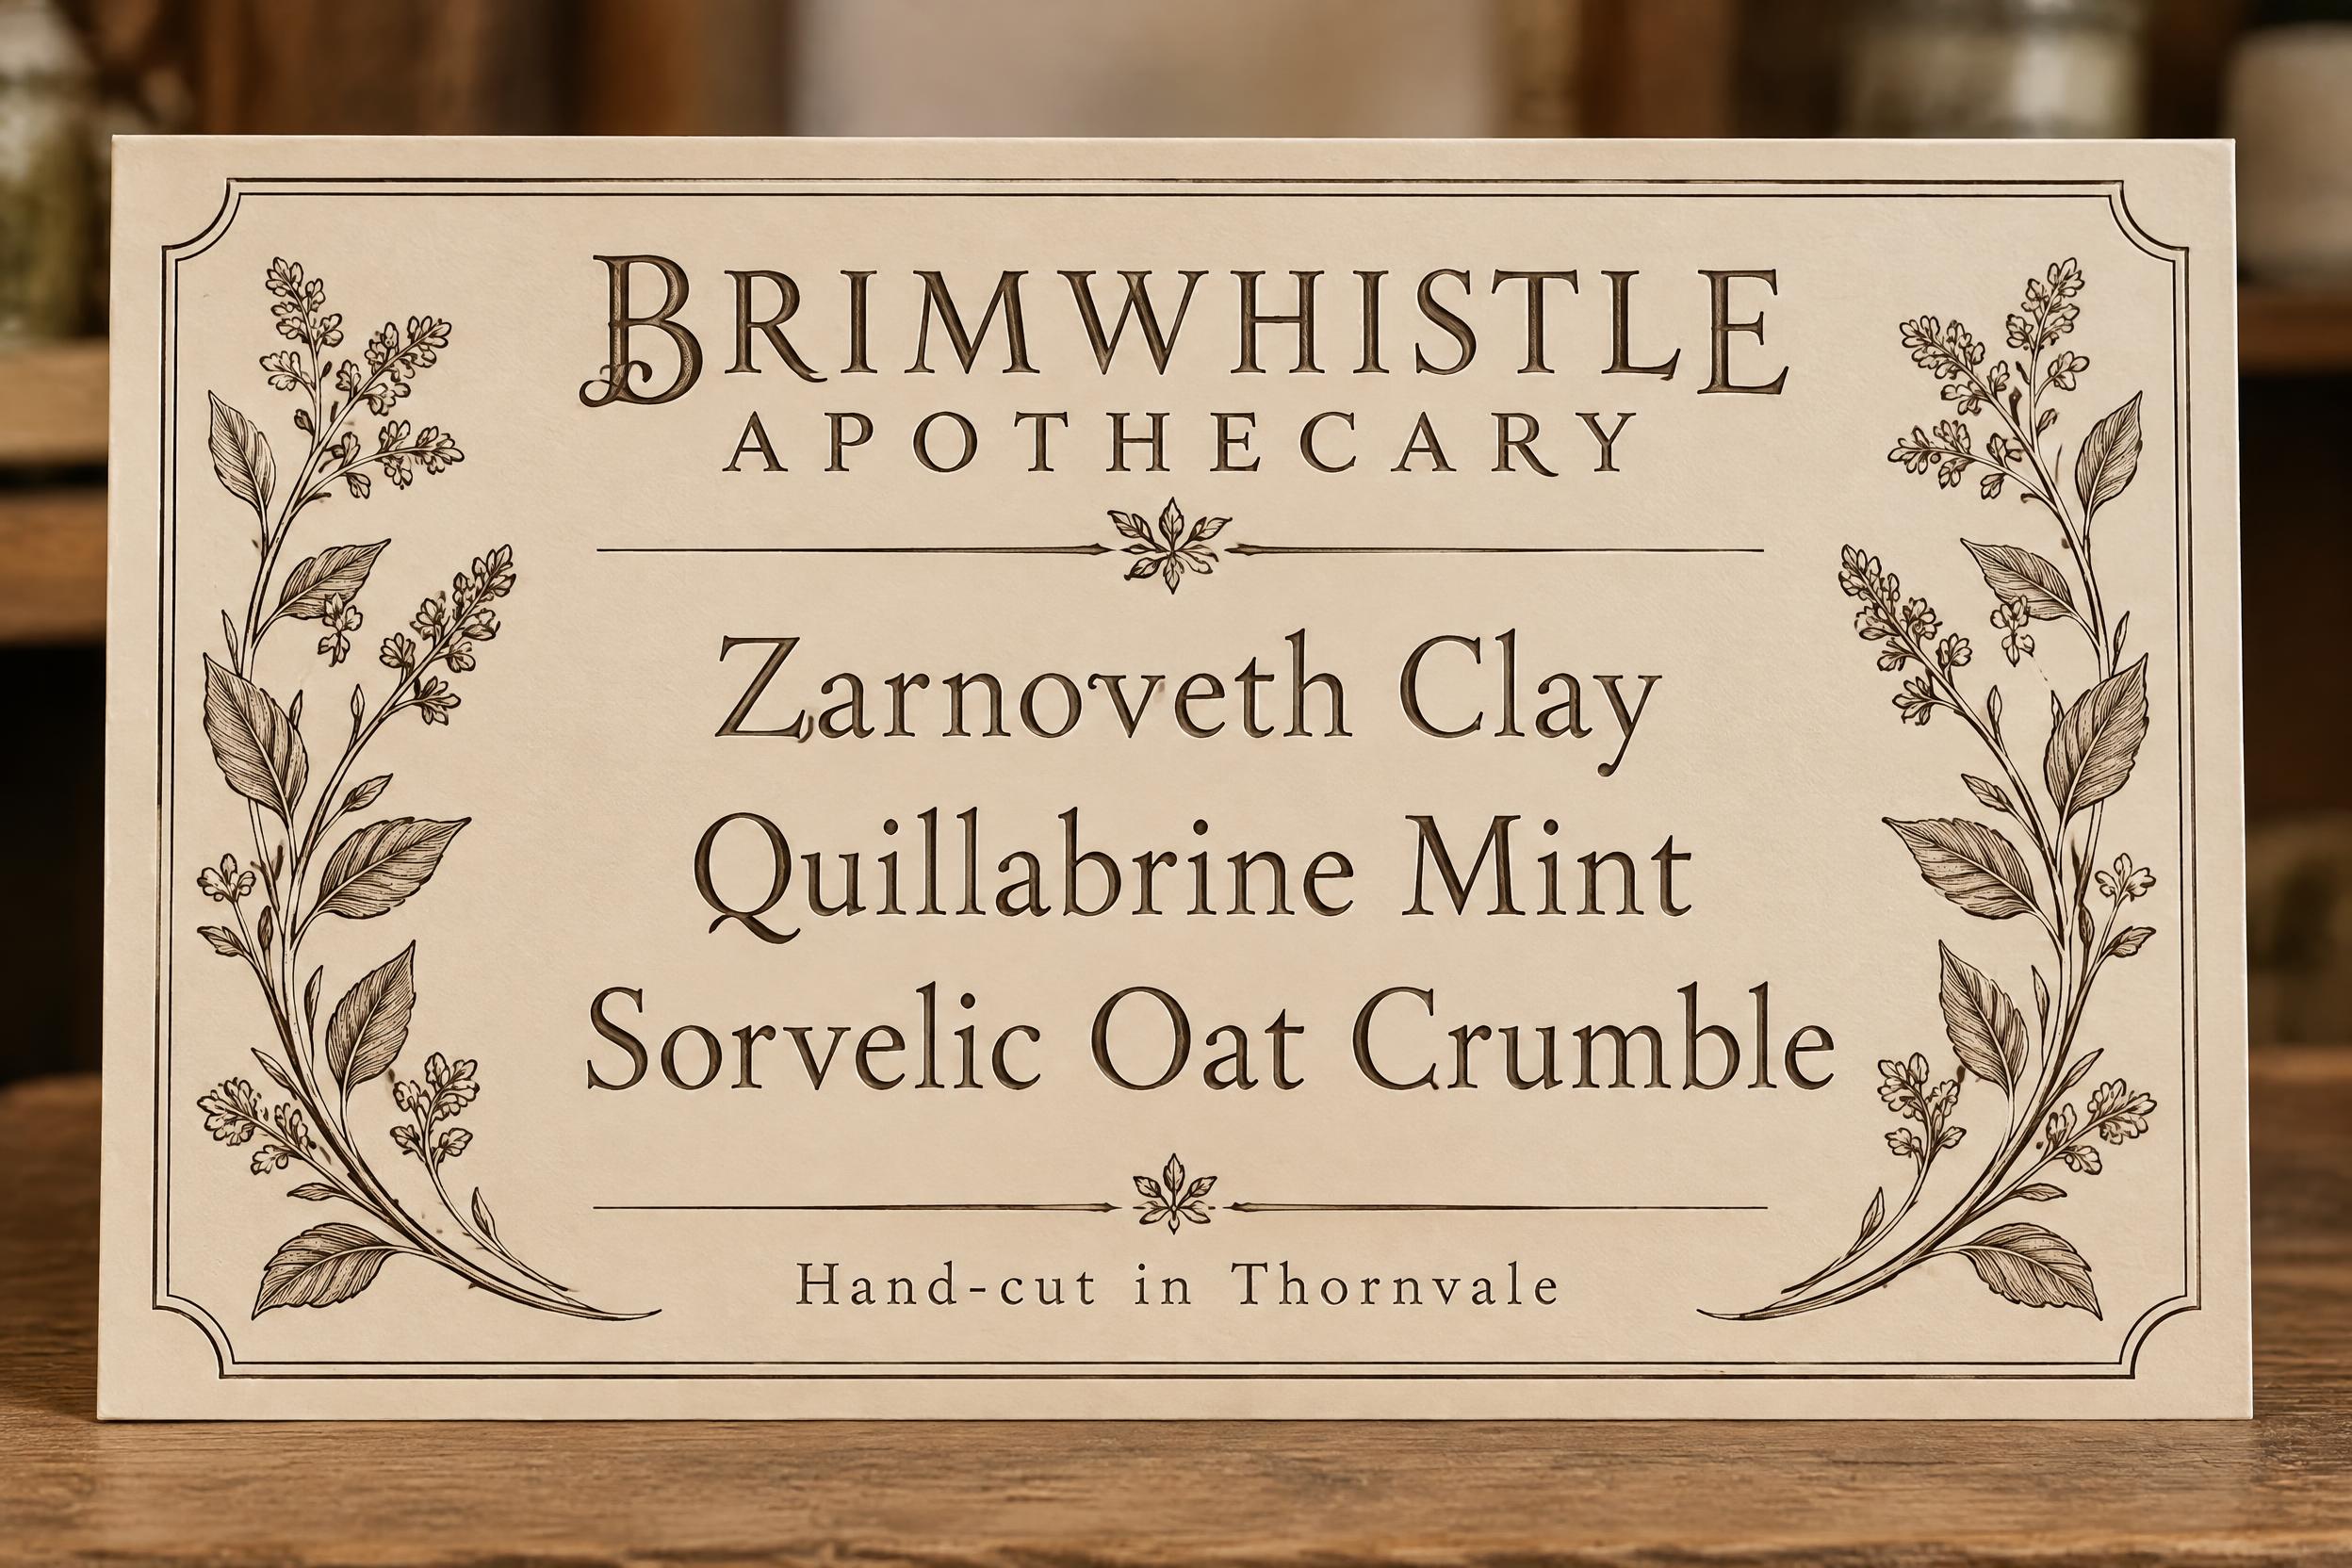
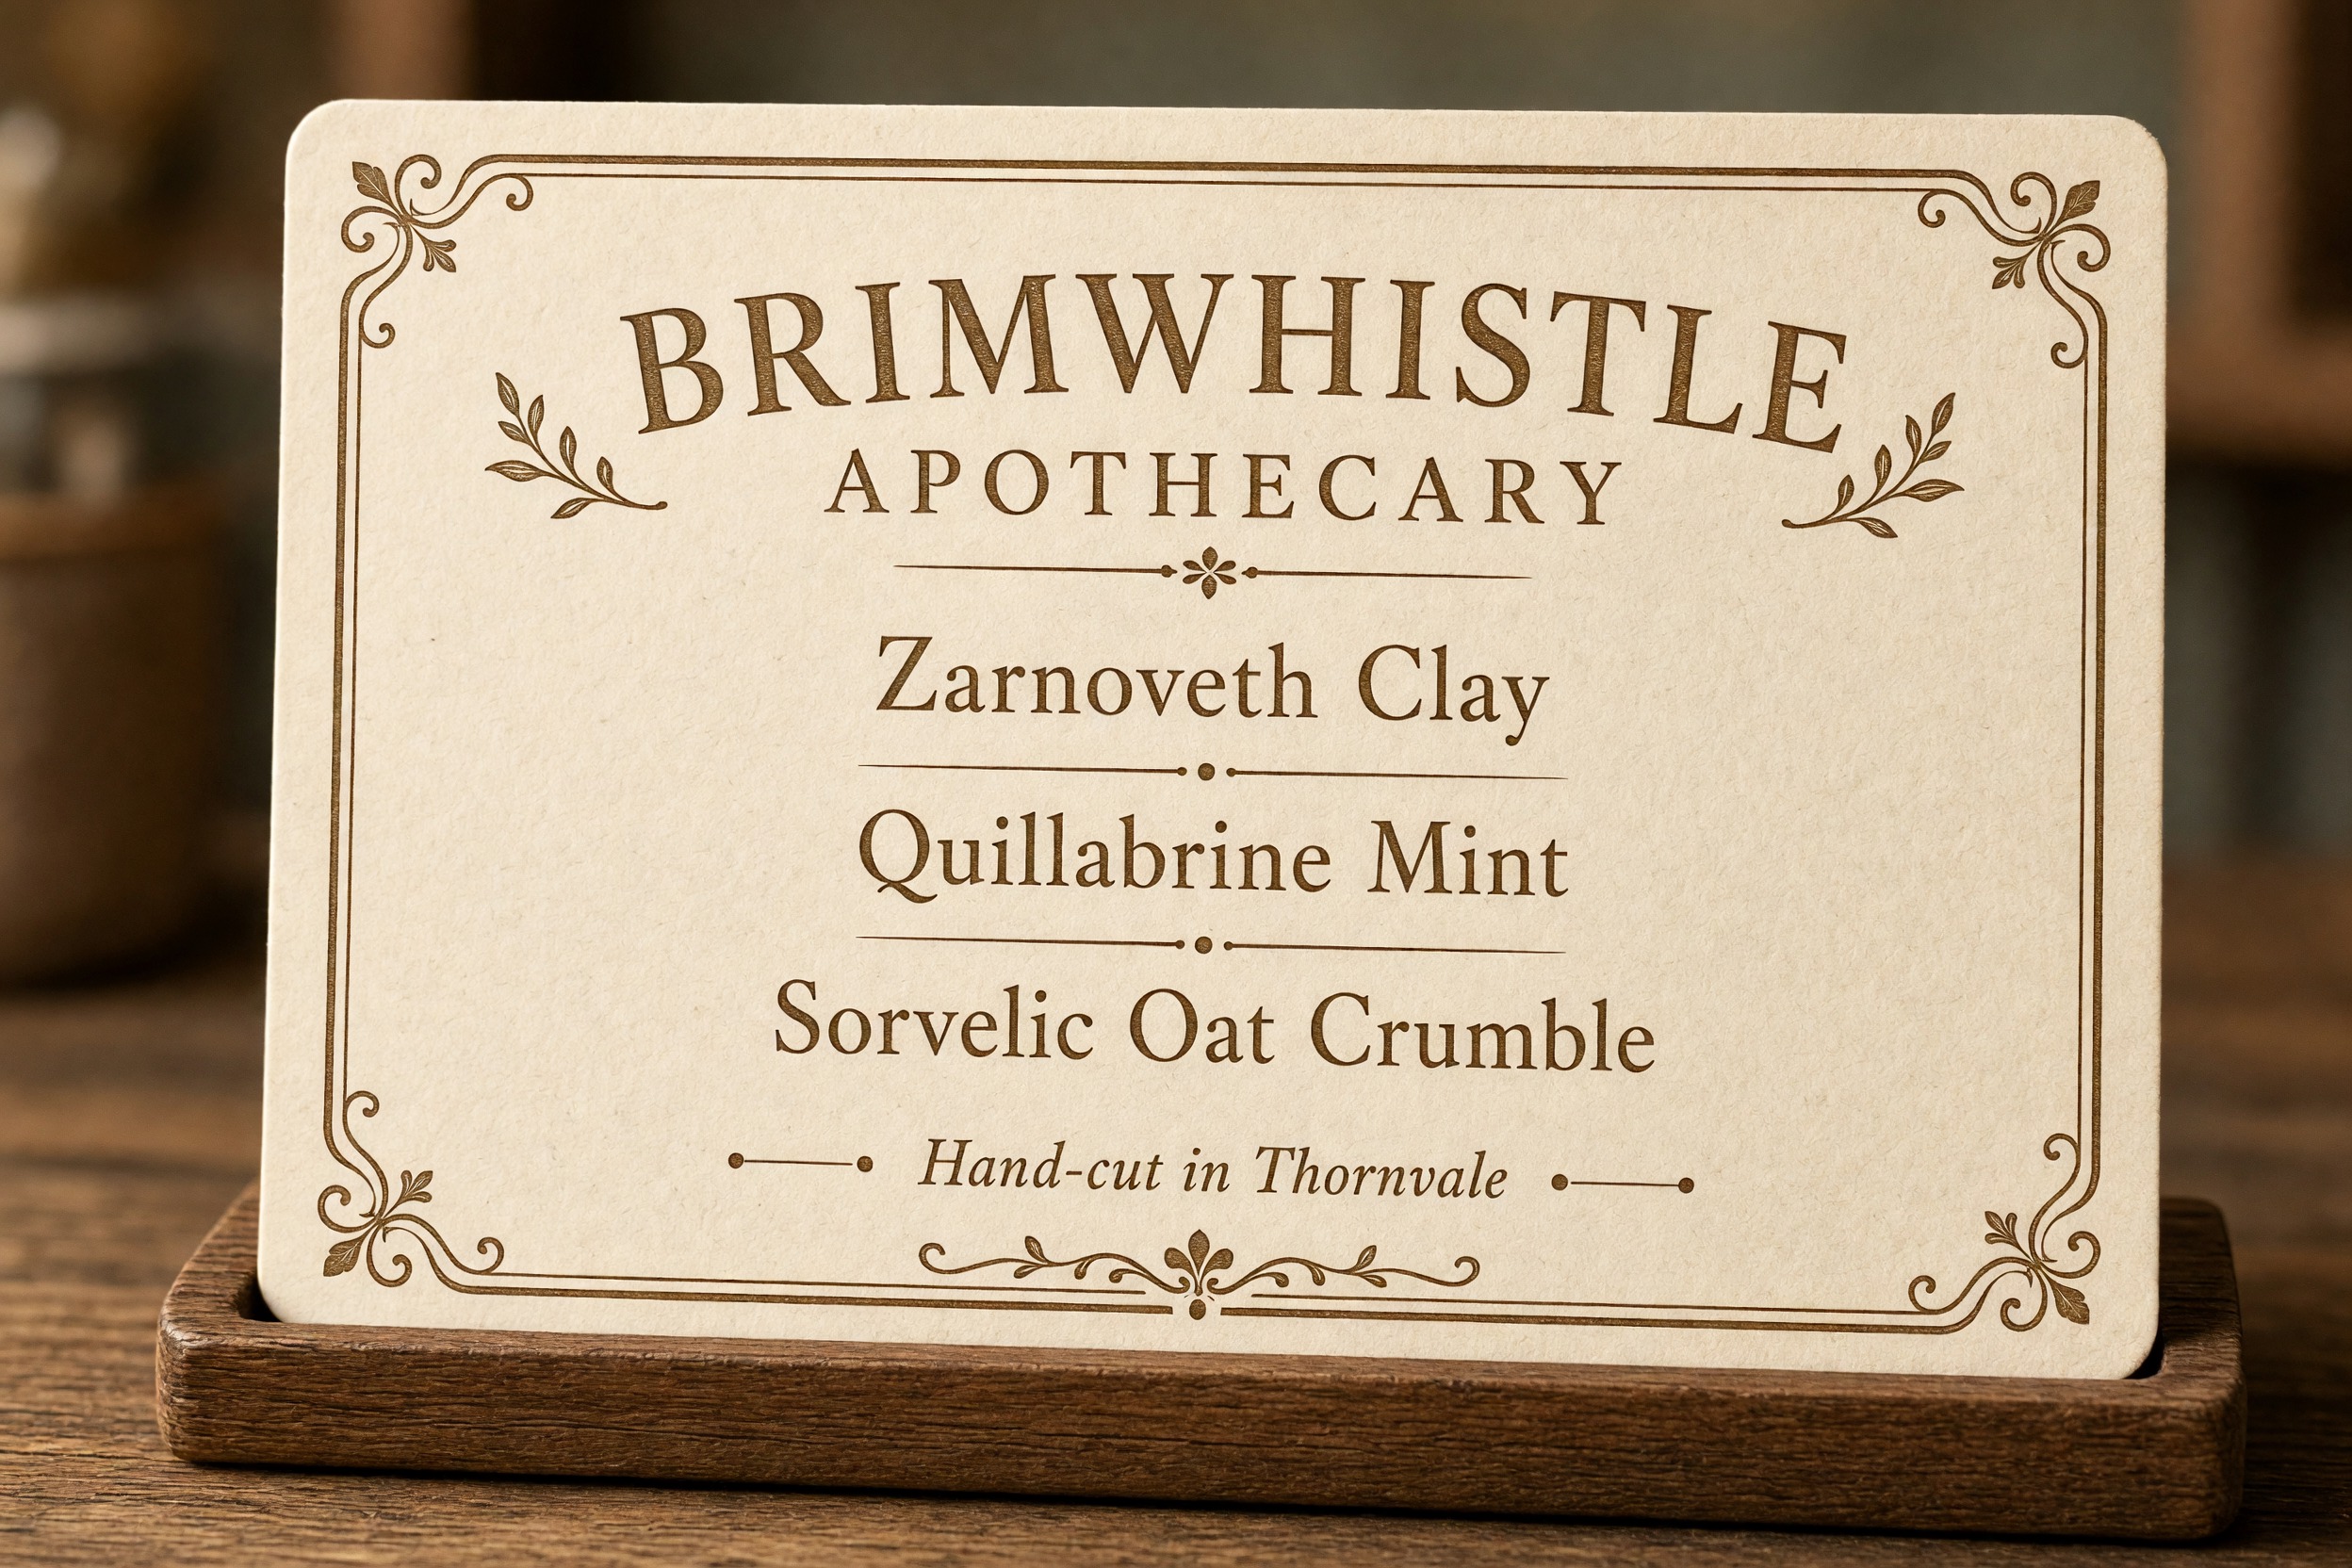
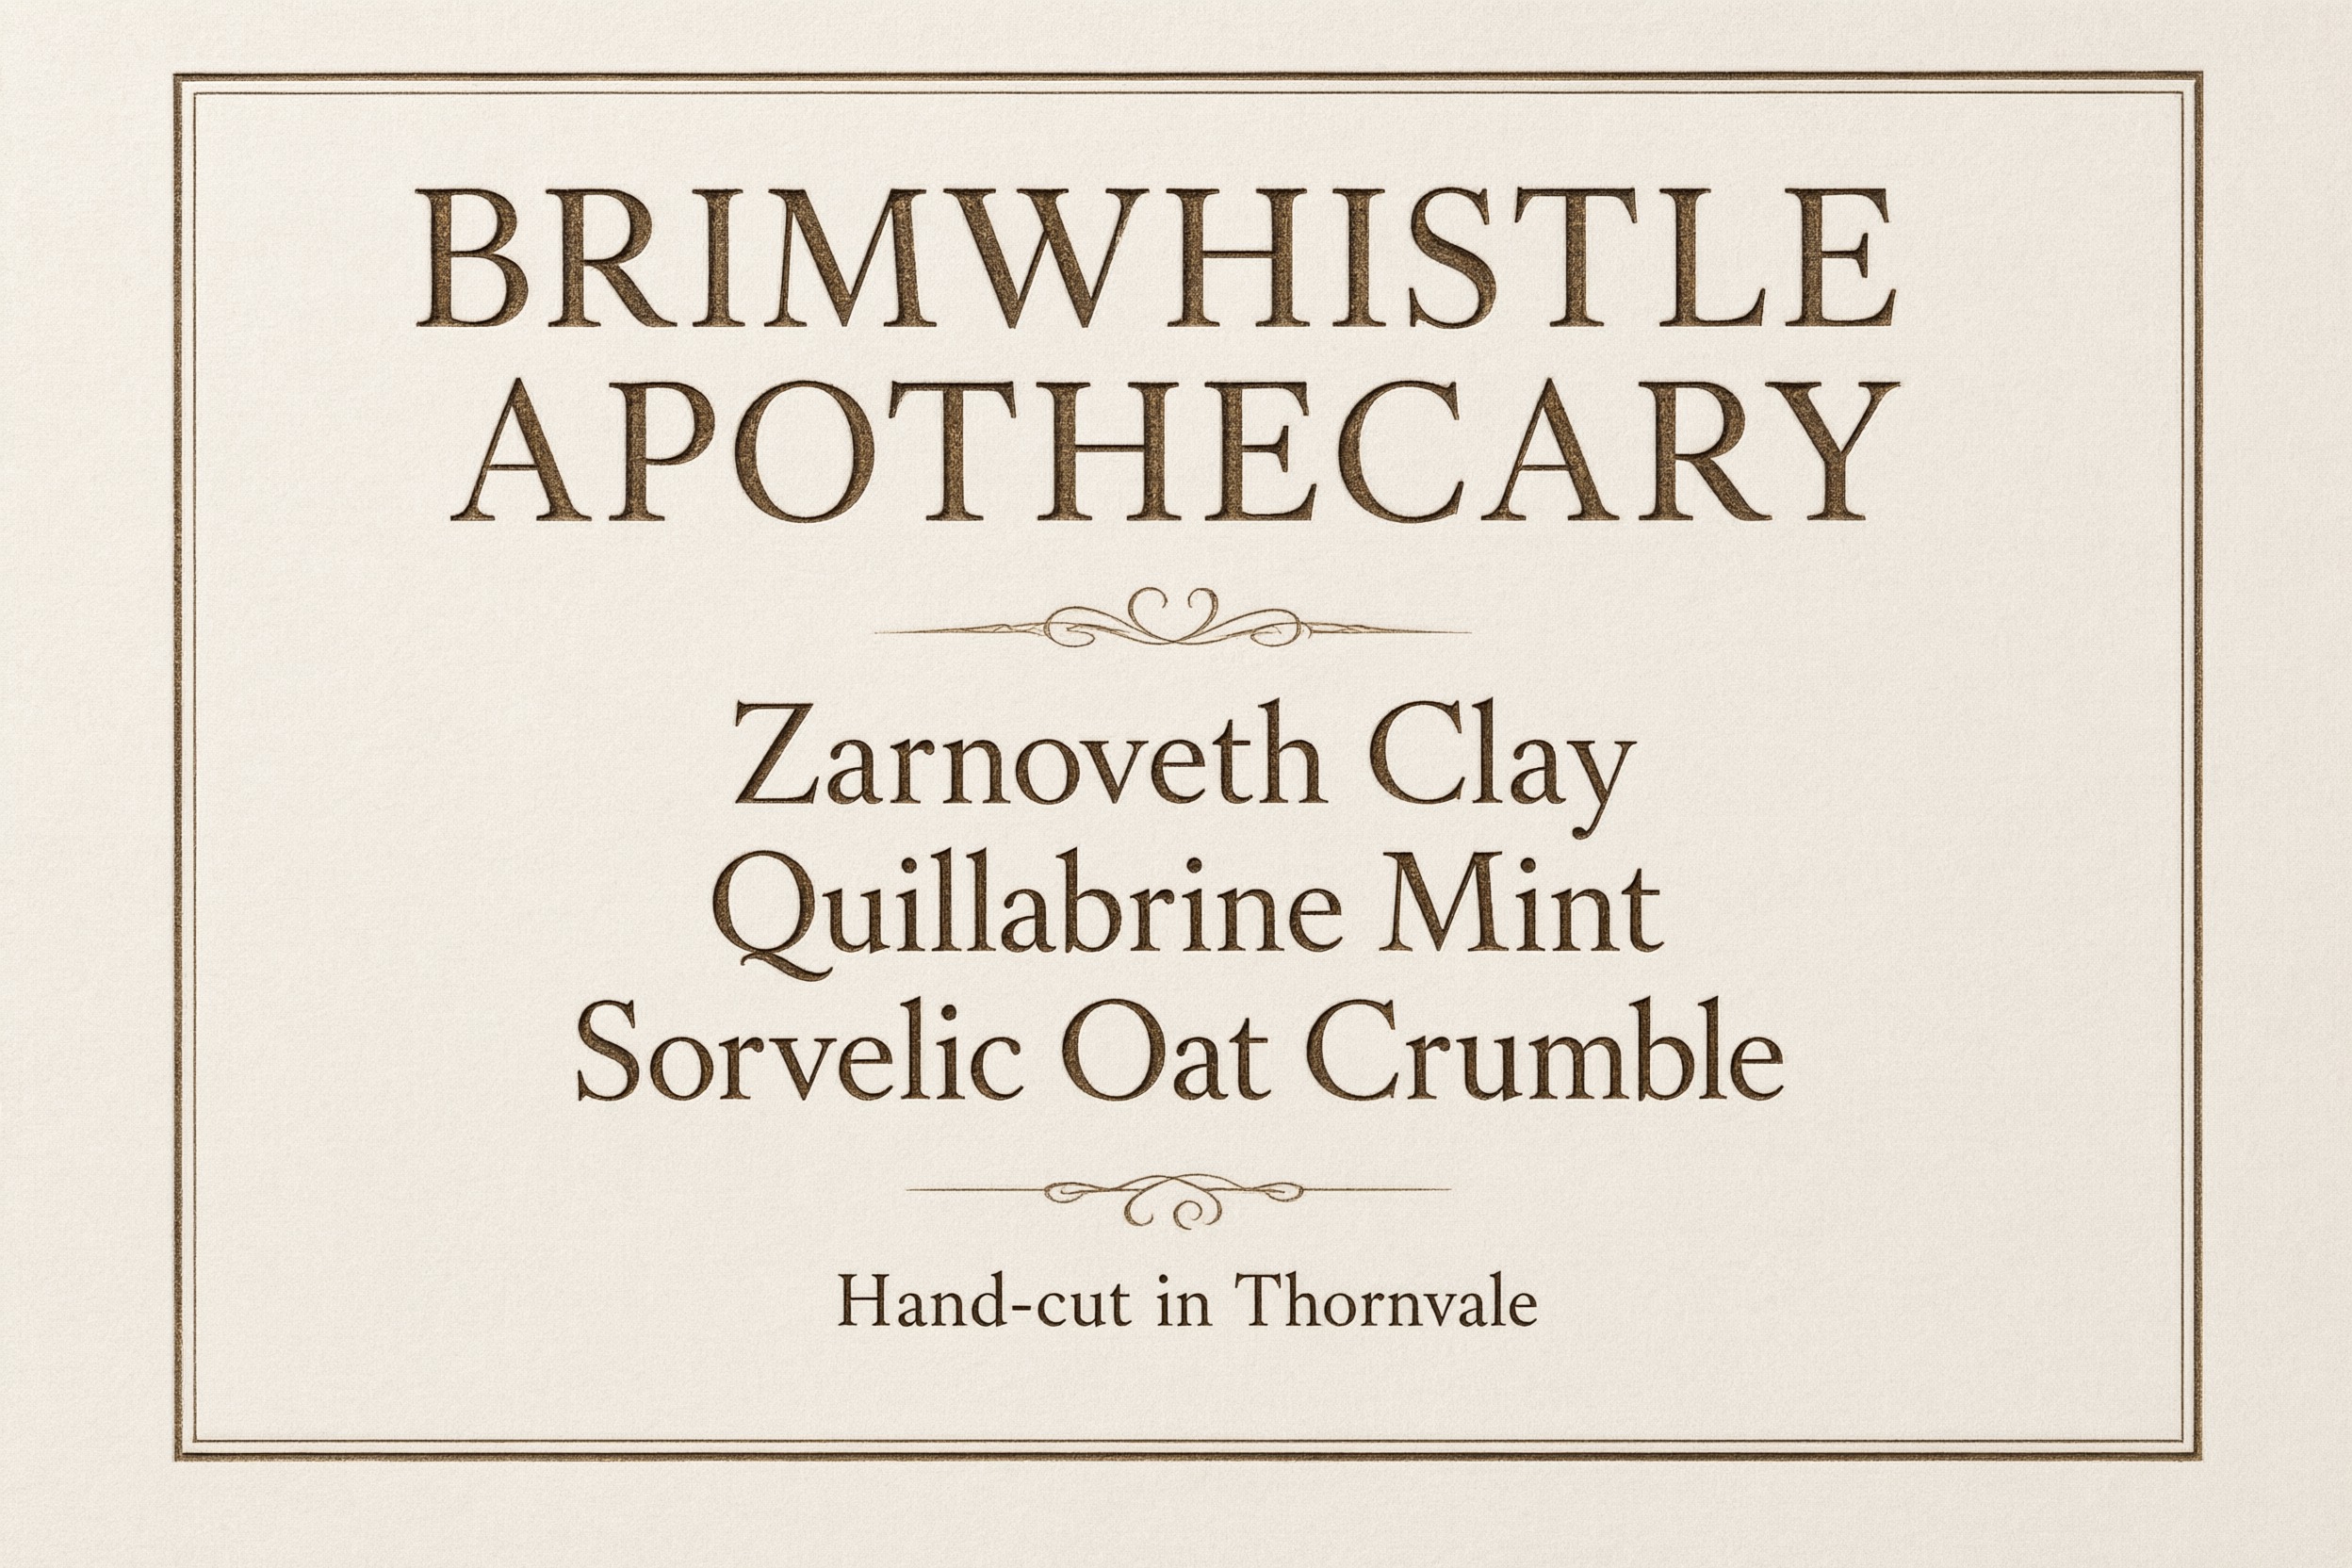
15 张用生造名字的手工皂店货架牌全部拼对。五款模型都没有把生造词「改」成真词。
西班牙语、葡萄牙语、德语的重音字母
面包店橱窗字三行:「Pequeñas delicias con café recién hecho」「Pão de queijo à moda da avó」「Frühstück für Groß und Klein」。
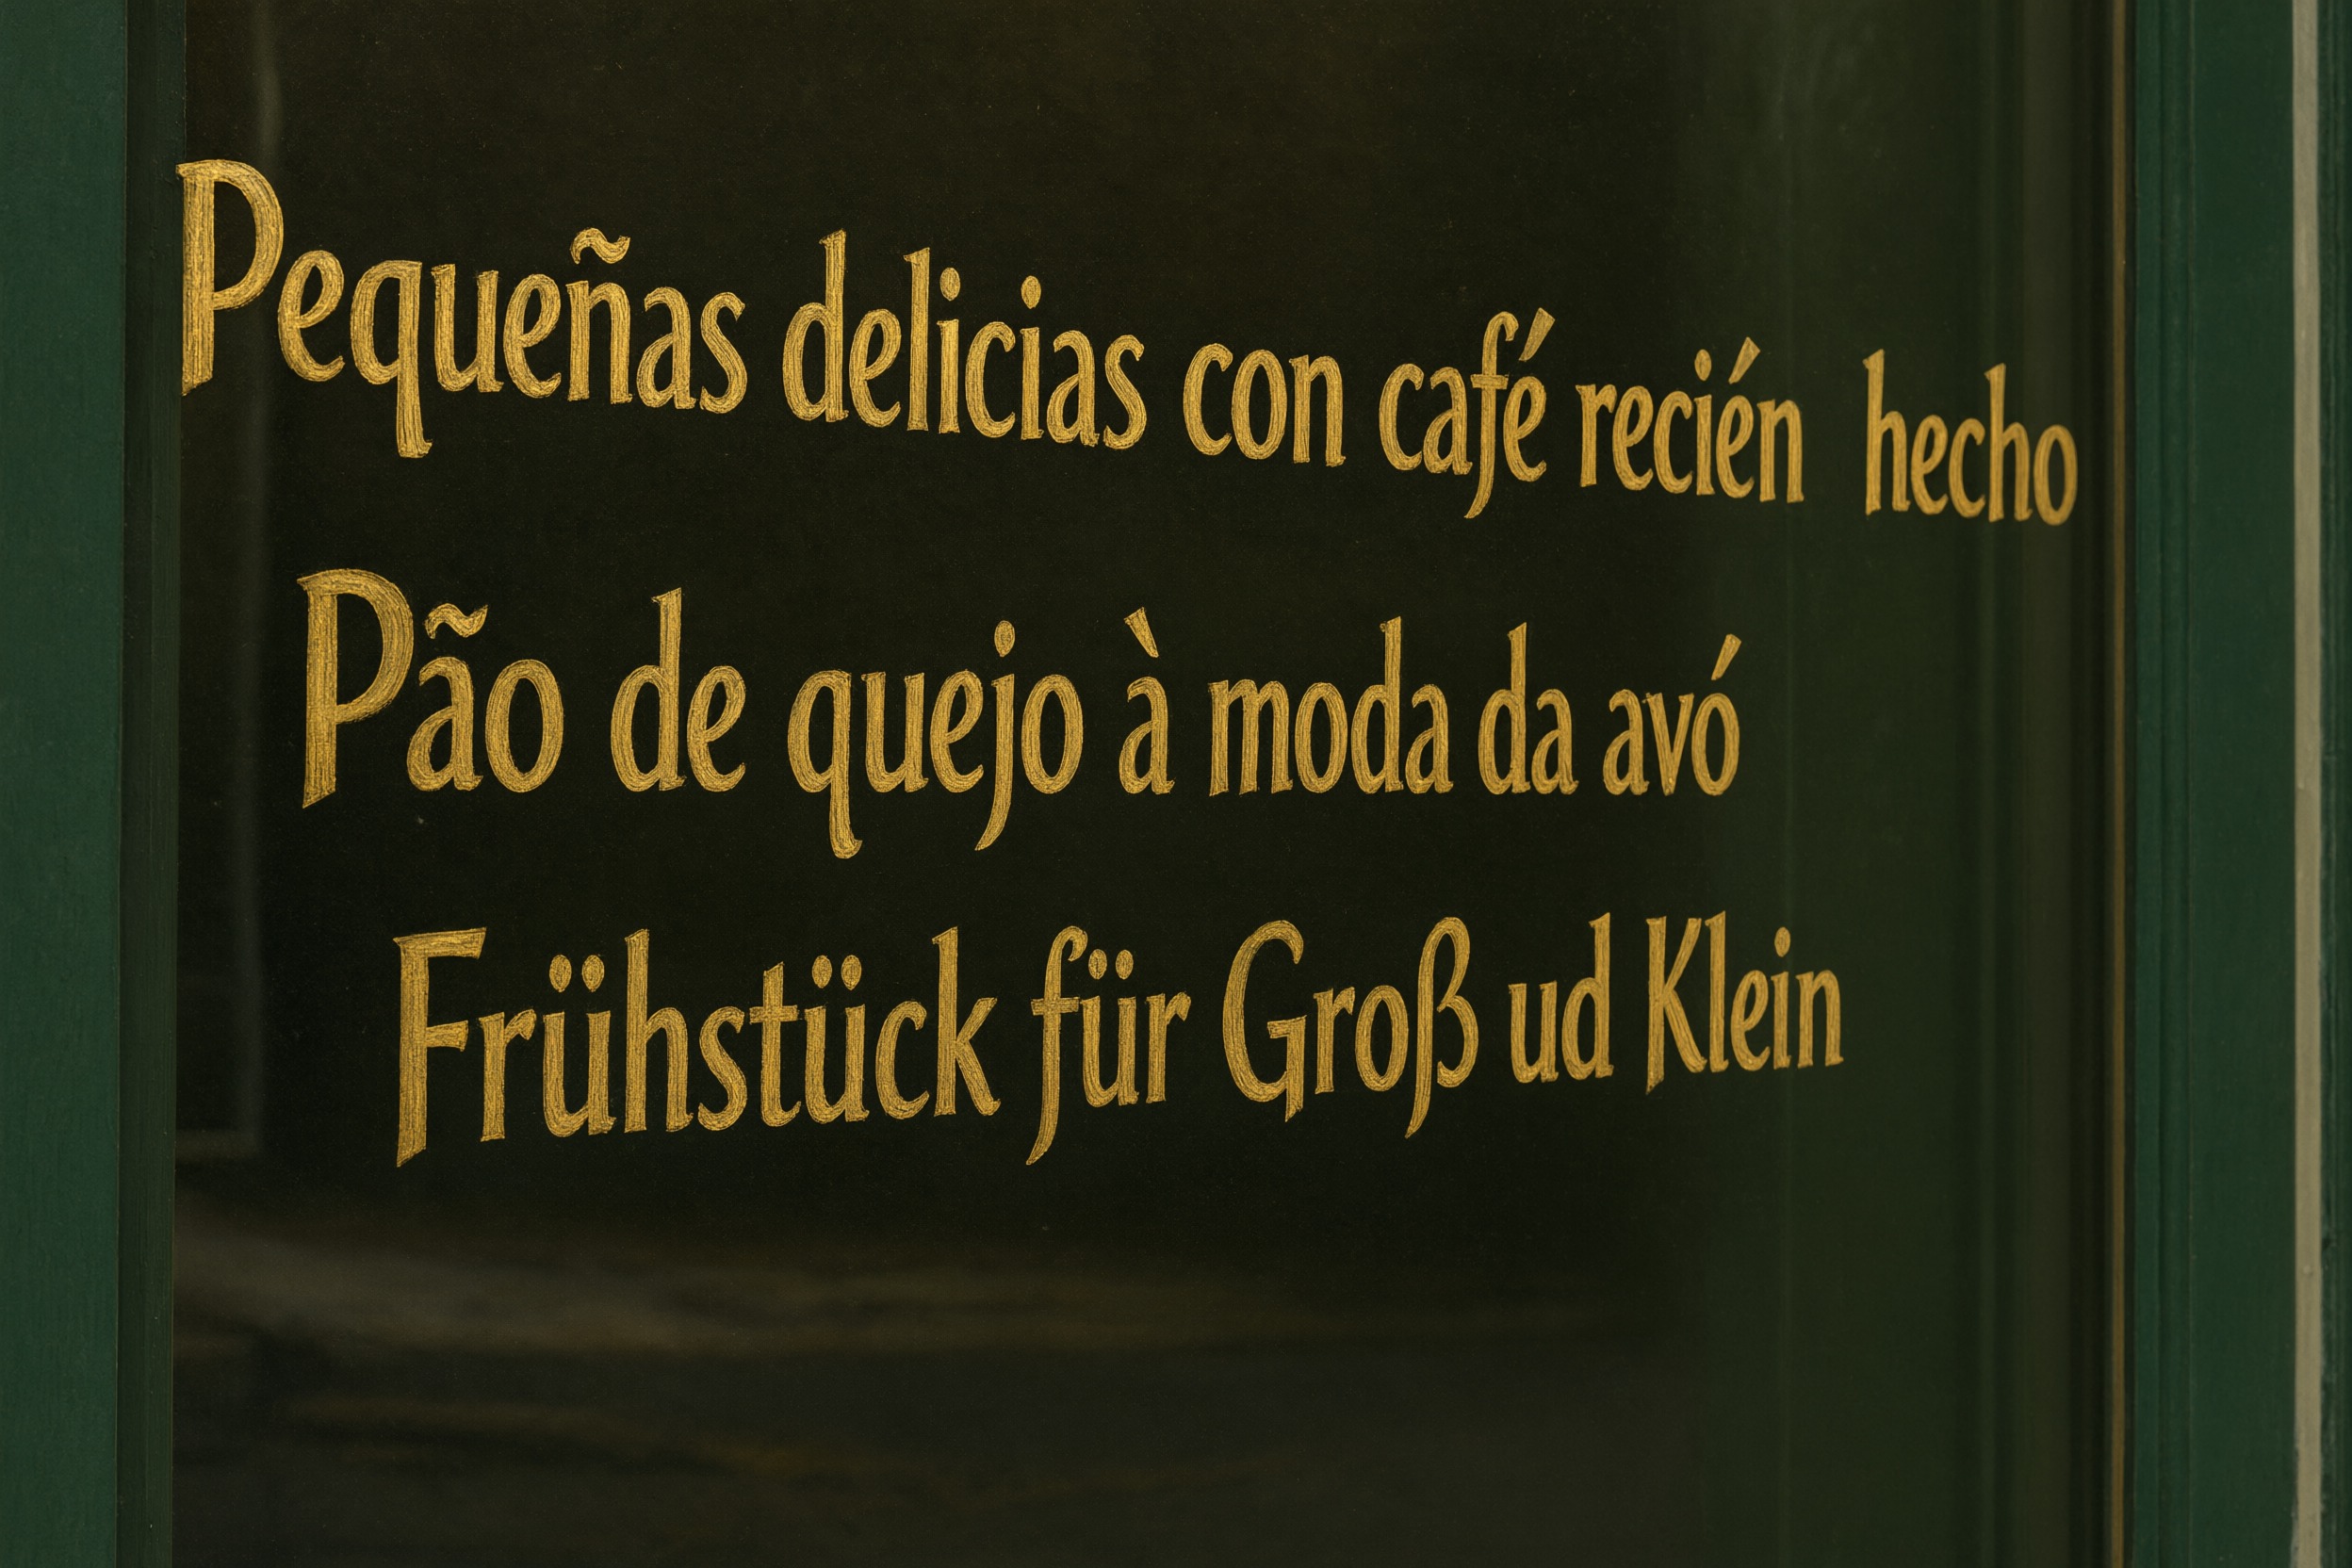
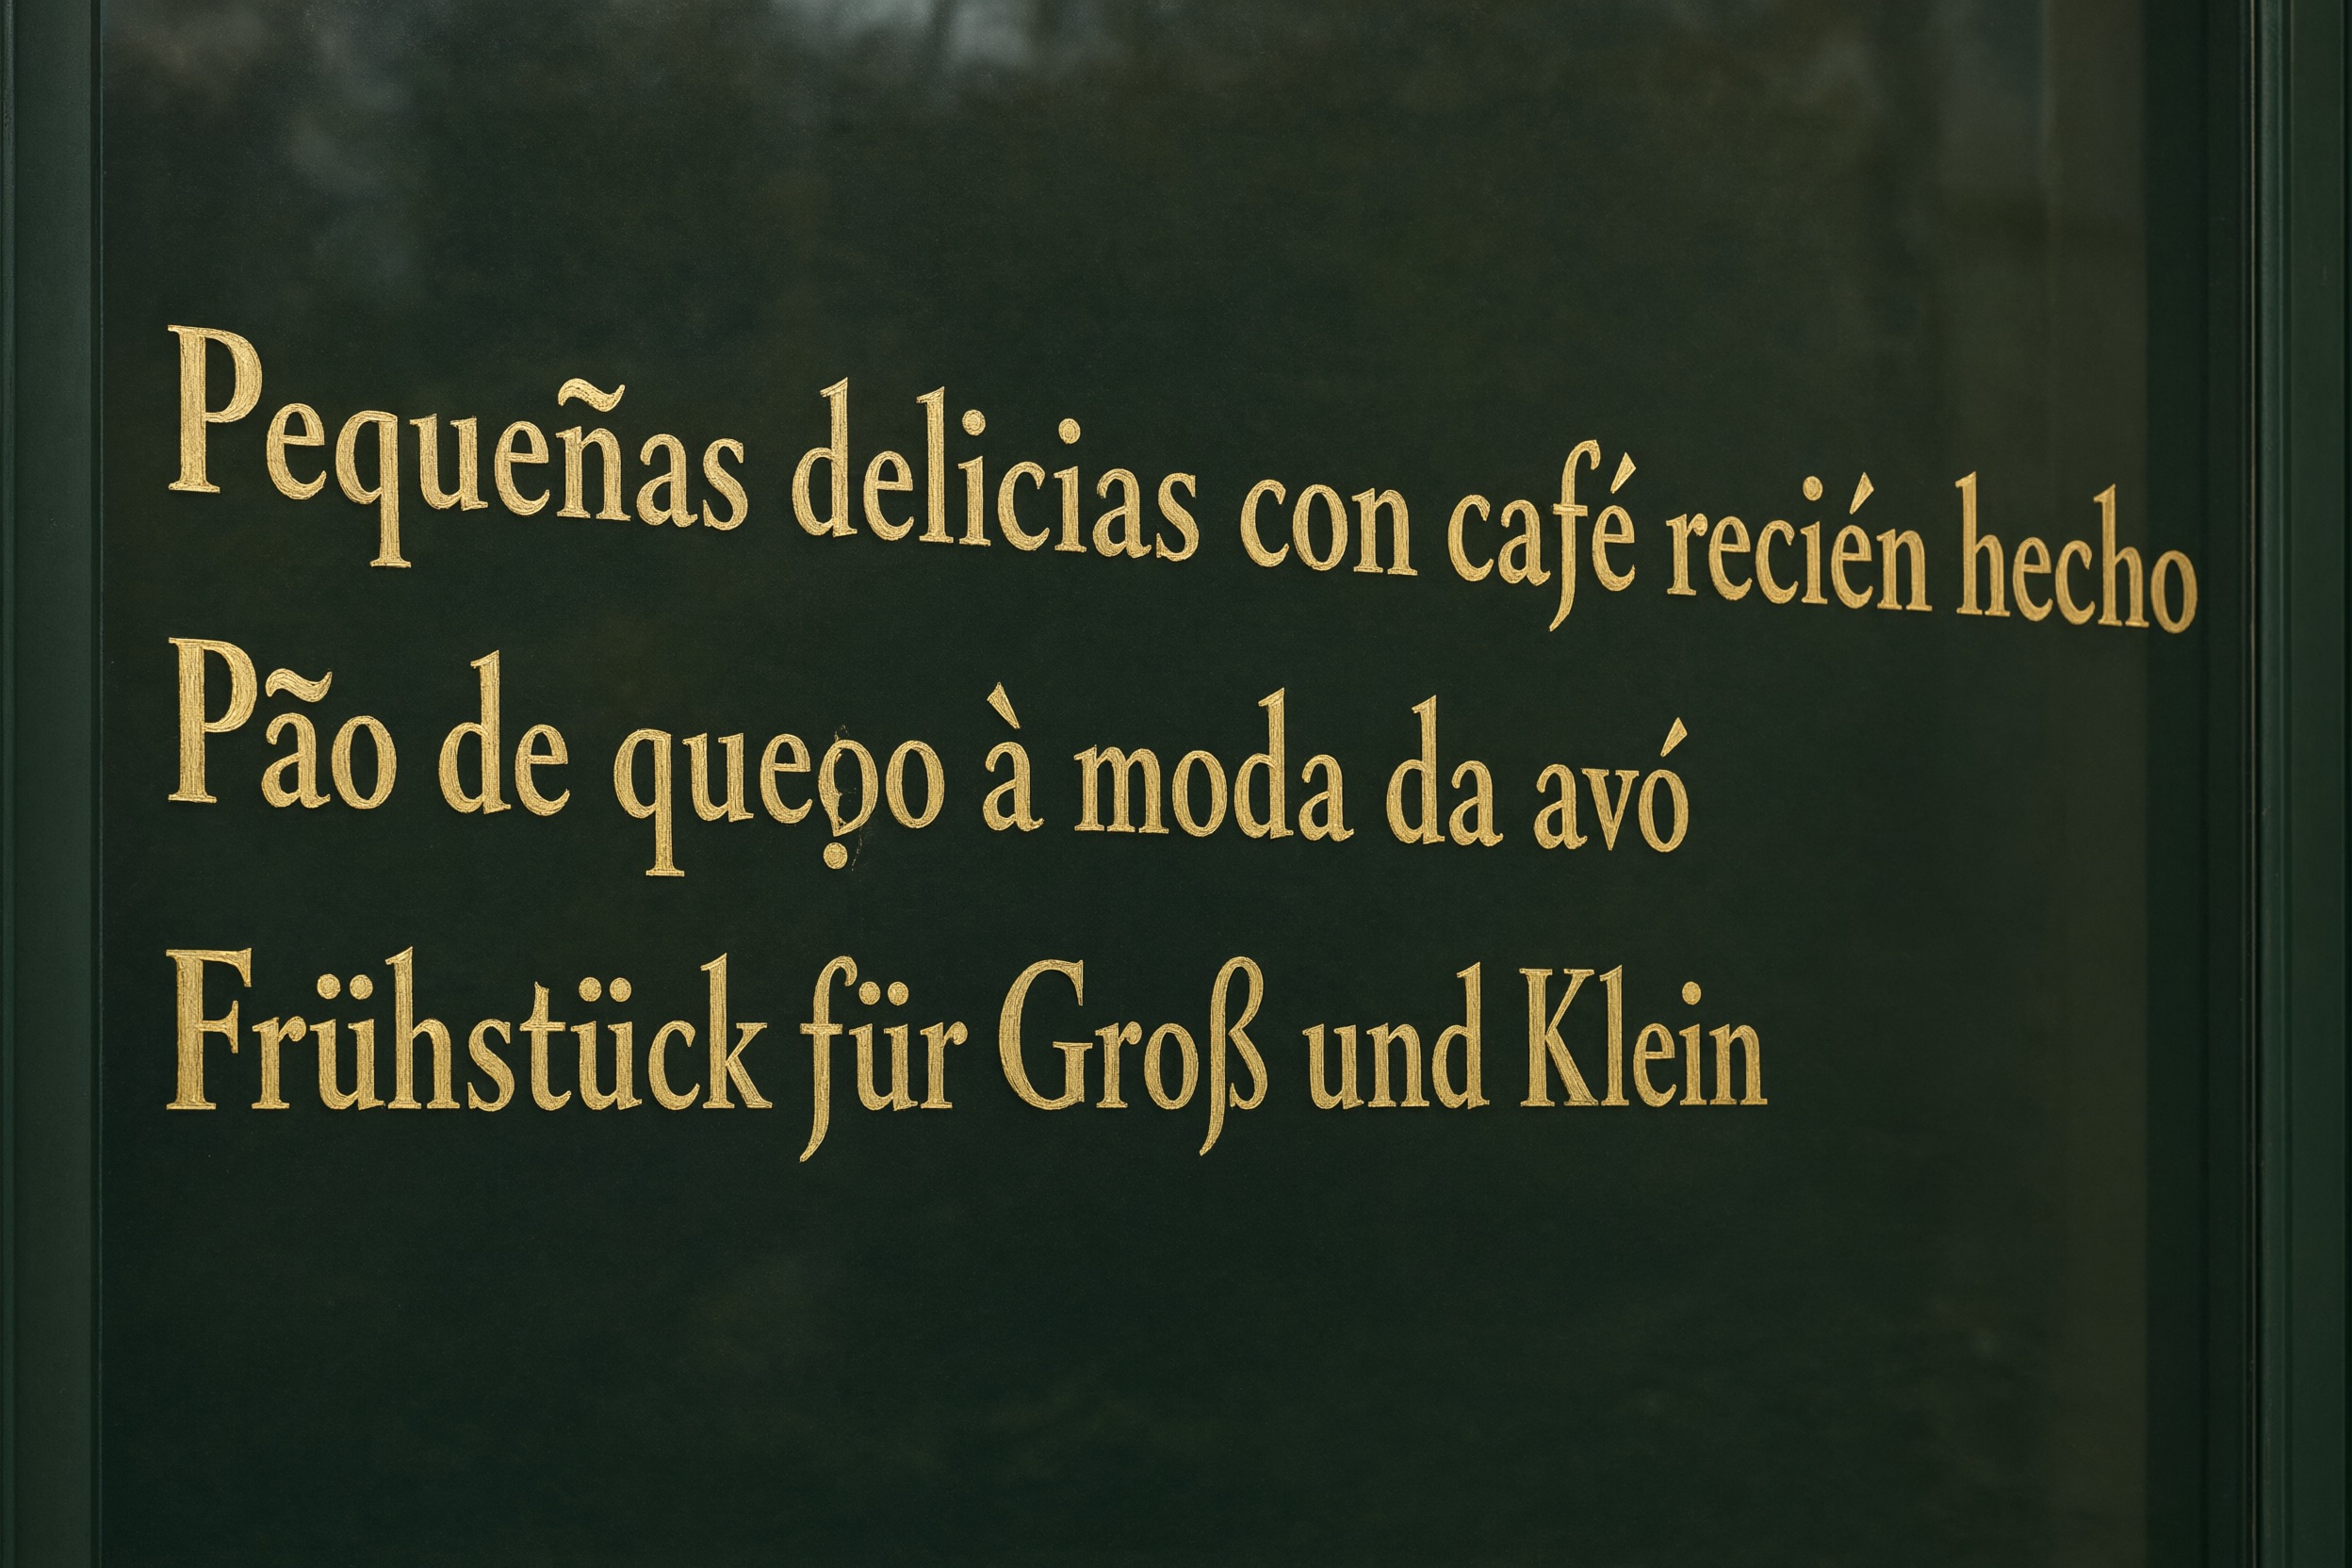
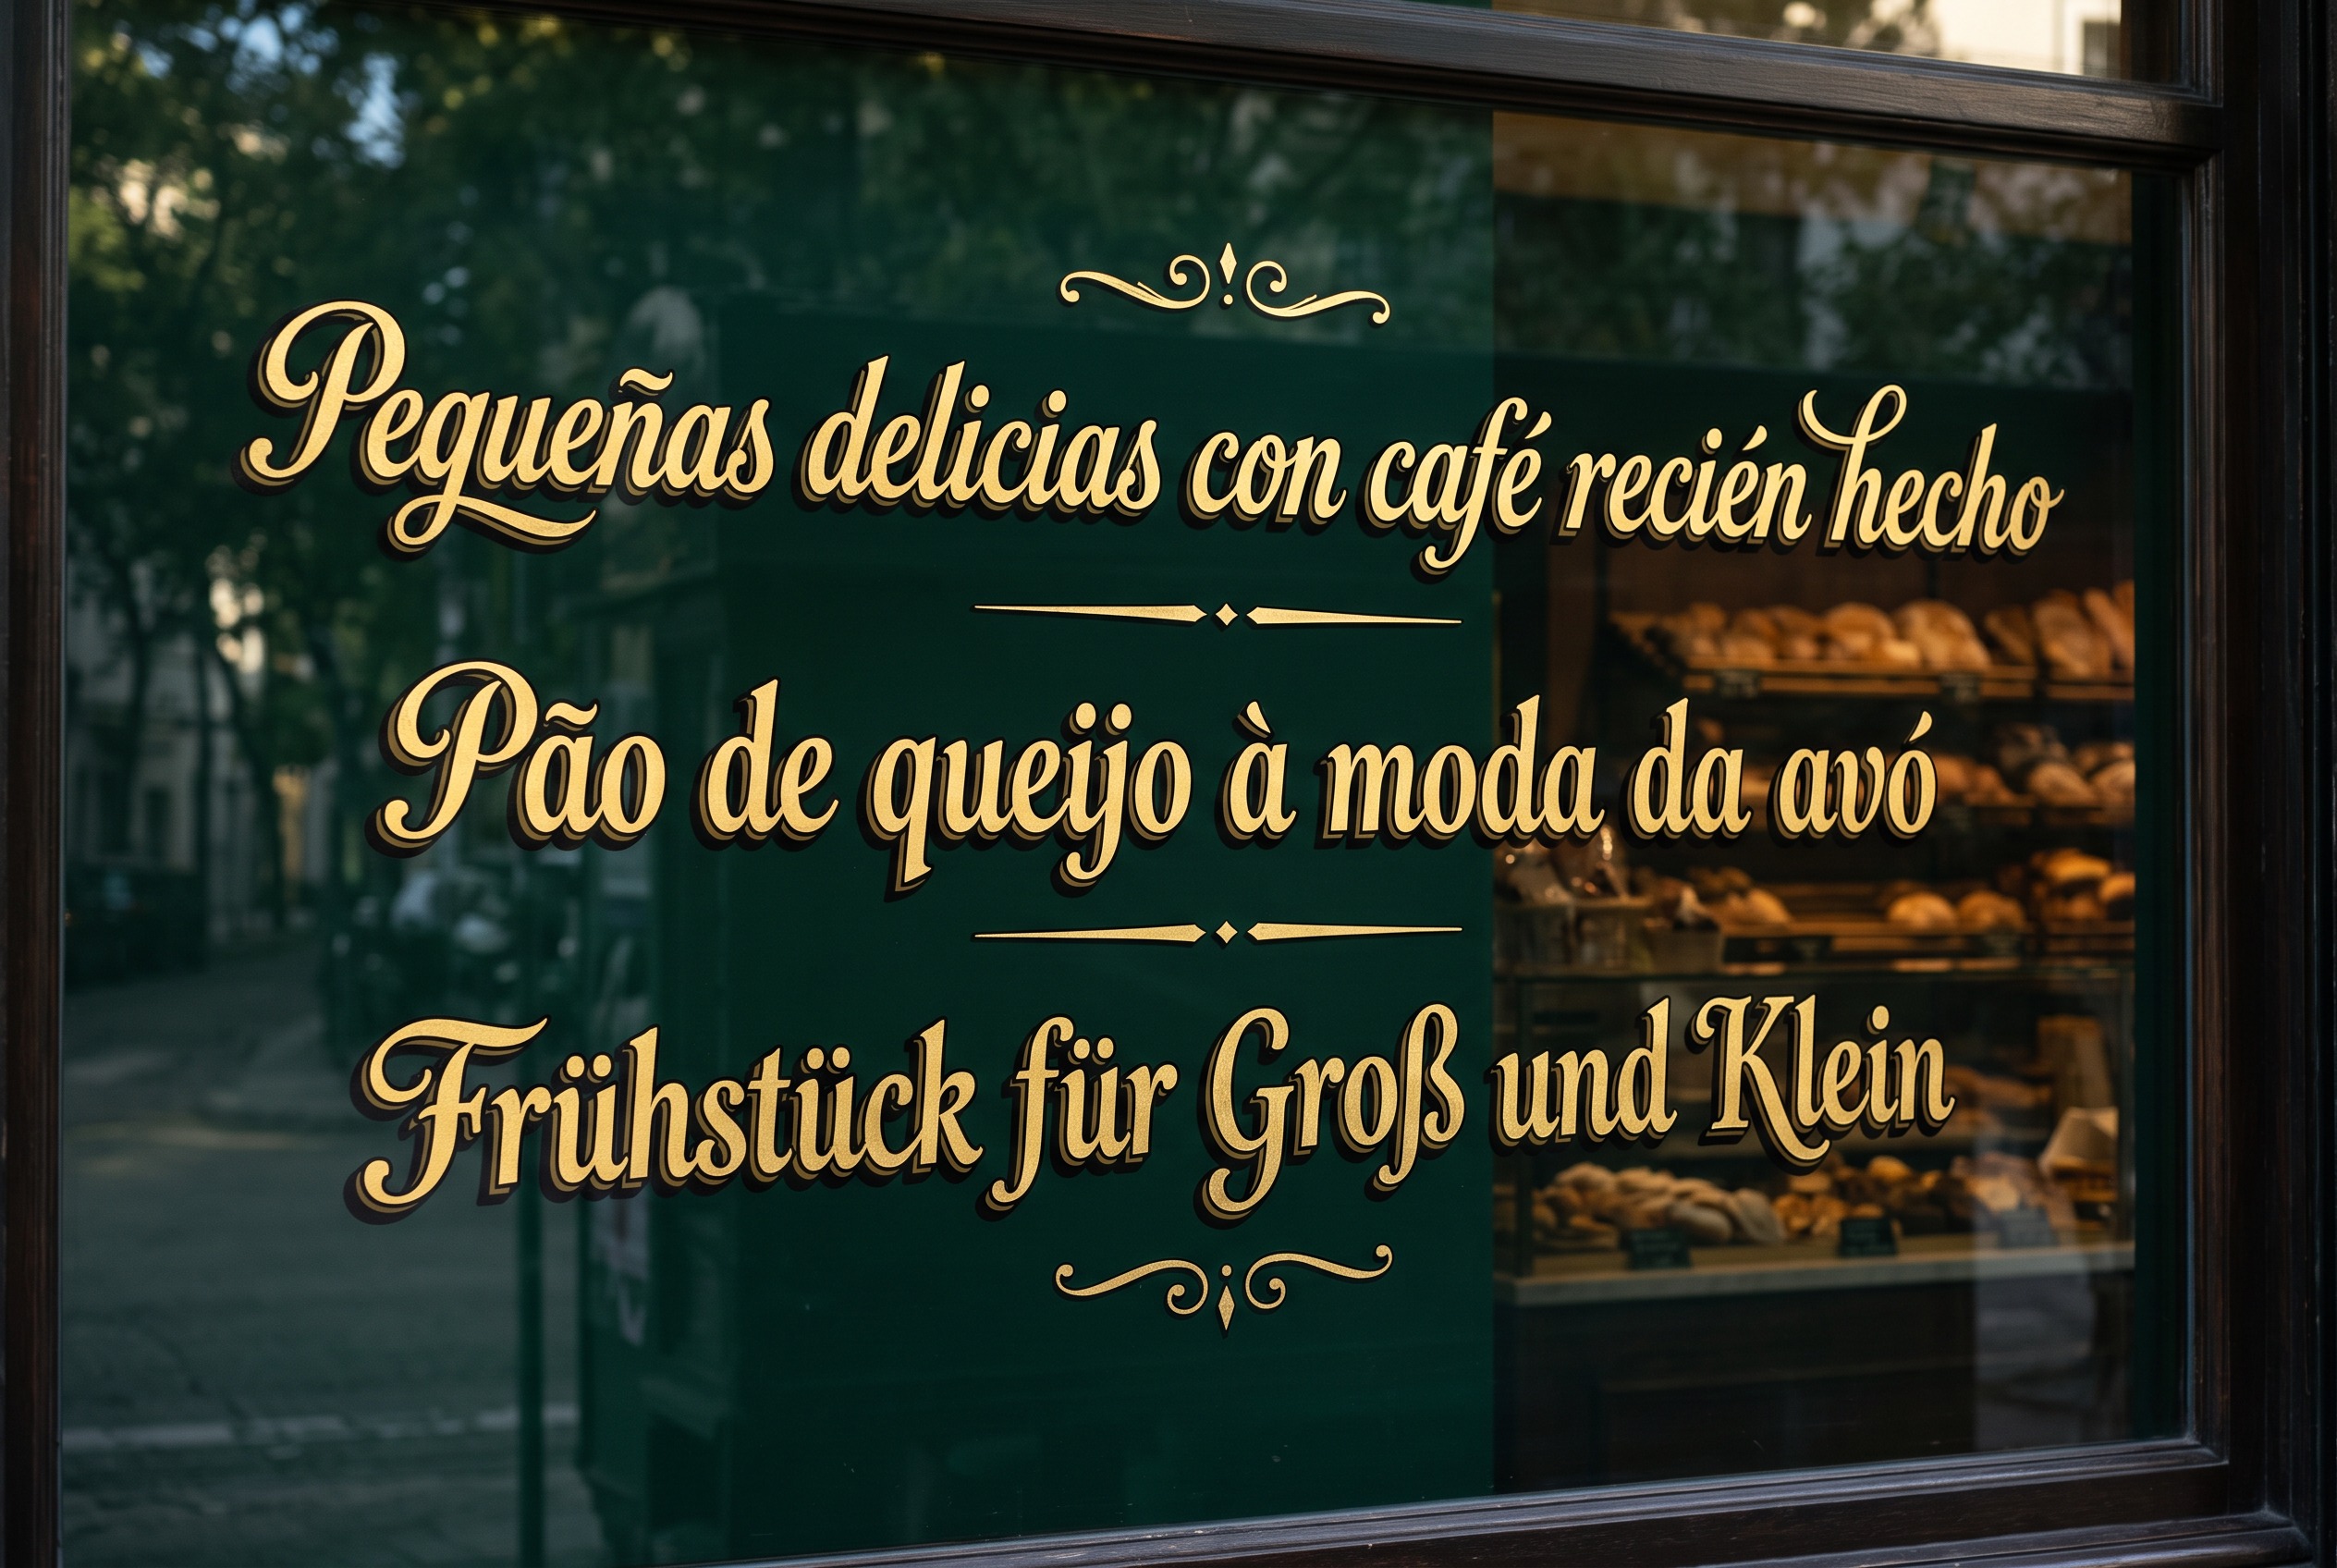
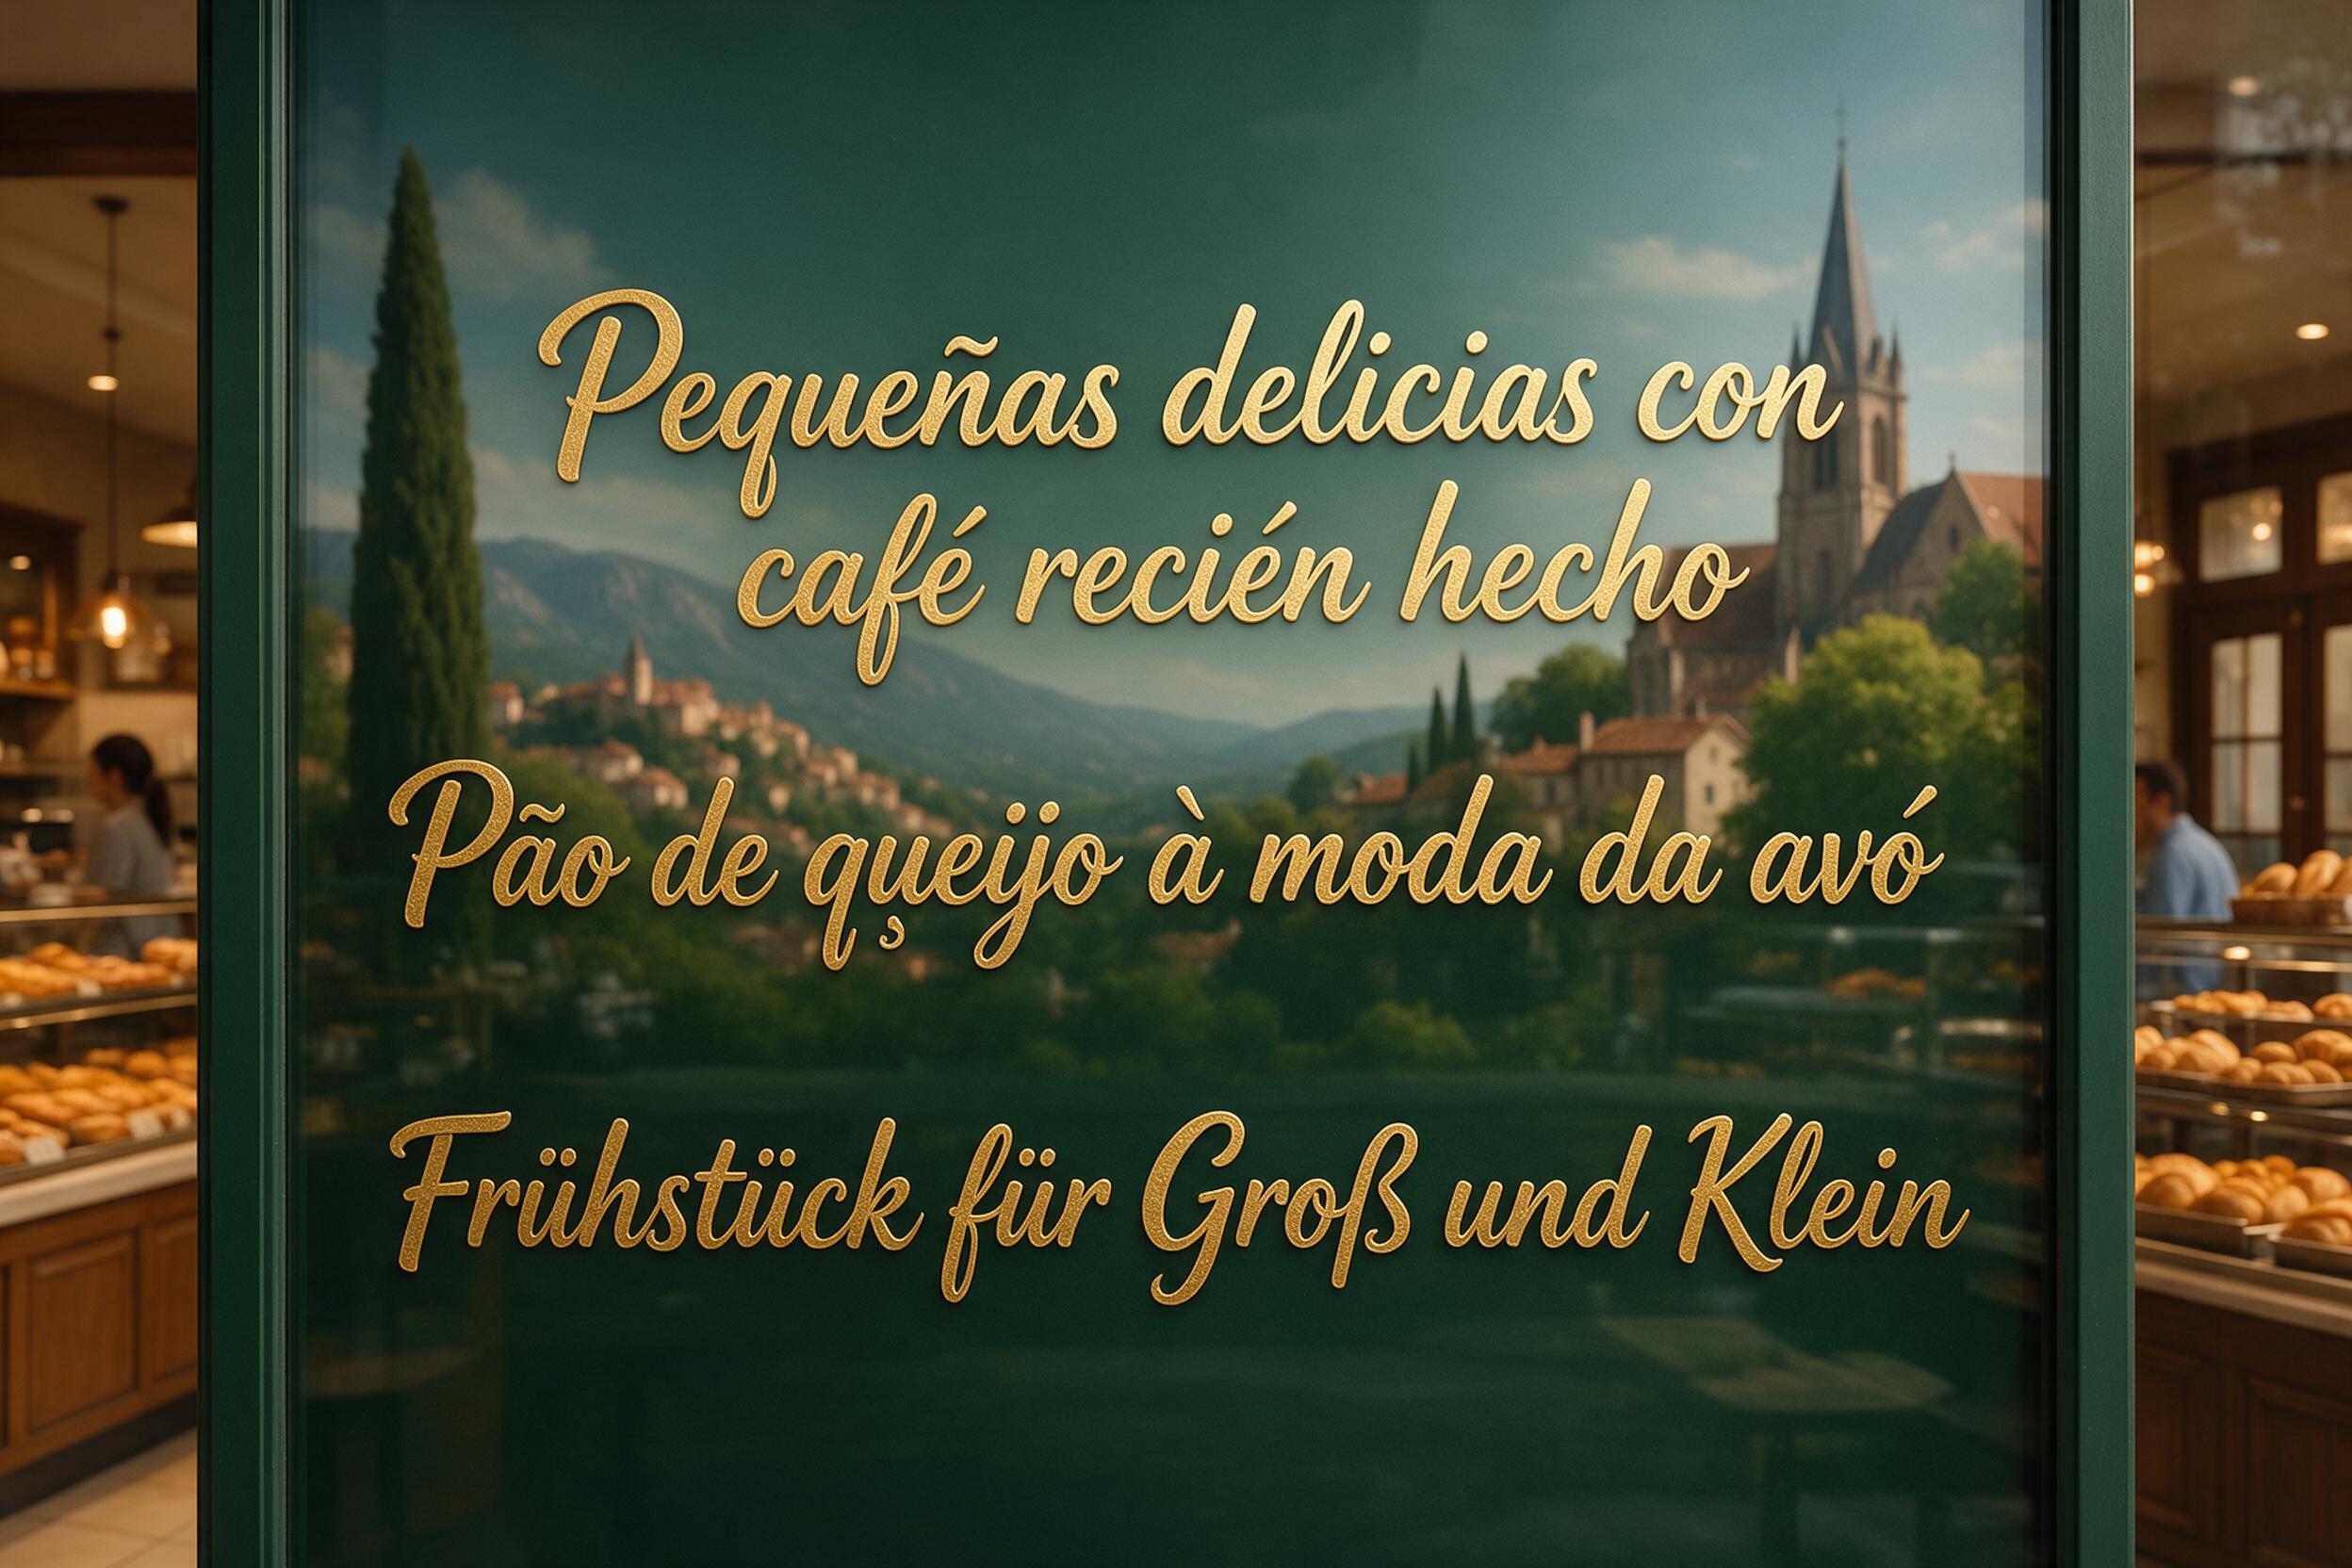
每款模型都保住了所有重音和 ß。GPT Image 2.5 Sunburst、Grok Imagine 2.0、Seedream 5.0 Pro 和 Nano Banana 2.1 的 12 张橱窗字没有错。Qwen Image 3.0 Pro 3 张每张错一两个字母,错的都是普通字母而不是重音字母(107866 把 recién 写成了 reeién)。
中日文各一句
茶馆柜台卡要求一句简体中文(30 字)、一句日文(28 字),共 58 个字(含全角标点)。
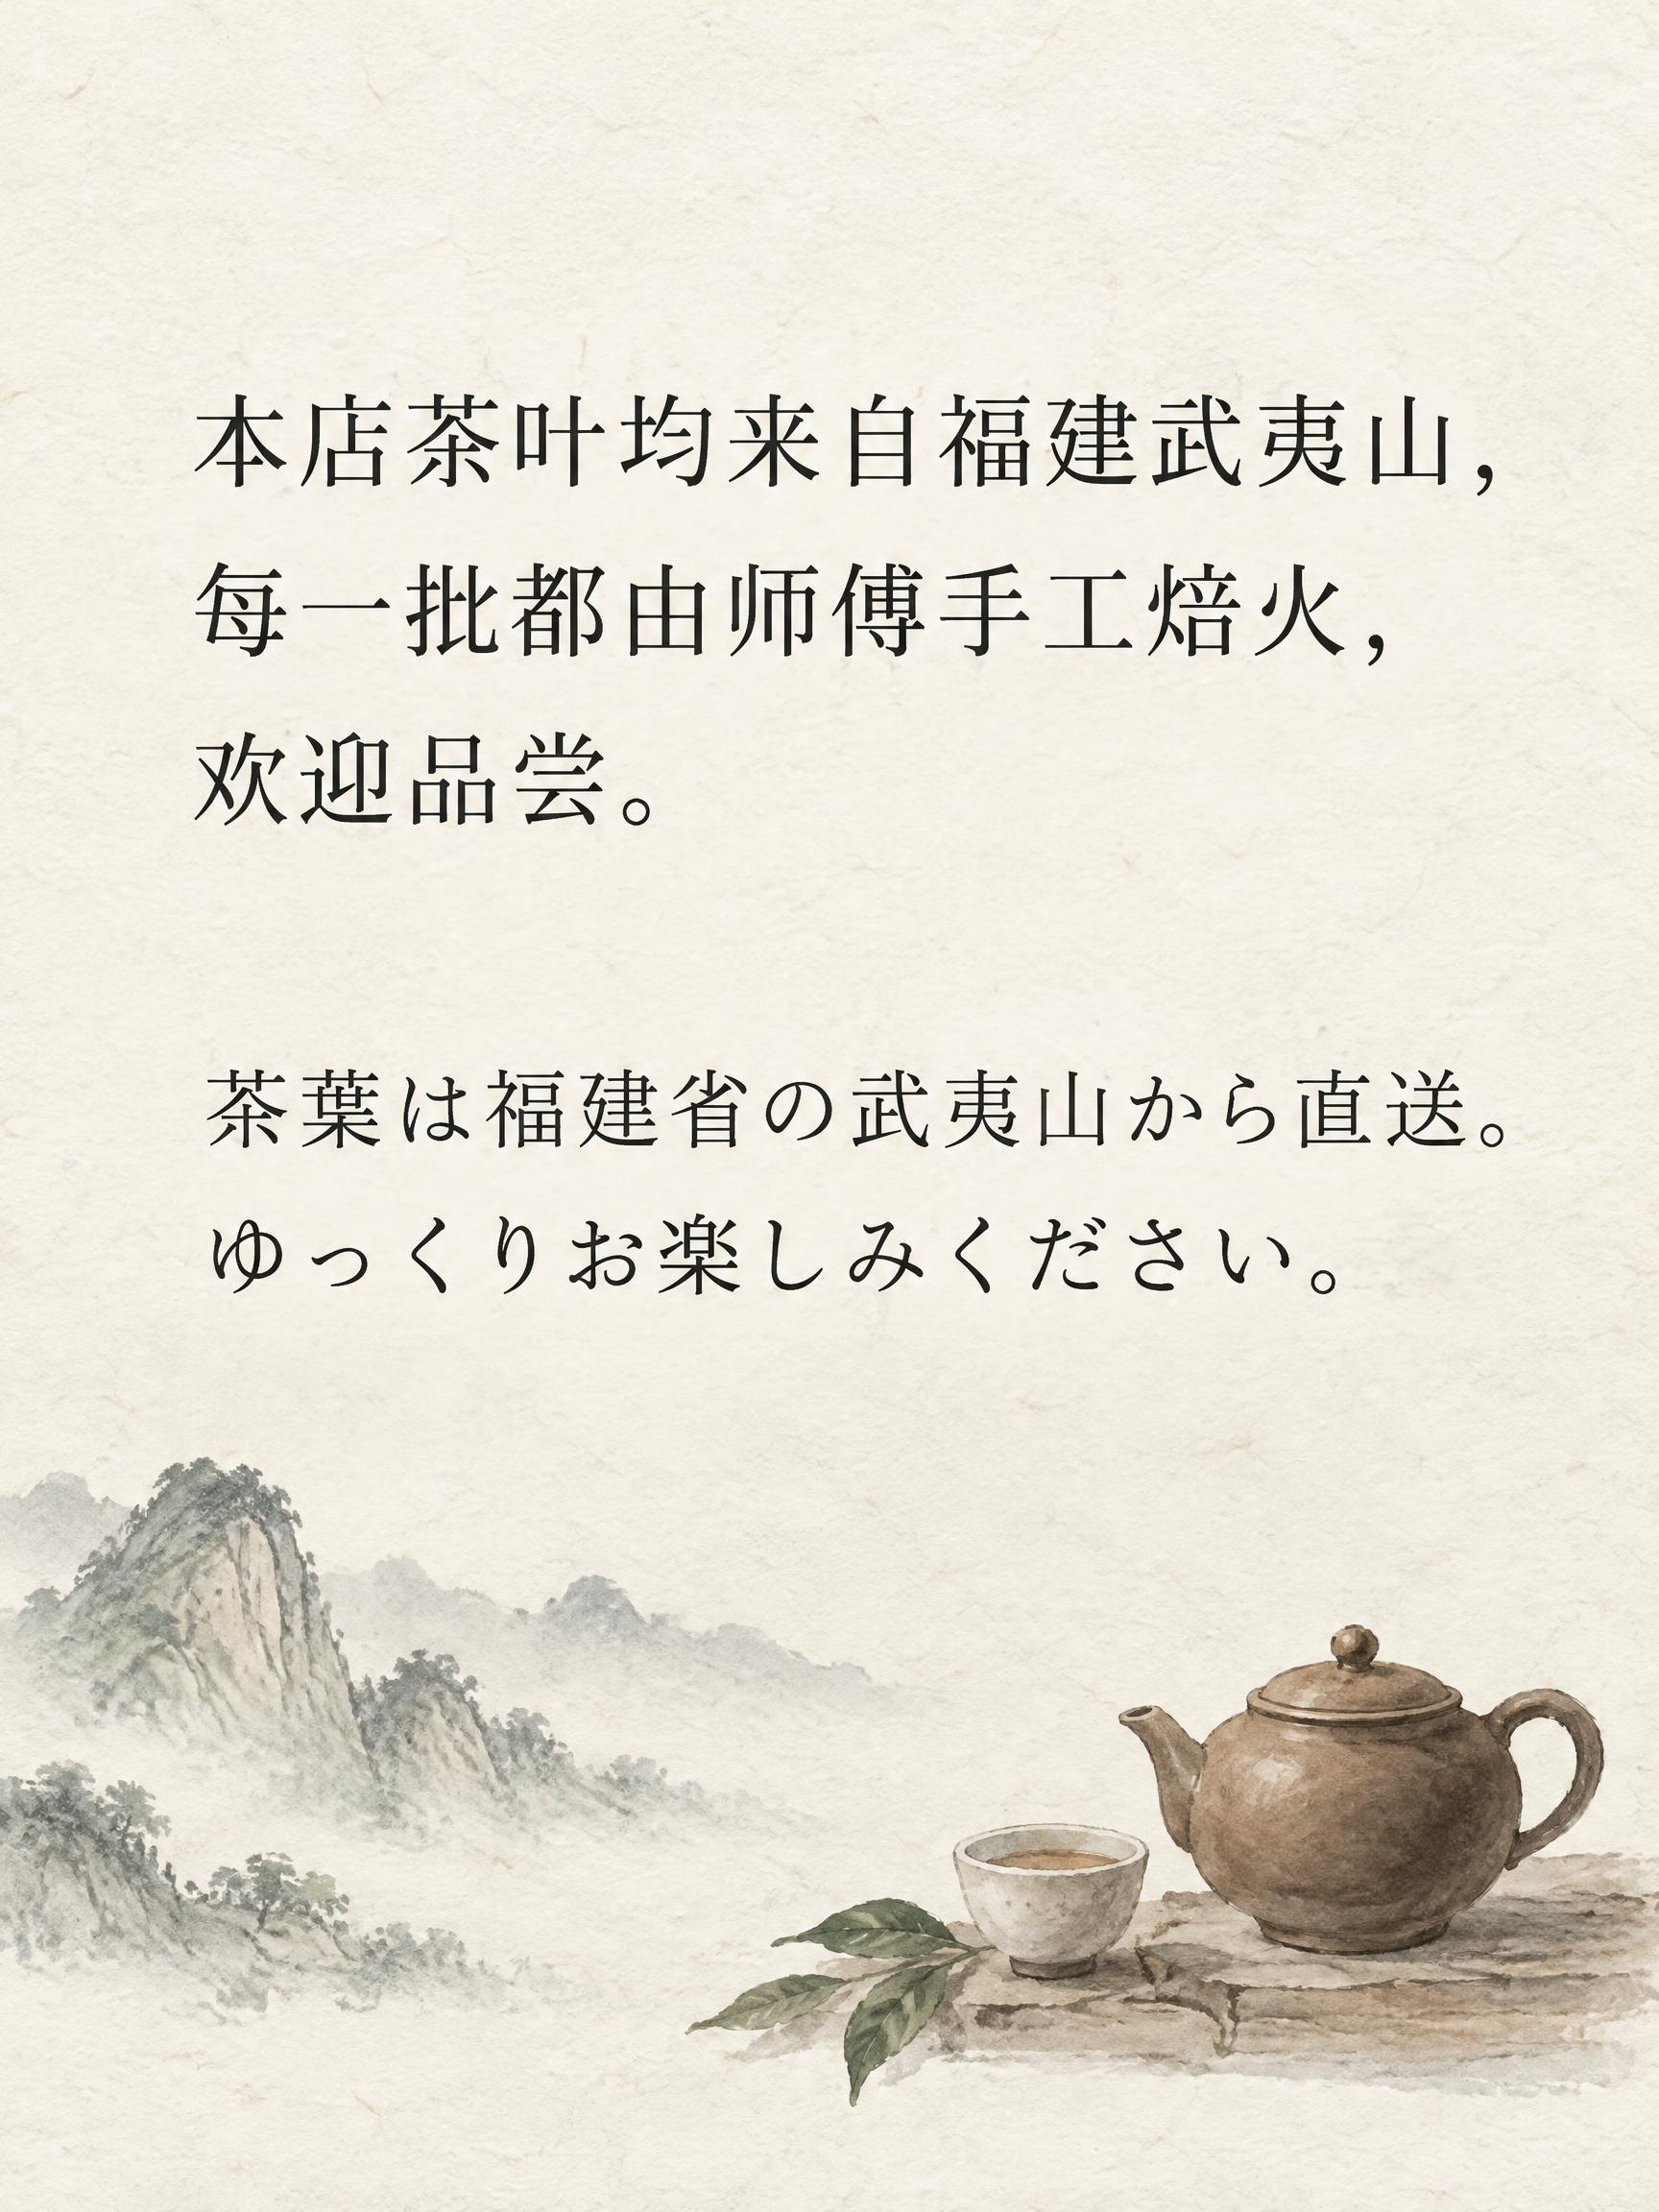
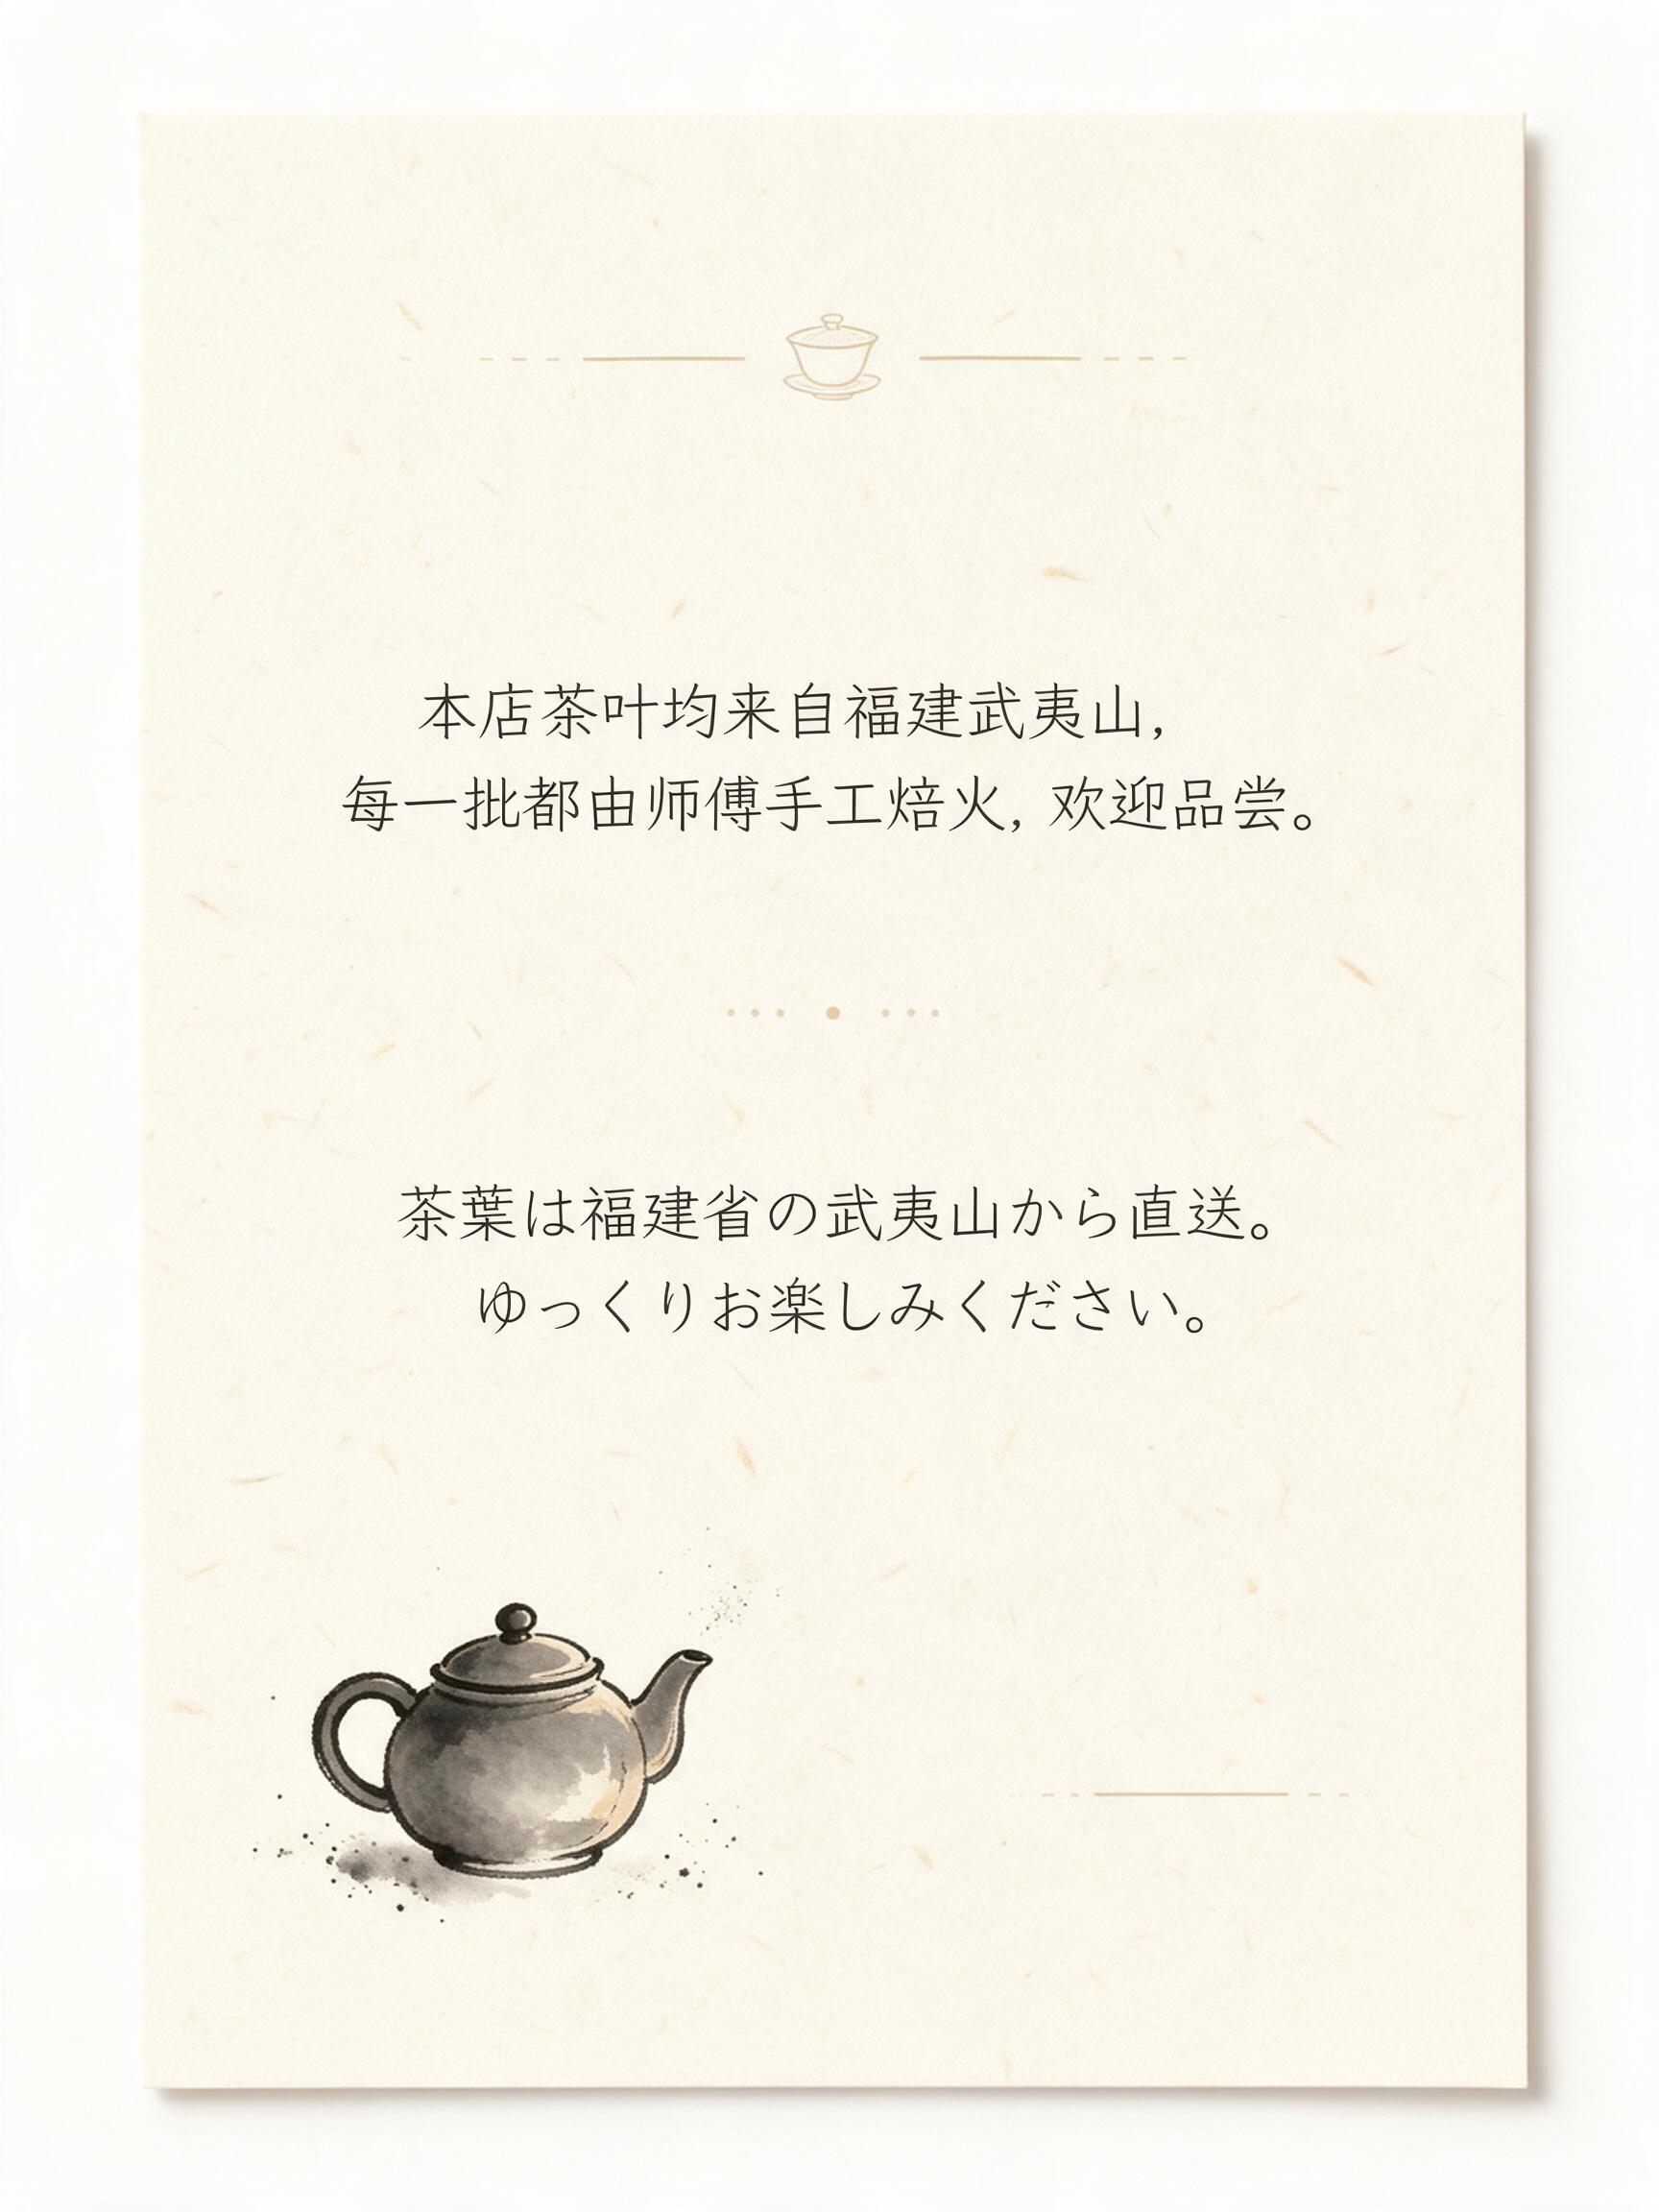
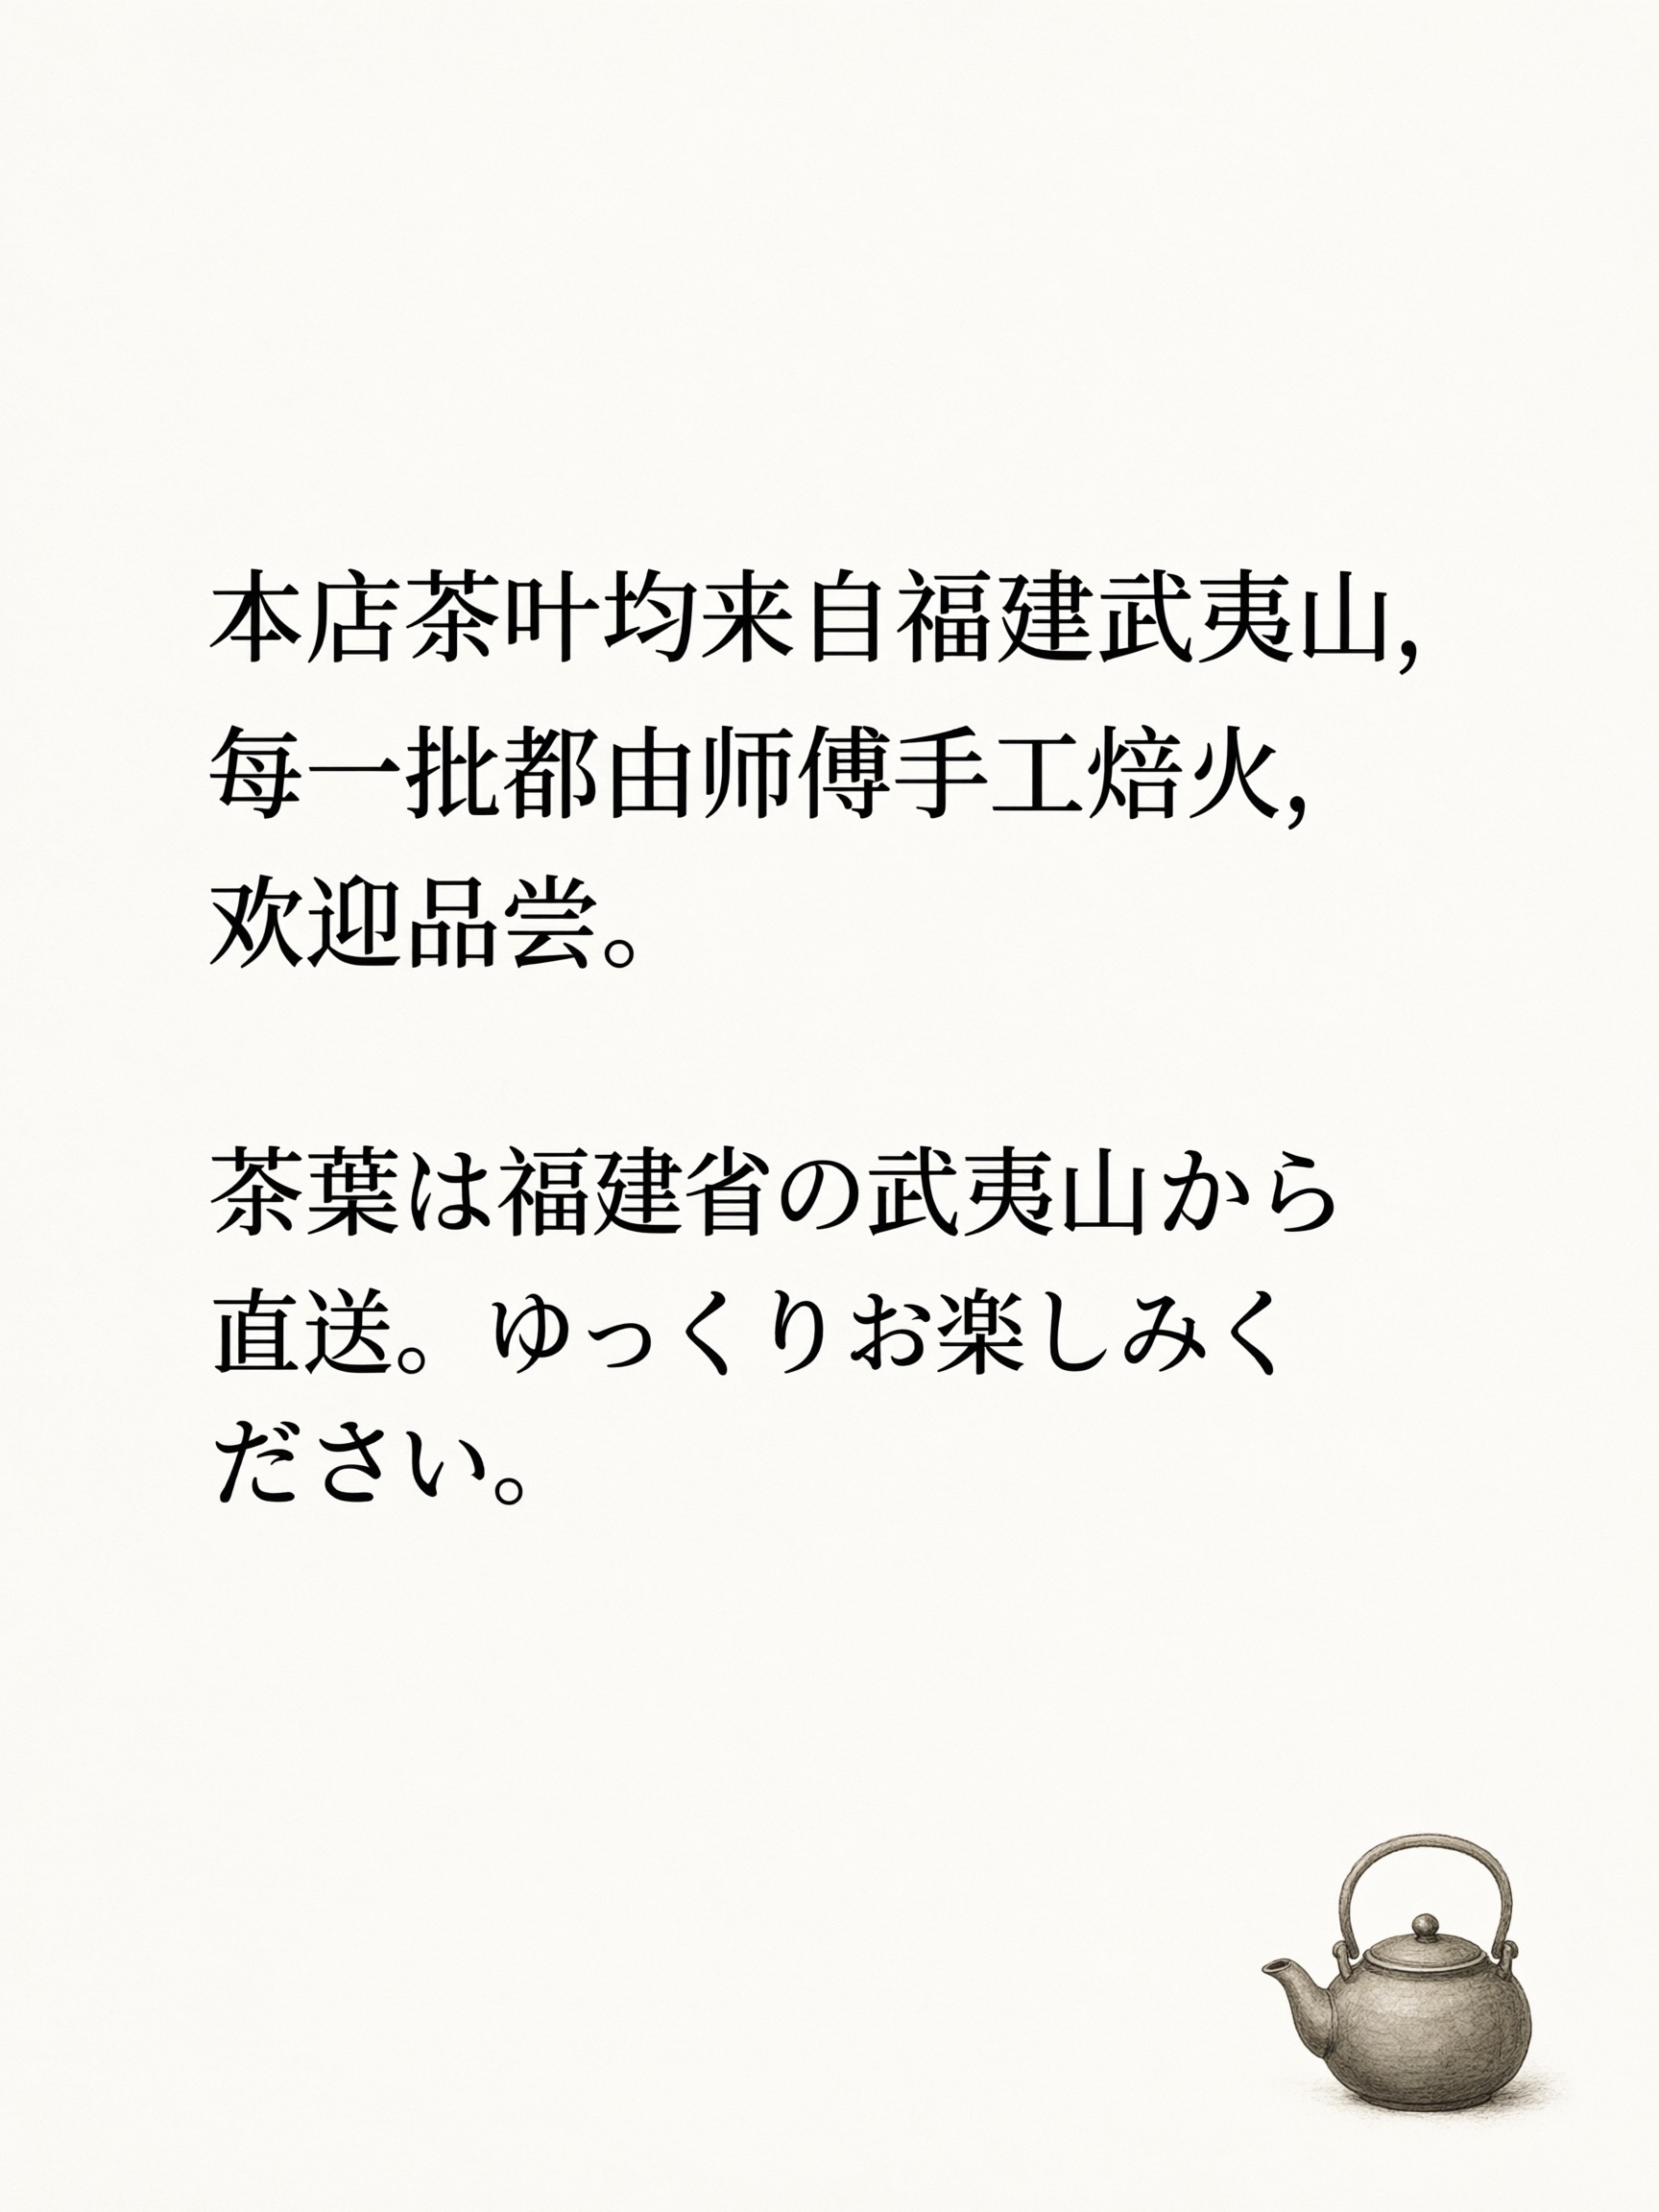
15 张中日双语茶馆卡片每个字都对,包括中文的傅、焙、夷和日文的葉、楽。有的模型用了半角逗号,算标点差别,不算错。这题只考模型能不能照抄中日文各一句短句,说明不了更长的中日文。
和 10 月测试同一张海报
第 1 题 BURNING ORCHARD 演出海报,用的是 10 月 Grok Imagine 2.0 实测和 Qwen Image 3.0 实测里的同一条提示词,一字不改。第 2 题咖啡店菜单沿用了 Grok 那篇的另一条提示词。
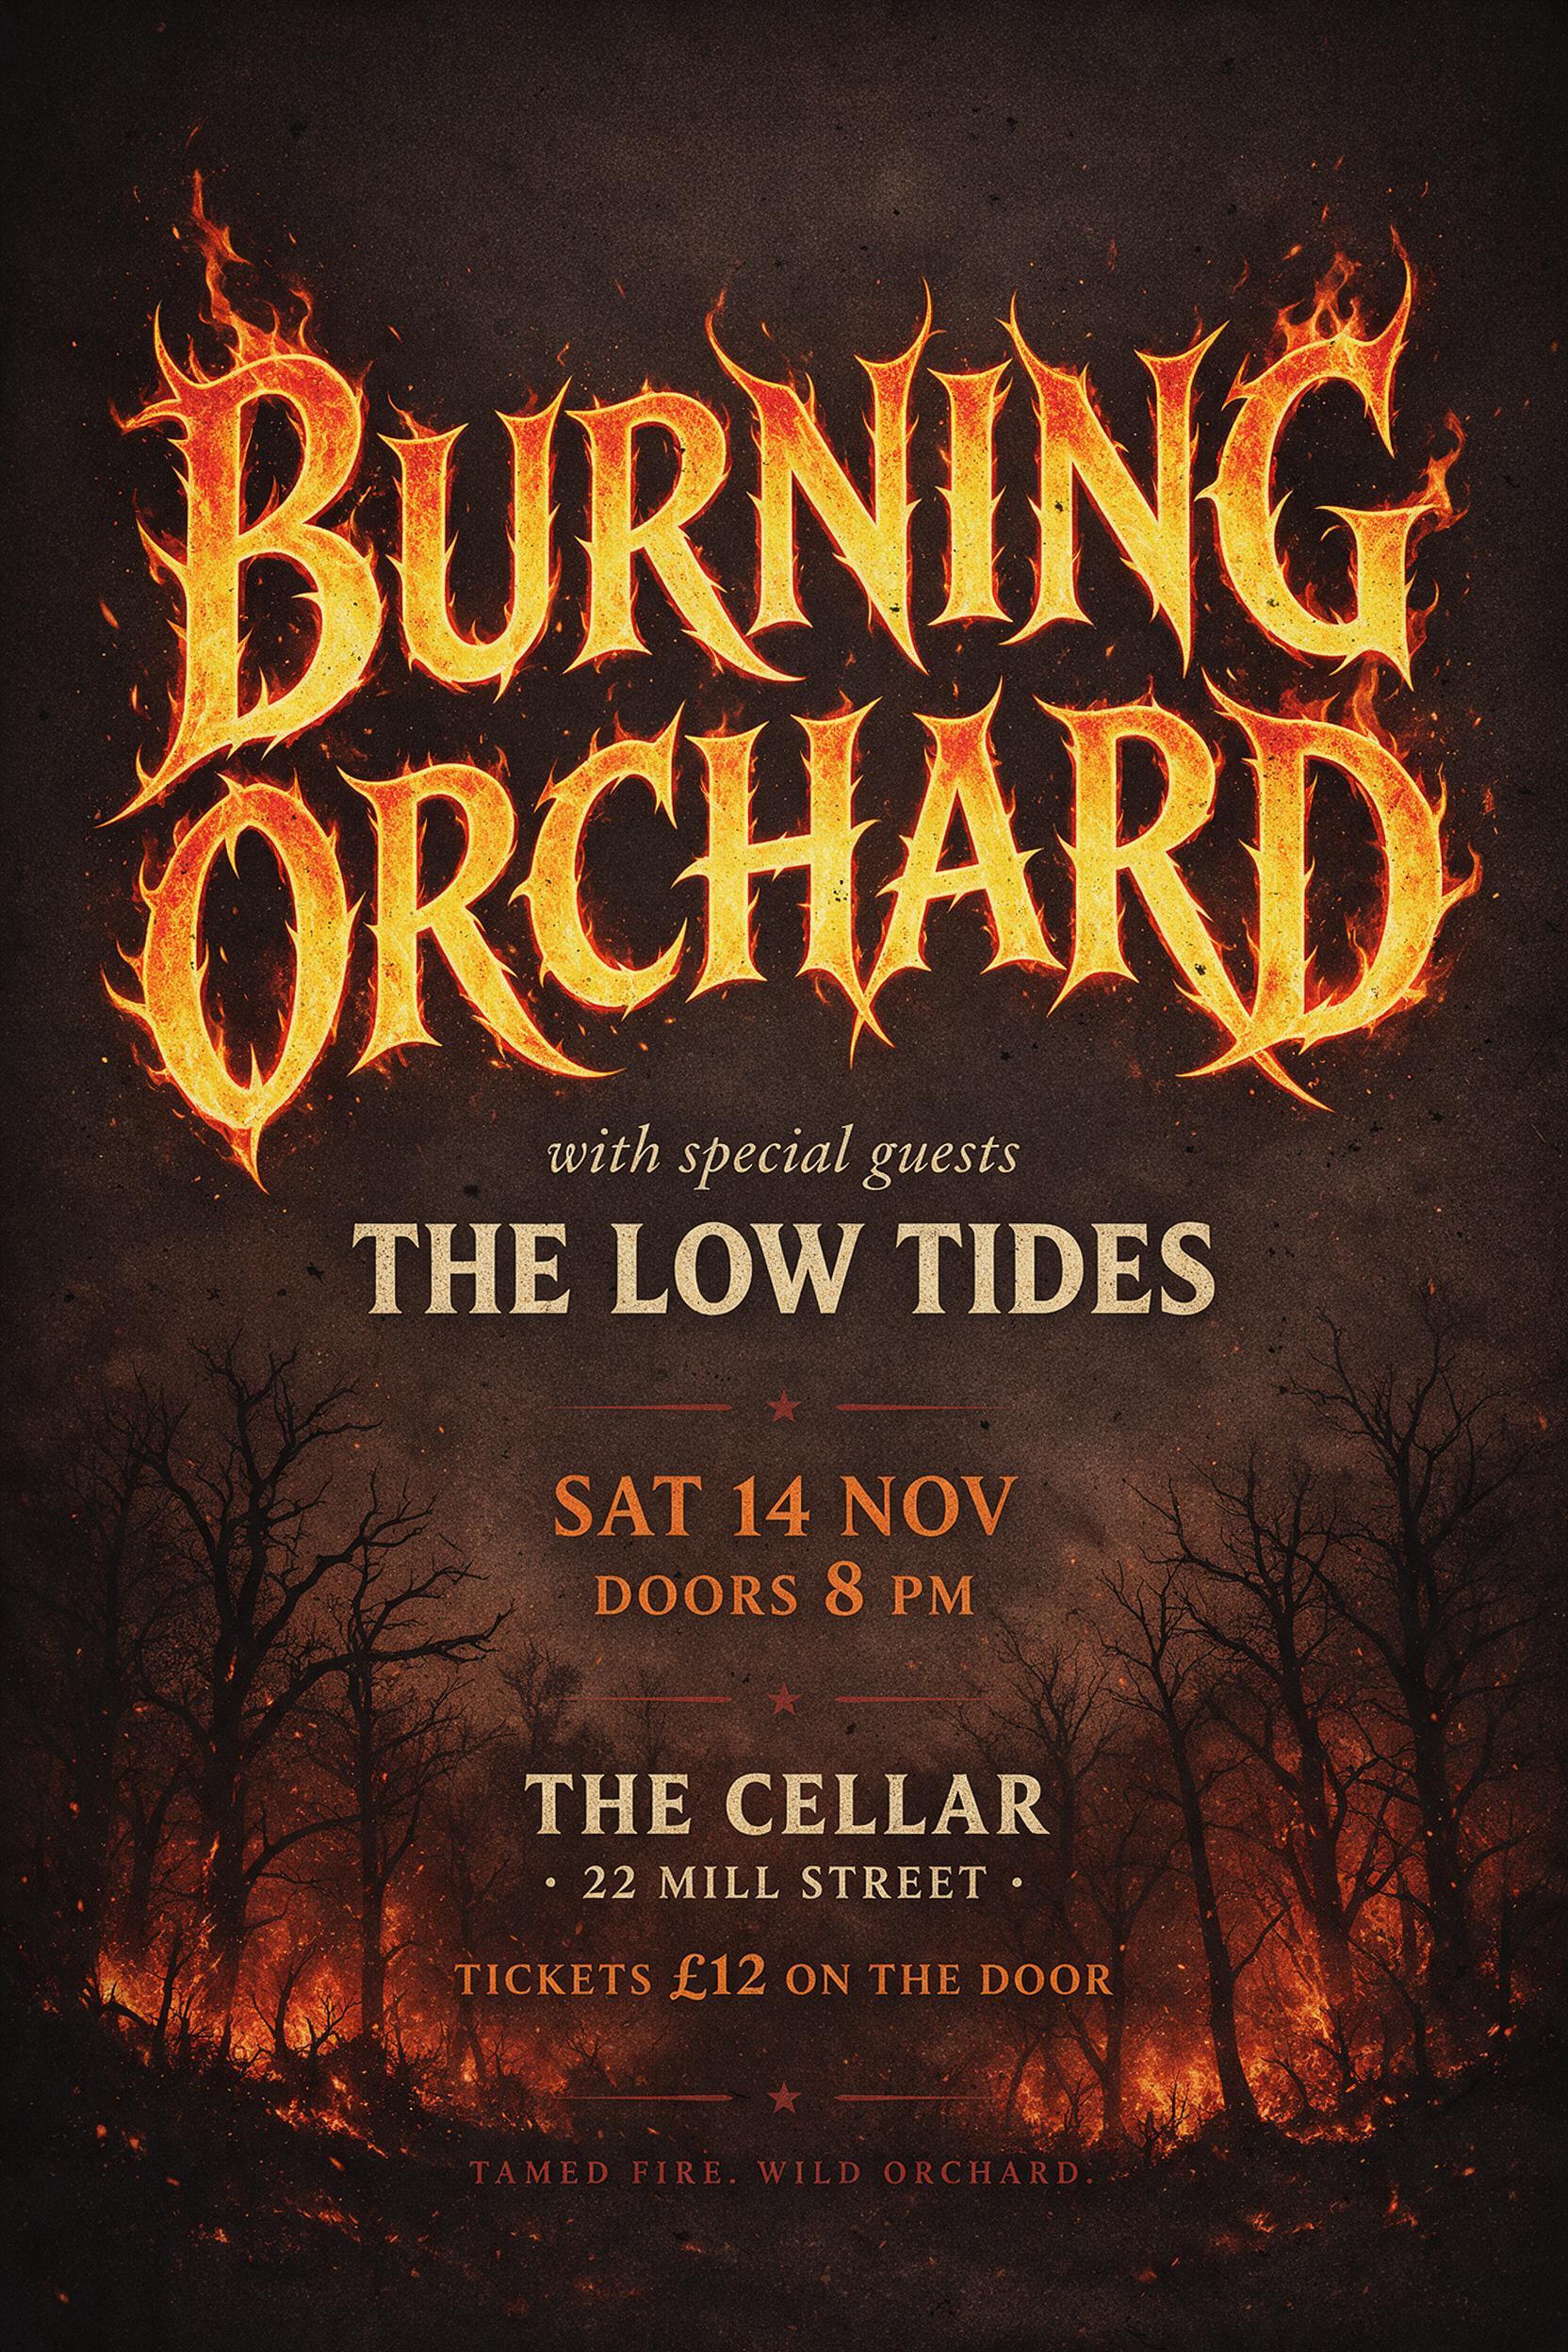
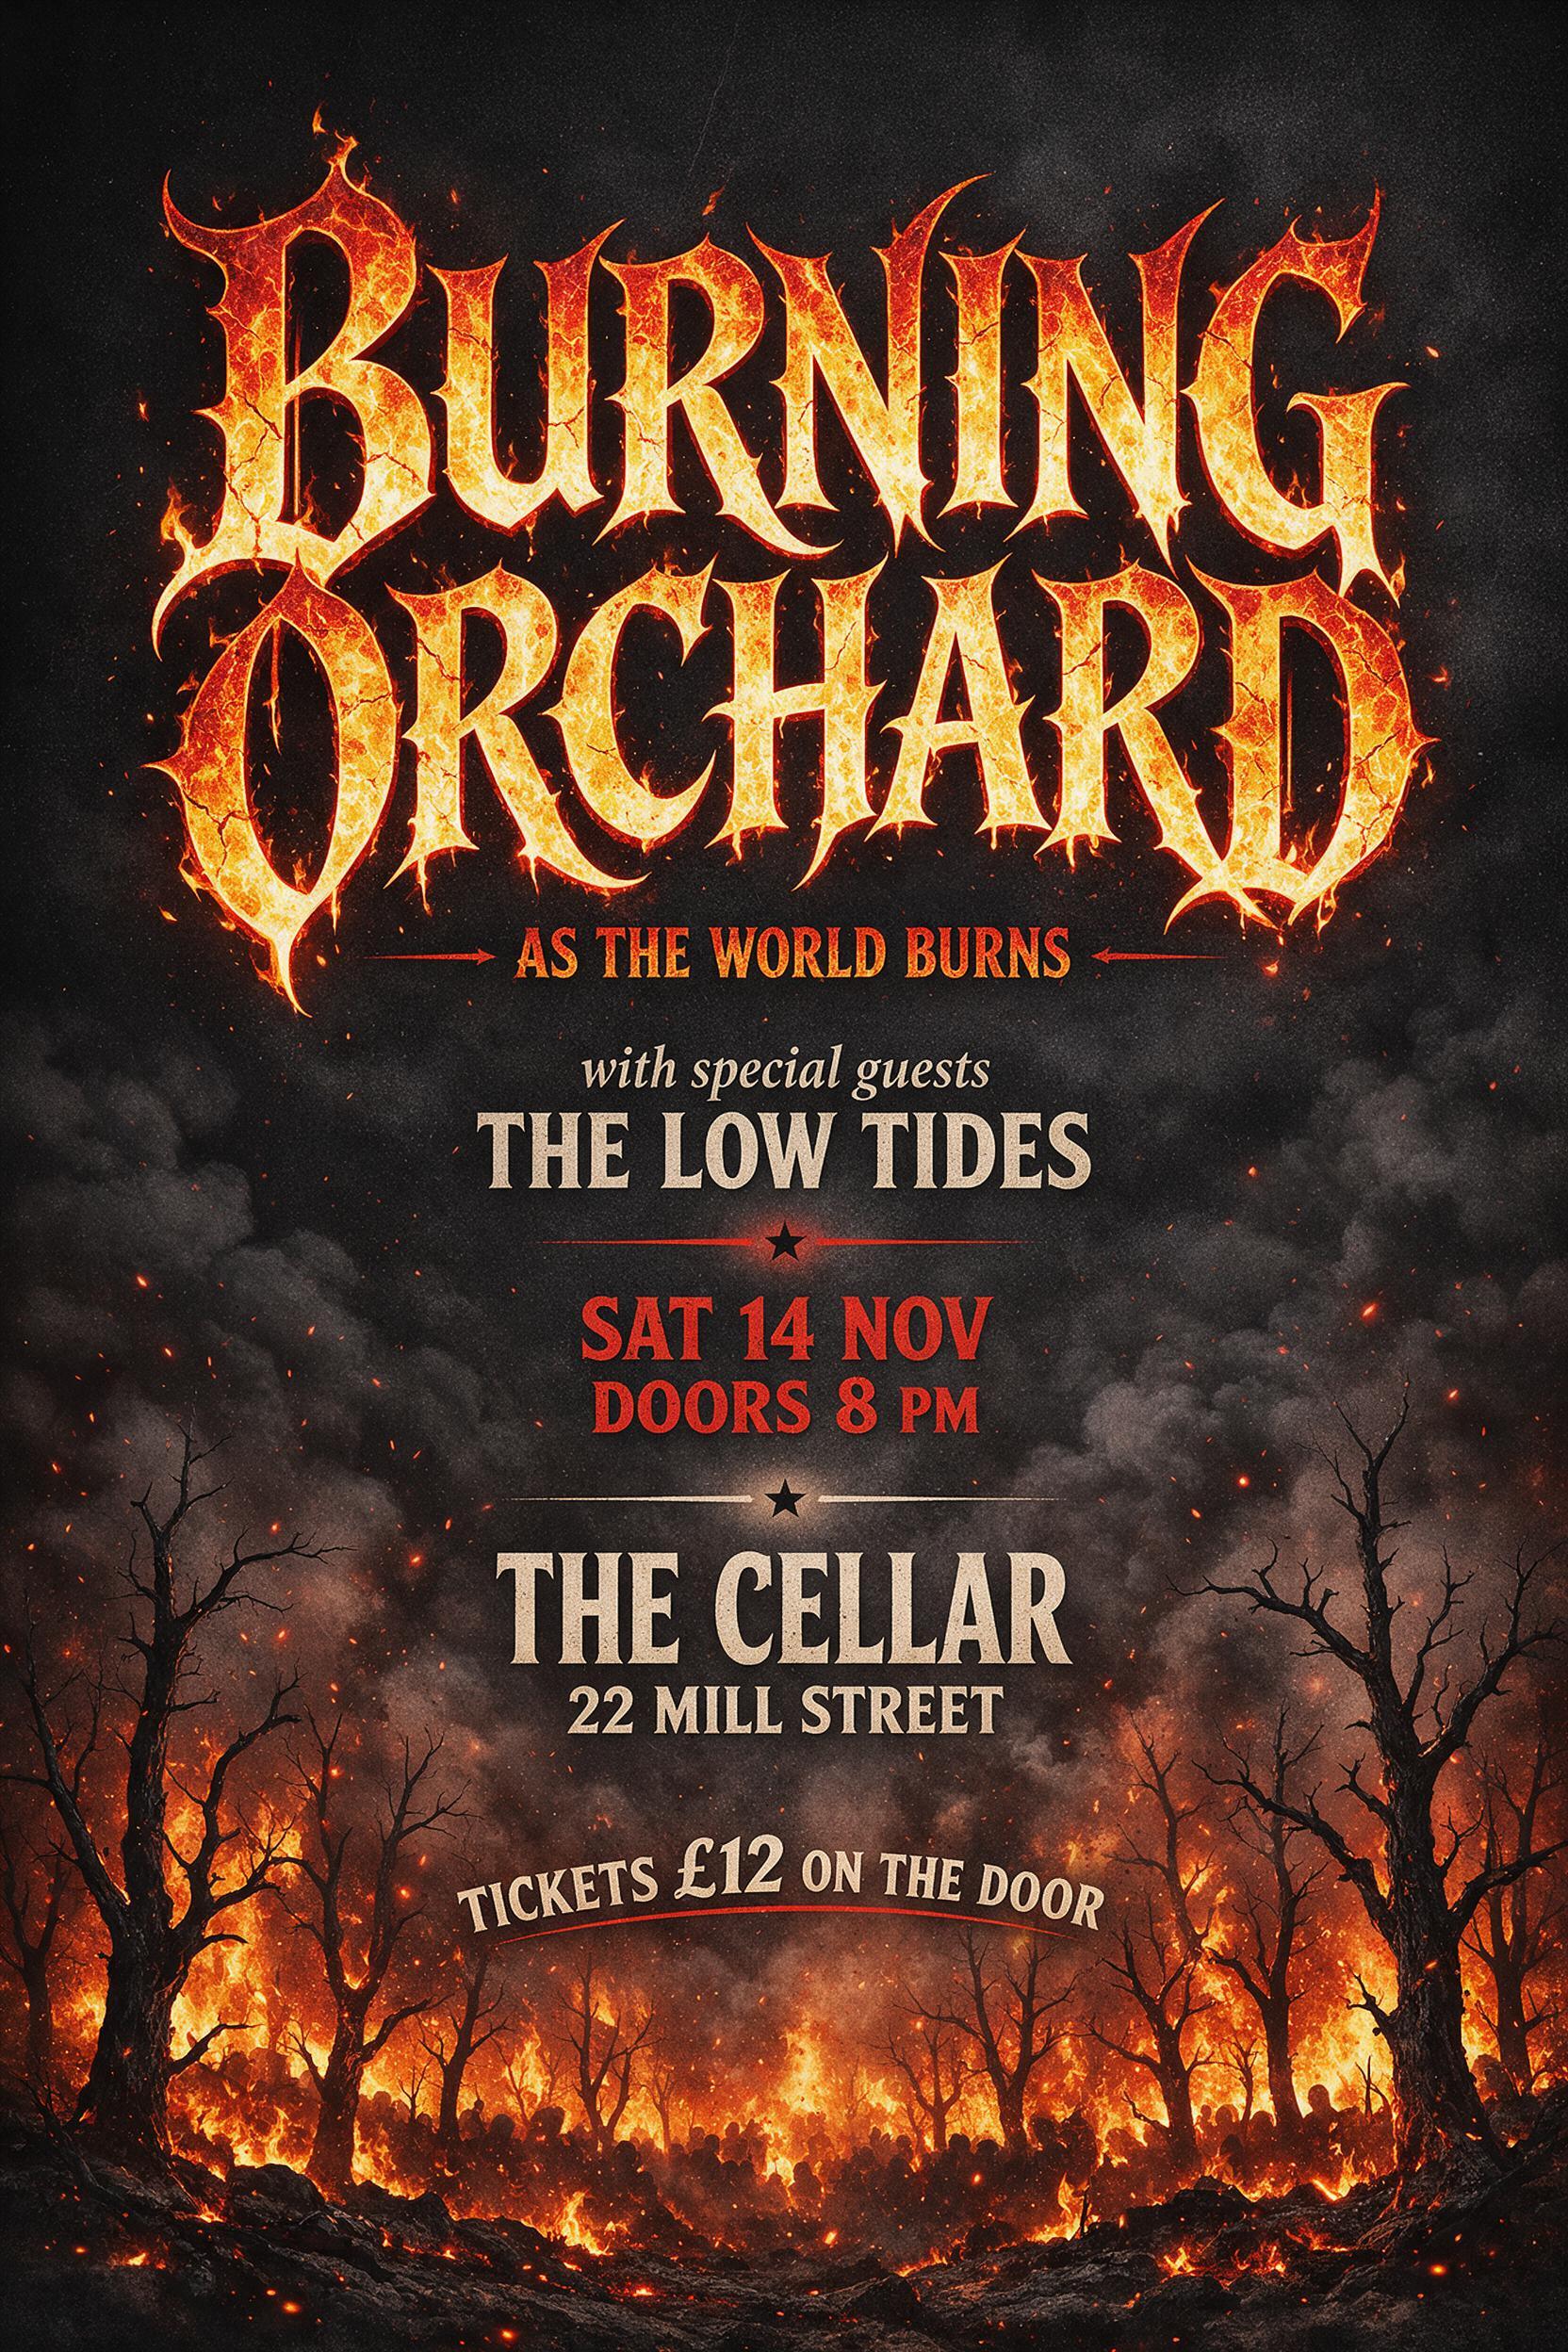
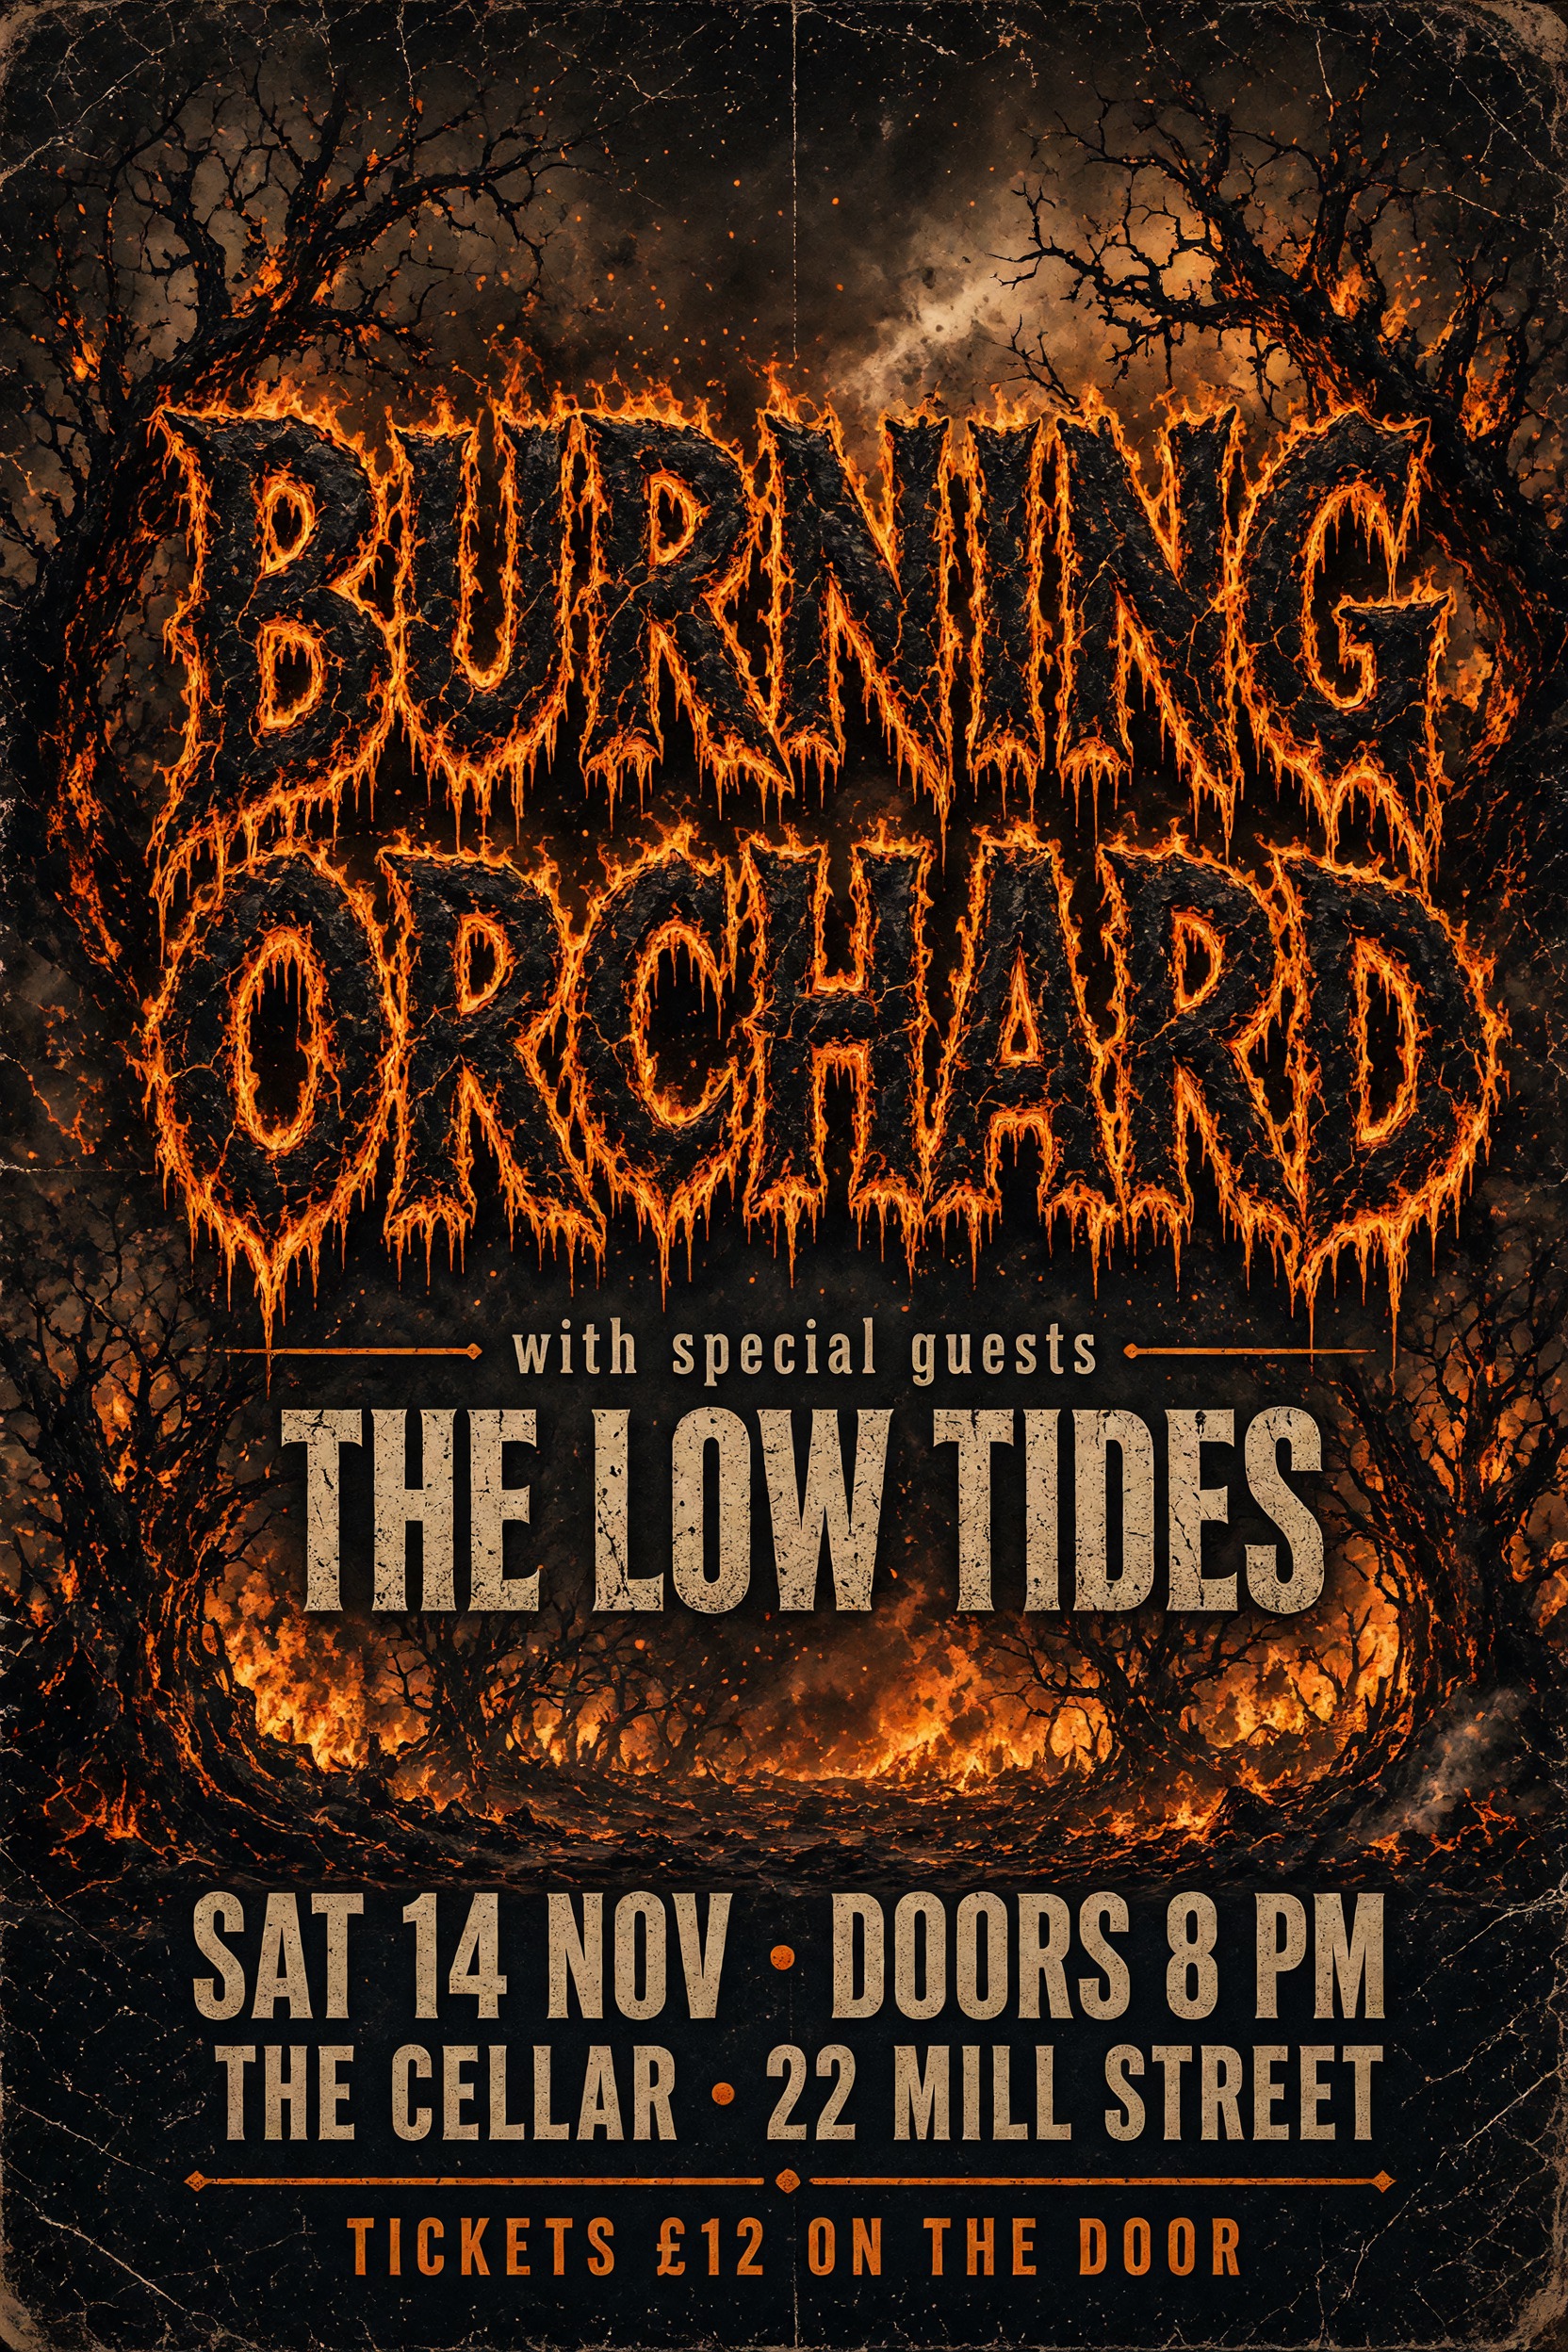
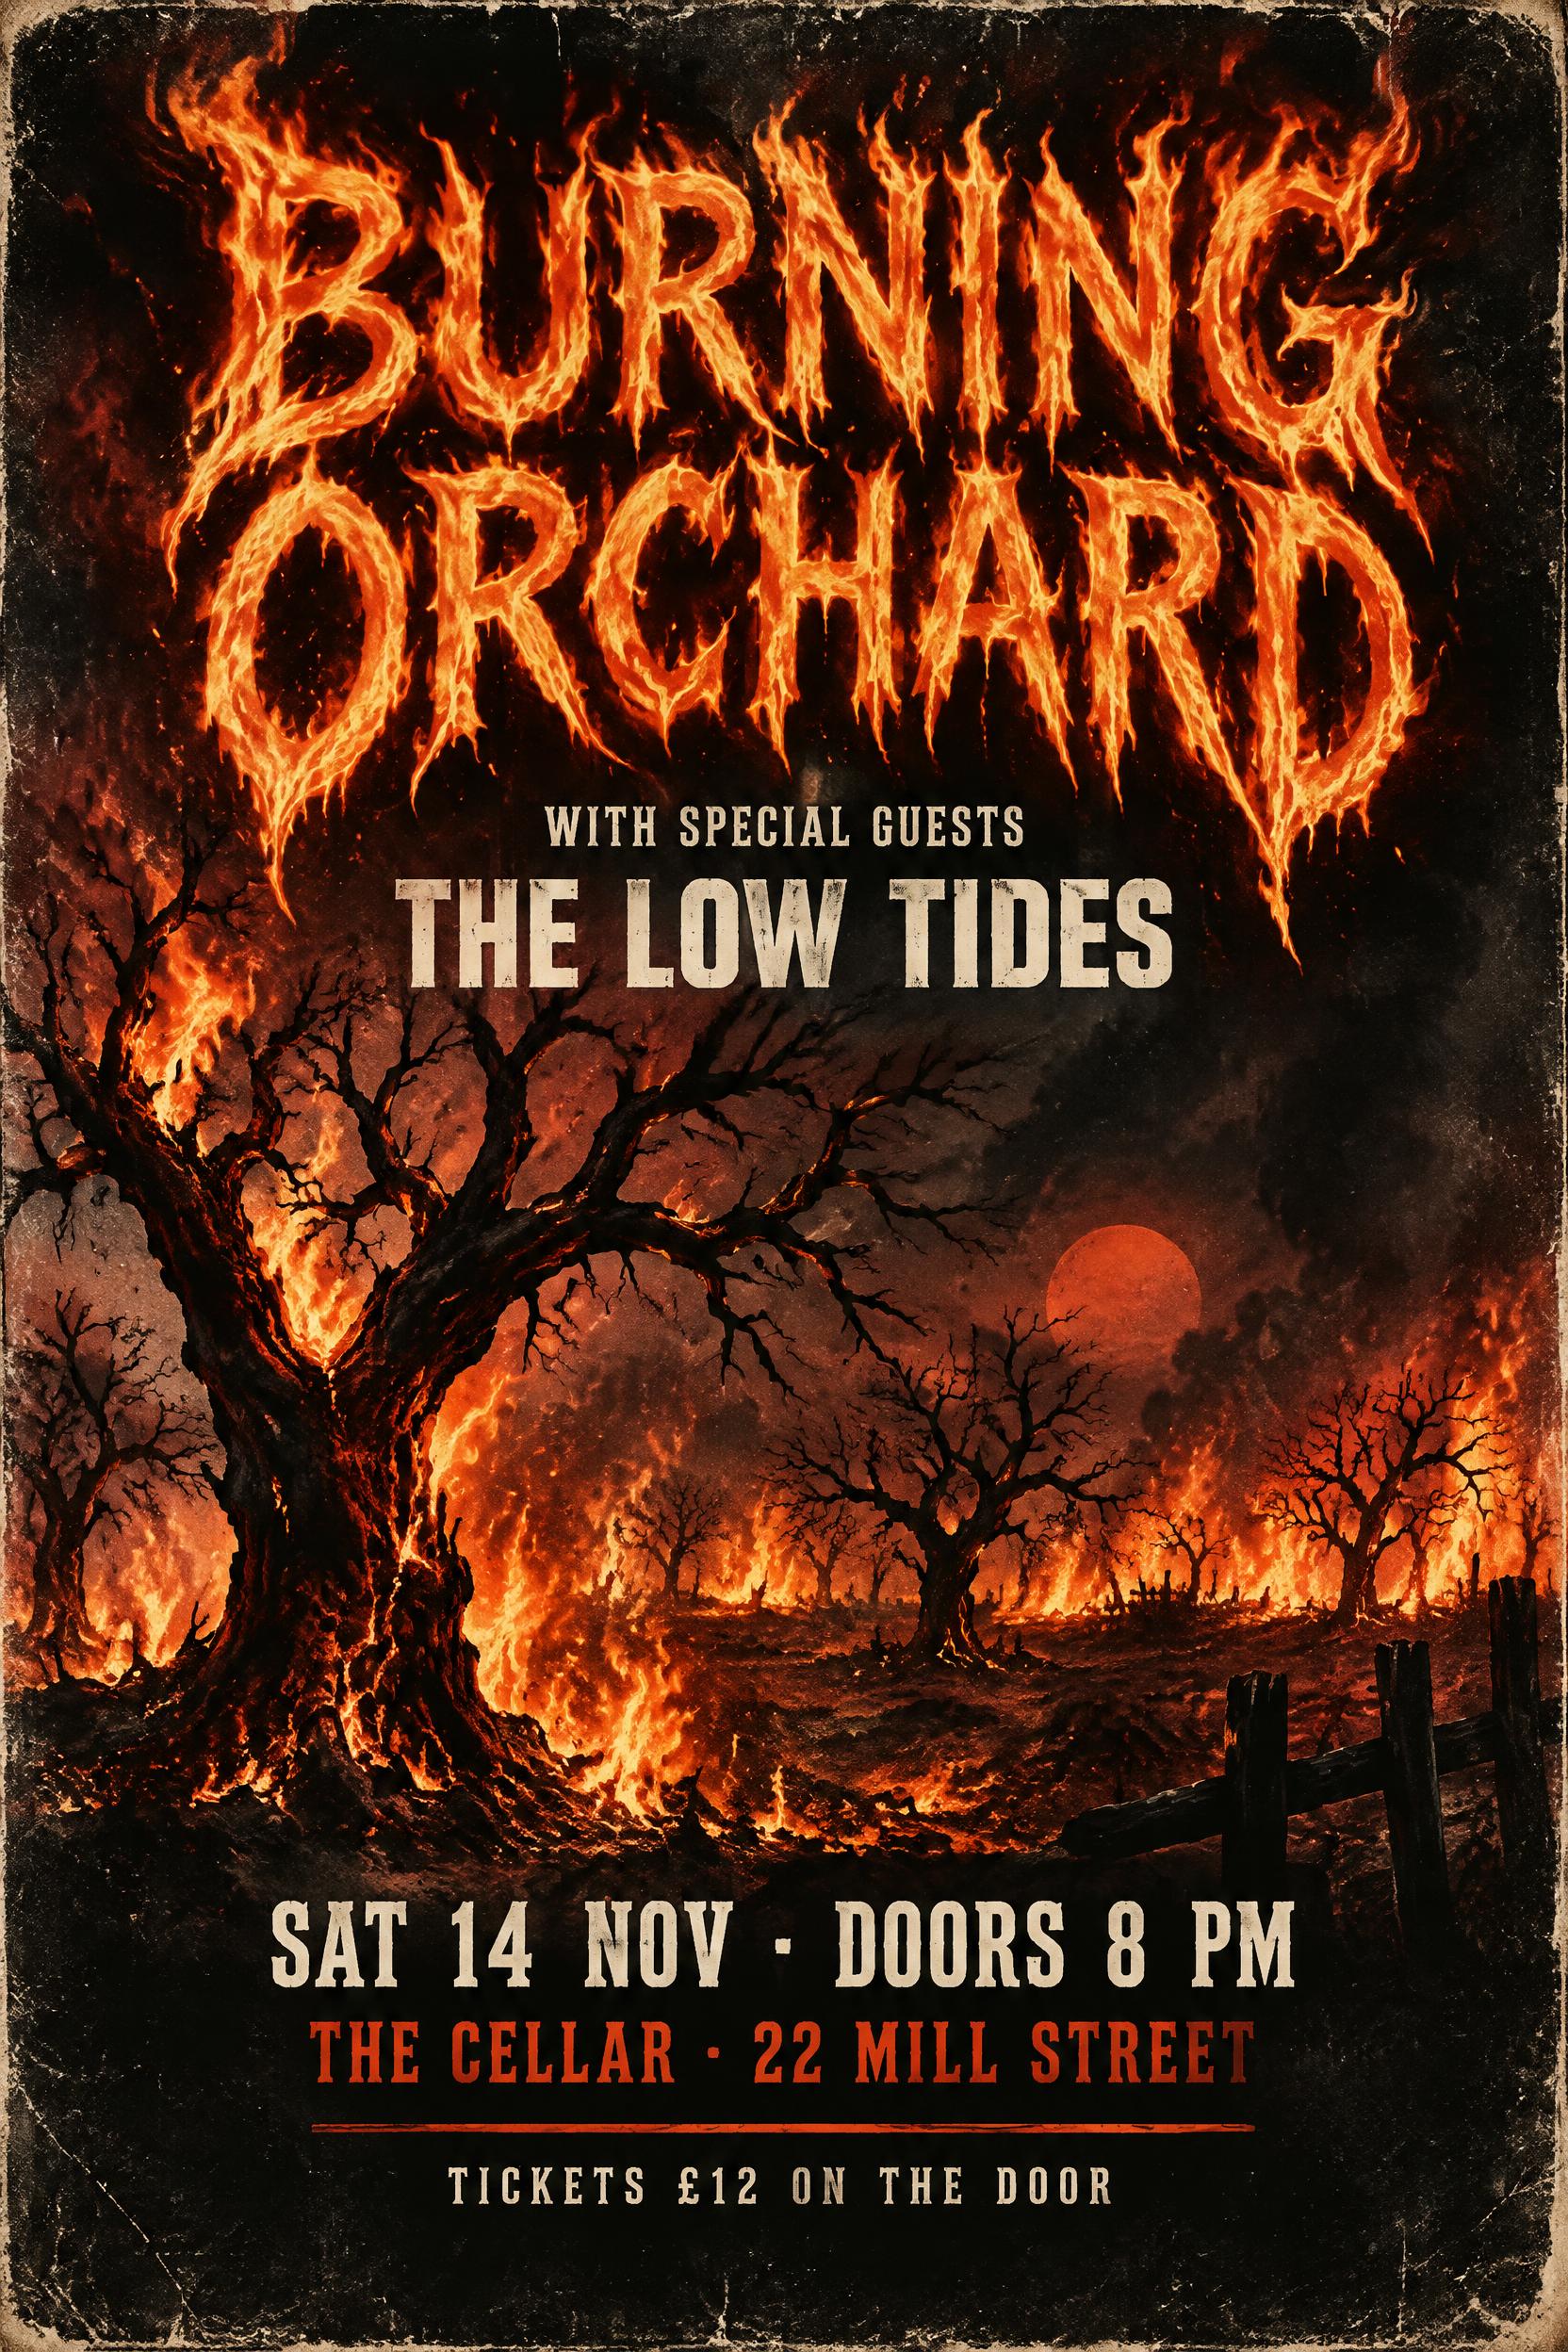
15 张海报、15 张菜单全部拼对,和 10 月一样。这两条提示词已经太简单,拉不开现在这些模型。变化在多出来的字:Seedream 5.0 Pro 3 张海报都加了提示词没要的一行(两次是标语,一次是主办方名)。我们把它记作「自加文字」,不算错。自加文字在所有题里都只记录、不算错,包括提示词写了「no other text」的第 3–10 题(Qwen Image 3.0 Pro 在第 6 题有两张门票加了字)。不想要多余的字,提示词里写明,出图后也要再看一眼。想直接套用火焰字,可以看火焰字风格。
写字准的 AI 生图模型怎么选
准确度分不出前四款,所以选哪个要看画面效果、价格和一些习惯。
设计分是另一个独立的维度。每张图由一位看不到模型名的 AI 评审打分:可读性(占 20%)、字体效果(35%)、信息与版面(25%)、第一眼观感(20%)四项各打 1–10 分,加权平均就是设计分,满分 10。按评审的尺子,9–10 分是想要的效果全部做到、做得精致、版面讲究;7–8 分是干净专业但偏通用,或细节有瑕疵;5–6 分是效果只做到一半,或和要求有明显偏差。下面是平均分和 95% 区间:
| 模型 | 设计分 | 95% 区间 |
|---|---|---|
| Grok Imagine 2.0(Medium,它两档里较高的一档) | 8.01 | 7.86 – 8.17 |
| GPT Image 2.5 Sunburst(Medium,比默认的 High 低一档) | 7.91 | 7.62 – 8.20 |
| Nano Banana 2.1 | 7.69 | 7.34 – 8.07 |
| Seedream 5.0 Pro | 7.25 | 6.73 – 7.76 |
| Qwen Image 3.0 Pro | 5.82 | 5.02 – 6.55 |
判断标准和准确度一样:两款逐题配对比,差值的 95% 区间包含零就算打平。按这个标准,Grok Imagine 2.0、GPT Image 2.5 Sunburst 和 Nano Banana 2.1 设计分打平,Nano Banana 2.1 和 Seedream 5.0 Pro 也打平。Grok Imagine 2.0 和 GPT Image 2.5 Sunburst 高于 Seedream 5.0 Pro(差值 +0.76 和 +0.67,95% 区间分别是 +0.24 到 +1.28、+0.06 到 +1.23)。四款都高于 Qwen Image 3.0 Pro。
- 要画面最好: Grok Imagine 2.0、GPT Image 2.5 Sunburst 或 Nano Banana 2.1。三款设计分打平,凭这些数字我们不会说哪个更好。
- 预算有限: Nano Banana 2.1,每张 25 积分,FontVibe 上五款里最便宜;30 张零错,设计分和 Grok Imagine 2.0、GPT Image 2.5 Sunburst 打平。
- Seedream 5.0 Pro: 30 张零错,但设计分低于 Grok Imagine 2.0 和 GPT Image 2.5 Sunburst,而且每张演出海报都自己加了字。提示词里加上「no other text」。
- Qwen Image 3.0 Pro: 不管多长都要逐字检查。本次测试里 26 个和 34 个英文单词的两题、价目表、生造词、中日文卡片都写对了;但三行的面包店橱窗字 3 张都有字母错,门票 3 张里有 1 张订单号写错,72 个英文单词时 3 张错 1 张,117 个英文单词起每张都错。没法逐字校对的话,换前面四款。
五款模型都在 FontVibe 生成器的模型菜单里,文中每张图都有 Recreate 按钮,可以用同一条提示词再出一张。这个话题的其他测试都收在文字渲染专题页。
怎么测的
模型。 2026 年 11 月 9 日 FontVibe 用户能选到的、五家公司各自最新的模型,全部 2K。(OpenAI 的 GPT Image 2.6 第二天才接入 FontVibe,单独补测,见下文。)
- GPT Image 2.5 Sunburst(OpenAI),Medium 画质。 FontVibe 对这款模型的默认档是 High。我们测的是它下面一档 Medium。High 及以上没有测,可能更准。
- Grok Imagine 2.0(xAI),Medium 画质,它两个档位里较高的一档。
- Seedream 5.0 Pro(字节跳动),没有画质档。
- Nano Banana 2.1(Google),没有画质档。
- Qwen Image 3.0 Pro(阿里巴巴),没有画质档。
题目。 10 道题,用普通英语写,品牌名都是编的,电话用北美留给虚构作品的 555-01xx 号段,不用任何一家模型专有的写法。每题的必需文字事先逐行定好。第 1–5 题文字量递增(26、34、72、117、189 个英文单词)。第 6–10 题各考一类难点:带数字和地址的门票、价目表、生造词、重音字母、中日文。第 3–10 题末尾都写了「no other text」。
出图。 每条提示词通过 FontVibe 的 DIY 模式原样发给每款模型,DIY 模式不改写提示词。画幅用参数设定。每款模型每题出 3 张:5 款 × 10 题 × 3 张 = 150 张,2026 年 11 月 9 日(UTC)生成。返回的图一张都没有重跑、丢弃或挑选。GPT Image 2.5 Sunburst 有一次请求在厂商那边报错、没有返回图,重新发了一次,就是附录里的 107902。150 张图都在 FontVibe 上公开。
GPT Image 2.6(11 月 10 日补测)。 GPT Image 2.6 Sunburst 和 GPT Image 2.6 Flare(OpenAI),都是 2K、Medium 档(FontVibe 对两者的默认档都是 High),同样的 10 道题、同样的跑法:2 个型号 × 10 题 × 3 张 = 60 张,2026 年 11 月 10 日(UTC)生成。没有请求失败,没有一张重跑、丢弃或挑选。60 张都在 FontVibe 上公开,列在附录。
怎么数的
读图。 两家公司的视觉模型 Claude Opus 5.5(Anthropic)和 Gemini 3.7 Flash(Google)各自把每张图上的所有文字转写一遍。它们看不到必需文字,所以不会顺手把看到的字纠正过来。Anthropic 没有模型参赛。Gemini 3.7 Flash 和 Nano Banana 2.1 是同一家公司的,所以两家转写不一致的地方,一律不以任何一家的读法为准,都要对着原图再核一遍(见下一段)。
比对。 脚本把每条必需文字和两份转写里最接近的一段做比对。脚本标出的每一行、两家读法不一致的每一行、每一条可能的自加文字,再由 Claude Opus 5.5 单独做一遍核对:这次给它看必需文字,让它对着放大的原图记下图上实际印的字。这一步 AI 核对的结果就是最终结果(见测试的局限)。
什么算错。 必需文字里的字母、数字、重音、符号(& # @ % / $ £ +)写错、漏写或多写。模型自己多加的整行字记作自加文字,不算错。原图分辨率下认不出的文字按漏写算。大小写、标点替换和换行只记录、不算错。小数点变了算错(3.20 写成 320);本次没有出现。
已知的盲区。 转写模型有时会读成它以为该有的词,而不是图上实际印的词。千问的一张背标上印的是 Colories,Gemini 3.7 Flash 读成了正确的 Calories;Claude Opus 5.5 照实读出,两家不一致,对着原图核对后确认是错字。如果两家犯了同一个错,这一行就会被放过,因为两家读法一致、又和必需文字吻合的行,不再对着原图核对。为了查这部分,又另外用 Claude Opus 5.5 对着放大的原图,把 15 张图(每款 3 张,偏向最难的题)的每一条必需文字逐字重读了一遍。15 张全部和我们的结果一致,没有发现漏判。
统计。 每款模型报零错图、写对的行和错字符。两款比较时,我们逐题配对、重抽样 10,000 次。差值的 95% 区间包含零,就算两款打平。
设计分。 由一位 AI 评审(Claude Opus 5.5,也是两个转写模型之一)在看不到模型名的情况下给每张图打分,用的是我们之前几篇测试的同一套四项评分:可读性 20%、字体效果 35%、信息与版面 25%、观感 20%。设计分用来在打平的模型之间挑选,不计入准确度结果。
GPT Image 2.6 的图走的是同样两个转写模型、同样的脚本、同样的对原图 AI 核对(有 2 张图的 2 行需要核)。另开的 Claude Opus 5.5 核对员把 60 张里的 6 张(每个型号 3 张,难题多抽)每一条必需文字逐字重读,6 张都和我们的结果一致。它们的设计分来自单独一轮,同样看不到模型名,那一轮放进了 30 张 GPT Image 2.5 Sunburst 作对照,见上文。
测试的局限
- GPT Image 2.5 Sunburst 测的是 Medium,不是 FontVibe 的默认档 High。 它的结果说的是 Medium。更高的档位可能更准。
- 结果里没有人工逐字核对。 读图和核对全部由 AI 完成:两家转写、对着原图核对标出的行、15 张图的逐字重读(GPT Image 2.6 另抽 6 张)都是。核对用的是 Claude Opus 5.5,和其中一家转写是同一个模型。如果这几轮 AI 都读错了同一处,这个错不会出现在我们的结果里。
- 最长的文本是 189 个英文单词。 四款模型在这个长度都没错,所以它们的上限不知道。本轮没测更长的文本。
- 每款每题 3 张。 足够把一款常出错的模型和四款很少出错的分开,不够给四款各错 0 或 1 张的模型排名次。
- 更新的模型。 GPT Image 2.6 于 11 月 10 日接入 FontVibe,当天补测,只测了 Medium 档,High 及更高档没测。11 月 10 日之后接入 FontVibe 的模型不在本次测试里。等它们在 FontVibe 上接入后,我们会补测并更新这篇。
- 非英文只测了短文本。 中文、日文各一句,西 / 葡 / 德各一行。
- 结果对应的是这些模型 2026 年 11 月 9 日的版本(GPT Image 2.6 是 2026 年 11 月 10 日)。
如果你用这些提示词重跑、结果差别很大,请发邮件到 hello@fontvibe.ai,我们会补进这篇。
这几款模型在长文以外的设计任务上谁强谁弱,见我们的 Grok Imagine 2.0 实测和 Qwen Image 3.0 实测。测 AI 工具(而不是模型)的,见我们的 AI 文字特效生成器横评。
附录:全部 210 张图
每格链接到 FontVibe 上的那张图,后面是必需文字里错了几个字符。第一张表是主测试的 150 张;11 月 10 日补测的 60 张 GPT Image 2.6 在第二张表。
| 题 | 模型 | 第 1 张 | 第 2 张 | 第 3 张 |
|---|---|---|---|---|
| 1 | GPT Image 2.5 Sunburst(Medium) | 107744 零错 | 107748 零错 | 107749 零错 |
| 1 | Grok Imagine 2.0(Medium) | 107752 零错 | 107764 零错 | 107776 零错 |
| 1 | Seedream 5.0 Pro | 107754 零错,自加 1 行 | 107766 零错,自加 1 行 | 107777 零错,自加 1 行 |
| 1 | Nano Banana 2.1 | 107746 零错 | 107750 零错 | 107756 零错 |
| 1 | Qwen Image 3.0 Pro | 107745 零错 | 107751 零错 | 107757 零错 |
| 2 | GPT Image 2.5 Sunburst(Medium) | 107753 零错 | 107755 零错 | 107759 零错 |
| 2 | Grok Imagine 2.0(Medium) | 107789 零错 | 107800 零错 | 107809 零错 |
| 2 | Seedream 5.0 Pro | 107783 零错 | 107793 零错 | 107801 零错 |
| 2 | Nano Banana 2.1 | 107761 零错 | 107767 零错 | 107771 零错 |
| 2 | Qwen Image 3.0 Pro | 107763 零错 | 107768 零错 | 107773 零错 |
| 3 | GPT Image 2.5 Sunburst(Medium) | 107760 零错 | 107762 零错 | 107765 零错 |
| 3 | Grok Imagine 2.0(Medium) | 107818 零错 | 107826 零错 | 107832 零错 |
| 3 | Seedream 5.0 Pro | 107807 零错 | 107814 零错 | 107822 零错 |
| 3 | Nano Banana 2.1 | 107779 零错 | 107788 零错 | 107796 零错 |
| 3 | Qwen Image 3.0 Pro | 107780 零错 | 107786 错 40 字符 | 107794 零错 |
| 4 | GPT Image 2.5 Sunburst(Medium) | 107902 零错 | 107770 零错 | 107772 零错 |
| 4 | Grok Imagine 2.0(Medium) | 107841 零错 | 107848 零错 | 107853 零错 |
| 4 | Seedream 5.0 Pro | 107829 零错 | 107835 零错 | 107840 零错 |
| 4 | Nano Banana 2.1 | 107802 零错 | 107811 零错 | 107816 零错 |
| 4 | Qwen Image 3.0 Pro | 107799 错 75 字符 | 107803 错 1 字符 | 107810 错 2 字符 |
| 5 | GPT Image 2.5 Sunburst(Medium) | 107774 零错 | 107778 零错 | 107781 零错 |
| 5 | Grok Imagine 2.0(Medium) | 107859 零错 | 107865 零错 | 107870 零错 |
| 5 | Seedream 5.0 Pro | 107847 零错 | 107851 零错 | 107855 零错 |
| 5 | Nano Banana 2.1 | 107824 零错 | 107828 零错 | 107834 零错 |
| 5 | Qwen Image 3.0 Pro | 107813 错 10 字符 | 107820 错 9 字符 | 107825 错 106 字符 |
| 6 | GPT Image 2.5 Sunburst(Medium) | 107782 零错 | 107785 零错 | 107787 错 16 字符 |
| 6 | Grok Imagine 2.0(Medium) | 107876 零错 | 107883 零错 | 107887 零错 |
| 6 | Seedream 5.0 Pro | 107860 零错 | 107864 零错 | 107869 零错 |
| 6 | Nano Banana 2.1 | 107839 零错 | 107844 零错 | 107850 零错 |
| 6 | Qwen Image 3.0 Pro | 107830 零错 | 107833 错 7 字符,自加 1 行 | 107838 零错,自加 2 行 |
| 7 | GPT Image 2.5 Sunburst(Medium) | 107790 零错 | 107795 零错 | 107797 零错 |
| 7 | Grok Imagine 2.0(Medium) | 107890 零错 | 107893 零错 | 107896 零错 |
| 7 | Seedream 5.0 Pro | 107874 零错 | 107879 零错 | 107884 零错 |
| 7 | Nano Banana 2.1 | 107854 零错 | 107857 零错 | 107861 零错 |
| 7 | Qwen Image 3.0 Pro | 107842 零错 | 107846 零错 | 107849 零错 |
| 8 | GPT Image 2.5 Sunburst(Medium) | 107798 零错 | 107804 零错 | 107806 零错 |
| 8 | Grok Imagine 2.0(Medium) | 107899 零错 | 107905 零错 | 107907 零错 |
| 8 | Seedream 5.0 Pro | 107886 零错 | 107889 零错 | 107892 零错 |
| 8 | Nano Banana 2.1 | 107863 零错 | 107867 零错 | 107871 零错 |
| 8 | Qwen Image 3.0 Pro | 107852 零错 | 107856 零错 | 107858 零错 |
| 9 | GPT Image 2.5 Sunburst(Medium) | 107808 零错 | 107812 零错 | 107815 零错 |
| 9 | Grok Imagine 2.0(Medium) | 107909 零错 | 107910 零错 | 107912 零错 |
| 9 | Seedream 5.0 Pro | 107895 零错 | 107897 零错 | 107900 零错 |
| 9 | Nano Banana 2.1 | 107873 零错 | 107878 零错 | 107881 零错 |
| 9 | Qwen Image 3.0 Pro | 107862 错 2 字符 | 107866 错 1 字符 | 107868 错 2 字符 |
| 10 | GPT Image 2.5 Sunburst(Medium) | 107819 零错 | 107821 零错 | 107823 零错 |
| 10 | Grok Imagine 2.0(Medium) | 107913 零错 | 107916 零错 | 107918 零错 |
| 10 | Seedream 5.0 Pro | 107903 零错 | 107906 零错 | 107908 零错 |
| 10 | Nano Banana 2.1 | 107885 零错 | 107888 零错 | 107891 零错 |
| 10 | Qwen Image 3.0 Pro | 107872 零错 | 107875 零错 | 107880 零错 |
有错的 12 张,图上实际印的是:
- 107786,千问,第 3 题:gloves are → 像字非字的笔画;「Rain moves everything to the church hall on Birch Lane.」大半认不出。
- 107787,GPT Image 2.5 Sunburst,第 6 题:「Order #NLF-48213-QX」整行没有。
- 107799,千问,第 4 题:SMOKED PEPPER → MOKED PEOKKELPPAPIA R;第一句 slow-smoked 之后认不出;kitchen → klthun;Calories → Colories。
- 107803,千问,第 4 题:sesame → seame。
- 107810,千问,第 4 题:mL → nL;Calories → Colories。
- 107813,千问,第 5 题:recycling → recycal;jackets → jackdes;canoe → canse;ten → tever。
- 107820,千问,第 5 题:recycling → recycal;canoe → cone;ten → tever。
- 107825,千问,第 5 题:recycling → recycal;救生衣那句多处错字;安静时段和退房两句认不出。
- 107833,千问,第 6 题:「Order #NLF-48213-QX」→「#-48203」加认不出的笔画。
- 107862,千问,第 9 题:queijo → quejo;und → ud。
- 107866,千问,第 9 题:recién → reeién。
- 107868,千问,第 9 题:queijo 的 ij 成了乱码字形。
自加文字(不算错):Seedream 5.0 Pro 第 1 题 107754、107766、107777 各一行;Qwen Image 3.0 Pro 第 6 题 107833 一行、107838 两行。
GPT Image 2.6 的图(11 月 10 日补测)
| 题 | 模型 | 第 1 张 | 第 2 张 | 第 3 张 |
|---|---|---|---|---|
| 1 | GPT Image 2.6 Sunburst(Medium) | 108313 零错 | 108316 零错 | 108320 零错 |
| 1 | GPT Image 2.6 Flare(Medium) | 108311 零错 | 108312 零错 | 108314 零错 |
| 2 | GPT Image 2.6 Sunburst(Medium) | 108324 零错 | 108328 零错 | 108331 零错 |
| 2 | GPT Image 2.6 Flare(Medium) | 108315 零错 | 108317 零错 | 108318 零错 |
| 3 | GPT Image 2.6 Sunburst(Medium) | 108335 零错 | 108338 零错 | 108341 零错 |
| 3 | GPT Image 2.6 Flare(Medium) | 108319 零错 | 108321 零错 | 108322 零错 |
| 4 | GPT Image 2.6 Sunburst(Medium) | 108345 零错 | 108348 零错 | 108351 零错 |
| 4 | GPT Image 2.6 Flare(Medium) | 108323 零错 | 108325 零错 | 108326 零错 |
| 5 | GPT Image 2.6 Sunburst(Medium) | 108353 零错 | 108354 零错 | 108355 零错 |
| 5 | GPT Image 2.6 Flare(Medium) | 108327 零错 | 108329 零错 | 108330 零错 |
| 6 | GPT Image 2.6 Sunburst(Medium) | 108356 错 16 字符 | 108357 零错 | 108359 零错 |
| 6 | GPT Image 2.6 Flare(Medium) | 108332 零错 | 108333 零错 | 108334 零错 |
| 7 | GPT Image 2.6 Sunburst(Medium) | 108360 零错 | 108363 零错 | 108365 零错 |
| 7 | GPT Image 2.6 Flare(Medium) | 108336 零错 | 108337 零错 | 108339 零错 |
| 8 | GPT Image 2.6 Sunburst(Medium) | 108366 零错 | 108367 零错 | 108368 零错 |
| 8 | GPT Image 2.6 Flare(Medium) | 108340 零错 | 108342 零错 | 108343 零错 |
| 9 | GPT Image 2.6 Sunburst(Medium) | 108369 零错 | 108370 零错 | 108371 零错 |
| 9 | GPT Image 2.6 Flare(Medium) | 108344 零错 | 108346 零错 | 108347 零错 |
| 10 | GPT Image 2.6 Sunburst(Medium) | 108372 零错 | 108373 零错 | 108374 零错 |
| 10 | GPT Image 2.6 Flare(Medium) | 108349 零错 | 108350 零错 | 108352 零错 |
GPT Image 2.6 唯一出错的一张,图上实际印的:
- 108356,GPT Image 2.6 Sunburst,第 6 题:「Order #NLF-48213-QX」整行没有。
自加文字:GPT Image 2.6 的 60 张里没有。
常见问题
哪个 AI 生图模型写字最准?
我们 2026 年 11 月测了 150 张图,有四款模型写字几乎不出错、彼此分不出高下:GPT Image 2.5 Sunburst、Grok Imagine 2.0、Seedream 5.0 Pro 和 Nano Banana 2.1。四款合计 120 张里 119 张零错,最长写到 189 个英文单词的长信。Qwen Image 3.0 Pro(千问)30 张里有 11 张出错。四款之间怎么选,看设计分和价格:Grok Imagine 2.0、GPT Image 2.5 Sunburst 和 Nano Banana 2.1 的设计分在误差范围内打平,Nano Banana 2.1 在 FontVibe 上积分最便宜。11 月 10 日补测的 GPT Image 2.6 Sunburst 和 GPT Image 2.6 Flare 也和这四款打平,但截至当天只有 FontVibe 自己的测试账号能用。
AI 生图模型写多长的英文开始出错?
本次测试的长度都按英文单词计。中文只测了一句 30 字的短句(含全角标点,另有一句 28 字的日文,两句合计 58 字)。本次测试里,GPT Image 2.5 Sunburst、Grok Imagine 2.0、Seedream 5.0 Pro 和 Nano Banana 2.1 写一封 189 个英文单词、三段的长信,每款 3 次都没错一个字。它们的上限在 189 个英文单词以上,更长的文本本轮没测。Qwen Image 3.0 Pro 写 72 个英文单词的告示 3 次对 2 次,到 117 个英文单词和 189 个英文单词 3 次全都出错。
千问 Qwen Image 3.0 Pro 写长文行不行?
本次测试里不行,短文字也要检查。我们测的是 Qwen Image 3.0 Pro,没测不带 Pro 的 Qwen Image 3.0。它写 72 个英文单词的告示 3 张里错了 1 张,在 117 个英文单词的酱料背标和 189 个英文单词的长信两题里 6 张全部出错,既有把 recycling 写成 recycal 这样的错拼,也有整句变成像字非字的笔画。这 6 张图的最后几行都在,所以错误不是提示词被截断造成的。短文字也不是都对:26 个和 34 个英文单词的两题、价目表、生造词、中日文卡片它都写对了,但三行的面包店橱窗字 3 张都有字母错,门票 3 张里有 1 张订单号写错。不管多长,都要逐字检查。
GPT Image 2.6 写字比 GPT Image 2.5 准吗?
在我们 2026 年 11 月的测试里,没有测出更准。同样 10 道题、2K:GPT Image 2.6 Sunburst 30 张错 1 张,和 GPT Image 2.5 Sunburst 漏的是同一行订单号;GPT Image 2.6 Flare 30 张一张没错。逐题配对比较,两者和 GPT Image 2.5 Sunburst 的差距都在运气范围内,设计分也打平。三者测的都是 Medium,比 FontVibe 的默认档 High 低一档,更高的档位可能更准。截至 2026 年 11 月 10 日,GPT Image 2.6 在 FontVibe 上还是内测,只对 FontVibe 自己的测试账号开放。
AI 生图能写对数字、网址和带重音的字母吗?
大体能。门票题有日期、订单号、网址、电话和邮箱,GPT Image 2.5 Sunburst、Grok Imagine 2.0、Seedream 5.0 Pro 和 Nano Banana 2.1 共 12 张里只有 1 张出错:GPT Image 2.5 Sunburst 有一次漏印订单号。单车店价目表有 26 组数字,五款模型 15 张全对。西 / 葡 / 德三语橱窗字,五款模型 15 张的重音字母和德语 ß 全部写对。Qwen Image 3.0 Pro 3 张仍然都有拼写错,但错在普通字母(queijo 成了 quejo),不在重音上;其余四款没有错。
评论